

Stejně jako v , objevila se problém s distribuovanou službou, nazvěme tuto službu Elvin. Tentokrát jsem problém neobjevil sám, dali mi o něm vědět kluci z klientské části.
Jednou jsem se probudil od nespokojeného e-mailu kvůli velkým zpožděním u Elvina, kterého jsme plánovali zavést v blízké době. Zejména se klient setkal se zpožděním v 99. percentilu kolem 50 ms, což bylo mnohem nad naším rozpočtem pro zpoždění. Bylo to překvapivé, protože jsem službu pečlivě testoval, zejména na latenci, neboť to je předmět častých stížností.
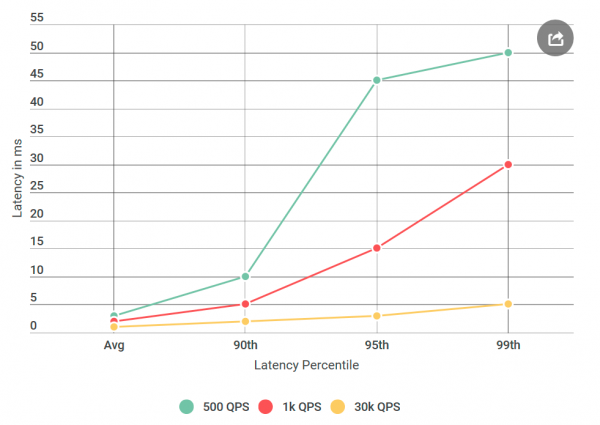
Než jsem dal Elvina do testování, provedl jsem mnoho experimentů s 40 000 dotazy za sekundu (QPS), všechny ukázaly latenci pod 10 ms. Byl jsem připraven prohlásit, že s jejich výsledky nesouhlasím. Ale když jsem se znovu podíval na e-mail, všiml jsem si něčeho nového: přesně jsem netestoval podmínky, které zmínili, jejich QPS bylo mnohem nižší než moje. Testoval jsem na 40k QPS, a oni pouze na 1k. Spustil jsem další experiment, tentokrát s nižším QPS, jen abych je uklidnil.
Protože o tom píšu na blogu – pravděpodobně už jste pochopili: jejich čísla se ukázala jako správná. Kontroloval jsem svého virtuálního klienta znovu a znovu, stále se stejným výsledkem: nízký počet dotazů nezvyšuje pouze latenci, ale zvyšuje počet dotazů se zpožděním nad 10 ms. Jinými slovy, zatímco při 40k QPS přibližně 50 dotazů za sekundu překročilo 50 ms, při 1k QPS každou sekundu bylo 100 dotazů nad 50 ms. Paradox!
Zúžení okruhu podezřelých.
Při čelní problému zpoždění v distribuovaném systému s mnoha komponenty je prvním krokem sestavit krátký seznam podezřelých. Pojďme se podívat hlouběji do architektury Elvina:
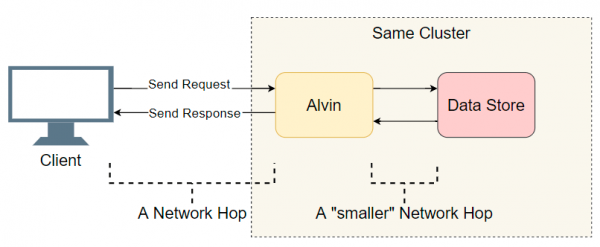
Dobrou výchozí bodem je seznam provedených přechodů vstupů a výstupů (síťové volání/hledání na disku atd.). Pokusíme se zjistit, kde je zpoždění. Kromě zřejmého vstupu a výstupu s klientem, Elvin provádí další krok: obrací se na úložiště dat. Ale toto úložiště funguje ve stejném clusteru jako Elvin, takže by tam zpoždění mělo být menší než s klientem. Takže seznam podezřelých:
- Síťové volání od klienta k Elvinovi.
- Síťové volání od Elvina k datovému úložišti.
- Hledání na disku v datovém úložišti.
- Síťové volání z datového úložiště k Elvinovi.
- Síťové volání od Elvina k klientovi.
Pokud zkusíme vyjmout některé položky.
Datové úložiště není příčinou.
Nejprve jsem převedl Elvina na ping-ping server, který nezpracovává žádné požadavky. Po obdržení požadavku vrátí prázdnou odpověď. Pokud se zpoždění zkracuje, pak je chyba v implementaci Elvina nebo datového úložiště — nic takového neslýchaného. V prvním experimentu máme takový graf:
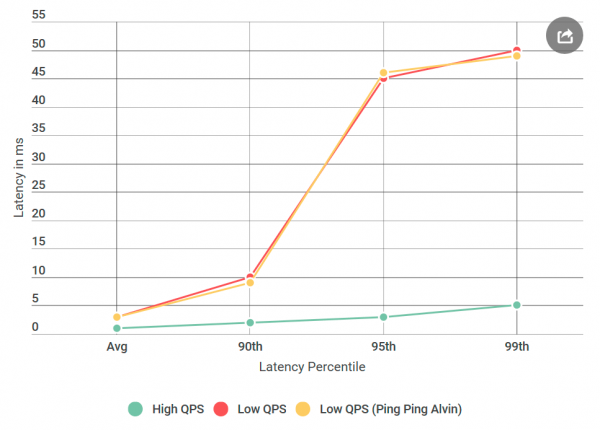
Jak vidíme, při použití ping-ping serveru se neobjevují žádná zlepšení. To znamená, že datové úložiště nezvyšuje zpoždění, a seznam podezřelých se zúžil na polovinu:
- Síťové volání od klienta k Elvinovi.
- Síťové volání od Elvina k klientovi.
Skvělé! Seznam se rychle zúžuje. Myslel jsem, že jsem téměř objevil příčinu.
gRPC
Právě teď je čas představit vám nového hráče: . Je to knihovna s otevřeným zdrojovým kódem od Google pro intraprocesní komunikaci. . I když gRPC je dobře optimalizovaný a široce používaný, poprvé jsem jej použil v systému takového rozsahu a očekával jsem, že moje implementace bude méně efektivní — mírně řečeno.
Přítomnost gRPC ve stacku vyvolala novou otázku: možná je to moje implementace nebo sám gRPC způsobuje problém se zpožděním? Přidáváme do seznamu nového podezřelého:
- Klient volá knihovnu
gRPC - Knihovna
gRPCna klientovi provádí síťové volání knihovnygRPCna serveru - Knihovna
gRPCse obrací na Elvina (operace není v případě serveru ping-pong)
Abychom vám ukázali, jak vypadá kód, moje implementace klienta/Elvina se moc neliší od příkladů klient-server .
Poznámka: výše uvedený seznam je trochu zjednodušen, protože
gRPCumožňuje použití vlastní (šablonové?) modelové osnovy, která propletuje běhový stackgRPCa uživatelskou implementaci. Pro jednoduchost se budeme držet tohoto modelu.
Profilování to všechno opraví.
Po vyřazení datových úložišť jsem si myslel, že jsem skoro hotov: 'Teď to bude snadné! Použijeme profil a zjistíme, kde vzniká zpoždění.' Jsem protože CPU je velmi rychlé a často není úzkým místem. Většina zpoždění se vyskytuje, když procesor musí zastavit zpracování, aby udělal něco jiného. Přesné profilování CPU je určeno právě k tomuto: přesně zaznamenává vše. a naznačuje, kde dochází k prodlevám.
Vzal jsem čtyři profily: jeden pro vysoký QPS (malá prodleva) a s ping-pong serverem na nízkém QPS (velká prodleva) jak na straně klienta, tak na straně serveru. A pro jistotu jsem si také vzal vzorek profilu CPU. Při porovnávání profilů obvykle hledám anomální stack volání. Například na špatné straně s vysokou prodlevou dochází k mnohem více kontextovým přepnutím (10 a vícekrát). Ale v mém případě se počet kontextových přepnutí prakticky shodoval. K mému zděšení tam nebylo nic zásadního.
Další ladění
Byl jsem zoufalý. Nevěděl jsem, jaké další nástroje mohu použít, a můj další plán v zásadě spočíval v opakování experimentů s různými variantami, nikoli v jasném diagnostikování problému.
Co když
Už od začátku mě znepokojoval specifický čas prodlevy 50 ms. To je velmi dlouhá doba. Rozhodl jsem se, že budu odřezávat kousky kódu, dokud nezjistím, která část způsobuje tuto chybu. Poté následoval experiment, který vyšel.
Jak už to bývá, zpětně to vypadá, že všechno bylo jasné. Dal jsem klienta na jeden stroj s Elvinem – a poslal žádost na localhost. A prodleva se vytratila!
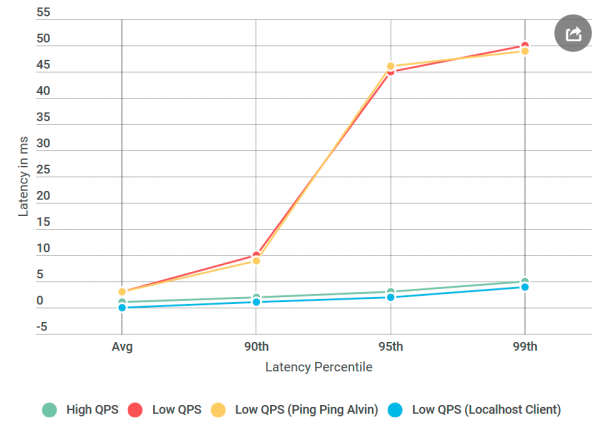
Něco nebylo v pořádku sítě.
Osvojení si dovedností síťového inženýra
Musím přiznat: moje znalosti sítí jsou hrozné, zvlášť když s nimi pracuji každý den. Ale síť byla hlavním podezřelým a musel jsem se naučit, jak ji ladit.
Naštěstí internet miluje ty, kteří se chtějí učit. Kombinace ping a tracert se zdála jako dostatečně dobrý začátek pro ladění problémů se síťovým transportem.
Nejprve jsem spustil na TCP portu Elvina. Použil jsem výchozí parametry – nic zvláštního. Z více než tisíce pingů žádný nepřekročil 10 ms, s výjimkou prvního pro zahřátí. To je v rozporu se zjevným zvýšením prodlevy 50 ms v 99. percentilu: tam jsme měli vidět přibližně jeden požadavek na každých 100 s prodlevou 50 ms.
Pak jsem zkusil : možná je problém na jednom z uzlů na trase mezi Elvinem a klientem. Ale ani tracer se nevrátil s prázdnou.
Takže důvodem zpoždění nebyl můj kód, implementace gRPC ani síť. Začal jsem se už obávat, že tomu nikdy neporozumím.
Teď, na jakém operačním systému se nacházíme
gRPC široce se používá v Linuxu, ale pro Windows je to exotika. Rozhodl jsem se provést experiment, který vyšel: vytvořil jsem virtuální stroj Linux, zkompiloval Elvina pro Linux a nasadil ho.
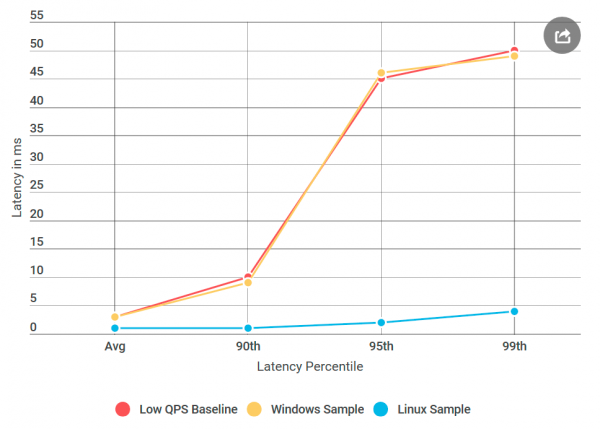
A takto to dopadlo: na ping-pong serveru Linux nebyla taková zpoždění jako u srovnatelného uzlu Windows, i když zdroj dat byl stejný. Zjistil jsem, že problém je v implementaci gRPC pro Windows.
Näherův algoritmus
Celou dobu jsem si myslel, že mi chybí příznak gRPC. Teď jsem pochopil, že ve skutečnosti jde o gRPC chybějící příznak Windows. Našel jsem vnitřní knihovnu RPC, u které jsem byl přesvědčen, že funguje dobře pro všechny nainstalované příznaky . Pak jsem přidal všechny tyto příznaky do gRPC a nasadil Elvina na Windows, v opraveném ping-pong serveru pod Windows!
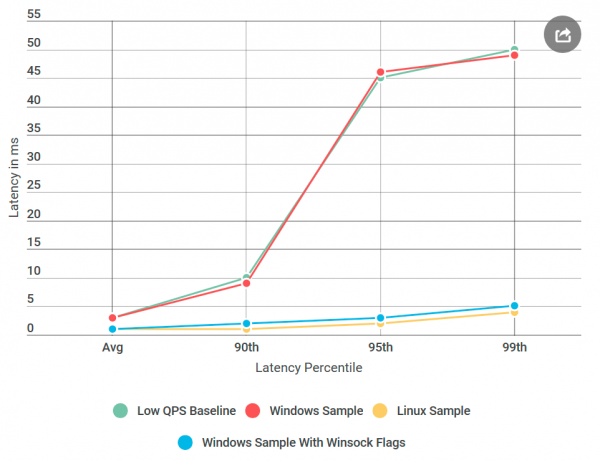
Téměř hotovo: začal jsem odebírat přidané příznaky jeden po druhém, dokud se nezapnula regresní chyba, takže jsem mohl přesně určit její příčinu. Byl to notoricky známý , přepínač Nährungsova algoritmu.
se snaží snížit počet paketů odeslaných přes síť tím, že zpožďuje odesílání zpráv, dokud velikost paketu nepřekročí určité množství bajtů. I když to může být příjemné pro průměrného uživatele, je to devastující pro servery v reálném čase, protože OS bude zpožďovat některé zprávy, což způsobí zpoždění při nízkém QPS. U gRPC byl tento příznak nastaven v implementaci Linux pro TCP sokety, ale ne pro Windows. Opravil jsem to. .
Závěr
uživatelském režimu. Pokud jde o experiment localhost, ten pravděpodobně nesouvisel s vlastním síťovým kódem, a Nährungsův algoritmus nebyl spuštěn, takže problémy se zpožděním zmizely, když se klient obrátil na Elvina přes localhost.
Příště, když uvidíte zvýšení zpoždění při snižování počtu požadavků za sekundu, měl by být Nährungsův algoritmus na vašem seznamu podezřelých!
!
Zdroj: habr.com
