

Ahoj, Habr!
Máte rádi létání letadly? Já ano, ale během samoizolace jsem si zamiloval také analýzu dat o letenkách z jednoho známého zdroje — Aviasales.
Dnes si podrobně probereme Amazon Kinesis, vytvoříme streamovací systém s real-time analýzou, nasadíme NoSQL databázi Amazon DynamoDB jako hlavní úložiště dat a nastavíme upozornění pomocí SMS na zajímavé letenky.
Všechny podrobnosti najdete níže! Jdeme na to!
Úvod
Jako příklad budeme potřebovat přístup k . Přístup je poskytován zdarma a bez omezení, stačí se zaregistrovat v sekci „Pro vývojáře“, abyste získali svůj API token pro přístup k datům.
Hlavním cílem tohoto článku je poskytnout obecné porozumění použití streamování dat v AWS, vynecháváme, že data měněná použitým API nejsou striktně aktuální a jsou předávána z cache, která se tvoří na základě vyhledávání uživatelů na stránkách Aviasales.ru a Jetradar.com za posledních 48 hodin.
Získaná data o letenkách přes API bude Kinesis-agent, nainstalovaný na producentovi, automaticky parsovat a předávat do správného streamu přes Kinesis Data Analytics. Nezpracovaná verze tohoto streamu bude zapisována přímo do úložiště. Zavedené úložiště „syrových“ dat v DynamoDB umožní provádět hlubší analýzu letenek pomocí BI nástrojů, jako je AWS Quick Sight.
Podíváme se na dvě varianty nasazení celé infrastruktury:
- Ruční — přes AWS Management Console;
- Infrastruktura z kódu Terraform — pro líné automatizátory;
Architektura vyvíjeného systému
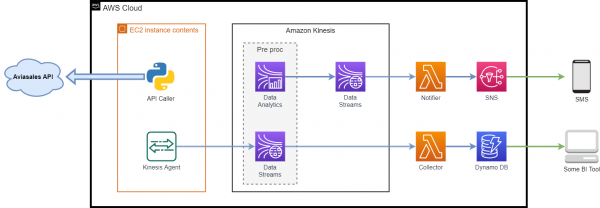
Používané komponenty:
- — data vrácená tímto API budou používána pro veškerou další práci;
- — běžný virtuální stroj v cloudu, na kterém bude generován vstupní tok dat:
- — to je Java aplikace, instalovaná lokálně na stroj, která poskytuje jednoduchý způsob sběru a odesílání dat do Kinesis (Kinesis Data Streams nebo Kinesis Firehose). Agent neustále sleduje souborovou sadu v určených adresářích a odesílá nová data do Kinesis;
- — Python skript, který provádí dotazy na API a ukládá odpověď do složky, kterou sleduje Kinesis Agent;
- — služba pro streamování dat v reálném čase s širokými možnostmi škálování;
- — bezserverová služba, která zjednodušuje analýzu streamovaných dat v reálném čase. Amazon Kinesis Data Analytics nastavuje zdroje pro provoz aplikací a automaticky se škáluje, aby zpracovalo jakýkoli objem příchozích dat;
- — služba, která umožňuje spouštět kód bez rezervace a konfigurace serverů. Veškeré výpočetní kapacity se automaticky škálují pro každý konkrétní požadavek;
- — databáze párů „klíč-hodnota“ a dokumentů, která zajišťuje latenci pod 10 milisekund bez ohledu na měřítko. Při používání DynamoDB není třeba rozdělovat servery, instalovat na ně opravy nebo je spravovat. DynamoDB automaticky škáluje tabulky, upravuje objem dostupných zdrojů a udržuje vysoký výkon. Není potřeba žádná administrativní činnost;
- — plně spravovaná služba pro zasílání zpráv na základě modelu „publikace – odběratel“ (Pub/Sub), pomocí které můžete izolovat mikroslužby, distribuované systémy a bezserverové aplikace. SNS lze použít k zasílání informací koncovým uživatelům prostřednictvím mobilních push oznámení, SMS zpráv a e-mailů.
Úvodní příprava
Pro simulaci datového streamu jsem se rozhodl použít informace o letenkách vracené API Aviasales. V poměrně rozsáhlém seznamu různých metod vezmeme jednu z nich — „Kalendář cen na měsíc“, která vrací ceny za každý den v měsíci, seskupené podle počtu přestupů. Pokud v požadavku nezadáte měsíc hledání, bude vrácena informace za měsíc následující po aktuálním.
Takže se zaregistrujeme a získáme svůj token.
Příklad požadavku níže:
http://api.travelpayouts.com/v2/prices/month-matrix?currency=rub&origin=LED&destination=HKT&show_to_affiliates=true&token=TOKEN_APIVýše popsaný způsob získání dat z API pomocí tokenu v požadavku bude fungovat, ale já raději předávám token přístup prostřednictvím hlavičky, takže ve skriptu api_caller.py budeme používat právě tento způsob.
Příklad odpovědi:
{{
   "success":true,
   "data":[{
      "show_to_affiliates":true,
      "trip_class":0,
      "origin":"LED",
      "destination":"HKT",
      "depart_date":"2015-10-01",
      "return_date":"",
      "number_of_changes":1,
      "value":29127,
      "found_at":"2015-09-24T00:06:12+04:00",
      "distance":8015,
      "actual":true
   }]
}
V příkladu odpovědi API výše je ukázána jízdenka z Petrohradu do Phuketu… Ach, co si jen přát…
Protože jsem z Kazaně a Phuket je teď „jen ve snech“, podíváme se na jízdenky z Petrohradu do Kazaně.
Předpokládá se, že již máte účet na AWS. Hned bych chtěl zdůraznit, že Kinesis a odesílání upozornění přes SMS nejsou zahrnuty v ročním . Ale i přesto, když si v duchu spočítáte pár dolarů, je docela možné vybudovat navrhovaný systém a experimentovat s ním. A samozřejmě nezapomeňte smazat všechny zdroje poté, co již nebudou potřeba.
Naštěstí, DynamoDB a lambda funkce budou pro nás podmíněně zdarma, pokud se vejdeme do měsíčních bezplatných limitů. Například pro DynamoDB: 25 GB úložiště, 25 WCU/RCU a 100 milionů dotazů. A milion volání lambda funkcí za měsíc.
Ruční nasazení systému
Nastavení Kinesis Data Streams
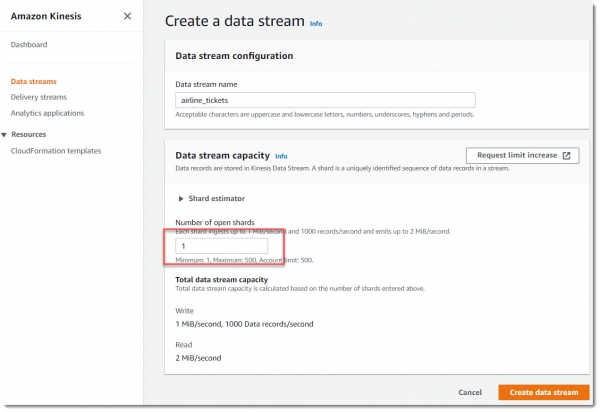
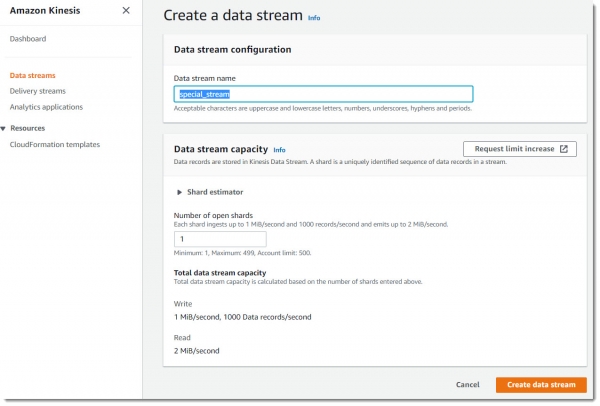
Přejdeme do služby Kinesis Data Streams a vytvoříme dva nové proudy, jeden shard pro každý.
Co je shard?
Shard je hlavní jednotka přenosu dat proudu Amazon Kinesis. Jeden shard zajišťuje přenos vstupních dat rychlostí 1 MB/s a přenos výstupních dat rychlostí 2 MB/s. Jeden shard podporuje až 1000 příkazů PUT za sekundu. Při vytváření datového proudu je nutné zadat požadované množství shardů. Například lze vytvořit datový proud se dvěma shardy. Tento datový proud zajistí přenos vstupních dat rychlostí 2 MB/s a přenos výstupních dat rychlostí 4 MB/s s podporou až 2000 příkazů PUT za sekundu.
Čím více shardů ve vašem proudu, tím vyšší je jeho propustnost. V zásadě se proudy škálují přidáváním shardů. Ale čím více shardů máte, tím vyšší je cena. Každý shard stojí 1,5 centu za hodinu a navíc 1,4 centu za každé milion operací přidání do proudu (PUT payload units).
Vytvoříme nový proud s názvem airline_tickets, bude mu zcela stačit 1 shard:
Teď vytvoříme další proud s názvem special_stream:
Nastavení producenta
Jako producent dat pro analýzu úkolu stačí použít běžný EC2 instance. Neměla by to být výkonná drahá virtuální mašina, postačí spottový t2.micro.
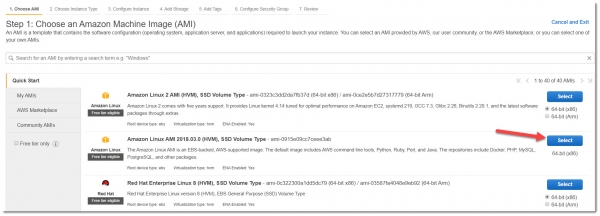
Důležité poznámka: pro příklad by měl být použit image — Amazon Linux AMI 2018.03.0, s nímž je méně nastavení pro rychlé spuštění Kinesis Agent.
Přejdeme do služby EC2, vytvoříme novou virtuální stroj, vybereme požadovaný AMI typu t2.micro, který je součástí Free Tier:
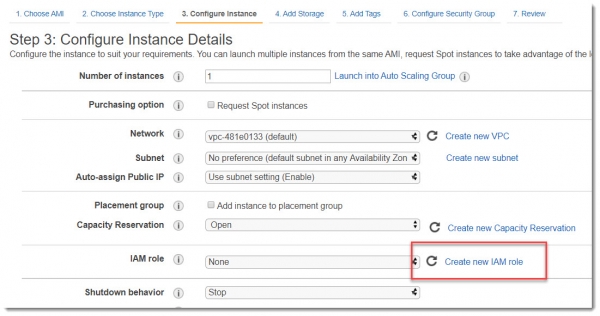
Aby nově vytvořený virtuální stroj mohl interagovat se službou Kinesis, je nutné mu k tomu udělit oprávnění. Nejlepším způsobem, jak to udělat, je přiřadit IAM Role. Proto na obrazovce Krok 3: Konfigurace podrobností instance vybereme Vytvořit novou IAM roli:
Vytvoření IAM role pro EC2
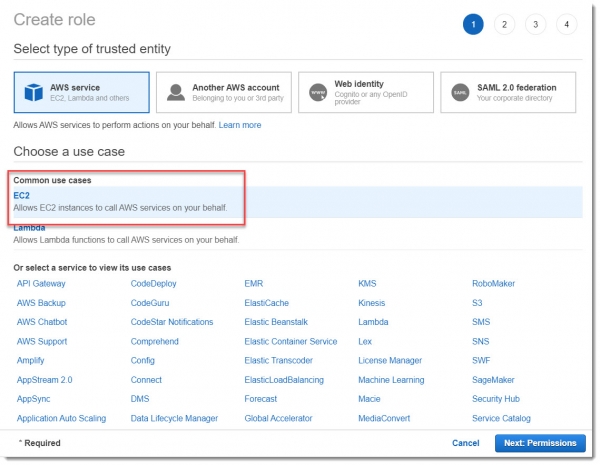
V otevřeném okně vybereme, že novou roli vytváříme pro EC2 a přejdeme do sekce Oprávnění:
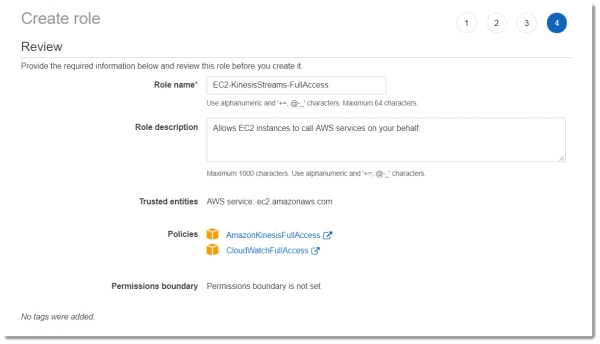
Na příkladu výuky se nemusíme zabývat všemi detaily granulárního nastavení práv na zdroje, takže vybereme přednastavené politiky od Amazonu: AmazonKinesisFullAccess a CloudWatchFullAccess.
Dáme nějaké smysluplné jméno této roli, například: EC2-KinesisStreams-FullAccess. V důsledku by mělo vzniknout to samé, co je uvedeno na obrázku níže:
Po vytvoření této nové role nezapomeňte ji přiřadit k vytvářenému instanci virtuálního stroje:
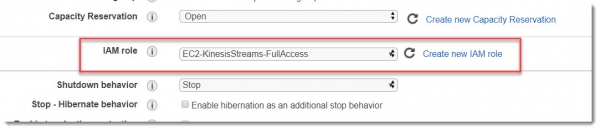
Na této obrazovce již nic neměníme a přecházíme k dalším oknům.
Nastavení pevného disku můžete nechat výchozí, tagy také (i když dobrou praxí je používat tagy, alespoň pojmenovat instanci a uvést prostředí).
Nyní jsme na záložce Krok 6: Konfigurace bezpečnostní skupiny, kde je nutné vytvořit novou nebo uvést stávající bezpečnostní skupinu, která umožňuje připojení přes ssh (port 22) na instanci. Vyberte tam Zdroj -> Můj IP a můžete spustit instanci.
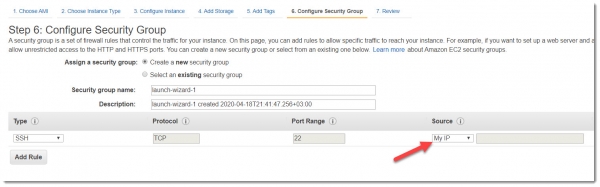
Jakmile převede do stavu running, můžete se pokusit se k němu připojit přes ssh.
Abychom mohli pracovat s Kinesis Agent, po úspěšném připojení k stroji je třeba zadat následující příkazy do terminálu:
sudo yum -y update
sudo yum install -y python36 python36-pip
sudo /usr/bin/pip-3.6 install --upgrade pip
sudo yum install -y aws-kinesis-agent
Vytvoříme složku pro ukládání odpovědí API:
sudo mkdir /var/log/airline_ticketsPřed spuštěním agenta je třeba nakonfigurovat jeho konfigurační soubor:
sudo vim /etc/aws-kinesis/agent.jsonObsah souboru agent.json by měl mít následující podobu:
{
  "cloudwatch.emitMetrics": true,
  "kinesis.endpoint": "",
  "firehose.endpoint": "",

  "flows": [
    {
      "filePattern": "\/var\/log\/airline_tickets\/*log",
      "kinesisStream": "airline_tickets",
      "partitionKeyOption": "RANDOM",
      "dataProcessingOptions": [
         {
            "optionName": "CSVTOJSON",
            "customFieldNames": ["cost","trip_class","show_to_affiliates",
                "return_date","origin","number_of_changes","gate","found_at",
                "duration","distance","destination","depart_date","actual","record_id"]
         }
      ]
    }
  ]
}
Jak je vidět z konfiguračního souboru, agent bude monitorovat v adresáři \/var\/log\/airline_tickets\/ soubory s příponou .log, parsovat je a přenášet do proudu airline_tickets.
Restartujeme službu a ověříme, že se spustila a běží:
sudo service aws-kinesis-agent restartNyní stáhneme Python skript, který bude dotazovat data z API:
REPO_PATH=https:\/\/raw.githubusercontent.com\/igorgorbenko\/aviasales_kinesis\/master\/producer

wget $REPO_PATH\/api_caller.py -P \/home\/ec2-user\/
wget $REPO_PATH\/requirements.txt -P \/home\/ec2-user\/
sudo chmod a+x \/home\/ec2-user\/api_caller.py
sudo \/usr\/local\/bin\/pip3 install -r \/home\/ec2-user\/requirements.txt
Skript api_caller.py dotazuje data od Aviasales a ukládá obdrženou odpověď do adresáře, který skenuje Kinesis agent. Implementace tohoto skriptu je dost standardní, existuje třída TicketsApi, která umožňuje asynchronně volat API. Do této třídy předáváme hlavičku s tokenem a parametry dotazu:
class TicketsApi:
    """Třída volající API."""

    def __init__(self, headers):
        """Iniciační metoda."""
        self.base_url = BASE_URL
        self.headers = headers

    async def get_data(self, data):
        """Získání dat z dotazu API."""
        response_json = {}
        async with ClientSession(headers=self.headers) as session:
            try:
                response = await session.get(self.base_url, data=data)
                response.raise_for_status()
                LOGGER.info('Stav odpovědi %s: %s',
                            self.base_url, response.status)
                response_json = await response.json()
            except HTTPError as http_err:
                LOGGER.error('Och! Došlo k chybě HTTP: %s', str(http_err))
            except Exception as err:
                LOGGER.error('Och! Došlo k chybě: %s', str(err))
            return response_json


def prepare_request(api_token):
    """Vrátí hlavičky a dotaz pro API požadavek."""
    headers = {'X-Access-Token': api_token,
               'Accept-Encoding': 'gzip'}

    data = FormData()
    data.add_field('currency', CURRENCY)
    data.add_field('origin', ORIGIN)
    data.add_field('destination', DESTINATION)
    data.add_field('show_to_affiliates', SHOW_TO_AFFILIATES)
    data.add_field('trip_duration', TRIP_DURATION)
    return headers, data


async def main():
    """Spustí kód."""
    if len(sys.argv) != 2:
        print('Použití: api_caller.py ')
        sys.exit(1)
        return
    api_token = sys.argv[1]
    headers, data = prepare_request(api_token)

    api = TicketsApi(headers)
    response = await api.get_data(data)
    if response.get('success', None):
        LOGGER.info('API vrátilo %s položek', len(response['data']))
        try:
            count_rows = log_maker(response)
            LOGGER.info('%s řádků bylo uloženo do %s',
                        count_rows,
                        TARGET_FILE)
        except Exception as e:
            LOGGER.error('Och! Výsledky požadavku nebyly uloženy do souboru. %s',
                         str(e))
    else:
        LOGGER.error('Och! Požadavek API byl neúspěšný %s!', response)
Pro testování správnosti nastavení a funkčnosti agenta provedeme testovací spuštění skriptu api_caller.py:
sudo ./api_caller.py TOKEN 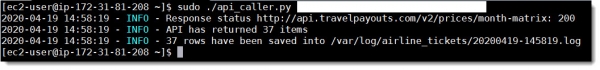
A sledujeme výsledek práce v logách Agenta a na záložce Monitoring v datovém proudu airline_tickets:
tail -f /var/log/aws-kinesis-agent/aws-kinesis-agent.log 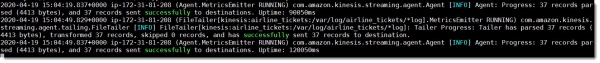
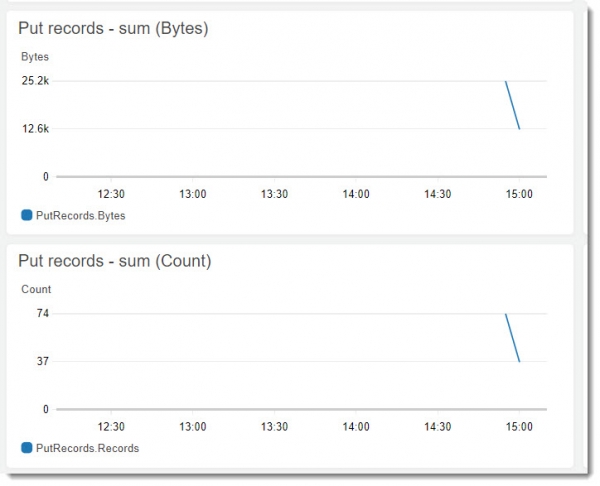
Jak je vidět, všechno funguje a Kinesis Agent úspěšně odesílá data do proudu. Nyní nastavíme consumer.
Nastavení Kinesis Data Analytics
Přejdeme k centrální komponentě celého systému — vytvoříme novou aplikaci v Kinesis Data Analytics s názvem kinesis_analytics_airlines_app:
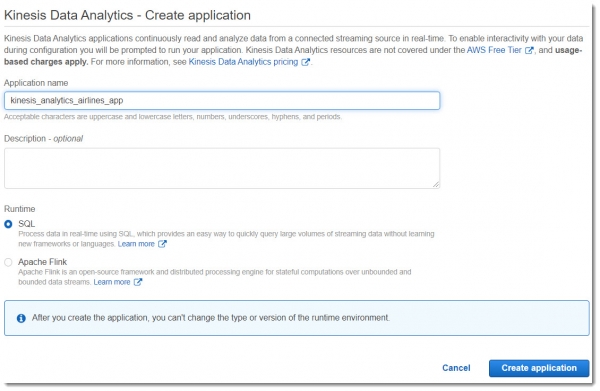
Kinesis Data Analytics umožňuje provádět analýzu dat v reálném čase z Kinesis Streams pomocí jazyka SQL. Je to plně automaticky škálovatelná služba (na rozdíl od Kinesis Streams), která:
- umožňuje vytvářet nové proudy (Output Stream) na základě dotazů na zdrojová data;
- poskytuje proud s chybami, které vznikly během práce aplikací (Error Stream);
- umí automaticky určit schéma vstupních dat (může být ručně předefinováno při potřebě).
Toto není levný servis — 0,11 USD za hodinu, takže byste jej měli používat opatrně a po dokončení práce s ním odstranit.
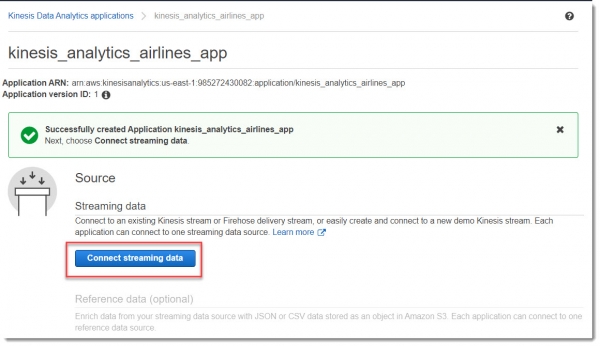
Připojíme aplikaci ke zdroji dat:
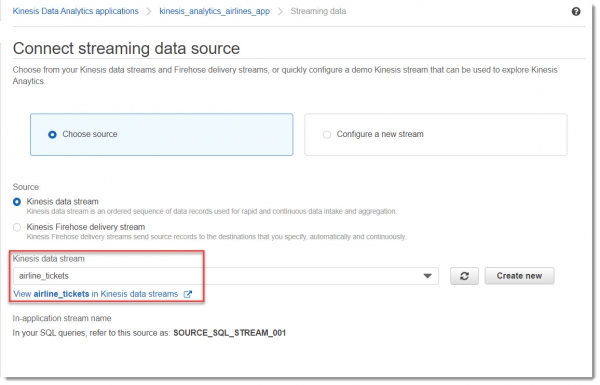
Vyberte proud, ke kterému se chceme připojit (airline_tickets):
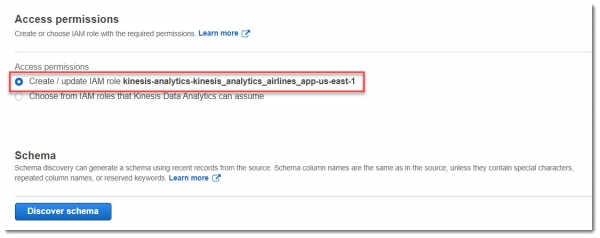
Poté je třeba připojit novou IAM roli, aby mohla aplikace číst z proudu a zapisovat do proudu. K tomu stačí nic neměnit v bloku Přístupová oprávnění:
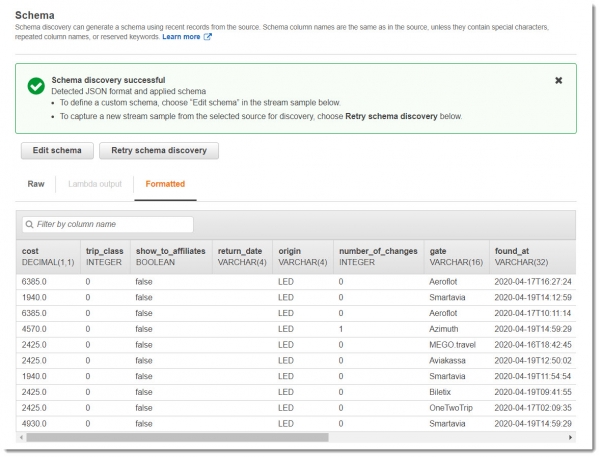
Nyní požádáme o zjištění schématu dat v proudu, k tomu stiskneme tlačítko „Objevit schéma“. Výsledkem bude aktualizace (vytvoření nové) role IAM a spuštění zjištění schématu z dat, která již dorazila do proudu:
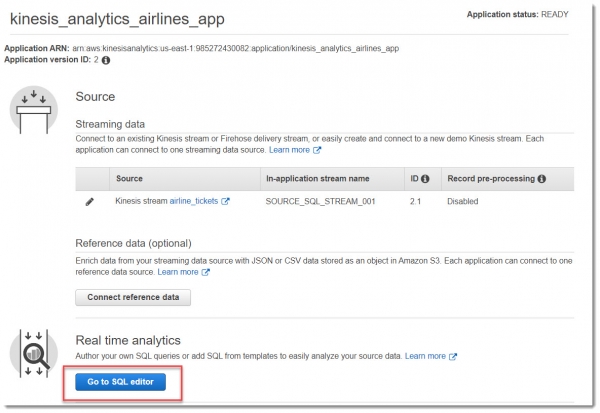
Nyní je nutné přejít do editoru SQL. Po kliknutí na toto tlačítko se objeví okno s otázkou, co chceme spustit — vybereme, co chceme spustit:
Do okna editoru SQL vložíme tento jednoduchý dotaz a stiskneme Uložit a spustit SQL:
CREATE OR REPLACE STREAM "DESTINATION_SQL_STREAM" ("cost" DOUBLE, "gate" VARCHAR(16));

CREATE OR REPLACE PUMP "STREAM_PUMP" AS INSERT INTO "DESTINATION_SQL_STREAM"
SELECT STREAM "cost", "gate"
FROM "SOURCE_SQL_STREAM_001"
WHERE "cost" < 5000
    and "gate" = 'Aeroflot';
Ve relačních databázích pracujete s tabulkami, používáte operátory INSERT pro přidávání záznamů a operátor SELECT pro dotazování dat. V Amazon Kinesis Data Analytics pracujete s proudy (STREAM) a „čerpadly“ (PUMP) — nepřetržitými dotazy na vložení, které vkládají data z jednoho proudu v aplikaci do druhého proudu.
V uvedeném SQL dotazu se hledají letenky Aeroflotu s cenou nižší než pět tisíc rublů. Všechny záznamy, které splňují tyto podmínky, budou umístěny do proudu DESTINATION_SQL_STREAM.
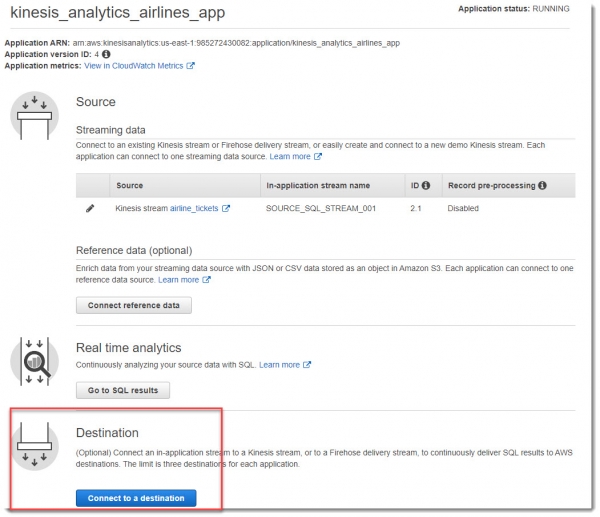
V bloku Destination vyberte proud special_stream a ve výběrovém seznamu In-application stream name DESTINATION_SQL_STREAM:
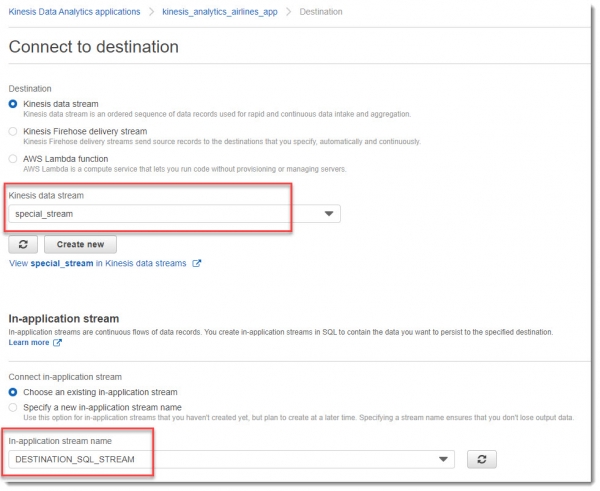
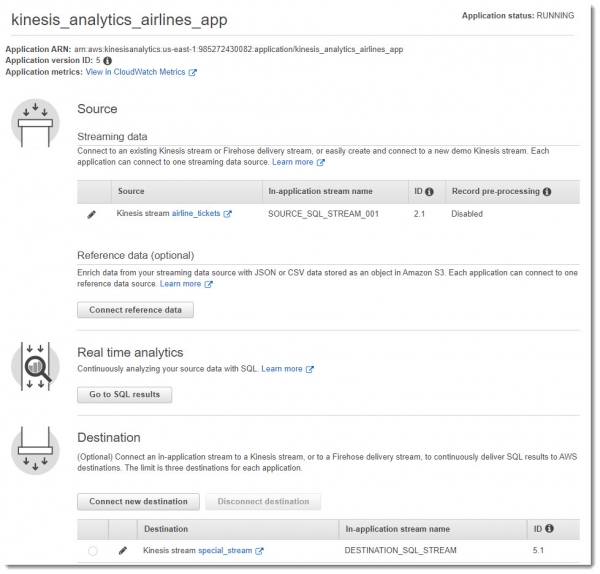
V důsledku všech manipulací by mělo vzniknout něco jako obrázek níže:
Vytvoření a registrace tématu SNS
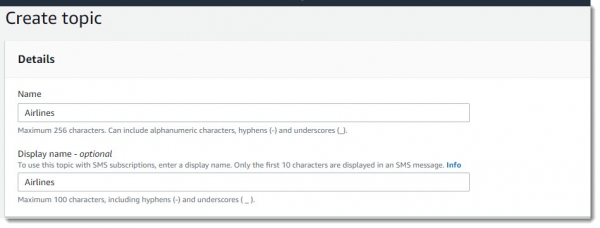
Přejděte do služby Simple Notification Service a vytvořte nové téma s názvem Airlines:
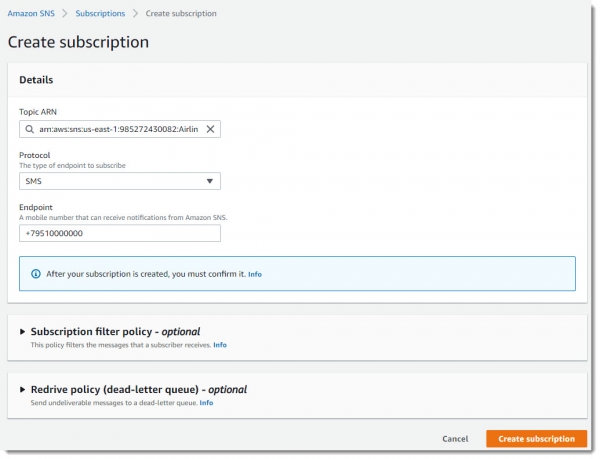
Zaregistrujte se na toto téma, přičemž uvedete číslo mobilního telefonu, na které budou docházet SMS upozornění:
Vytvoření tabulky v DynamoDB
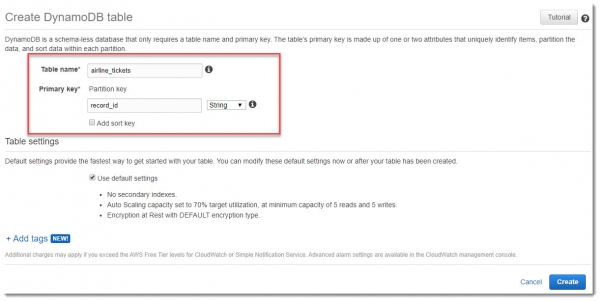
Pro uložení nezpracovaných dat z proudu airline_tickets vytvoříme tabulku v DynamoDB se stejným názvem. Jako primární klíč budeme používat record_id:
Vytvoření lambda funkce collector
Vytvoříme lambda funkci s názvem Collector, jejímž úkolem bude zpracovávat proud airline_tickets a v případě nalezení nových záznamů je vložit do tabulky DynamoDB. Je jasné, že kromě výchozích oprávnění by měla mít tato lambda přístup k čtení datového proudu Kinesis a zápisu do DynamoDB.
Vytvoření IAM role pro lambda funkci collector
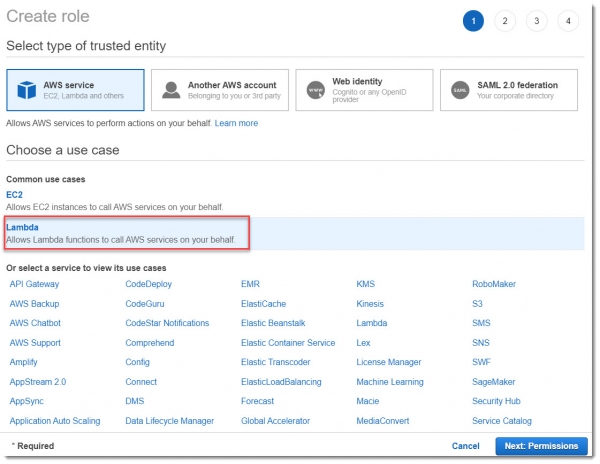
Nejprve vytvoříme novou IAM roli pro lambdu s názvem Lambda-TicketsProcessingRole:
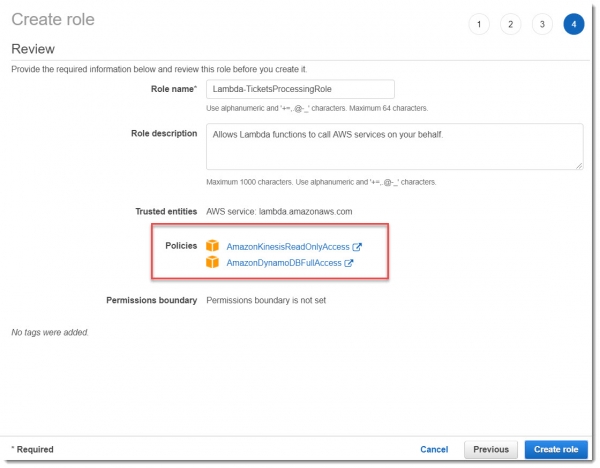
Pro testovací příklad stačí přednastavené politiky AmazonKinesisReadOnlyAccess a AmazonDynamoDBFullAccess, jak je znázorněno na obrázku níže:
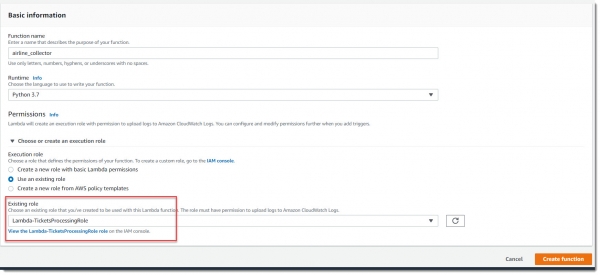
Tato lambda by měla být spuštěna pomocí spouštěče od Kinesis při přidání nových záznamů do proudu airline_stream, proto je potřeba přidat nový spouštěč:
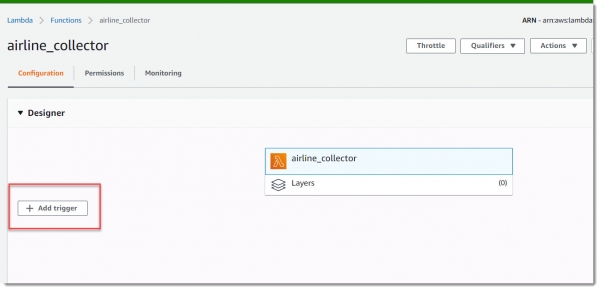
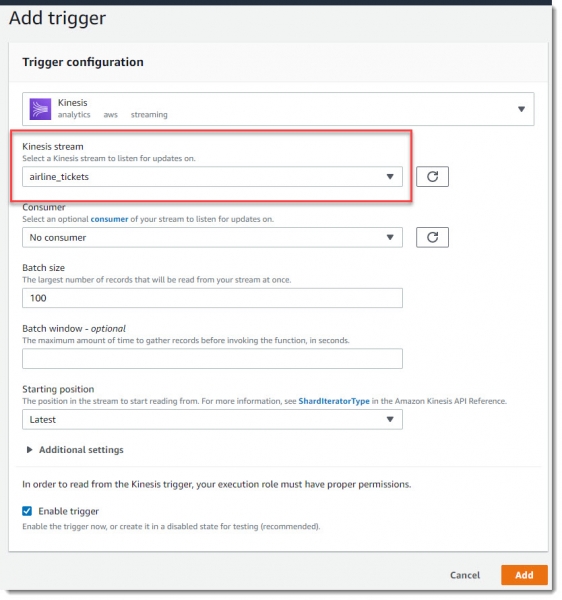
Teď stačí vložit kód a uložit lambdu.
"""Zpracování proudu a vložení do tabulky DynamoDB."""
import base64
import json
import boto3
from decimal import Decimal

DYNAMO_DB = boto3.resource('dynamodb')
TABLE_NAME = 'airline_tickets'

class TicketsParser:
    """Zpracování informací z proudu."""

    def __init__(self, table_name, records):
        """Inicializační metoda."""
        self.table = DYNAMO_DB.Table(table_name)
        self.json_data = TicketsParser.get_json_data(records)

    @staticmethod
    def get_json_data(records):
        """Vrátí deserializovaná data z proudu."""
        decoded_record_data = ([base64.b64decode(record['kinesis']['data'])
                                for record in records])
        json_data = ([json.loads(decoded_record)
                      for decoded_record in decoded_record_data])
        return json_data

    @staticmethod
    def get_item_from_json(json_item):
        """Předzpracování json dat."""
        new_item = {
            'record_id': json_item.get('record_id'),
            'cost': Decimal(json_item.get('cost')),
            'trip_class': json_item.get('trip_class'),
            'show_to_affiliates': json_item.get('show_to_affiliates'),
            'origin': json_item.get('origin'),
            'number_of_changes': int(json_item.get('number_of_changes')),
            'gate': json_item.get('gate'),
            'found_at': json_item.get('found_at'),
            'duration': int(json_item.get('duration')),
            'distance': int(json_item.get('distance')),
            'destination': json_item.get('destination'),
            'depart_date': json_item.get('depart_date'),
            'actual': json_item.get('actual')
        }
        return new_item

    def run(self):
        """Hromadné vložení do tabulky."""
        with self.table.batch_writer() as batch_writer:
            for item in self.json_data:
                dynamodb_item = TicketsParser.get_item_from_json(item)
                batch_writer.put_item(dynamodb_item)

        print('Bylo přidáno ', len(self.json_data), ' položek')

def lambda_handler(event, context):
    """Zpracovat proud a vložit do tabulky DynamoDB."""
    print('Dostal událost:', event)
    parser = TicketsParser(TABLE_NAME, event['Records'])
    parser.run()
Vytvoření lambda funkce notifier
Druhá lambda funkce, která bude monitorovat druhý tok (special_stream) a zasílat oznámení do SNS, se vytváří obdobně. Tato lambda tedy musí mít přístup pro čtení z Kinesis a zasílání zpráv do určeného SNS tématu, které pak služba SNS odešle všem odběratelům tohoto tématu (e-mail, SMS atd.).
Vytvoření role IAM
Nejprve vytvoříme roli IAM Lambda-KinesisAlarm pro tuto lambdu a poté přiřadíme tuto roli pro vytvářenou lambdu alarm_notifier:
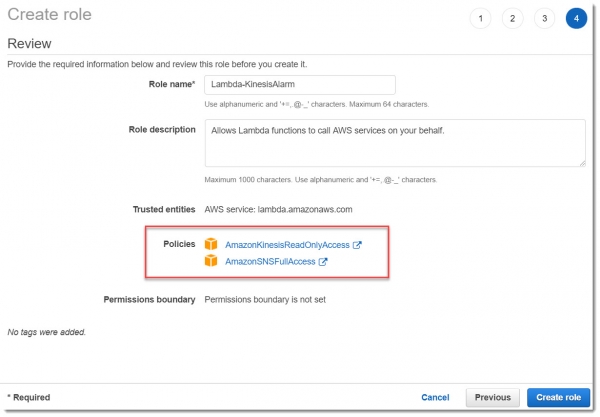
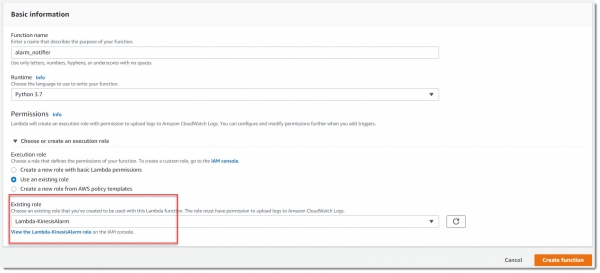
Tato lambda by měla fungovat podle spouštěče při příjmu nových záznamů do toku special_stream, proto je nutné nastavit spouštěč obdobně, jak jsme to udělali pro lambdu Collector.
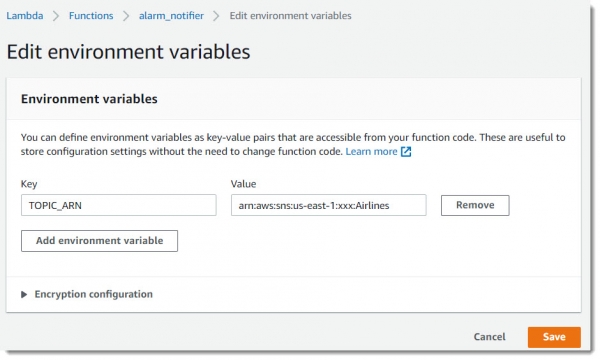
Pro snadné nastavení této lambdy zavedeme novou proměnnou prostředí — TOPIC_ARN, do které vložíme ANR (Amazon Resource Names) tématu Airlines:
A vložíme kód lambdy, který je docela jednoduchý:
import boto3
import base64
import os

SNS_CLIENT = boto3.client('sns')
TOPIC_ARN = os.environ['TOPIC_ARN']


def lambda_handler(event, context):
    try:
        SNS_CLIENT.publish(TopicArn=TOPIC_ARN,
                           Message='Ahoj! Našel jsem zajímavé věci!',
                           Subject='Alarm na letenky')
        print('Alarmová zpráva byla úspěšně doručena')
    except Exception as err:
        print('Chyba doručení', str(err))
Zdá se, že tímto byla manuální konfigurace systému dokončena. Zbývá jen otestovat a ujistit se, že jsme vše nastavili správně.
Nasazení z kódu Terraform
Potřebná příprava
— velmi užitečný open-source nástroj pro nasazení infrastruktury z kódu. Má svůj vlastní syntax, který je snadno pochopitelný, a množství příkladů, jak a co nasadit. V editoru Atom nebo Visual Studio Code je mnoho užitečných doplňků, které usnadňují práci s Terraform.
Distribuci si můžete stáhnout . Podrobná analýza všech možností Terraformu přesahuje rámec tohoto článku, a proto se omezíme na hlavní body.
Jak spustit
Celý kód projektu se nachází . Klonujeme si repozitář. Před spuštěním je nutné se ujistit, že máte nainstalovaný a nakonfigurovaný AWS CLI, protože Terraform bude hledat přihlašovací údaje v souboru ~/ .aws / credentials.
Dobrou praxí je před nasazením celé infrastruktury spustit příkaz plan, abychom zjistili, co nám Terraform nyní vytvoří v cloudu:
terraform.exe planBude nabídnuta možnost zadat telefonní číslo pro zasílání oznámení na něj. V této fázi není nutné jej zadávat.
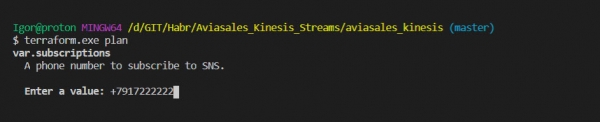
Po analýze plánu práce programu můžeme spustit vytváření zdrojů:
terraform.exe applyPo odeslání tohoto příkazu se znovu zobrazí výzva k zadání telefonního čísla, zadáme „yes“, když se zobrazí otázka o skutečném provedení akce. To umožní zvednout celou infrastrukturu, provést veškeré potřebné nastavení EC2, nasadit lambda funkce atd.
Jakmile budou všechny zdroje úspěšně vytvořeny pomocí kódu Terraform, je třeba přejít do detailů aplikace Kinesis Analytics (bohužel jsem nenašel, jak to udělat přímo z kódu).
Spouštíme aplikaci:
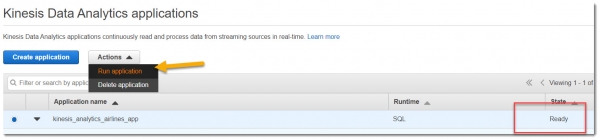
Poté je třeba výslovně zadat in-application stream name, výběrem z rozbalovacího seznamu:
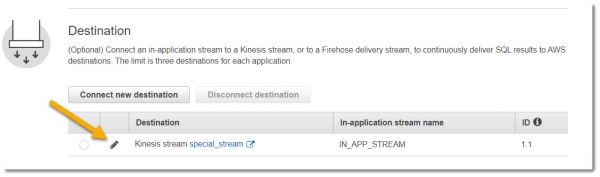
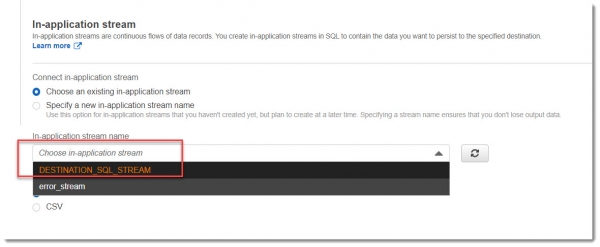
Nyní je vše připraveno k práci.
Testování fungování aplikace
Bez ohledu na to, jak jste systém nasadili, ručně nebo prostřednictvím kódu Terraform, bude fungovat stejně.
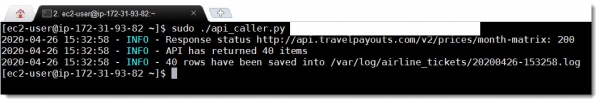
Přihrajte se přes SSH na virtuální stroj EC2, kde je nainstalován Kinesis Agent, a spusťte skript api_caller.py
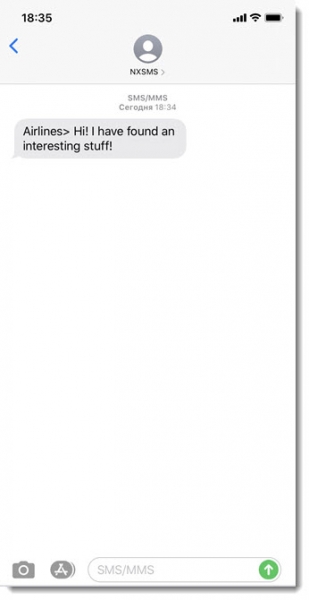
sudo ./api_caller.py TOKENZbývá počkat na SMS na vašem čísle:
SMS – zpráva dorazí na telefon prakticky během 1 minuty:
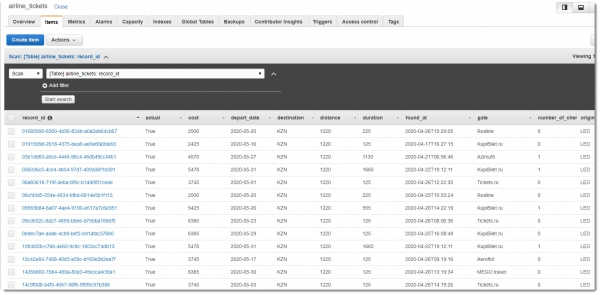
Je potřeba se podívat, zda se záznamy uložily do databáze DynamoDB pro následnou, podrobnější analýzu. Tabulka airline_tickets obsahuje přibližně tato data:
Závěr
Během vykonané práce jsme postavili systém online zpracování dat založený na Amazon Kinesis. Byly prozkoumány možnosti využití Kinesis Agent ve spojení s Kinesis Data Streams a real-time analýzou Kinesis Analytics pomocí SQL příkazů, stejně jako interakce Amazon Kinesis s dalšími službami AWS.
Výše popsaný systém jsme nasadili dvěma způsoby: dostatečně dlouhým ručním a rychlým pomocí kódu Terraform.
Celý zdrojový kód projektu je k dispozici , doporučuji se s ním seznámit.
Rád bych diskutoval o článku, čekám na vaše komentáře. Doufám v konstruktivní kritiku.
Přeji hodně úspěchů!
Zdroj: habr.com
