

V současné době existují hotová (proprietární) řešení pro monitoring IP(TS) toků, například a , která mají dostatečně bohatou sadu funkcí a obvykle taková řešení mají velcí operátoři, kteří se zabývají televizními službami. V tomto článku je popsáno řešení na bázi open source projektu , určené pro minimální kontrolu IP(TS) toků podle čítače CC (continuity counter) a bitrate. Možným způsobem použití je kontrola ztráty paketů nebo celého toku prostřednictvím pronajatého L2 kanálu (který není možné normálně monitorovat, například čtením čítačů ztrát ve frontách).
Velmi krátce o TSDuck
TSDuck je open source (licence 2-Clause BSD) software (sada konzolových utilit a knihovna pro vyvíjení vlastních utilit nebo pluginů) pro manipulaci s TS toky. Jako vstup umí pracovat s IP (multicast/unicast), http, hls, dvb tunery, dektec dvb-asi demodulátorem, má interní generátor TS toku a čtení z souborů. Jako výstup může být zápis do souboru, IP (multicast/unicast), hls, dektec dvb-asi a HiDes modulátory, přehrávače (mplayer, vlc, xine) a drop. Mezi vstupem a výstupem lze vložit různé procesory dopravy, například remapping PID, provádět šifrování/dešifrování, analýzu CC čítačů, počítání bitrate a další typické operace pro TS toky.
V tomto článku budou jako vstupy použity IP toky (multicast), použijí se procesory bitrate_monitor (z názvu je jasné, co to je) a continuity (analýza CC čítačů). Bez problémů lze nahradit IP multicast jiným typem vstupu podporovaným TSDuck.
Existují TSDuck pro většinu aktuálních operačních systémů. Pro Debian nejsou k dispozici, ale podařilo se bez problémů sestavit pod debian 8 a debian 10.
Dále se používá verze TSDuck 3.19-1520, operační systém je Linux (pro přípravu řešení byl použit debian 10, pro reálné použití — CentOS 7)
Příprava TSDuck a operačního systému
Než začnete sledovat skutečné toky, je důležité ověřit, že TSDuck funguje správně a nedochází k ztrátám na úrovni síťové karty nebo OS (socket). To je nezbytné, abyste později nemuseli hádat, kde k ztrátám došlo — na síti nebo „uvnitř serveru“. Ztráty na úrovni síťové karty lze zkontrolovat pomocí příkazu ethtool -S ethX, ladění se provádí také pomocí ethtool (obvykle je třeba zvýšit RX-buffer (-G) a někdy vypnout některé offloady (-K)). Jako obecné doporučení lze navrhnout používat samostatný port pro příjem analyzovaného provozu, pokud je to možné, což minimalizuje falešné poplachy spojené s tím, že k ztrátě došlo konkrétně na portu analyzátoru kvůli jinému provozu. Pokud taková možnost není (používá se mini-počítač/NUC s jedním portem), je velmi žádoucí nastavit prioritu analyzovaného provozu vůči ostatním na zařízení, do kterého je analyzátor připojen. Co se týče virtuálních prostředí, zde je třeba být opatrný a umět najít ztráty paketů od fyzického portu až po aplikaci uvnitř virtuálního stroje.
Generování a příjem toku uvnitř hostitele
Jako první krok přípravy TSDuck budeme generovat a přijímat provoz uvnitř jednoho hostitele pomocí netns.
Připravujeme prostředí:
ip netns add P #vytváříme netns P, v němž se bude analyzovat provoz
ip link add type veth #vytváříme veth-párování - veth0 zůstává v netns ve výchozím stavu (do tohoto rozhraní se generuje provoz)
ip link set dev veth1 netns P #veth1 - umisťujeme do netns P (na tomto rozhraní bude příjem provozu)
ip netns exec P ifconfig veth1 192.0.2.1/30 up #zvedáme IP na veth1, nezáleží na tom, jaké přesně
ip netns exec P ip ro add default via 192.0.2.2 #nastavujeme výchozí trasu uvnitř netns P
sysctl net.ipv6.conf.veth0.disable_ipv6=1 #vypínáme IPv6 na veth0 - to se dělá, aby se do počítadla TX nedostávalo nepotřebné pozadí
ifconfig veth0 up #zvedáme rozhraní veth0
ip route add 239.0.0.1 dev veth0 #vytváříme trasu, aby OS směřovala provoz k 239.0.0.1 směrem k veth0
Prostředí je připraveno. Spouštíme analyzátor provozu:
ip netns exec P tsp --realtime -t
 -I ip 239.0.0.1:1234
 -P continuity
 -P bitrate_monitor -p 1 -t 1
 -O drop
kde „-p 1 -t 1“ znamená, že je třeba počítat bit-rate každou sekundu a zobrazovat informace o bit-rate každou sekundu
Spouštíme generátor provozu se rychlostí 10Mbit/s:
tsp -I craft
 -P regulate -b 10000000
 -O ip -p 7 -e --local-port 6000 239.0.0.1:1234
kde „-p 7 -e“ znamená, že je třeba sbalit 7 TS paketů do 1 IP paketu a dělat to pevně (-e), tedy vždy čekat na 7 TS paketů od posledního procesu před odesláním formováním IP paketu.
Analizátor začíná vypisovat očekávané zprávy:
* 2020/01/03 14:55:44 - bitrate_monitor: 2020/01/03 14:55:44, TS bitrate: 9,970,016 bits/s
* 2020/01/03 14:55:45 - bitrate_monitor: 2020/01/03 14:55:45, TS bitrate: 10,022,656 bits/s
* 2020/01/03 14:55:46 - bitrate_monitor: 2020/01/03 14:55:46, TS bitrate: 9,980,544 bits/s
Nyní přidáváme trochu ztrát:
ip netns exec P iptables -I INPUT -d 239.0.0.1 -m statistic --mode random --probability 0.001 -j DROPa objevují se zprávy typu těchto:
* 2020/01/03 14:57:11 - continuity: packet index: 80,745, PID: 0x0000, missing 7 packets
* 2020/01/03 14:57:11 - continuity: packet index: 83,342, PID: 0x0000, missing 7 packets
což je očekávané. Vypínáme ztrátu paketů (ip netns exec P iptables -F) a zkusíme zvýšit bitrate generátoru na 100Mbit/s. Analizátor hlásí spoustu CC chyb a přibližně 75 Mbit/s místo 100. Pokoušíme se zjistit, kdo je za to zodpovědný – zda generátor nestíhá, nebo jestli je problém někde jinde, proto spouštíme generaci pevného množství paketů (700000 TS paketů = 100000 IP paketů):
# ifconfig veth0 | grep TX
       TX packets 151825460  bytes 205725459268 (191.5 GiB)
        TX errors 0  dropped 0 overruns 0  carrier 0  collisions 0
# tsp -I craft -c 700000 -P regulate -b 100000000 -P count -O ip -p 7 -e --local-port 6000 239.0.0.1:1234
* count: PID    0 (0x0000):    700,000 packets
# ifconfig veth0 | grep TX
        TX packets 151925460  bytes 205861259268 (191.7 GiB)
        TX errors 0  dropped 0 overruns 0  carrier 0  collisions 0
Jak je vidět, bylo vygenerováno přesně 100000 IP paketů (151925460-151825460). Zjistíme, co se děje s analizátorem, k tomu porovnáme s počítadlem RX na veth1, které je striktně rovno počítadlu TX na veth0, poté se podíváme, co se děje na úrovni socketu:
# ip netns exec P cat /proc/net/udp
  sl  local_address rem_address   st tx_queue rx_queue tr tm->when retrnsmt   uid  timeout inode ref pointer drops
  133: 010000EF:04D2 00000000:0000 07 00000000:00000000 00:00000000 00000000     0        0 72338 2 00000000e0a441df 24355
Zde je vidět počet ztrát = 24355. V TS paketech je to 170485 nebo 24.36% z 700000, vidíme tedy, že těchto 25% ztraceného bitrate je způsobeno ztrátami v udp socketu. Ztráty v UDP socketu obvykle vznikají z nedostatku bufferu, podíváme se, na jakou velikost bufferu socketu je ve výchozím nastavení a maximální velikost bufferu socketu:
# sysctl net.core.rmem_default
net.core.rmem_default = 212992
# sysctl net.core.rmem_max
net.core.rmem_max = 212992
Takže, pokud aplikace explicitně nepožaduje velikost bufferu, sockety jsou vytvářeny s bufferem o velikosti 208 Kb, ale pokud požádají o více, stejně neobdrží požadované množství. Vzhledem k tomu, že v tsp pro IP vstup lze nastavit velikost bufferu (—buffer-size), tak standardní velikost socketu nebudeme měnit, ale pouze nastavíme maximální velikost bufferu socketu a uvedeme velikost bufferu explicitně prostřednictvím argumentů tsp:
sysctl net.core.rmem_max=8388608
ip netns exec P tsp --realtime -t -I ip 239.0.0.1:1234 -b 8388608 -P continuity -P bitrate_monitor -p 1 -t 1 -O drop
S tímto laděním bufferu socketu nyní hlášený bitrate činí přibližně 100Mbit/s, CC chyby nejsou.
Podle spotřeby CPU samotnou aplikací tsp. Pro analýzu toku 10 Mbit/s bude potřeba 3-4 % CPU s jedním jádrem i5-4260U CPU @ 1.40 GHz, 100 Mbit/s – 25 %, 200 Mbit/s – 46 %. Při nastavení % ztráty paketů se zátěž na CPU prakticky nezvyšuje (ale může se snižovat).
Na výkonnějším hardwaru bylo možné bez problémů generovat a analyzovat toky přes 1 Gbit/s.
Testování na reálných síťových kartách
Po testování na páru veth je třeba vzít dva hosty nebo dva porty jednoho hosta, propojit porty mezi sebou, na jednom spustit generátor, na druhém analyzátor. Zde se žádná překvapení nekonala, ale ve skutečnosti to vše závisí na hardwaru, čím slabší, tím zajímavější to bude.
Použití získaných dat systémem monitorování (Zabbix)
Aplikace tsp nemá žádné machine-readable API jako SNMP nebo podobné. Zprávy CC je třeba agregovat alespoň po 1 sekundě (při vysokém procentu ztráty paketů, může jich být stovky/tisíce/desítky tisíc za sekundu, závisí na bitovém toku).
Takže, abychom uchovali jak informace, tak nakreslili grafy o CC-chybách a bitovém toku a provedli nějaké havárie, mohou být následující možnosti:
- Rozparsovat a agregovat (podle CC) výstup tsp, t.j. převést ho do požadované formy.
- Upravit samotný tsp a/nebo procesorové pluginy bitrate_monitor a continuity, aby výsledek byl ve machine-readable formátu vhodném pro systém monitorování.
- Napsat svou aplikaci nad knihovnou tsduck.
Je zřejmé, že z hlediska pracovního zatížení je varianta 1 nejjednodušší, zejména vzhledem k tomu, že samotný tsduck je napsán v nízkoúrovňovém (podle moderních měřítek) jazyce (C++)
Jednoduchý prototyp parseru+agregátoru na bash ukázal, že při toku 10 Mbit/s a 50% ztrátě paketů (nejhorší scénář) proces bash spotřebovával 3-4krát více CPU než samotný proces tsp. Takový vývoj událostí je nepřijatelný. Vlastně kousek tohoto prototypu je níže.
Noodle na bash
#!/usr/bin/env bash

missingPackets=0
ccErrorSeconds=0
regexMissPackets='^* (.+) - continuity:.*missing ([0-9]+) packets$'
missingPacketsTime=""

ip netns exec P tsp --realtime -t -I ip -b 8388608 "239.0.0.1:1234" -O drop -P bitrate_monitor -p 1 -t 1  -P continuity 2>&1 |
while read i
do
    #line example:* 2019/12/28 23:41:14 - continuity: packet index: 6,078, PID: 0x0100, missing 5 packets
    #line example 2: * 2019/12/28 23:55:11 - bitrate_monitor: 2019/12/28 23:55:11, TS bitrate: 4,272,864 bits/s
    if [[ "$i" == *continuity:* ]]
    then
        if [[ "$i" =~ $regexMissPackets ]]
        then
            missingPacketsTimeNew="${BASH_REMATCH[1]}" #timestamp (seconds)
            if [[ "$missingPacketsTime" != "$missingPacketsTimeNew" ]] #new second with CC error
            then
                ((ccErrorSeconds += 1))
            fi
            missingPacketsTime=$missingPacketsTimeNew
            packets=${BASH_REMATCH[2]} #TS missing packets
            ((missingPackets += packets))
        fi
    elif [[ "$i" == *bitrate_monitor:* ]]
    then
        : #...
    fi
done
Kromě toho, že to funguje nepřijatelně pomalu, v bash chybí normální vlákna, bash jobs jsou samostatné procesy a musel jsem jednou za sekundu zapisovat hodnotu missingPackets na vedlejším efektu (při přijímání zprávy o bitrate, které přicházejí každou sekundu). Nakonec byl bash ponechán na pokoji a bylo rozhodnuto napsat obálku (parser+agregátor) v golangu. Spotřeba CPU obdobného kódu v golangu je 4-5krát menší než samotného procesu tsp. Zrychlení obálky výměnou bash za golang bylo přibližně 16krát a celkový výsledek je přijatelný (overhead na CPU v nejhorším případě 25%). Zdrojový soubor v golangu se nachází .
Spuštění obálky
Pro spuštění obálky byl vytvořen nejsnazší šablonový servis pro systemd (). Předpokládá se, že samotná obálka byla zkompilována do spustitelného souboru (go build tsduck-stat.go), umístěného v /opt/tsduck-stat/. Předpokládá se, že se používá golang s podporou monotonic clock (>=1.9).
Pro vytvoření instance služby je potřeba provést příkaz systemctl enable tsduck-stat@239.0.0.1:1234, poté spustit pomocí systemctl start tsduck-stat@239.0.0.1:1234.
Objevování v Zabbixu
Aby Zabbix mohl provádět objevování spuštěných služeb, byl vytvořen (discovery.sh), v formátu potřebném pro Zabbix discovery, předpokládá se, že je umístěn tamtéž — v /opt/tsduck-stat. Aby bylo možné spouštět objevování přes zabbix-agenta, je třeba přidat do adresáře s konfiguracemi zabbix-agenta pro přidání uživatelského parametru.
Šablona Zabbixu
(tsduck_stat_template.xml) obsahuje pravidlo pro automatické objevování, prototypy datových prvků, grafů a spouštěčů.
Stručný kontrolní seznam (pro případ, že by se někdo rozhodl využít)
- Ujistit se, že tsp nedropuje pakety za "ideálních" podmínek (generátor a analyzátor připojeny přímo), pokud dochází k dropům, viz odst. 2 nebo text článku k tomu.
- Provedení ladění maximálního bufferu socketu (net.core.rmem_max=8388608).
- Zkompilovat tsduck-stat.go (go build tsduck-stat.go).
- Položit šablonu služby do /lib/systemd/system.
- Spustit služby pomocí systemctl, zkontrolovat, že se začínají objevovat počítadla (grep "" /dev/shm/tsduck-stat/*). Počet služeb podle počtu multicastových proudů. Může být potřeba vytvořit trasu k multicastové skupině, možná vypnout rp_filter nebo vytvořit trasu k source ip.
- Spustit discovery.sh, ujistit se, že generuje json.
- Předhodit konfiguraci zabbix-agenta, restartovat zabbix-agenta.
- Nahrajte šablonu do Zabbixu, aplikujte ji na hostitele, na kterém probíhá monitorování a je nainstalován Zabbix agent, počkejte přibližně 5 minut a podívejte se, zda se objevily nové datové položky, grafy a spouštěče.
Výsledek
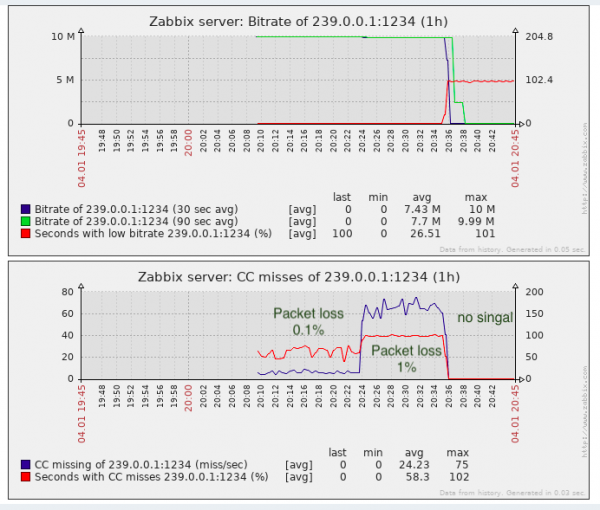
Pro úkol odhalení ztráty paketů je to téměř dostatečné, vlastně je to lepší než žádné monitorování.
Opravdu, CC-„ztráty“ mohou nastávat při spojování video fragmentů (což, jak mi je známo, se dělají vložení v místních televizních stanicích v RF, tj. bez přepočtu CC počítadla), na to je třeba pamatovat. V proprietárních řešeních je tento problém částečně obchován detekcí SCTE-35 značek (pokud je přidává generátor toku).
Z hlediska monitorování kvality přenosu chybí sledování jitter (IAT), protože televizní zařízení (ať už modulační zařízení nebo koncová zařízení) mají požadavky na tento parametr a ne vždy je možné nekonečně zvětšit jitbuffer. A jitter může kolísat, když je na trase použito zařízení s velkými buffery a QoS pro přenos obdobného realtime provozu není nastaveno nebo není dostatečně dobře nastaveno.
Zdroj: habr.com
