

Ahoj, Habr!
Pokračujeme v zkoumání tématu a , včetně úrovně databází. Dnes vám nabízíme článek o tom, proč by při návrhu velkých aplikací měla mít struktura databáze rozhodující význam, nikoli kód Java, jak se to dělá a jaká výjimky z tohoto pravidla existují.
V tomto poněkud opožděném článku vysvětlím, proč považuji za zásadní, aby byla datová model aplikace projektován "na základě databáze", a nikoli "na základě možností Javy" (nebo jiného klientského jazyka, se kterým pracujete). Výběr druhého přístupu vás postaví na dlouhou cestu bolesti a utrpení, jakmile váš projekt začne růst.
Článek byl napsán na základě , který byl položen na Stack Overflow.
Zajímavé diskuze na redditu v sekcích a .
Generace kódu
Jak moc jsem byl překvapen, že existuje tak malá skupina uživatelů, kteří se, po seznámení se s jOOQ, rozčilují nad tím, že při práci s jOOQ se vážně spoléhá na generaci zdrojového kódu. Nikdo vám nebrání používat jOOQ tak, jak uznáte za vhodné, a nenutí vás používat generaci kódu. Ale ve výchozím nastavení (jak je popsáno v dokumentaci) se práce s jOOQ provádí takto: začínáte s (zděděným) schématem databáze, provádíte jeho zpětné projektování pomocí generátoru kódu jOOQ, abyste tak získali sadu tříd představujících vaše tabulky, a následně píšete typově bezpečné dotazy na tyto tabulky:
	for (Record2 record : DSL.using(configuration)
//   ^^^^^^^^^^^^^^^^^^^^^^^ Informace o typech jsou odvozeny na
//   základě vygenerovaného kódu, na který se odkazuje uvedené
//   níže podmínka SELECT

       .select(ACTOR.FIRST_NAME, ACTOR.LAST_NAME)
//           vvvvv ^^^^^^^^^^^^  ^^^^^^^^^^^^^^^ vygenerovaná jména
       .from(ACTOR)
       .orderBy(1, 2)) {
    // ...
}
Kód se generuje buď ručně mimo sestavení, nebo ručně při každém sestavení. Například taková regenerace může následovat hned po .
Generace zdrojového kódu
S těmito přístupy k generování kódu – ručními a automatickými – jsou spojeny různé filozofie, výhody a nevýhody, které nehodlám podrobně rozebírat v tomto článku. Ale obecně je celá podstata generovaného kódu v tom, že umožňuje reprodukovat v Javě tu „pravdu“, kterou přijímáme jako danost, ať už v rámci našeho systému, nebo mimo něj. V jistém smyslu to samé dělají kompilátory, které generují bytecode, strojový kód nebo nějaký jiný typ kódu na základě zdrojových souborů – dostáváme zobrazení naší „pravdy“ v jiném jazyce, bez ohledu na konkrétní důvody.
Existuje mnoho takových generátorů kódu. Například, . Princip je vždy stejný:
- Existuje nějaká pravda (vnitřní nebo vnější) – například specifikace, datový model atd.
- Potřebujeme místní zobrazení této pravdy v našem programovacím jazyce.
A generovat takové zobrazení je téměř vždy rozumné – aby se předešlo nadbytečnosti.
Poskytovatelé typů a zpracování anotací
Na paměti: ještě jeden, modernější a specifičtější přístup k generování kódu pro jOOQ je spojen s použitím poskytovatelů typů, . V takovém případě je kód generován kompilátorem, vlastně v době kompilace. V podobě zdrojových kódů takový kód v zásadě neexistuje. V Javě existují podobné, i když ne tak elegantní nástroje – to jsou procesory anotací, například, .
V jistém smyslu se zde děje to samé jako v prvním případě, s výjimkou:
- Nevidíte generovaný kód (možná, že to někomu nepřipadá tak odrazující?)
- Musíte zaručit, že typy mohou být poskytovány, tedy „pravda“ musí být vždy dostupná. To je snadné v případě Lombok, který anotuje „pravdu“. O něco složitější je to s databázovými modely, jejichž fungování závisí na trvale dostupném živém připojení.
Jaký je problém s generováním kódu?
Kromě složité otázky, jak nejlépe spustit generaci kódu – ručně nebo automaticky – musíme také zmínit, že existují lidé, kteří věří, že generace kódu vůbec není potřeba. Nejčastější obhajoba tohoto názoru, se kterou jsem se setkal, spočívá v tom, že pak je obtížné nastavit sestavovací pipeline. Ano, skutečně je to složité. Vznikají další infrastrukturní náklady. Pokud právě začínáte pracovat s nějakým produktem (ať už jOOQ, JAXB, Hibernate atd.), čas strávený nastavením pracovního prostředí byste raději věnovali studiu samotného API, abyste z něj později dokázali vytěžit hodnotu.
Pokud jsou náklady spojené s porozuměním konstrukci generátoru příliš vysoké – pak je to skutečně známka špatné práce na použitelnosti API generátoru kódu (a nakonec se ukáže, že i uživatelské nastavení v něm je složité). Pohodlí používání by mělo být nejvyšším prioritou pro jakékoliv API. Ale to je jen jeden argument proti generaci kódu. Jinak je naprosto zbytečné psát lokální reprezentaci vnitřní či vnější pravdy úplně ručně.
Mnozí řeknou, že nemají čas se tím vším zabývat. Mají termíny pro dodání svých superproduktů. Někdy to napravíme s pipeline. Odpovím jim:
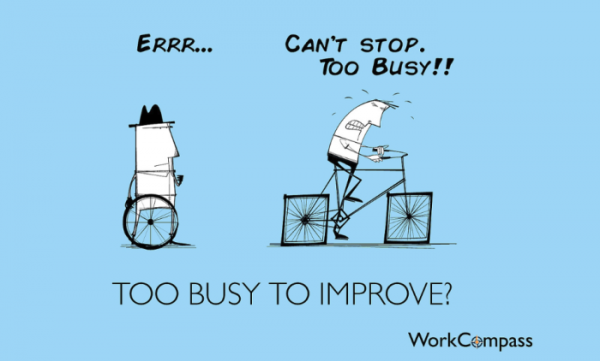
,
Ale v Hibernate / JPA je tak snadné psát kód „pro Java“.
Skutečně. Pro Hibernate a jeho uživatele to je zároveň požehnání i prokletí. V Hibernate můžete jednoduše napsat pár entit, takto:
	@Entity
class Book {
  @Id
  int id;
  String title;
}
A skoro je to hotové. Nyní je úkol Hibernate generovat složité „detaily“ toho, jak přesně tato entita bude definována v DDL vašeho „dialektu“ SQL:
	CREATE TABLE book (
  id INTEGER PRIMARY KEY GENERATED ALWAYS AS IDENTITY,
  title VARCHAR(50),

  CONSTRAINT pk_book PRIMARY KEY (id)
);

CREATE INDEX i_book_title ON book (title);
… a začneme spouštět aplikaci. Opravdu skvělá schopnost, jak rychle začít pracovat a vyzkoušet různé věci.
Ale počkejte. Řekl jsem to špatně.
- Bude Hibernate skutečně používat definici tohoto pojmenovaného primárního klíče?
- Vytvoří Hibernate index v TITLE? – přesně vím, že ho budeme potřebovat.
- A udělá Hibernate tento klíč identifikujícím v Identity Specification?
Pravděpodobně ne. Pokud vyvíjíte svůj projekt od nuly, je vždy výhodné jednoduše zahodit starou databázi a vytvořit novou, jakmile přidáte potřebné anotace. Tak bude entita Book vypadat nakonec takto:
	@Entity
@Table(name = "book", indexes = {
  @Index(name = "i_book_title", columnList = "title")
})
class Book {
  @Id
  @GeneratedValue(strategy = IDENTITY)
  int id;
  String title;
}
Super. Znovu vygenerovat. Opět bude v takovém případě na začátku velmi snadné.
Ale později za to budete muset zaplatit.
Dříve nebo později se budete muset dostat do produkce. Právě tehdy tento model přestane fungovat. Protože:
V produkci již nebude možné v případě potřeby zahodit starou databázi a začít vše od začátku. Vaše databáze se stane zděděnou.
Od této chvíle budete muset psát . A co se tedy stane s vašimi entitami? Můžete je buď ručně přizpůsobit (a tak zdvojnásobit objem práce), nebo přikázat Hibernate, aby je znovu vygeneroval pro vás (jak velké jsou šance, že vygenerované takovým způsobem bude odpovídat vašim očekáváním?) V každém případě prohráváte.
Takže jakmile přejdete do produkce, budete potřebovat horké opravy. A ty je potřeba rychle dostat do produkce. Protože jste se nepřipravili a neorganizovali hladké nasazení vašich migrací do produkce, všechno budete šíleně patchovat. A poté už nebudete mít čas udělat to správně. A budete nadávat na Hibernate, protože vinen je vždy někdo jiný, jen ne vy...
Místo toho se to mohlo od samého začátku dělat úplně jinak. Například dát na kolo kulatá kola.
Nejprve databáze.
Skutečná "pravda" v schématu vaší databáze a "suverenita" nad ní spočívá uvnitř databáze. Schéma je určeno pouze uvnitř samotné databáze a nikde jinde, a každý z klientů má kopii tohoto schématu, proto je zcela smysluplné prosazovat dodržování schématu a jeho integrity přímo v databázi – tam, kde jsou uloženy informace.
To je stará, dokonce opotřebovaná moudrost. Primární a unikátní klíče – to je dobré. Vnější klíče – to je dobré. Kontrola omezení – to je dobré. – to je dobré.
A co víc, to ještě není všechno. Například při použití Oracle pravděpodobně budete chtít uvést:
- Ve kterém tabulkovém prostoru se nachází vaše tabulka
- Jaká je její hodnota PCTFREE
- Jaká je velikost cache ve vaší sekvenci (za identifikátorem)
Možná to všechno není důležité v malých systémech, ale nemusíte čekat na přechod do oblasti „velkých dat“ — výhody z optimalizací úložiště od dodavatele můžete začít čerpat mnohem dříve. Žádný z ORM, které jsem viděl (včetně jOOQ), neposkytuje přístup k plnému spektru možností DDL, které možná budete chtít ve své databázi použít. ORM nabízejí některé nástroje, které usnadňují psaní DDL.
Ale nakonec dobře navržená schéma je ručně napsaná v DDL. Jakýkoli generovaný DDL je jen jejím přiblížením.
Co klientský model?
Jak bylo zmíněno výše, na klientovi budete potřebovat kopii schématu vaší databáze, klientské zobrazení. Je zbytečné zmiňovat, že toto klientské zobrazení by mělo být synchronizováno se skutečným modelem. Jak toho nejlépe dosáhnout? Pomocí generátoru kódu.
Všechny databáze poskytují svou meta-informaci prostřednictvím SQL. Zde je, jak získat ze své databáze všechny tabulky v různých dialektech SQL:
	-- H2, HSQLDB, MySQL, PostgreSQL, SQL Server
SELECT table_schema, table_name
FROM information_schema.tables

-- DB2
SELECT tabschema, tabname
FROM syscat.tables

-- Oracle
SELECT owner, table_name
FROM all_tables

-- SQLite
SELECT name
FROM sqlite_master

-- Teradata
SELECT databasename, tablename
FROM dbc.tables
Tyto dotazy (nebo podobné, v závislosti na tom, zda je třeba rovněž zohlednit pohledy, materializované pohledy, funkce se tabulárním hodnotou) se také provádějí zavoláním z JDBC, nebo pomocí meta modulu jOOQ.
Z výsledků těchto dotazů lze poměrně snadno vygenerovat jakékoli klientské zobrazení modelu vaší databáze, bez ohledu na to, jaká technologie je na klientovi použita.
- Pokud používáte JDBC nebo Spring, můžete vytvořit sadu konstant typu String
- Pokud používáte JPA, můžete generovat vlastní entity
- Pokud používáte jOOQ, můžete vygenerovat meta-model jOOQ
V závislosti na tom, jaký objem možností nabízí vaše klientské API (např. jOOQ nebo JPA), může být vygenerovaný meta-model skutečně bohatý a kompletní. Vezměme si například možnost implicitních spojení, , která se opírá o vygenerované metainformace o vztazích cizích klíčů mezi vašimi tabulkami.
Nyní jakékoli zvýšení databáze automaticky povede k aktualizaci klientského kódu. Představte si například:
ALTER TABLE book RENAME COLUMN title TO book_title;Opravdu byste chtěli tuto práci dělat dvakrát? Rozhodně ne. Stačí, když zachytíme DDL, projdeme jím váš buildovací pipeline a získáme aktualizovanou entitu:
@Entity
@Table(name = "book", indexes = {

  // Přemýšleli jste o tom?
  @Index(name = "i_book_title", columnList = "book_title")
})
class Book {
  @Id
  @GeneratedValue(strategy = IDENTITY)
  int id;

  @Column("book_title")
  String bookTitle;
}
Nebo aktualizovanou třídu jOOQ. Většina změn DDL se rovněž odráží v sémantice, nikoli pouze v syntaxi. Proto je někdy užitečné podívat se do zkompilovaného kódu, jaký kód bude (nebo může být) ovlivněn zvýšením vaší databáze.
Jedna jediná pravda
Bez ohledu na to, jakou technologii používáte, vždy existuje jeden model, který je jediným zdrojem pravdy pro určitou podsystém – nebo se alespoň musíme snažit tomu vyhnout a předejít takovému chaosu v podnicích, kde je "pravda" hned všude a nikde. Všechno může být mnohem jednodušší. Pokud pouze vyměňujete XML soubory s nějakým jiným systémem, využijte XSD. Podívejte se na metamodel INFORMATION_SCHEMA z jOOQ ve formátu XML:
- XSD je snadno pochopitelná
- XSD velmi dobře popisuje obsah XML a umožňuje validaci ve všech klientských jazycích
- XSD se dobře verzionuje a má vyvinutou zpětnou kompatibilitu
- XSD lze převést do Java kódu pomocí XJC
Poslední bod je důležitý. Při komunikaci s externím systémem pomocí XML zpráv chceme mít jistotu o platnosti našich zpráv. Toho lze snadno dosáhnout pomocí JAXB, XJC a XSD. Bylo by naprostým šílenstvím předpokládat, že při přístupu k návrhu „nejprve Java“, kde vytváříme naše zprávy jako objekty Java, je možné je nějak rozumně převést na XML a odeslat pro spotřebu v jiném systému. XML generované tímto způsobem by bylo velmi nekvalitní, nedokumentované a těžko udržovatelné. Kdyby pro takové rozhraní existovala dohoda o úrovni poskytování služeb (SLA), ihned bychom ji porušili.
Upřímně řečeno, právě to se neustále děje s API na JSON, ale to je jiný příběh, příště si postěžuju…
Databáze: to je totéž
Při práci s databázemi chápete, že všechny jsou v zásadě podobné. Databáze vlastní svá data a musí řídit schéma. Jakékoli změny provedené ve schématu musí být realizovány přímo na DDL, aby se aktualizoval jediný zdroj pravdy.
Když k aktualizaci zdroje dojde, všichni klienti by také měli aktualizovat své kopie modelu. Někteří klienti mohou být napsáni v Javě pomocí jOOQ a Hibernate nebo JDBC (nebo všech najednou). Jiní klienti mohou být napsáni v Perlu (přejeme jim hodně štěstí), další pak v C#. Na tom nezáleží. Hlavní model se nachází v databázi. Modely generované pomocí ORM jsou obvykle nekvalitní, špatně dokumentované a těžko udržovatelné.
Takže nedělejte chyby. Od začátku nedělejte chyby. Pracujte na základě databáze. Vytvořte takový pipeline pro nasazení, který lze automatizovat. Zařaďte generátory kódu, aby bylo pohodlné kopírovat model vaší databáze a předávat ho klientům. A přestaňte se obávat generátorů kódu. Jsou dobré. S nimi budete produktivnější. Stačí na začátku investovat trochu času do jejich nastavení – a pak na vás čekají roky zvýšené produktivity, které utvoří příběh vašeho projektu.
Zatím nepoděkujte, později.
Vysvětlení
Pro jasno: Tento článek rozhodně nepropaguje, že byste měli přizpůsobit celý systém modelu vaší databáze (t.j. doméně, obchodní logice atd.). V tomto článku se zaměřuji na to, že klientský kód, který interaguje s databází, by měl fungovat na základě modelu databáze, tak aby samotný kód neodrážel model databáze jako „první třídy“. Taková logika se obvykle nachází na úrovni přístupu k datům na vaší straně klienta.
V dvouvrstvých architekturách, které se dosud na mnoha místech udržely, může být takový model systému jedině možný. Nicméně ve většině systémů se úroveň přístupu k datům jeví jako „podtřídou“, která inkapsuluje model databáze.
Výjimky
Z každého pravidla existují výjimky a již jsem zmínil, že přístup primární databáze a generování zdrojového kódu může někdy být nevhodný. Zde je pár takových výjimek (pravděpodobně existují i jiné):
- Když je schéma neznámé a je nutné je odhalit. Například, pokud jste dodavatel nástroje, který pomáhá uživatelům zorientovat se v jakémkoli schématu. Uf. Tady bez generování kódu. Ale přesto – databáze je na prvním místě.
- Když musí být schéma generováno za běhu pro řešení určitého úkolu. Tento příklad se zdá být poněkud vytříbenou verzí vzoru , t.j. opravdu nemáte jasně definované schéma. V tomto případě často ani není možné být si jisti, že vám bude nějaký RDBMS vyhovovat.
Výjimky jsou svým způsobem výjimečné. Většinou, co se týče používání RDBMS, je schéma známo dopředu, nachází se uvnitř RDBMS a je jediným zdrojem „pravdy“, a všichni klienti musí mít kopie, které z ní vycházejí. Ideálně by měl být zapojen generátor kódu.
Zdroj: habr.com
