

Prázdniny skončily a my se vracíme s naším druhým příspěvkem ze série o Istio Service Mesh.
Dnešní téma – Circuit Breaker, což v elektrické terminologii znamená „automatický vypínač“, v běžné řeči „ochranný automat“. Jenže v Istio tento automat nevypíná přetížený nebo zkratovaný obvod, ale vadné kontejnery.
Jak by to mělo fungovat ideálně
Když jsou mikroservisy řízeny Kubernetesem, například na platformě OpenShift, automaticky se škálují nahoru a dolů podle zatížení. Protože mikroservisy běží v podech, může na jednom koncovém bodě být současně několik instancí kontejnerizovaného mikroservisu, a Kubernetes bude směrovat požadavky a vyvažovat zátěž mezi nimi. A – ideálně – to vše by mělo fungovat skvěle.
Pamatujeme si, že mikroservisy jsou malé a efemérní. Efemérnost, která zde znamená jednoduchost vzniku a zániku, je často podceňována. Narození a smrt další instance mikroservisu v pode – to jsou zcela očekávané události, OpenShift a Kubernetes s tím dobře zacházejí a vše funguje skvěle – ale opět, to je teorie.
Jak to ve skutečnosti funguje
A teď si představte, že některá konkrétní instance mikroservisu, tedy kontejner, selhala: buď neodpovídá (chyba 503), nebo – což je horší – reaguje, ale příliš pomalu. Jinými slovy, má problémy s odezvou nebo neodpovídá na požadavky, ale z poolu není automaticky odstraněn. Co s tímto případem? Zkusit to znovu? Vyřadit ho z režimu směrování? A co znamená „příliš pomalu“ – kolik to je v číslech a kdo je určuje? Možná mu jednoduše dát pauzu a zkusit to později? Pokud ano, tak na jak dlouho?
Co je to Pool Ejection v Istio
A tady přichází na pomoc Istio se svými ochrannými automaty Circuit Breaker, které dočasně odstraňují vadné kontejnery z poolu zdrojů směrování a vyvažování zátěže, implementujíce proceduru Pool Ejection.
Pomocí strategie detekce odchylek (outlier detection) Istio detekuje křivé pode, které vybočují z normálu, a odstraňuje je z poolu zdrojů na stanovenou dobu, která se nazývá „spací okno“ (sleep window).
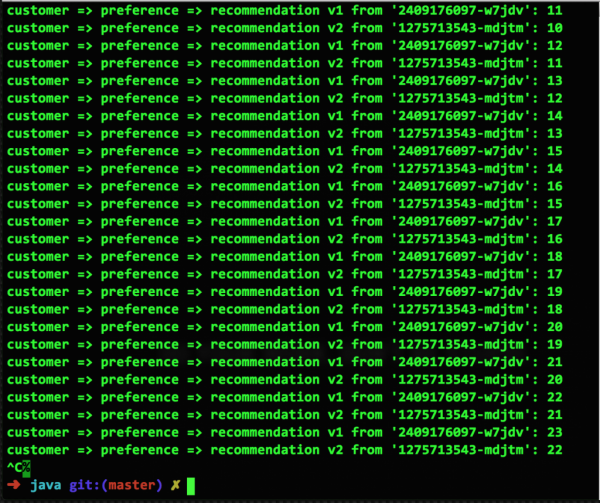
Aby ukázali, jak to funguje v Kubernetes na platformě OpenShift, začněme snímkem obrazovky normálně fungujících mikroslužeb z příkladu v repozitáři . Zde máme dvě pod, v1 a v2, přičemž v každém běží jeden kontejner. Když nejsou použita pravidla směrování Istio, Kubernetes ve výchozím nastavení aplikuje vyvážené cyklické směrování:
Připravujeme se na selhání
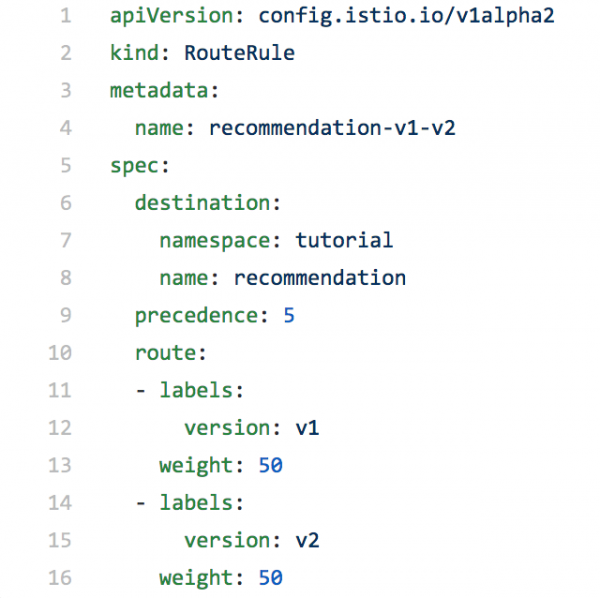
Než provedeme Pool Ejection, musíme vytvořit pravidlo směrování Istio. Předpokládejme, že chceme distribuovat požadavky mezi pod podle poměru 50/50. Navíc zvýšíme počet kontejnerů v2 z jednoho na dva, takto:
oc scale deployment recommendation-v2 --replicas=2 -n tutorial
Nyní definujeme pravidlo směrování, aby se provoz rozděloval mezi pod v poměru 50/50.
A zde vypadá výsledek tohoto pravidla:
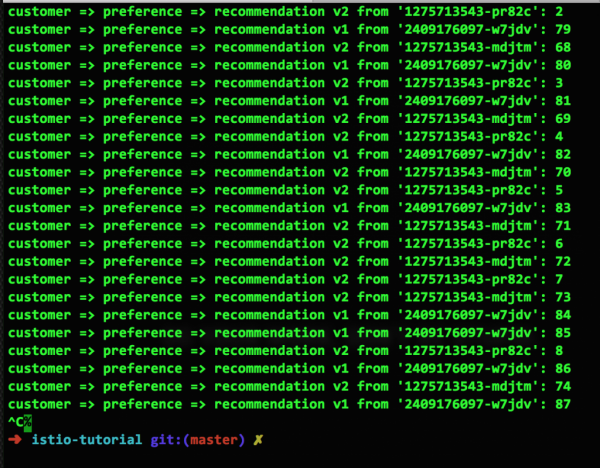
Můžeme namítnout, že na tomto snímku není 50/50, ale 14:9, ale časem se situace upraví.
Vytváříme selhání
A nyní vyřadíme jeden ze dvou kontejnerů v2, abychom měli jeden funkční kontejner v1, jeden funkční kontejner v2 a jeden nefunkční kontejner v2:
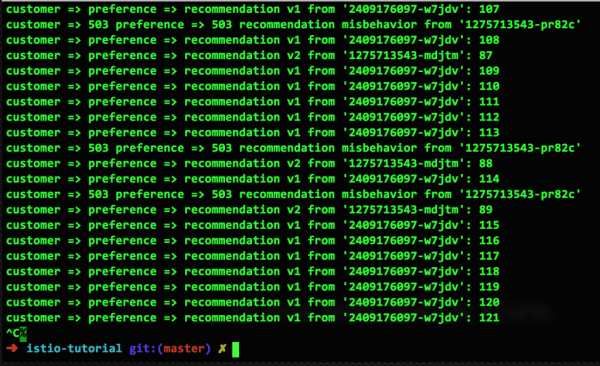
Oprava selhání
Takže máme nefunkční kontejner a nastal čas na Pool Ejection. S velmi jednoduchou konfigurací vyloučíme tento selhaný kontejner ze všech schémat směrování na 15 sekund s očekáváním, že se vrátí do funkčního stavu (buď se restartuje, nebo obnoví výkon). Takto vypadá tato konfigurace a výsledky jejího provedení:
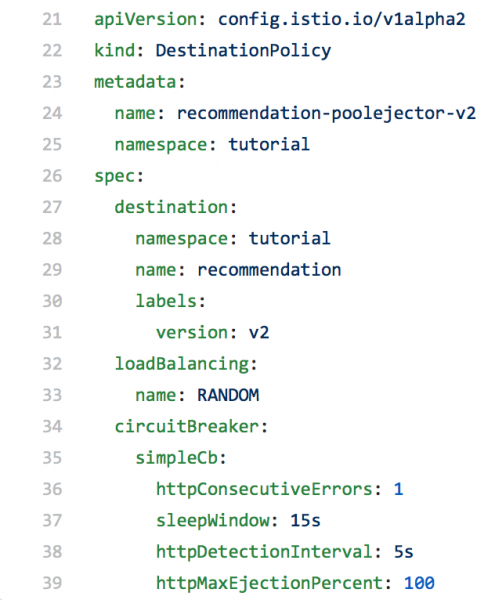
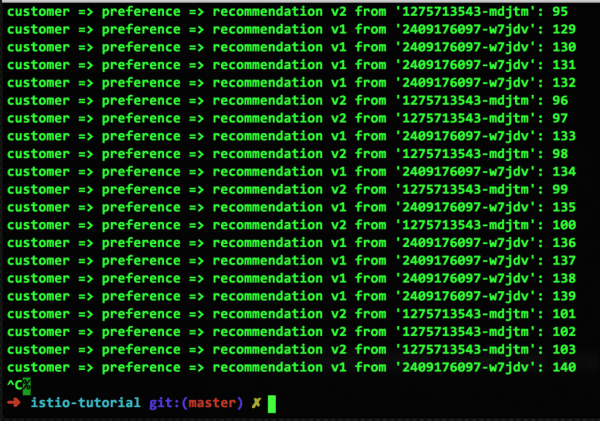
Jak vidno, nefunkční kontejner v2 již není používán při směrování požadavků, protože byl odstraněn z poolu. Po uplynutí 15 sekund se automaticky vrátí do poolu. Vlastně jsme právě ukázali, jak funguje Pool Ejection.
Začínáme stavět architekturu
Pool Ejection v kombinaci s monitorovacími schopnostmi Istio umožňuje začít budovat rámec automatické výměny nefunkčních kontejnerů, aby se minimalizovaly, nebo dokonce zcela eliminovaly prostoje a selhání.
NASA má jedno slavné heslo – Selhání není možností, jehož autorem je letový ředitel . Lze to přeložit jako „Porážka není možnost“, a smyslem je, že vše lze přimět k fungování, pokud máte dostatek vůle. V reálném životě se však selhání nevyskytují jen občas, jsou nevyhnutelná, všude a ve všem. Jak se tedy s nimi vypořádat v případě mikroslužeb? Z našeho pohledu je lepší spoléhat se nikoli na sílu vůle, ale na možnosti kontejnerů. , , a .
Jak jsme již výše psali, Istio dokonale implementuje osvědčený koncept automatických jističů. A stejně jako elektrický jistič odpojuje problémovou část obvodu, tak i programový Circuit Breaker v Istio přerušuje spojení mezi tokem požadavků a problémovým kontejnerem, když je s cílovým bodem něco v nepořádku, například když server spadne nebo začne zpomalovat.
A v druhém případě je problémů ještě více, protože zpomalení jednoho kontejneru nejenže způsobuje kaskádu zpoždění v obsluhovaných službách a tím snižuje výkon systému jako celku, ale také vyvolává opakované požadavky na jinak již pomalu fungující službu, což situaci jen zhoršuje.
Circuit Breaker v teorii
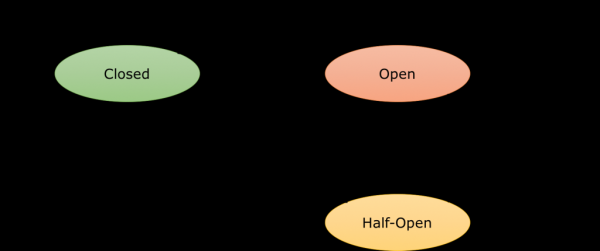
Circuit Breaker je proxy, která kontroluje tok požadavků k cílovému bodu. Když tento bod přestane fungovat nebo - v závislosti na nastavených parametrech - začne zpomalovat, proxy přeruší spojení s kontejnerem. Provoz je poté přesměrován na jiné kontejnery, prostě kvůli vyvážení zátěže. Spojení zůstává otevřené (open) po stanovenou dobu spánku, dejme tomu dvě minuty, a poté se považuje za polouzavřené (half-open). Pokus o odeslání dalšího požadavku určuje další stav spojení. Pokud je se službou vše v pořádku, spojení se vrátí do pracovního stavu a opět je uzavřeno (closed). Pokud je však se službou stále něco v nepořádku, spojení se opět přeruší a znovu se spouští doba spánku. Takto vypadá zjednodušený diagram změny stavů Circuit Breakeru:
Je důležité poznamenat, že se to všechno odehrává na úrovni, řekněme, systémové architektury. Proto vás v nějakém okamžiku bude muset naučit, aby vaše aplikace pracovaly s Circuit Breaker, například, aby v odpovědi poskytly výchozí hodnotu nebo, pokud je to možné, ignorovaly existenci služby. K tomu se používá vzor bulkhead, ale to překračuje rámec tohoto článku.
Circuit Breaker v praxi
Pro příklad spustíme na OpenShift dvě verze našeho microservisu doporučení. Verze 1 bude fungovat normálně, zatímco ve verzi 2 implementujeme zpoždění, abychom napodobili zpoždění na serveru. K zobrazení výsledků použijeme nástroj :
siege -r 2 -c 20 -v customer-tutorial.$(minishift ip).nip.io
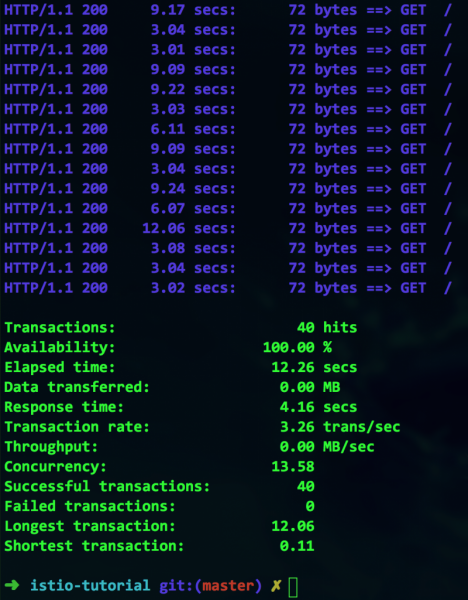
Všechno se zdá fungovat, ale jakou cenu to má? Na první pohled máme 100 % dostupnost, ale podívejte se blíže – maximální doba transakce je celých 12 sekund. To je jasné úzké místo, které je třeba rozšířit.
K tomu pomocí Istio vyloučíme přístupy k pomalým kontejnerům. Takhle vypadá příslušná konfigurace s použitím Circuit Breaker:
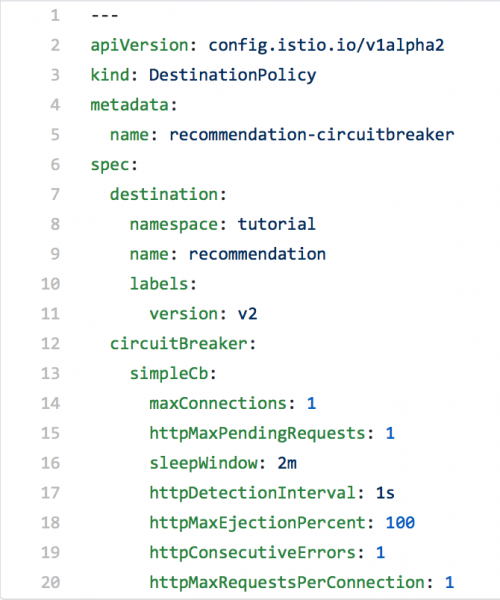
Poslední řádek s parametrem httpMaxRequestsPerConnection naznačuje, že spojení by se mělo přerušit při pokusu vytvořit další – druhé – spojení kromě již existujícího. Protože náš kontejner napodobuje zpomalující službu, takové situace budou občas vznikat, a pak Istio vrátí chybu 503, a co ukáže siege:
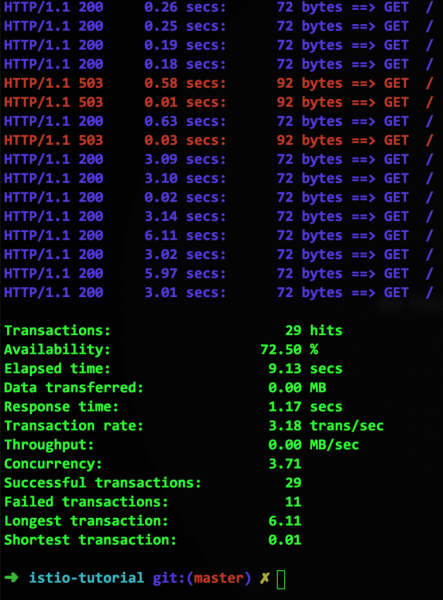
OK, máme Circuit Breaker, co dál?
Takže jsme implementovali automatické odpojení, aniž bychom se dotkli zdrojového kódu samotných služeb. Použitím Circuit Breaker a výše popsaného postupu Pool Ejection můžeme odstraňovat ze zdrojového fondu zpomalující kontejnery, dokud se nedostanou do normálu, a kontrolovat jejich stav v určených intervalech – v našem příkladu to jsou dvě minuty (parametr sleepWindow).
Všimněte si, že schopnost aplikace reagovat na chybu 503 se stále určuje na úrovni jejího zdrojového kódu. Existuje mnoho strategií pro práci s Circuit Breaker, které se používají podle situace.
V dalším příspěvku: budeme hovořit o trasování a monitorování, které jsou již zabudovány nebo je snadné je přidat do Istio, a také o tom, jak úmyslně způsobit chyby v systému.
Zdroj: habr.com
