

Od redaktora blogu Google: Zajímali jste se někdy o to, jak inženýři Google Cloud Technical Solutions (TSE) přistupují k vašim podáním žádostí o technickou podporu? Odpovědností inženýrů technické podpory TSE je identifikovat a řešit problémy, které uživatelé nahlásili. Některé z těchto problémů jsou poměrně jednoduché, ale někdy se objeví žádost, která vyžaduje pozornost několika inženýrů najednou. V tomto článku nám jeden z pracovníků TSE přiblíží velmi složitý problém ze své nedávné praxe — . Během tohoto vyprávění uvidíme, jak inženýrům povedlo situaci vyřešit a co nového se během odstranění chyby dozvěděli. Doufáme, že tento příběh vám nejen přiblíží hluboko zakořeněný bug, ale také poskytne přehled o procesech, které probíhají při podávání žádosti o podporu Google Cloud.
Odstraňování závad je zároveň věda i umění. Všechno začíná formulováním hypotézy o příčině nestandardního chování systému, po které následuje testování její platnosti. Nicméně před tím, než formulujeme hypotézu, musíme jasně definovat a přesně formulovat problém. Pokud otázka zní příliš neurčitě, budete muset vše důkladně analyzovat; v tom spočívá 'umění' odstraňování závad.
V podmínkách Google Cloud se tyto procesy mnohonásobně komplikují, protože Google Cloud se všemožně snaží zaručit soukromí svých uživatelů. Z tohoto důvodu nemají inženýři TSE přístup k úpravě vašich systémů ani nemusí mít tak široký přehled o konfiguracích, jak to dělají uživatelé. Proto k ověření jakékoli z našich hypotéz (inženýři) nemůžeme rychle modifikovat systém.
Někteří uživatelé si myslí, že všechny opravy provedeme jako mechanici v autoservisu a jednoduše nám zašlou id virtuálního stroje, zatímco ve skutečnosti probíhá proces formou konverzace: sběr informací, formulace a potvrzení (nebo vyvrácení) hypotéz, a nakonec je řešení problému založeno na komunikaci s klientem.
Zvažovaný problém
Dnes máme před sebou příběh s dobrým koncem. Jedním z důvodů úspěšného vyřešení daného případu je velmi podrobný a přesný popis problému. Níže můžete vidět kopii prvního tiketu (upravenou za účelem skrytí důvěrných informací):
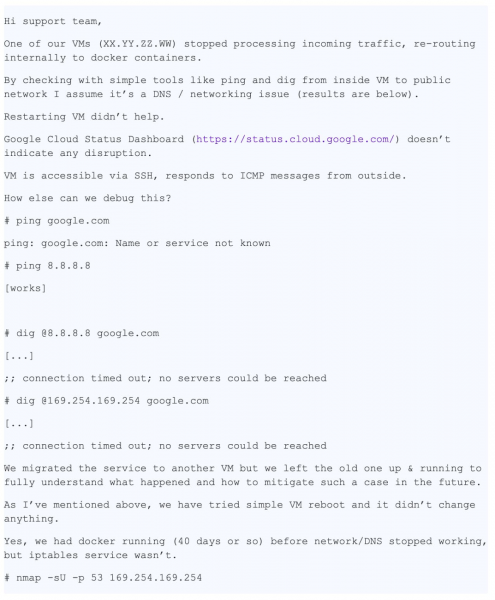
V této zprávě je velmi mnoho užitečných informací pro nás:
- Byla uvedena konkrétní VM
- Byl uveden samotný problém — nefunguje DNS
- Bylo uvedeno, kde se problém projevuje — VM a kontejner
- Byly uvedeny kroky, které uživatel podnikl pro určení problému
Žádost byla zařazena jako „P1: Kritický dopad — Služba nepoužitelná v produkci“, což znamená neustálou kontrolu situace 24/7 podle schématu „Follow the Sun“ (o prioritách uživatelských žádostí si můžete přečíst více ), s předáváním od jednoho týmu technické podpory k druhému při každém posunutí časových pásem. V podstatě, než se problém dostal k našemu týmu v Curychu, stihl obletět celý svět. Do té doby už uživatel přijal opatření k omezení následků, ale obával se opakování situace v produkci, protože hlavní příčina stále nebyla odhalena.
Ve chvíli, kdy tiket dorazil do Curychu, jsme už měli k dispozici následující informace:
- Obsah
/etc/hosts - Obsah
/etc/resolv.conf - Výstup
iptables-save - Sestavený týmem
ngrepsoubor pcap
S těmito daty jsme byli připraveni přistoupit k fázi „vyšetřování“ a odstraňování problémů.
Naše první kroky
Nejprve jsme zkontrolovali logy a stav serveru metadat a ujistili se, že funguje správně. Server metadat odpovídá IP adrese 169.254.169.254 a mimo jiné zajišťuje kontrolu nad názvy domén. Také jsme znovu zkontrolovali, že firewall správně funguje s VM a neblokuje pakety.
Byl to nějaký podivný problém: kontrola nmap vyvrátila naši hlavní hypotézu o ztrátě UDP paketů, proto jsme v mysli vytvořili ještě několik variant a způsobů jejich ověření:
- Ztrácí se pakety selektivně? => Zkontrolovat pravidla iptables
- Není příliš malý ? => Проверить вывод
ip a show - Zahrnuje problém pouze UDP pakety, nebo i TCP? => Spustit
dig +tcp - Vrací se generované dig pakety? => Spustit
tcpdump - Funguje libdns správně? => Spustit
stracek ověření přenosu paketů oběma směry
Zde se rozhodujeme telefonicky spojit s uživatelem za účelem odstranění problémů naživo.
Během hovoru se nám podaří ověřit několik věcí:
- Po několika kontrolách vylučujeme pravidla iptables ze seznamu příčin
- Ověřujeme síťové rozhraní a směrovací tabulky a znovu kontrolujeme správnost MTU
- Zjistíme, že
dig +tcp google.com(TCP) funguje, jak má, aledig google.com(UDP) nefunguje - Proběhneme
tcpdumpzatím fungujedig, zjišťujeme, že UDP pakety se vrací - Proháníme
strace dig google.coma vidíme, jak dig správně volásendmsg()arecvms(), ale druhé se přeruší kvůli timeoutu
Bohužel nastává konec směny a jsme nuceni předat problém do další časové zóny. Zároveň to vzbudilo zájem v našem týmu a kolega navrhuje vytvořit původní DNS paket pomocí Python modulu scrapy.
from scapy.all import *

answer = sr1(IP(dst="169.254.169.254")/UDP(dport=53)/DNS(rd=1,qd=DNSQR(qname="google.com")),verbose=0)
print ("169.254.169.254", answer[DNS].summary())
Tento fragment vytváří DNS paket a odesílá dotaz serveru metadat.
Uživatel spouští kód, DNS odpověď se vrací a aplikace ji přijímá, což potvrzuje, že na úrovni sítě není problém.
Po dalším "cestování kolem světa" se dotaz vrací k našemu týmu a zcela si ho přebírám, protože si myslím, že pro uživatele bude pohodlnější, pokud dotaz přestane bloudit sem a tam.
Mezitím uživatel ochotně souhlasí s poskytnutím snímku obrazu systému. To jsou velmi dobré zprávy: možnost testovat systém sám výrazně urychluje odstraňování chyb, protože už není třeba žádat uživatele, aby spouštěl příkazy, posílal mi výsledky a analyzoval je, vše mohu udělat sám!
Kolegové mi začínají trochu závidět. Při obědě probíráme dotaz, ale nikdo nemá nápad, co se děje. Naštěstí už samotný uživatel podnikl opatření k zmírnění problémů a nikam nespěchá, takže máme čas problém analyzovat. A protože máme obraz, můžeme provést všechny zajímavé testy. Skvělé!
Vrátíme se na krok zpět
Jedna z nejběžnějších otázek na pohovoru na pozici systémového inženýra zní: „Co se stane, když pingujete ?» Вопрос шикарный, так как кандидату необходимо описать пусть от оболочки до пользовательского пространства, до ядра системы и далее к сети. Я улыбаюсь: иногда вопросы с интервью оказываются полезны и в реальной жизни…
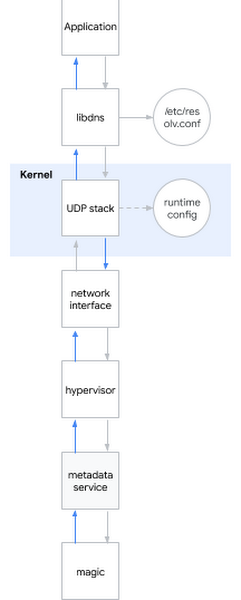
Rozhoduji se aplikovat tuto otázku pro aktuální problém. Zjednodušeně řečeno, když se pokoušíte určit DNS jméno, dochází k následujícímu:
- Aplikace volá systémovou knihovnu, například libdns
- libdns kontroluje konfiguraci systému, na který DNS server se má obrátit (na diagramu je to 169.254.169.254, server metadat)
- libdns používá systémové volání k vytvoření UDP soketu (SOKET_DGRAM) a přenosu UDP paketů s DNS dotazem oběma směry
- Pomocí rozhraní sysctl lze nastavit UDP stack na úrovni jádra
- Jádro komunikuje s hardwarem pro přenos paketů po síti prostřednictvím síťového rozhraní
- Hypervizor zachycuje a přenáší paket na server metadat při kontaktu s ním
- Server metadat svým uměním určuje DNS jméno a tímto způsobem vrací odpověď
Připomínám, jaké hypotézy jsme již stihli prozkoumat:
Hypotéza: Knihovny jsou poškozené
- Test 1: spustit v systému strace, zkontrolovat, že dig provádí správné systémové volání
- Výsledek: provádějí se správná systémová volání
- Test 2: pomocí srapy zkontrolovat, zda můžeme určovat jména bez systémových knihoven
- Výsledek: můžeme
- Test 3: provést rpm –V na balíčku libdns a md5sum souborech knihovny
- Výsledek: kód knihovny je zcela identický s kódem v pracovním operačním systému
- Test 4: připojit obraz kořenového systému uživatele na VM bez podobného chování, spustit chroot, podívat se, zda funguje DNS
- Výsledek: DNS funguje správně
Závěr na základě testů: problém není v knihovnách
Hypotéza: Existuje chyba v nastavení DNS
- Test 1: zkontrolovat tcpdump a pozorovat, zda jsou DNS pakety správně odesílány a přijímány po spuštění dig
- Výsledek: pakety jsou přenášeny správně
- Test 2: znovu zkontrolovat na serveru
/etc/nsswitch.confa/etc/resolv.conf - Výsledek: vše je v pořádku
Závěr na základě testů: problém není v konfiguraci DNS
Hypotéza: jádro je poškozené
- Test: nainstalovat nové jádro, zkontrolovat podpis, restartovat
- Výsledek: podobné chování
Závěr na základě testů: jádro není poškozené
Hypotéza: nesprávné chování uživatelské sítě (nebo rozhraní sítě hypervizora)
- Test 1: zkontrolovat nastavení firewallu
- Výsledek: firewall propouští DNS pakety jak na hostiteli, tak na GCP
- Test 2: zachytit provoz a sledovat správnost přenosu a návratu DNS dotazů
- Výsledek: tcpdump potvrzuje, že host obdržel zpětné pakety
Závěr na základě testů: problém není v síti
Hypotéza: server metadat nefunguje
- Test 1: zkontrolovat logy serveru metadat na anomálie
- Výsledek: v logech nejsou žádné anomálie
- Test 2: obejít server metadat přes
dig @8.8.8.8 - Výsledek: rozlišení selhává i bez použití serveru metadat
Závěr na základě testů: problém není v serveru metadat
Výsledek: o-testovali jsme všechny subsystémy kromě nastavení prostředí runtime!
Pohybujíc se v nastaveních runtime jádra
Pro konfiguraci prostředí runtime jádra můžete využít možnosti příkazového řádku (grub) nebo rozhraní sysctl. Podíval jsem se do /etc/sysctl.conf a představte si, našel jsem několik vlastních nastavení. Měl jsem pocit, že jsem se dostal k něčemu, tak jsem vyřadil všechna nesouvisející nebo non-tcp nastavení a zůstal jsem s hrstkou nastavení net.core. Pak jsem se obrátil tam, kde VM leží hostitelská oprávnění a začal aplikovat jednu po druhé, až jsem narazil na viníka:
net.core.rmem_default = 2147483647Tady to je, rozbíjející DNS konfigurace! Našel jsem nástroj zločinu. Ale proč to k tomu dochází? Ještě jsem potřeboval motiv.
Nastavení základní velikosti bufferu DNS paketů se provádí přes net.core.rmem_default. Typická hodnota se pohybuje někde kolem 200KiB, avšak pokud váš server přijímá mnoho DNS paketů, můžete zvýšit velikost bufferu. Pokud je buffer při příchodu nového paketu plný, například proto, že aplikace jej nedokáže dostatečně rychle zpracovat, začnete ztrácet pakety. Náš klient správně zvýšil velikost bufferu, protože se obával ztráty dat, jelikož používal aplikaci pro sběr metrik pomocí DNS paketů. Hodnota, kterou nastavil, byla maximálně možná: 231-1 (pokud nastavíte 231, jádro vrátí „INVALID ARGUMENT“).
Náhle jsem si uvědomil, proč nmap a scapy fungovaly správně: používaly syrové sokety! Syrové sokety se liší od běžných: fungují obcházením iptables a nebufferují se!
Ale proč „příliš velký buffer“ způsobuje problémy? Zjevně nefunguje tak, jak bylo zamýšleno.
V tomto okamžiku jsem byl schopen reprodukovat problém na několika jádrech a v mnoha distribucích. Problém se již projevoval na jádře 3.x a nyní se projevil i na jádře 5.x.
Opravdu, při spuštění
sysctl -w net.core.rmem_default=$((2**31-1))DNS přestával fungovat.
Začal jsem hledat pracovní hodnoty pomocí jednoduchého algoritmu binárního vyhledávání a zjistil jsem, že systém funguje s číslem 2147481343, ovšem toto číslo pro mě bylo bezvýznamnou řadou čísel. Navrhl jsem klientovi, aby to číslo vyzkoušel, a on mi odpověděl, že systém fungoval s google.com, avšak stále hlásil chybu s jinými doménami, proto jsem pokračoval ve svém vyšetřování.
Nainstaloval jsem , nástroj, který jsem měl použít dříve: ukazuje, kam přesně v jádru paket dopadá. Viníkem se ukázala funkce udp_queue_rcv_skb. Stáhl jsem si zdrojové kódy jádra a přidal několik pro sledování, kam konkrétně paket dopadá. Rychle jsem objevil nutnou podmínku if, a nějakou dobu jsem se na ni prostě díval, protože tehdy se konečně vše spojilo do celkového obrazu: 231-1, bezvýznamné číslo, nefungující doména… Problém byl v kuse kódu v __udp_enqueue_schedule_skb:
if (rmem > (size + sk->sk_rcvbuf))
		goto uncharge_drop;
Všimněte si:
rmemmá typ intsizemá typ u16 (nepodepsaný šestnáctibitový int) a uchovává velikost paketusk->sk_rcvbufmá typ int a uchovává velikost bufferu, která je z definice rovna hodnotě vnet.core.rmem_default
Když sk_rcvbuf se blíží k 231, sčítání velikosti paketu může vést k . A protože je to int, jeho hodnota se stává zápornou, tím pádem se podmínka stává pravdivou, když by měla být nepravdivou (více o tom si můžete přečíst v ).
Chyba se opravuje triviálním způsobem: přetypováním na unsigned int. Aplikoval jsem opravu a restartoval systém, po čemž DNS opět začal fungovat.
Chuť vítězství
Přeposlal jsem své nálezy klientovi a poslal patch jádra. Jsem spokojen: každý kousek skládačky do sebe zapadl, mohu přesně vysvětlit, proč jsme pozorovali to, co jsme pozorovali, a co je nejdůležitější, podařilo se nám najít řešení problému díky společné práci!
Musíme přiznat, že případ byl vzácný, a naštěstí k nám od uživatelů zřídka přicházejí takto složité požadavky.
Zdroj: habr.com
