

Jsem si jist, že titulek vyvolal zdravou reakci – „už zase začalo…“ Ale dovolte, abych upoutal vaši pozornost na 5-10 minut, a pokusím se nenaplnit očekávání.
Struktura článku bude následující: vezme se stereotypní tvrzení a rozebere se „povaha“ vzniku tohoto stereotypu. Doufám, že to umožní podívat se na výběr paradigmatu výměny dat ve vašich projektech z nového úhlu.
Abychom měli jasno v tom, co je RPC, navrhuji rozebírat standard . U REST není jasno. A ani by nemělo být. Všechno, co potřebujete vědět o REST – je, že není k rozeznání od .
RPC dotazy jsou rychlejší a efektivnější, protože umožňují provádět batch dotazy.
Jde o to, že v RPC můžete v jednom dotazu provést volání hned několika procedur. Například vytvořit uživatele, přidat mu avatar a ve stejném dotazu ho přihlásit k nějakým tématům. Pouze jeden dotaz, a kolik užitku!
Opravdu, pokud máte pouze jednu backendovou uzel, bude to vypadat rychleji při batch dotazu. Protože tři REST dotazy vyžadují třikrát více zdrojů od jedné uzlu na navazování spojení.
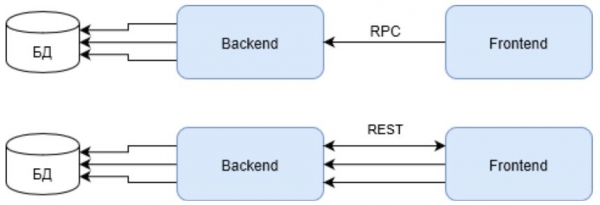
Všimněte si, že první dotaz v případě REST musí vrátit identifikátor uživatele pro provedení následujících dotazů. Což také negativně ovlivňuje celkový výsledek.
Ale takové infrastruktury lze potkat snad jen v in-house řešeních a Enterprise. V krajním případě v malých WEB projektech. Ale kompletní WEB řešení, a ještě nazývané HighLoad, by se takto stavět neměla. Jejich infrastruktura by měla splňovat kritéria vysoké dostupnosti a zatížení. A situace se mění.
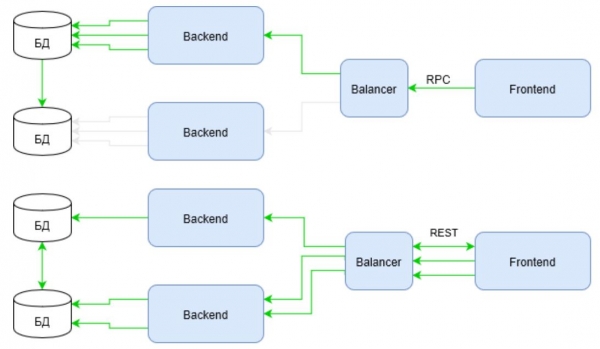
Zeleně jsou označeny kanály aktivity infrastruktury při stejném scénáři. Všimněte si, jak se nyní chová RPC. Dotaz využívá infrastrukturu pouze po jedné větvi od vyvažovače zatížení k backendu. Zatímco REST stále prohrává v prvním dotazu, ale dohání ztracené tím, že využívá celou infrastrukturu.
Stačí do scénáře zavést ne dva dotazy na obohacení, ale například pět nebo deset… a odpověď na otázku „kdo teď vyhrává?“ se stává nejasnou.
Nabídněte prozkoumat problém ještě šířeji. Na schématu je vidět, jak jsou využívány kanály infrastruktury, ale infrastruktura se neomezuje pouze na kanály. Důležitou součástí vysoce zatížené infrastruktury jsou cache. Pojďme nyní získat nějaký uživatelský artefakt. Několikrát. Řekněme 32krát.
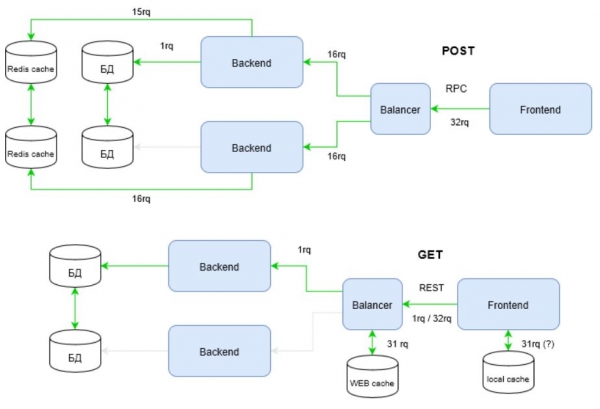
Podívejte se, jak se významně "vylepšila" infrastruktura u RPC, aby splnila požadavky na vysoké zatížení. Jde o to, že REST využívá veškerou sílu protokolu HTTP na rozdíl od RPC. Na uvedeném schématu je tato síla realizována prostřednictvím metody požadavku — GET.
Metody HTTP mají mimo jiné také strategie cachování. S nimi se můžete seznámit v dokumentaci na . Pro RPC se používají požadavky POST, které nejsou považovány za idempotentní, tedy opakované zasílání stejných požadavků POST může vracet různé výsledky (například po každém odeslání komentáře se objeví další kopie tohoto komentáře) ().
Proto RPC není schopno efektivně využívat infrastrukturní cache. To vede k tomu, že je nutné "přivádět" softwarové cache. Na schématu je v této roli uveden Redis. Softwarová cache zase vyžaduje od vývojáře dodatečnou kódovou vrstvu a značné změny v architektuře.
Pojďme nyní spočítat, kolik požadavků "zrodil" REST a RPC v zvažované infrastruktuře?
Požadavky
Příchozí
k backendu
k DBMS
k softwarové cache (Redis)
CELKEM
REST
1/32*
1
1
0
3 / 35
RPC
32
32
1
31
96
[*] v nejlepším případě (pokud je lokální cache použita) 1 požadavek (jeden!), v nejhorším 32 příchozích požadavků.
Ve srovnání s prvním schématem je rozdíl výrazný. Nyní je jasné, jaký prospěch přináší REST. Ale navrhuji se nezastavovat. Pokročilá infrastruktura zahrnuje CDN. Často také řeší otázku proti DDoS a DoS útokům. Získáme:
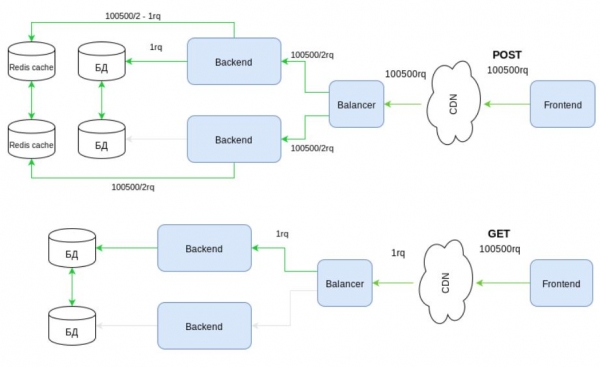
Pro RPC se situace stává opravdu nešťastnou. RPC prostě není schopno delegovat práci s zatížením CDN. Zůstává nám jen doufat v systémy protiútoků.
Může to být takto uzavřeno? A opět, ne. Metody HTTP, jak bylo již zmíněno, mají svou „magii“. A není náhodou, že metoda GET je v Internetu zcela využívaná. Všimněte si, že tato metoda může komunikovat s částí obsahu a nastavovat podmínky, které mohou interpretovat infrastruktury ještě před předáním řízení vašemu kódu atd. To vše umožňuje vytvářet flexibilní, řízené infrastruktury, které jsou schopné zpracovávat opravdu velké toky požadavků. A v RPC je tato metoda… ignorována.
Proč tedy přetrvává mýtus, že dávkové požadavky (RPC) jsou rychlejší? Osobně se domnívám, že většina projektů jednoduše nedosáhne takové úrovně vyspělosti, kdy REST dokáže ukázat svou sílu. Navíc, v menších projektech, častěji ukazuje své slabiny.
Volba mezi REST a RPC není osobní volbou jednotlivce v projektu. Tato volba by měla odpovídat požadavkům projektu. Pokud projekt dokáže vytěžit z REST všechno, co skutečně může, a to je skutečně potřeba, pak bude REST skvělou volbou.
Ale pokud bude potřeba najmout do projektu devopsy pro operativní rozšiřování infrastruktury, administrátory pro správu infrastruktury, architekta pro navrhování všech vrstev WEB služby, aby se získaly všechny výhody REST… a projekt prodává tři balíčky margarínu denně… zastavil bych se u RPC, protože tento protokol je více utilitární. Nevyžaduje hluboké znalosti o fungování cache a infrastruktury, ale soustředí vývojáře na jednoduché a srozumitelné výzvy potřebné procedury. Byznys bude spokojen.
RPC požadavky jsou spolehlivější, protože mohou vykonávat dávkové požadavky v rámci jedné transakce.
Tato vlastnost RPC je nepochybným plusem, protože snadno udržuje databázi v konzistentním stavu. S REST to je složitější. Požadavky mohou přicházet nesouvisle na různé uzly backendu.
Tato „nevýhoda“ REST je naopak stranou jeho výhody popsané výše — schopnost efektivně využívat všechny zdroje infrastruktury. Pokud je infrastruktura špatně navržena, a zejména pokud je špatně navržena architektura projektu a databáze zvlášť, pak je to skutečně velká bolest.
Ale jak spolehlivé jsou batch-dotazy, jak se zdají? Pojďme zvážit případ: vytvoříme uživatele, obohatíme jeho profil nějakým popisem a pošleme mu SMS s tajemstvím pro dokončení registrace. Tedy tři výzvy v jednom batch-dotazu.
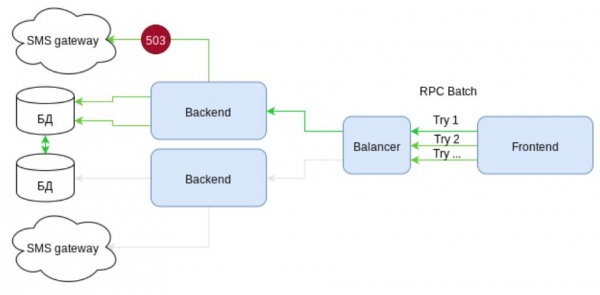
Zvažme schéma. Na něm je znázorněna infrastruktura s prvky vysoké dostupnosti. Existují dva nezávislé komunikační kanály se SMS bránami. Ale… co vidíme? Při odesílání SMS došlo k chybě 503 - služba je dočasně nedostupná. Vzhledem k tomu, že odesílání SMS je zabaleno v batch-dotazu, celý dotaz se musí vrátit. Akce v DB se zruší. Klient dostane chybu.
Další pokus je jako loterie. Buď dotaz opět skončí na té samé uzlu a znovu vrátí chybu, nebo má štěstí a úspěšně se provede. Ale hlavní je, že alespoň jednou naše infrastruktura už pracovala zbytečně. Zatížení bylo, ale zisk žádný.
Dobře, představme si, že jsme se snažili (!) a promysleli variantu, kdy může být dotaz úspěšně proveden částečně. A zbytek se pokusíme znovu provést po nějakém časovém intervalu (Jakém? To určuje front-end). Ale loterie zůstala. Dotaz na odeslání SMS má pravděpodobnost 50/50, znovu může selhat.
Souhlasíte, že z pohledu klienta služba nevypadá tak spolehlivě, jak bychom chtěli… a co REST?
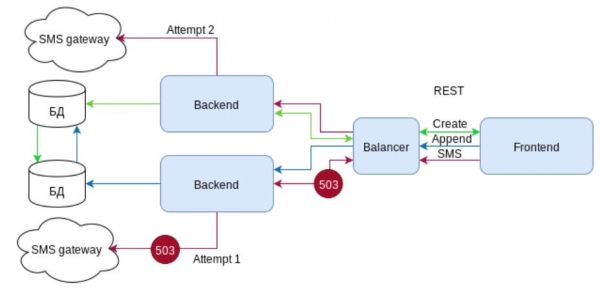
REST opět využívá "kouzlo" HTTP, ale nyní s kódy odpovědí. Při výskytu chyby 503 na SMS bráně backend tuto chybu přenáší na vyvažovač zátěže. Vyvažovač, dostávající tuto chybu a nepřerušující spojení s klientem, směruje dotaz na jinou uzlu, která úspěšně zpracovává dotaz. Tedy klient dostává očekávaný výsledek, zatímco infrastruktura potvrzuje svůj vysoký status "vysoké dostupnosti". Uživatel je šťastný.
A opět to není všechno. Vyvažovač nezískal pouze kód odpovědi 503. Tento kód při odpovědi je podle standardu doporučeno opatřit hlavičkou "Retry-After". Hlavička dává najevo vyvažovači, že by neměl obtěžovat tuto uzlu po tomto routu po stanovenou dobu. A další dotazy na odeslání SMS budou okamžitě směrovány na uzel, který nemá problémy se SMS bránou.
Jak vidíme, spolehlivost JSON-RPC je přeceňována. Opravu je snazší organizovat konzistenci v DB. Ale obětí v takovém případě bude spolehlivost systému jako celku.
Výstup je do značné míry podobný předchozímu. Když je infrastruktura jednoduchá, zřejmost JSON-RPC je určitě jeho výhodou. Pokud projekt předpokládá vysokou dostupnost s vysokou zátěží, REST se jeví jako správnější volba, i když je to složitější řešení.
Nízký vstupní práh pro REST
Myslím, že výše uvedená analýza, která vyvrací ustálené stereotypy o RPC, jasně ukázala, že vstupní práh pro REST je rozhodně vyšší než pro RPC. To souvisí s nutností hlubokého porozumění fungování HTTP, a také s nutností mít dostatečné znalosti o existujících infrastrukturních prvcích, které lze a měly by se používat v WEB projektech.
Tak proč si mnozí myslí, že REST bude jednodušší? Osobně se domnívám, že tato zdánlivá jednoduchost vychází ze samotných manifestů REST. Tedy REST není protokol, ale koncept… REST nemá standard, jsou tu pouze určitá doporučení… REST není složitější než HTTP. Zdánlivá svoboda a anarchie láká "svobodné umělce".
Rozhodně, REST není složitější než HTTP. Ale samotné HTTP je dobře promyšlený protokol, který prokázal svou životaschopnost po desetiletí. Pokud nemáte hluboké porozumění samotnému HTTP, nelze soudit ani o REST.
O RPC to platí - jednoduše si vezměte jeho specifikaci. Tak potřebujete ? Или все же хитрый REST? Решать вам.
Upřímně doufám, že jsem neztratil váš čas.
Zdroj: habr.com
