

Ahoj všichni. V tomto článku vám povím, proč jsme v Avitu před devíti měsíci zvolili Kafka, a co to vlastně představuje. Podělím se o jeden z případů použití — zasílání zpráv. A nakonec se podíváme na to, jaké výhody jsme získali z přístupu Kafka as a Service.
Problém
Nejprve trocha kontextu. Před nějakým časem jsme začali opouštět monolitní architekturu, a nyní má Avito již několik set různých služeb. Ty mají svá úložiště, svůj technologický stack a odpovídají za svou část obchodní logiky.
Jedním z problémů při velkém počtu služeb je komunikace. Služba A často chce znát informace, které má služba B. V tomto případě se služba A obrací na službu B přes synchronní API. Služba C chce vědět, co se děje u služeb G a D, a ty na oplátku mají zájem o služby A a B. Když je takových „zvědavých“ služeb mnoho, vazby mezi nimi se mění v zamotaný klubko.
Přitom v jakémkoli okamžiku může být služba A nedostupná. A co má v takovém případě dělat služba B a všechny ostatní služby na ní závislé? A pokud k vykonání obchodní operace musí provést řetězec sekvenčních synchronních volání, pravděpodobnost selhání celé operace se ještě zvyšuje (a tím je pravděpodobnost vyšší, čím delší je tento řetězec).
Výběr technologie
Dobře, problémy jsou jasné. Lze je vyřešit vytvořením centralizovaného systému výměny zpráv mezi službami. Nyní každá služba potřebuje vědět jen o tomto systému výměny zpráv. Navíc samotný systém by měl být odolný vůči selhání a horizontálně škálovatelný, a v případě poruchy by měl uchovávat v paměti frontu požadavků pro pozdější zpracování.
Nyní si vybereme technologii, na které bude realizováno doručování zpráv. Nejprve pochopíme, co od ní očekáváme:
- zprávy mezi službami by se neměly ztrácet;
- zprávy se mohou duplikovat;
- zprávy je možné uchovávat a číst až několik dní (persistenční fronta);
- služby se mohou přihlásit na data, která je zajímají;
- několik služeb může číst stejná data;
- zprávy mohou obsahovat podrobný, objemný payload (event-carried state transfer);
- někdy je potřeba záruka pořadí zpráv.
Je velmi důležité vybrat si co nejvíce škálovatelný a spolehlivý systém s vysokou propustností (minimálně 100k zpráv s několika kilobajty za sekundu).
V této fázi jsme se rozloučili s RabbitMQ (obtížné udržet stabilní při vysokých RPS), PGQ od SkyTools (nedostatečně rychlá a špatně škálovatelná) a NSQ (neperzistentní). Všechny tyto technologie používáme ve společnosti, ale pro daný úkol se nehodily.
Dále jsme začali zkoumat pro nás nové technologie — Apache Kafka, Apache Pulsar a NATS Streaming.
Prvním jsme se zbavili Pulsaru. Rozhodli jsme se, že Kafka a Pulsar jsou si navzájem dost podobné řešení. A přestože Pulsar byl otestován velkými společnostmi, je novější a nabízí nižší latenci (teoreticky), rozhodli jsme se z těchto dvou ponechat Kafku jako de facto standard pro takové úkoly. Pravděpodobně se k Apache Pulsaru vrátíme v budoucnu.
A tak zůstali dva kandidáti: NATS Streaming a Apache Kafka. Obě řešení jsme důkladně prozkoumali a obě vyhovovala úkolu. Nakonec nás však znepokojila relativní mladost NATS Streaming (a to, že jeden z hlavních vývojářů, Tyler Treat, se rozhodl projekt opustit a začít svůj vlastní — Liftbridge). Zároveň režim clusteringu NATS Streaming nenabízel silné horizontální škálování (pravděpodobně to už není problém po přidání particionování v roce 2017).
Nicméně, NATS Streaming je skvělá technologie napsaná v Go a má podporu Cloud Native Computing Foundation. Na rozdíl od Apache Kafka nepotřebuje Zookeeper k fungování (možná, ), protože vnitřně implementuje RAFT. Přitom je NATS Streaming jednodušší na administraci. Nevyjšujeme, že se k této technologii budeme v budoucnu ještě vracet.
A přesto dnes naším vítězem zůstává Apache Kafka. Na našich testech se ukázala jako dost rychlá (více než milion zpráv za sekundu při čtení a zápisu s objemem zprávy 1 kilobajt), dostatečně spolehlivá, dobře škálovatelná a ověřená ve výrobě velkými společnostmi. Kromě toho Kafka podporuje alespoň několik velkých komerčních společností (například používáme verzi Confluent) a Kafka má rozvinutý ekosystém.
Přehled Kafky
Než začnete, doporučuji skvělou knihu — „Kafka: The Definitive Guide“ (je také v ruském překladu, ale terminologie trochu mate). Můžete v ní najít informace potřebné pro základní pochopení Kafky a dokonce i něco víc. Samotná dokumentace od Apache a blog od Confluent jsou také skvěle napsány a snadno se čtou.
Tak se podívejme, jak Kafka funguje z ptačí perspektivy. Základní topologie Kafky se skládá z producer, consumer, broker a zookeeper.
Brokers
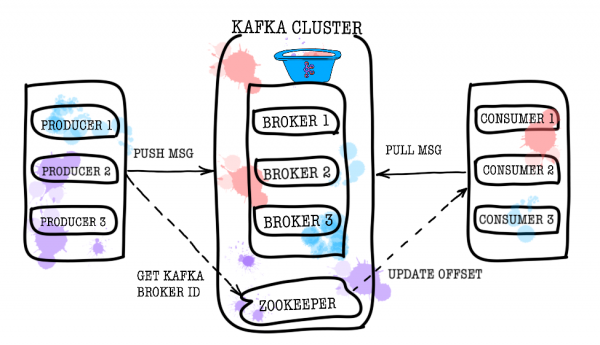
Za ukládání vašich dat odpovídá broker. Všechna data jsou uchovávána v binární podobě a broker má malou znalost o tom, co představují a jaká je jejich struktura.
Každý logický typ události obvykle sídlí ve svém samostatném topiku. Například událost vytvoření inzerátu může patřit do topiku item.created, zatímco událost jeho změny do item.changed. Topiky lze považovat za klasifikátory událostí. Na úrovni topiku lze nastavit takové konfigurační parametry, jako jsou:
- objem uchovávaných dat a/nebo jejich stáří (retention.bytes, retention.ms);
- faktor redundance dat (replication factor);
- maximální velikost jedné zprávy (max.message.bytes);
- minimální počet shodných replik, při kterém lze do topiku zapisovat data (min.insync.replicas);
- možnost provést failover na nesynchronizovanou zaostávající repliku s potenciální ztrátou dat (unclean.leader.election.enable);
- a ještě mnoho dalších ().
Na oplátku se každý topik dělí na jednu nebo více partií. Právě do partií nakonec události přicházejí. Pokud je v clusteru více než jeden broker, budou partitiony rovnoměrně rozloženy mezi všechny brokery (co nejvíce to půjde), což umožní škálování zátěže na zápis a čtení v jednom topiku na více brokerech najednou.
Na disku jsou data pro každou partition uchovávána ve formě segmentových souborů, které mají ve výchozím nastavení velikost jednoho gigabajtu (kontrolováno přes log.segment.bytes). Důležitý rys — odstraňování dat z partií (při vypršení retention) probíhá právě po segmentech (nelze odstranit jednu událost z partií, lze odstranit pouze celý segment, a to pouze neaktivní).
Zookeeper
Zookeeper funguje jako úložiště metadat a koordinátor. Právě on může říci, zda jsou brokři živí (na to se dá podívat očima zookeeper pomocí příkazu ls /brokers/ids), který z brokerů je kontroler (get /controller), jsou partitiony ve synchronním stavu se svými replikami (get /brokers/topics/topic_name/partitions/partition_number/state). Také k zookeeperu nejprve zamíří producer a consumer, aby zjistili, na kterém brokeru se nacházejí jaké topiky a partitiony. V případech, kdy je pro topik nastaven replication factor vyšší než 1, zookeeper určí, které partitiony jsou lídry (do nich se bude zapisovat a z nich také bude probíhat čtení). V případě pádu brokeru bude v zookeeperu zaznamenána informace o nových leader-partitionách (od verze 1.1.0 asynchronně, ).
Ve starších verzích Kafka zookeeper také odpovídal za ukládání offsetů, ale nyní jsou uloženy ve speciálním topiku __consumer_offsets na brokeru (i když stále můžete zookeeper používat k těmto účelům).
Nejjednodušší způsob, jak proměnit vaše data v dýni, je ztráta informací ze zookeeperu. V takovém scénáři bude velmi obtížné pochopit, co a odkud je třeba číst.
Producent
Producer je nejčastěji služba, která provádí přímé zapisování dat do Apache Kafka. Producer vybírá topik, ve kterém budou uloženy jeho tematické zprávy, a začíná do něj zapisovat informace. Například producentem může být služba pro inzeráty. V takovém případě bude odesílat do tematických topiků takové události, jako "inzerát vytvořen", "inzerát aktualizován", "inzerát smazán" atd. Každá událost přitom představuje pár klíč-hodnota.
Ve výchozím nastavení se všechny události rozdělují mezi partitiony topiku round-robinem, pokud není zadán klíč (ztrácí se pořadí), a pomocí MurmurHash (klíč), pokud klíč existuje (pořadí v rámci jedné partition).
Je zde třeba hned poznamenat, že Kafka zaručuje pořadí událostí pouze v rámci jedné partition. Ale ve skutečnosti to často není problém. Například lze zaručeně přidávat všechny změny jednoho a téhož inzerátu do jedné partition (tím se zachovává pořadí těchto změn v rámci inzerátu). Také je možné předávat pořadové číslo v jednom z polí události.
Consumer
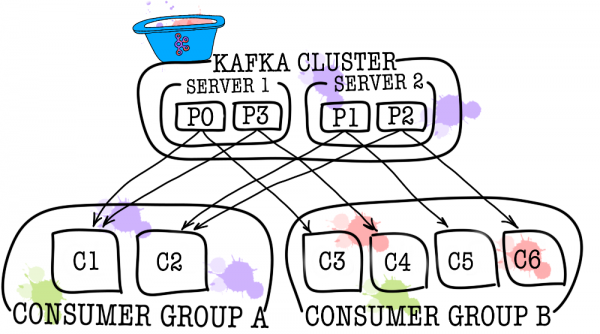
Consumer odpovídá za získávání dat z Apache Kafka. Pokud se vrátíme k výše uvedenému příkladu, consumer může být moderací služby. Tato služba se přihlásí k tématu služby inzerátů a při přidání nového inzerátu ho obdrží a analyzuje z hlediska souladu s určitými stanovenými politikami.
Apache Kafka si pamětá, jaké poslední události consumer obdržel (k tomu se používá pomocné téma __consumer__offsets), což zajišťuje, že při úspěšném čtení consumer neobdrží stejnou zprávu dvakrát. Nicméně, pokud se použije volba enable.auto.commit = true a úplně se svěřuje sledování polohy consumer v tématu Kafce, může dojít k . V produkčním kódu se většinou poloha consumera kontroluje ručně (vývojář řídí okamžik, kdy musí dojít k potvrzení přečtené události).
V případech, kdy jeden consumer nestačí (například když je proud nových událostí velmi velký), lze přidat několik dalších consumerů, které spojíme do consumer group. Consumer group logicky představuje stejný consumer, ale s rozdělením dat mezi členy skupiny. To umožňuje každému z účastníků vzít si svůj díl zpráv, čímž se zvyšuje rychlost čtení.
Výsledky testování
Tady nebudu psát moc vysvětlujícího textu, prostě se s vámi podělím o získané výsledky. Testování bylo provedeno na 3 fyzických strojích (12 CPU, 384 GB RAM, 15k SAS DISK, 10 GBit/s síť), což zahrnovalo brokery a zookeeper nasazené v lxc.
Testování výkonu
Během testování byly získány následující výsledky.
- Rychlost zápisu zpráv o velikosti 1 KB současně 9 producenty – 1300000 událostí za sekundu.
- Rychlost čtení zpráv o velikosti 1 KB současně 9 consumery – 1500000 událostí za sekundu.
Testování odolnosti proti chybám
Během testování byly získány následující výsledky (3 brokery, 3 zookeepery).
- Nepředvídané ukončení jednoho z brokerů nevede k zastavení nebo nedostupnosti clusteru. Práce pokračuje v běžném režimu, ale na zbývající brokery je kladena větší zátěž.
- Nehodové ukončení dvou brokerů ve třechbrokerovém clusteru s min.isr = 2 vede k nedostupnosti clusteru pro zápis, ale k dostupnosti pro čtení. V případě, že min.isr = 1, cluster zůstává dostupný jak pro čtení, tak pro zápis. Tento režim však odporuje požadavku na vysokou spolehlivost dat.
- Nehodové ukončení jednoho ze serverů Zookeeper nevede k zastavení nebo nedostupnosti clusteru. Práce pokračuje normálně.
- Nehodové ukončení dvou serverů Zookeeper vede k nedostupnosti clusteru do obnovení provozu alespoň jednoho ze serverů Zookeeper. Toto tvrzení platí pro cluster Zookeeper se třemi servery. V důsledku výzkumu bylo rozhodnuto zvýšit cluster Zookeeper na 5 serverů pro zvýšení odolnosti proti chybám.
Kafka jako služba
Ujistili jsme se, že Kafka je skvělá technologie, která nám pomohla vyřešit uvedený úkol (implementaci brokeru zpráv). Rozhodli jsme se však zakázat službám přímý přístup k Kafce a uzavřeli jsme ji nad službou data-bus. Proč jsme to udělali? Odpovědí je několik důvodů.
Data-bus převzal všechny úkoly spojené s integrací s Kafkou (implementace a nastavení consumerů a producerů, monitorování, alerting, logování, škálování apod.). Integrace s brokerem zpráv probíhá tímto způsobem co nejjednodušeji.
Data-bus umožnil abstrahovat od konkrétního jazyka nebo knihovny pro práci s Kafkou.
Data-bus umožnil ostatním službám abstrahovat od úložného slLayeru. Možná v nějakém okamžiku vyměníme Kafku za Pulsar a nikdo si ničeho nevšimne (všechny služby znají pouze API data-bus).
Data-bus převzal validaci schémat událostí.
S pomocí data-bus byla implementována autentizace.
Pod ochranou data-bus můžeme bez prostojů a nenápadně aktualizovat verze Kafky a centralizovaně spravovat konfigurace producerů, consumerů, brokerů atd.
Data-bus umožnil přidání potřebných funkcí, které v Kafce nejsou (například audit témat, sledování anomálií v clusteru, vytváření DLQ atd.).
Data-bus umožňuje implementaci failoveru centralizovaně pro všechny služby.
V současné době stačí připojit malou knihovnu do kódu vašeho servisu, aby bylo možné začít odesílat události do zprostředkovatele zpráv. To je vše. Získáváte možnost psát, číst a škálovat pomocí jediné řádky kódu. Celá implementace je pro vás skrytá, venku vystupují pouze některé úpravy typu velikosti dávky. Pod kapotou služba data-bus zvedá v Kubernetes potřebný počet instancí producentů a spotřebitelů a dodává jim potřebnou konfiguraci, ale to vše je pro váš servis průhledné.
Samozřejmě, neexistuje žádný stříbrný kulka a tento přístup má svá omezení.
- Data-bus je třeba udržovat vlastními silami, na rozdíl od třetími stranami dodávaných knihoven.
- Data-bus zvyšuje počet interakcí mezi službami a zprostředkovatelem zpráv, což vede ke snížení výkonu ve srovnání s holou Kafkou.
- Ne všechno lze tak snadno skrýt před službami, duplicita funkcí KSQL nebo Kafka Streams v data-bus se nám nechce, proto někdy musíme povolit službám přistupovat přímo.
V našem případě převažovaly výhody nad nevýhodami a rozhodnutí skrýt zprostředkovatele zpráv pod zvláštní službou se osvědčilo. Za rok provozu jsme neměli žádné vážné havárie ani problémy.
P.S. Děkuji své přítelkyni, Ekaterině Obalajevě, za skvělé obrázky k tomuto článku. Pokud se vám líbily, najde se ještě více ilustrací.
Zdroj: habr.com
