

Vítejte, Habre!
Svého času jsme jako první představili téma na ruském trhu a pokračujeme v jeho rozvoji. Zejména nás zaujalo téma interakce mezi Kafka a . Přehledový (a poměrně opatrný) na toto téma vyšel na blogu společnosti Confluent už v říjnu loňského roku pod autorským jménem Gwen Shapiro. Dnes bychom chtěli upozornit na aktuálnější, dubnový článek Johann Gyger, který, i když se nevyhnul otazníku v názvu, zkoumá téma v konkrétnějším klíči a doprovází text zajímavými odkazy. Omluvte náš volný překlad „chaos monkey“, pokud můžete!
Úvod
Kubernetes je určen k práci s částmi zátěže, které neudržují stav. Obvykle jsou tyto pracovní zátěže prezentovány ve formě mikroslužebné architektury, jsou lehké, dobře se horizontálně škálují, podléhají principům 12-faktorových aplikací a umožňují pracovat s automatickými výpadky (circuit breaker) a chaos monky (chaos monkeys).
Kafka, umístěná na druhé straně, v podstatě funguje jako distribuovaná databáze. Při práci se tedy musíte zabývat stavem, který je mnohem těžší než mikroslužba. Kubernetes podporuje zátěže s udržením stavu, ale, jak uvádí Kelsey Hightower ve svých dvou tweetech, je třeba s nimi zacházet opatrně:
Někteří si myslí, že když nasadí Kubernetes na zátěž s udržením stavu, stává se z něj plně řízená databáze, která může soutěžit s RDS. To není pravda. Možná, pokud se dostatečně snažíte, připojíte další komponenty a zapojíte tým SRE inženýrů, podaří se vám zřídit RDS nad Kubernetes.
Vždy doporučuji projevovat mimořádnou opatrnost při spuštění zátěže s udržením stavu na Kubernetes. Většina těch, kteří se ptají, ‚mohu na Kubernetes spouštět zátěže s udržením stavu‘, nemá dostatečné zkušenosti s Kubernetes a často ani s tím zatížením, na které se ptají.
Měli bychom spustit Kafka na Kubernetes? Na tuto otázku se dá odpovědět i jinak: Bude Kafka lépe fungovat bez Kubernetes? Rád bych v tomto článku zdůraznil, jak se Kafka a Kubernetes vzájemně doplňují a na jaké překážky můžete při jejich kombinaci narazit.
Doba provádění
Pojďme si promluvit o základní věci – o samotném prostředí provádění.
Proces
Brokery Kafka jsou efektivní při práci s CPU. TLS může přinést určité výdaje. Klienti Kafka mohou však více zatížit CPU, pokud používají šifrování, ale to neovlivňuje brokery.
Paměť
Brokery Kafka spotřebovávají paměť. Velikost haldy JVM by obvykle měla být omezena na 4–5 GB, ale budete potřebovat také spoustu systémové paměti, protože Kafka velmi aktivně využívá stránkovací cache. V Kubernetes správně nastavte limity pro zdroje a požadavky kontejnerů.
Úložiště dat
Úložiště dat v kontejnerech je efemérní – data se ztrácejí při restartu. Pro data Kafka můžete využít svazek emptyDir, a efekt bude podobný: data vašeho brokera budou ztracena po ukončení. Vaše zprávy se však mohou zachovat na jiných brokerech jako repliky. Proto se po restartu nefunkční broker musí nejprve replikovat všechna data, což může nějakou dobu trvat.
Proto je důležité použít dlouhodobé úložiště dat. Může to být nelokální dlouhodobé úložiště s filesystémem XFS nebo přesněji ext4. Nepoužívejte NFS. Varoval jsem vás. NFS verze v3 nebo v4 nebude fungovat. Jinými slovy, broker Kafka skončí, pokud nebude schopen odstranit adresář s daty kvůli problémům s "hloupými přejmenováními," které se týkají NFS. Pokud vás dosud nepřesvědčilo, velmi důkladně . Úložiště dat by mělo být nelokální, aby Kubernetes mohl flexibilněji vybírat nový uzel po restartování nebo relokaci.
Síť
Stejně jako u většiny distribuovaných systémů, výkon Kafka silně závisí na minimálních latencích v síti a maximální šířce pásma. Neměli byste se snažit umístit všechny brokery na jeden uzel, protože tím se sníží dostupnost. Pokud dojde k selhání uzlu Kubernetes, selže celý cluster Kafka. Také nečleňte cluster Kafka mezi různými datovými centry. Totéž platí pro cluster Kubernetes. Dobrým kompromisem je vybrat různé dostupnostní zóny.
Konfigurace
Obvyklé manifesty
Na webu Kubernetes je o tom, jak nastavit ZooKeeper pomocí manifestů. Protože ZooKeeper je součástí Kafka, je výhodné začít se seznamovat s tím, jaké koncepty Kubernetes se zde uplatňují. Po pochopení toho budete moci použít stejné koncepty také pro cluster Kafka.
- Pod: pod – to je minimální nasaditelná jednotka v Kubernetes. Pod obsahuje vaši pracovní zátěž a sám pod odpovídá procesu ve vašem clusteru. Pod obsahuje jeden nebo více kontejnerů. Každý server ZooKeeper v souboru a každý broker v clusteru Kafka bude fungovat v samostatném podu.
- StatefulSet: StatefulSet je objekt Kubernetes, který pracuje s více pracovními zátěžemi, jež uchovávají své stavy, a tyto zátěže vyžadují koordinaci. StatefulSet poskytuje záruky týkající se pořadí podů a jejich jedinečnosti.
- Headless služby: Služby umožňují odpojit pody od klientů pomocí logického jména. Kubernetes je v tomto případě zodpovědný za vyvažování zátěže. Při operacích s pracovními zátěžemi, které uchovávají stav, jako je tomu u ZooKeeper a Kafka, však musí klienti komunikovat s konkrétním instancí. Zde přicházejí na řadu headless služby: klient tak stále bude mít logické jméno, ale nebude třeba se přímo obracet na pod.
- Objem pro trvalé úložiště: takové objemy jsou potřeba pro konfiguraci nelokálního blokového trvalého úložiště, které bylo zmíněno výše.
Na poskytuje komplexní sadu manifestů, pomocí kterých je snadné začít pracovat s Kafka na Kubernetes.
Helm diagramy
Helm je manažer balíčků pro Kubernetes, který lze přirovnat k manažerům balíčků pro operační systémy, jako jsou yum, apt, Homebrew nebo Chocolatey. Pomocí něj můžete snadno instalovat předem definované softwarové balíčky popsané v diagramech Helm. Dobře navržený diagram Helm usnadňuje složitý úkol: jak správně nakonfigurovat všechny parametry pro použití Kafka na Kubernetes. Existuje několik diagramů Kafka: oficiální se nachází , existuje jeden od , další je od .
Operátoři
Protože Helm má určité nedostatky, roste popularita dalšího nástroje: operátoři Kubernetes. Operátor nejen balí software pro Kubernetes, ale také vám umožňuje nasadit tento software a spravovat ho.
V seznamu jsou uvedeni dva operátoři pro Kafka. Jedním z nich je . S pomocí Strimzi není žádný problém spustit klastr Kafka během několika minut. Téměř žádná konfigurace není potřeba, navíc samotný operátor poskytuje některé příjemné funkce, například šifrování TLS typu „point-to-point“ uvnitř klastru. Confluent také poskytuje .
Výkon
Je velmi důležité testovat výkon tím, že zařízení, které máte nainstalované, vybavíte kontrolními body. Takové testy vám pomohou odhalit potenciální úzká místa, než začnou problémy. Naštěstí v Kafce jsou již k dispozici dva nástroje pro testování výkonu: kafka-producer-perf-test.sh a kafka-consumer-perf-test.sh. Aktivně je používejte. Pro informaci se můžete odkazovat na výsledky uvedené v Jayem Krepskem, nebo se řídit Amazon MSK od Stéphane Maarek.
Operace
Monitoring
Transparentnost v systému je velmi důležitá – jinak nebudete rozumět tomu, co se v něm děje. Dnes je k dispozici solidní soubor nástrojů, které poskytují monitorování založené na metrikách ve stylu cloud native. Dva populární nástroje pro tento účel jsou Prometheus a Grafana. Prometheus může sbírat metriky ze všech Java procesů (Kafka, Zookeeper, Kafka Connect) pomocí JMX exportéru – tím nejjednodušším způsobem. Pokud připojíte metriky cAdvisor, budete mít úplnější představu o tom, jak jsou zdroje využívány v Kubernetes.
Strimzi má velmi užitečný příklad Grafana dashboardu pro Kafka. Vizualizuje klíčové metriky, jako jsou nedoreplikované sektory nebo ty, které jsou offline. Vše je velmi přehledné. Tyto metriky jsou doplněny informacemi o využití zdrojů a výkonnosti, jakož i indikátory stability. Tak získáte základní monitoring Kafka clusteru úplně zdarma!
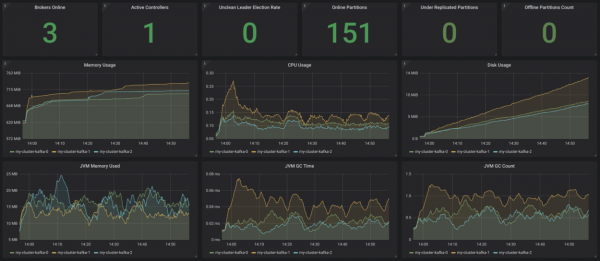
Zdroj:
Bylo by dobré doplnit to monitorováním klientů (metriky pro spotřebitele a producenty) a také monitoringem zpoždění (k tomu slouží ) a podrobným monitoringem – pro to použijte .
Logování
Logování je další velmi důležitý úkol. Ujistěte se, že všechny kontejnery ve vaší instalaci Kafka jsou logovány do stdout a stderr, a také se postarejte o to, aby váš Kubernetes cluster agregoval všechny logy do centrální logovací infrastruktury, například do .
Kontrola stavu
Kubernetes používá sondy "životnosti" (liveness) a připravenosti (readiness), aby zkontroloval, zda vaše pody fungují správně. Pokud kontrola životnosti selže, Kubernetes tento kontejner zastaví a poté ho automaticky restartuje, pokud je politika restartu nastavena správně. Pokud kontrola připravenosti selže, Kubernetes odizoluje tento pod od obsluhy požadavků. V takových případech tedy není potřeba žádný manuální zásah, což je velké plus.
Nasazení aktualizací
StatefulSet podporují automatické aktualizace: při výběru strategie RollingUpdate bude každý pod Kafka aktualizován postupně. Tímto způsobem můžete minimalizovat dobu výpadku na nulu.
Škálování
Škálování Kafka clusteru je náročný úkol. Nicméně v Kubernetes je velmi snadné škálovat pody na určité množství replik, což znamená, že můžete deklarativně určit tolik brokerů Kafka, kolik budete chtít. Nejtěžší částí v tomto případě je přeřazení sektorů po navýšení nebo před snížením měřítka. Znovu, s tímto úkolem vám pomůže Kubernetes.
Administrace
Úkoly spojené s administrací vašeho Kafka clusteru, zejména vytváření témat a přenos sektorů, lze provádět pomocí dostupných shell skriptů, když otevřete příkazový řádek ve svých podech. Nicméně, toto řešení není příliš elegantní. Strimzi podporuje správu témat pomocí jiného operátora. Tady je co zlepšovat.
Zálohování a obnova
Nyní bude dostupnost Kafka záviset také na dostupnosti Kubernetes. Pokud vám spadne Kubernetes cluster, v nejhorším případě spadne i Kafka cluster. Podle Murphyho zákona se to určitě stane a vy ztratíte data. Aby se snížilo riziko tohoto druhu, měli byste pečlivě propracovat koncept zálohování. Můžete využít MirrorMaker, dalším řešením je použít S3, jak je popsáno v tomto od Zalando.
Závěr
Při práci s malými nebo středními Kafka clustery je rozhodně rozumné použít Kubernetes, protože poskytuje dodatečnou flexibilitu a zjednodušuje práci s operátory. Pokud máte velmi přísné nefunkční požadavky týkající se latence a/nebo propustnosti, možná by stálo za to zvážit nějakou jinou možnost nasazení.
Zdroj: habr.com
