

Clouds are like a magical box — you specify what you need, and resources simply appear out of nowhere. Virtual machines, databases, networks — all of these belong only to you. There are other cloud tenants, but in your universe, you are the sole ruler. You are confident that you will always receive the required resources, not accounting for anyone else, and you independently determine how the network will be configured. How does this magic work, allowing the cloud to elastically allocate resources and completely isolate tenants from each other?
AWS Cloud is a mega-super-complex system that has been evolving since 2006. Part of this evolution was witnessed Vasily Pantyuchin — by an architect of Amazon Web Services. As an architect, he sees not only the end result but also the challenges that AWS overcomes. The greater the understanding of how the system works, the more trust is built. Therefore, Vasily will share the secrets of AWS cloud services. Below, you will find the structure of AWS physical servers, elastic database scalability, custom Amazon databases, and methods to enhance virtual machine performance while simultaneously reducing costs. Knowledge of Amazon's architectural approaches will help you utilize AWS services more effectively and may provide new ideas for building your own solutions.
About the speaker: Vasily Pantyukhin () started as a Unix admin in Russian companies, spent 6 years working with large hardware at Sun Microsystems, and devoted 11 years to advocating for a data-centric world at EMC. He naturally evolved into private clouds and in 2017 ventured into public clouds. He now offers technical advice to help one thrive and develop in AWS.
Disclaimer: everything below is Vasily's personal opinion and may not coincide with Amazon Web Services' position. of the report on which this article is based is available on our YouTube channel.
Why I am talking about the structure of Amazon
My first car had a ‘stick’ — it had a manual transmission. It was fantastic because I felt that I could drive the car and have full control over it. I also liked that I understood at least roughly how it worked. Naturally, I envisioned the mechanism of the gearbox quite primitively — somewhat like a bicycle transmission.
Vše bylo skvělé, kromě jedné věci — stání v zácpách. Sice sedíte a nic neděláte, ale neustále řadíte, mačkáte spojku, plyn, brzdu — tím se opravdu unavíte. Problém zácp se částečně vyřešil, když jsme si v rodině pořídili automat. Za volantem se objevilo čas na přemýšlení, poslouchání audioknihy.
Další záhada se objevila v mém životě, protože jsem přestal rozumět tomu, jak moje auto funguje. Moderní automobil je složité zařízení. Auto se přizpůsobuje zároveň desítkám různých parametrů: stisknutí plynu, brzdy, stylu jízdy, kvalitě silnice. Už úplně nerozumím, jak to funguje.
Když jsem začal pracovat s Amazonem, byla to pro mě také tajemství. Jenže toto tajemství je na zcela jiné úrovni, protože v autě je jen jeden řidič, zatímco v AWS jich jsou miliony. Všichni uživatelé současně řídí, mačkají plyn a brzdu. Je překvapivé, že jedou tam, kam chtějí — pro mě je to zázrak! Systém se automaticky přizpůsobuje, škáluje a elasticky upravuje pro každého uživatele tak, že má pocit, že je v této vesmíru sám.
Mágie se trochu rozptýlila, když jsem později začal pracovat jako architekt v Amazonu. Viděl jsem, s jakými problémy se potýkáme, jak je řešíme, jak vyvíjíme služby. S rostoucím porozuměním fungování systému narůstá důvěra ve službu. Proto se chci podělit o obrázek toho, co se skrývá pod kapotou cloudového řešení AWS.
O čem se budeme bavit
Zvolil jsem diverzifikovaný přístup — vybral jsem čtyři zajímavé služby, o kterých stojí za to hovořit.
Optimalizace serverů. Efemérní cloudy s fyzickou podobou: fyzická datacentra, kde stojí fyzické servery, které bzučí, zahřívají se a blikají kontrolkami.
Serverless funkce (Lambda) — pravděpodobně nejškálovatelnější služba v cloudu.
Škálování databáze. Řeknu vám, jak budujeme naše vlastní škálovatelné databáze.
Škálování sítě. Poslední část, ve které odhalím strukturu naší sítě. Je to úžasná věc — každý uživatel cloudu si myslí, že je v cloudu sám a vůbec nevidí ostatní nájemce.
Poznámka. V tomto článku se budeme věnovat optimalizaci serverů a škálování databází. Škálování sítě probereme v dalším článku. Kde jsou serverless funkce? Ty byly podrobně popsány v samostatném článku „“. V něm je popsáno několik různých způsobů škálování a podrobně rozebráno řešení Firecracker – spojení nejlepších vlastností virtuálních strojů a kontejnerů.
Servery
Cloud je efemérní. Ale tato efemérnost má přesto fyzickou podobu – servery. Jejich architektura byla původně klasická. Standardní čipová sada x86, síťové karty, Linux, hypervizor Xen, na kterém běžely virtuální stroje.
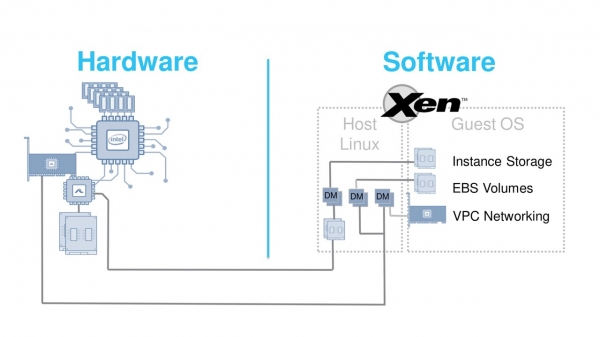
V roce 2012 taková architektura zcela splnila své úkoly. Xen je skvělý hypervizor, ale má jeden zásadní nedostatek. Má dost vysoké režijní náklady na emulaci zařízení. S příchodem novějších, rychlejších síťových karet nebo SSD disků se tyto režijní náklady stávají příliš vysokými. Jak se s tímto problémem vypořádat? Rozhodli jsme se pracovat hned na dvou frontách – optimalizovat jak hardware, tak hypervizor. Úkol je velmi vážný.
Optimalizace hardware a hypervizoru
Dělat všechno najednou a dobře se nepodaří. Co znamená „dobře“, původně také nebylo jasné.
Rozhodli jsme se použít evoluční přístup – měníme jednu důležitou součást architektury a zavádíme ji do produkce.
Stupňujeme kroky, nasloucháme stížnostem a návrhům. Pak měníme další komponentu. Tak, malými inkrementy, radikálně měníme celou architekturu na základě zpětné vazby od uživatelů a podpory.
Transformace začaly v roce 2013 s tím nejnáročnějším – sítí. V C3 instancích byla ke standardní síťové kartě přidána speciální karta Network Accelerator. Ta byla připojena doslova krátkým loopback kabelem na předním panelu. Není to estetické, ale v cloudu to není vidět. Přímá interakce s hardwarem zásadně zlepšila jitter a propustnost sítě.
Dále jsme se rozhodli zlepšit přístup k blokovému úložišti dat EBS – Elastic Block Storage. To je kombinace sítě a úložiště. Složitost spočívá v tom, že zatímco na trhu existovaly karty Network Accelerator, možnosti pořídit hardware Storage Accelerator nebyly. Proto jsme se obrátili na startup Annapurna Labs, který vyvinul speciální čipy ASIC pro nás. Ty umožnily připojit vzdálené objemy EBS jako zařízení NVMe.
Ve instancích C4 jsme vyřešili dva problémy. První — připravili jsme se na budoucnost perspektivní, ale v té době novou technologii NVMe. Druhá — výrazně jsme uvolnili centrální procesor přesunutím zpracování požadavků na EBS na novou kartu. Dopadlo to úspěšně, a proto je nyní Annapurna Labs součástí Amazonu.
Do listopadu 2017 jsme pochopili, že nastal čas změnit i samotný hypervizor.
Nový hypervizor byl vyvinut na základě upravených modulů jádra KVM.
Umožnil zásadně snížit režijní náklady na emulaci zařízení a pracovat přímo s novými ASIC. Instance C5 byly prvními virtuálkami, pod kapotou kterých běží nový hypervizor. Pojmenovali jsme ho Nitro.
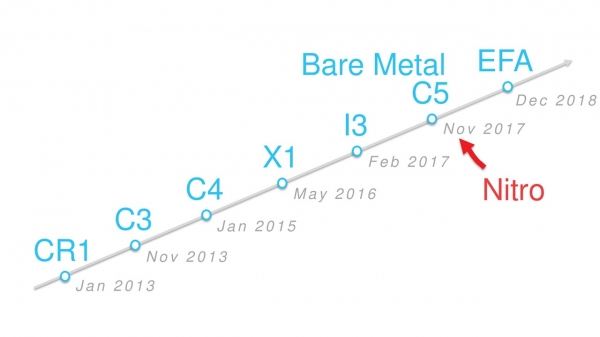 Evoluce instancí na časové ose.
Všechny nové typy virtuálních strojů, které vznikly od listopadu 2017, pracují na tomto hypervizoru. Bare Metal instance nemají hypervizor,, ale také se nazývají Nitro, protože používají specializované Nitro karty.
Během následujících dvou let se počet typů Nitro instancí zvýšil na více než dvě desítky: A1, C5, M5, T3 a další.
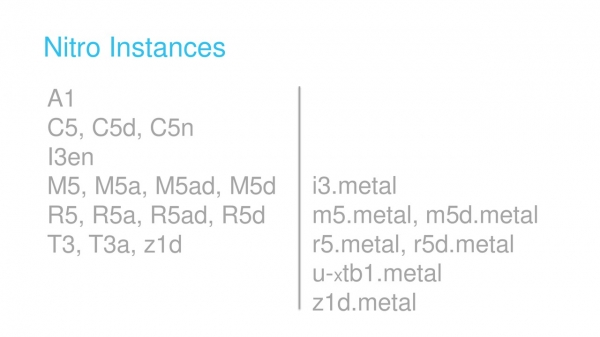
Typy instancí.
Jak fungují moderní Nitro stroje
Mají tři hlavní komponenty: Nitro hypervizor (o něm jsme hovořili výše), bezpečnostní čip a Nitro karty.
Bezpečnostní čip je integrován přímo na základní desku. Kontroluje řadu důležitých funkcí, například kontrolu spuštění hostitelského operačního systému.
Nitro karty existují ve čtyřech typech. Všechny byly vyvinuty Annapurna Labs a jsou založeny na společných ASIC. Část jejich firmwaru je také společná.
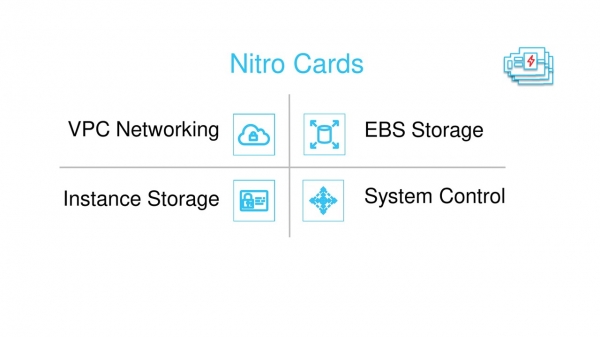
Čtyři typy Nitro karet.
Jedna z karet je určena pro práci s síťovýmiVPCzařízeními. Ta je viditelná ve virtuálkách jako síťová karta ENA — Elastic Network Adaptor. Ta také inkapskuluje provoz při jeho přenosu přes fyzickou síť (o tom si povíme ve druhé části článku), kontroluje firewall Security Groups, zodpovídá za routování a další síťové úkoly.
Samostatné karty pracují s blokovým úložištěm EBS a disky, které jsou integrovány do serveru. Pro hostitelskou virtuální mašinu jsou prezentovány jako NVMe adaptéry. Také se podílejí na šifrování dat a monitorování disků.
Systém Nitro karet, hypervizoru a bezpečnostního čipu je spojen do sítě SDN nebo Software Defined Network. Za správu této sítě (Control Plane) odpovídá karta-ovladač.
Samozřejmě, pokračujeme ve vývoji nových ASIC. Například na konci roku 2018 jsme vydali čip Inferentia, který umožňuje efektivnější zpracování úloh strojového učení.
Čip Inferentia pro zpracování strojového učení.
Škálovatelná databáze
Tradiční databáze má vrstevnatou strukturu. Pokud to zjednodušíme, vymezujeme následující úrovně.
- SQL — na něm pracují správci klientů a požadavků.
- Zajištění transakcí — tady je vše jasné, ACID a to vše.
- Cacheování, které je zajištěno pomocí vyrovnávacích pamětí.
- Logování — zajišťuje práci s redo-žurnály. V MySQL se nazývají Bin Logs, v PostgreSQL — Write Ahead Logs (WAL).
- Úložiště – přímý zápis na disk.
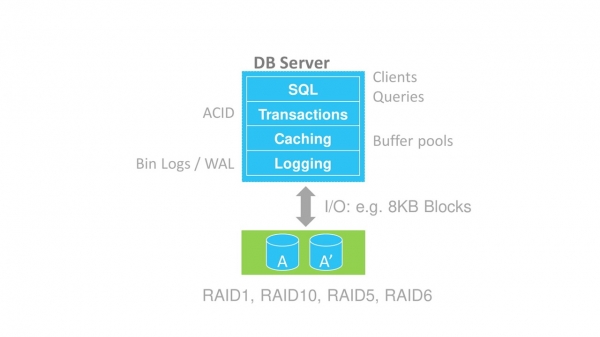
Vrstvená struktura databáze.
Existují různé způsoby škálování databází: shardování, architektura Shared Nothing, sdílené disky.
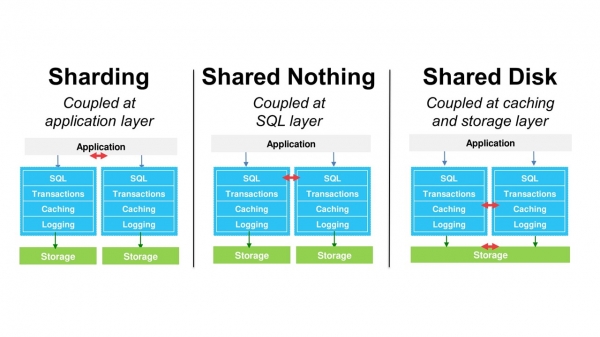
Nicméně, všechny tyto metody zachovávají stejnou monolitickou strukturu databáze. To výrazně omezuje škálování. Abychom tento problém vyřešili, vyvinuli jsme naši vlastní databázi — Amazon Aurora. Je kompatibilní s MySQL a PostgreSQL.
Amazon Aurora
Hlavní architektonická myšlenka je oddělit úrovně ukládání a logování od samotné databáze.
Mimochodem, úroveň cachování jsme také udělali nezávislou. Architektura přestává být monolitem a získáváme další míry volnosti při škálování jednotlivých bloků.
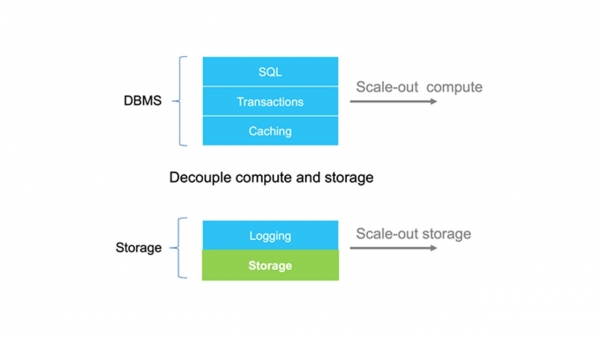
Úrovně logování a ukládání jsou odděleny od databáze.
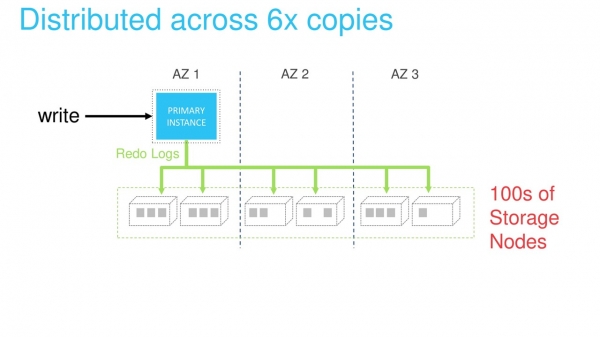
Tradiční DBMS zapisuje data na systém ukládání ve formě bloků. V Amazon Aurora jsme vytvořili „inteligentní“ úložiště, které může komunikovat v jazyce redo-žurnálů. Uvnitř se úložiště mění na bloky dat, sleduje jejich integritu a automaticky zálohuje.
Tento přístup umožňuje realizovat zajímavé věci, jako je klonování. Funguje podstatně rychleji a ekonomičtěji, protože nevyžaduje vytváření úplné kopie všech dat.
Úroveň ukládání je realizována jako distribuovaný systém. Skládá se z velkého množství fyzických serverů. Každý redo-žurnál je zpracováván a ukládán současně šesti uzly. To zajišťuje ochranu dat a rozložení zátěže.
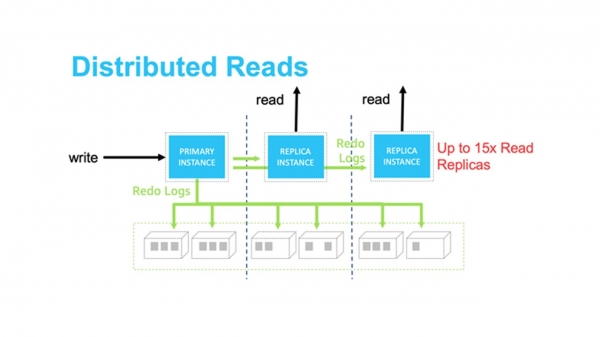
Škálování pro čtení lze zajistit pomocí odpovídajících replik. Distribuované úložiště odstraňuje potřebu synchronizace mezi hlavním instancí databáze, přes kterou zapisujeme data, a ostatními replikami. Aktuální data jsou zaručeně dostupná všem replikám.
Jediným problémem je cachování starých dat na replikách pro čtení. Ale tento problém se dá vyřešit. přenosem všech redo logů na repliky po vnitřní síti. Pokud je log v cache, je označen jako neplatný a přepsán. Pokud v cache není, jednoduše se zahodí.
S úložištěm máme jasno.
Jak škálovat úrovně DBMS
Zde je horizontální škálování mnohem složitější. Proto se vydáme osvědčenou cestou klasického vertikálního škálování..
Předpokládejme, že máme aplikaci, která komunikuje s DBMS přes master node.
Při vertikálním škálování vyčleníme novou node, která bude mít více procesorů a paměti.
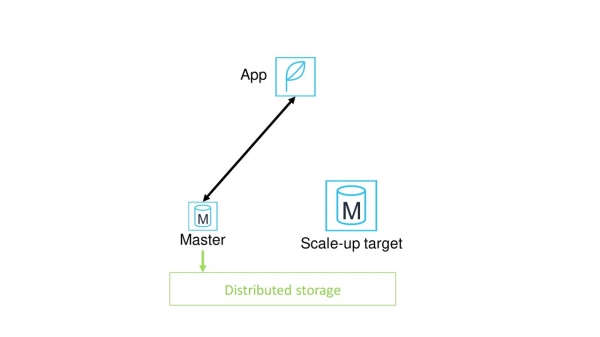
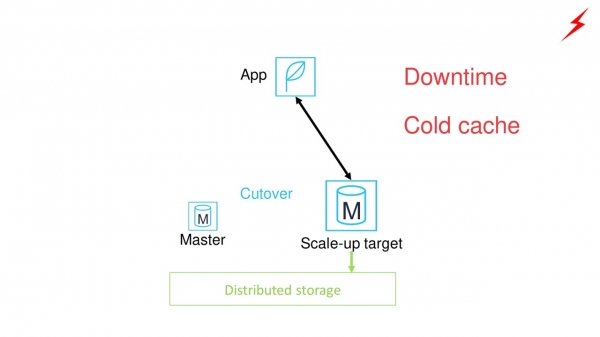
Pak přepneme aplikaci ze staré master node na novou. Objevují se problémy.
- To si vyžádá výrazný výpadek aplikace.
- Nová master node bude mít studenou cache. Výkon DB bude maximální teprve po ohřátí cache.
Jak zlepšit situaci? Umístit proxy mezi aplikaci a master node.
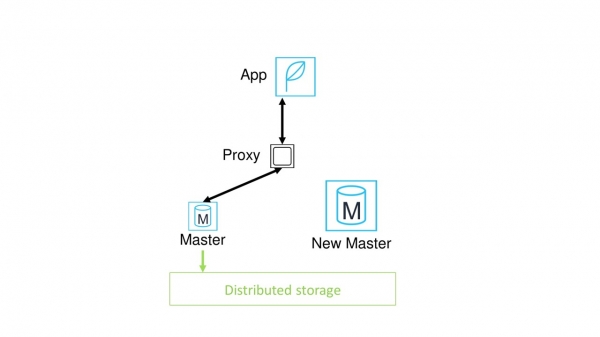
Co nám to přinese? Nyní není třeba ručně přesměrovávat všechny aplikace na novou node. Přepnutí lze provést pod proxy a tím pádem podstatně rychleji.
Zdá se, že je problém vyřešen. Ale ne, stále trpíme nutností ohřívat cache. Kromě toho se objevila nová otázka - nyní je proxy potenciálním bodem selhání.
Konečné řešení s Amazon Aurora serverless
Jak jsme vyřešili tyto problémy?
Zůstali jsme u proxy.Není to nějaký samostatný instance, ale celý distribuovaný flotila proxy, skrze kterou se aplikace připojují k DB. Jakoukoliv node lze v případě selhání nahradit prakticky okamžitě.
Přidali jsme pool teplých nodů různé velikosti.Proto nelépe při potřebě vyčlenění nové node většího či menšího rozměru je ihned dostupná. Není třeba čekat, až se načte.
Celý proces škálování je řízen speciálním monitorovacím systémem. Monitorování neustále sleduje stav aktuální master-nody. Pokud zjistí, že zatížení procesoru dosáhlo kritické hodnoty, informuje pool teplých instancí o potřebě vyčlenit novou nodu.
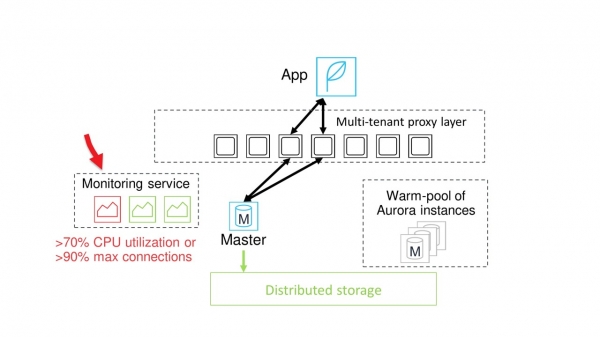
Distribuované proxy, teplé instance a monitorování.
Noda požadovaného výkonu je k dispozici. Na ni se kopírují vyrovnávací pooly a systém začne očekávat bezpečný okamžik pro přepnutí.
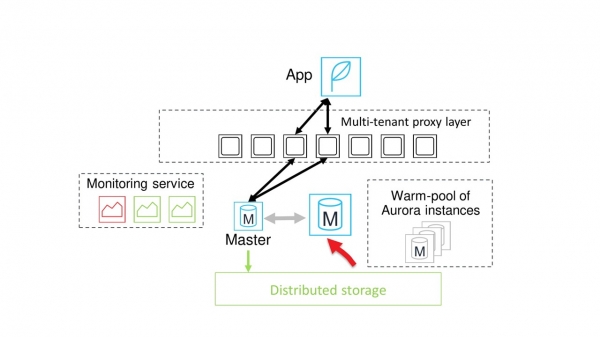
Obvykle okamžik pro přepnutí nastává dost rychle. Poté je komunikace mezi proxy a starou master-nodou pozastavena, všechny relace jsou přepnuty na novou nodu.
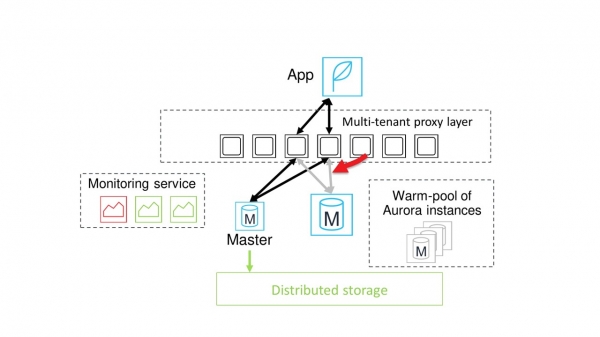
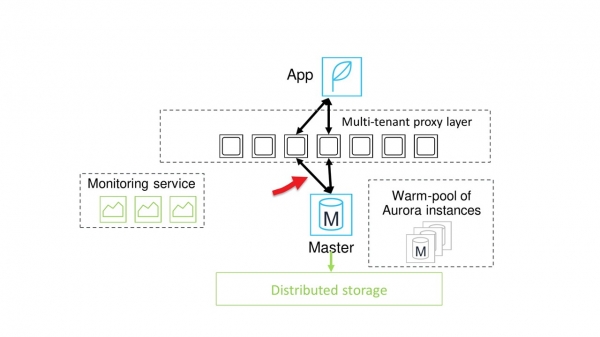
Práce s databází pokračuje.
Na grafu je vidět, že pozastavení je skutečně velmi krátké. Na modrém grafu je zatížení, a na červených stupních — okamžiky škálování. Krátkodobé poklesy na modrém grafu jsou právě tou krátkou prodlevou.
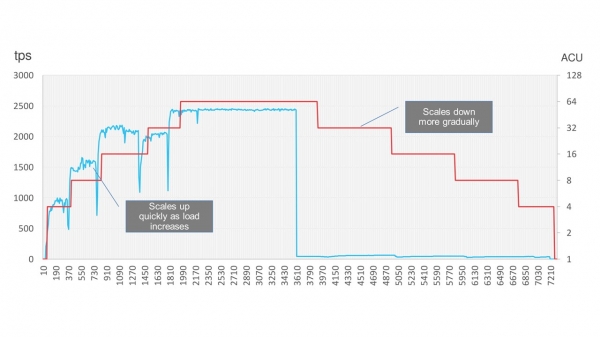
Mimochodem, Amazon Aurora umožňuje značně ušetřit a vypnout databázi, když se nepoužívá, například o víkendech. Po zastavení zátěže databáze postupně snižuje svůj výkon a na nějakou dobu se vypne. Když se zátěž vrátí, opět se hladce zvýší.
V další části příběhu o Amazonu se budeme zabývat škálováním sítě. Přihlaste se a sledujte aktualizace, abyste nezmeškali článek.
Na Vasilij Pantjuchin vystoupí s přednáškou „‘. Jaké vzory návrhu distribuovaných systémů používají vývojáři Amazonu, jaké mohou být důvody selhání služeb, co je Cell-based architecture, Constant Work, Shuffle Sharding — bude to zajímavé. Do konference zbývá méně než měsíc — . 24. října konečné zvýšení cen.
Zdroj: habr.com
