

Škálování Amazon Web Services zahrnuje 69 zón po celém světě ve 22 regionech: USA, Evropa, Asie, Afrika a Austrálie. V každé zóně se nachází až 8 datových center. V každém datovém centru jsou tisíce nebo statisíce serverů. Síť je navržena tak, aby brala v úvahu všechny málo pravděpodobné scénáře výpadků. Například všechny regiony jsou izolovány od sebe a zóny dostupnosti jsou vzdáleny několik kilometrů. I když dojde k přerušením kabelu, systém přejde na záložní kanály a ztráty informací budou minimální. O dalších principech fungování sítě a její struktuře bude hovořit Vasily Pantyuchin.
Vasily Pantyuchin začínal jako Unix administrátor v .ru společnostech, 6 let pracoval s velkými zařízeními Sun Microsystem, 11 let propagoval datacentricitu světa v EMC. Přirozeně přešel k privátním cloudům, pak se přesunul do veřejných. Nyní, jako architekt Amazon Web Services, poskytuje technické rady pro život a rozvoj v cloudu AWS.
V předchozí části trilogie o fungování AWS se Vasily hlouběji zabýval strukturou fyzických serverů a škálováním databází. Nitro karty, vlastní hypervizor na bázi KVM, databáze Amazon Aurora — o tom všem v materiálu "". Přečtěte si, abyste se ponořili do kontextu, nebo se podívejte na prezentace.
V této části se budeme zabývat škálováním sítě — jedním z nejkomplexnějších systémů v AWS. Evoluce od ploché sítě k Virtual Private Cloud a její struktura, interní služby Blackfoot a HyperPlane, problém hlučného souseda, a nakonec — rozsahy sítě, backbone a fyzické kabely. O tom všem se dozvíte níže.
Disklaimer: vše, co je níže, je osobní názor Vasilyho a nemusí se shodovat s postojem Amazon Web Services.
Škálování sítě
Cloud AWS byl spuštěn v roce 2006. Jeho síť byla dost primitivní — s plochou strukturou. Rozsah privátních adres byl společný pro všechny nájemce cloudu. Při spuštění nové virtuální stanice jste náhodně získali dostupnou IP adresu z tohoto rozsahu.
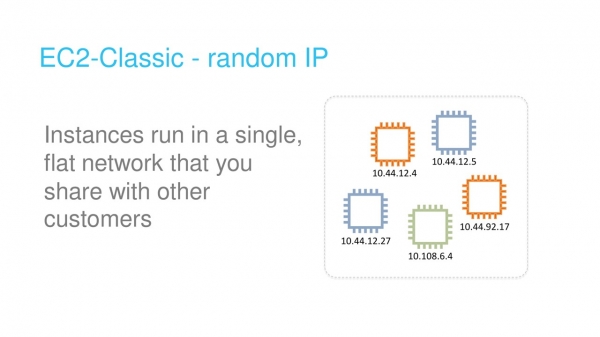
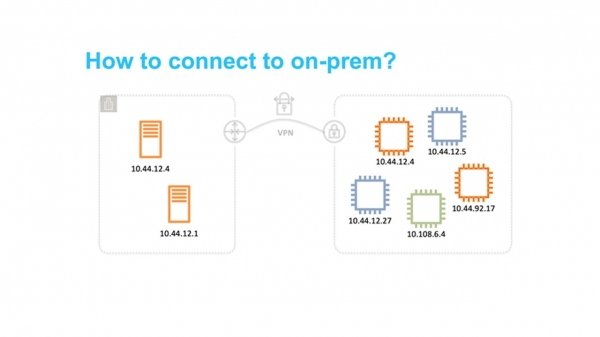
Tento přístup byl snadný na implementaci, ale zásadně omezoval používání cloudu. Zejména bylo obtížné vyvíjet hybridní řešení, která kombinují soukromé sítě na místě a v AWS. Nejčastějším problémem byla překrývání rozsahů IP adres.
Virtuální privátní cloud
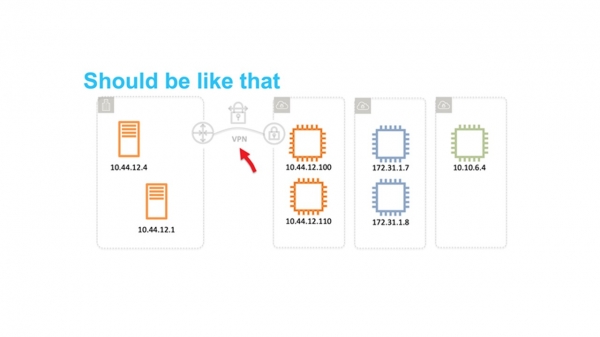
Cloud se ukázal jako žádaný. Přišel čas přemýšlet o škálovatelnosti a možnosti jeho využití desítkami milionů tenantů. Plánovaná síť se stala hlavní překážkou. Proto jsme začali přemýšlet, jak izolovat uživatele od sebe na úrovni sítě tak, aby si mohli nezávisle vybírat rozsahy IP.
Co vás napadne jako první, když přemýšlíte o síťové izolaci? Samozřejmě VLAN a VRF — Virtuální směrování a přeposílání.
Bohužel to nefungovalo. VLAN ID má pouze 12 bitů, což nám dává pouze 4096 izolovaných segmentů. I v největších přepínačích lze použít maximálně 1-2 tisíce VRF. Sdílení VRF a VLAN nám dává jen několik milionů podsítí. To rozhodně nestačí pro desítky milionů tenantů, z nichž každý musí mít možnost využívat několik podsítí.
Také si jednoduše nemůžeme dovolit koupit požadované množství velkých boxů, například od Cisco nebo Juniper. Důvody jsou dva: je to šíleně drahé a nechceme se dostat do závislosti na jejich politice vývoje a patchování.
Jedno je jasné – musíme si uvařit vlastní řešení.
V roce 2009 jsme oznámili VPC — Virtuální privátní cloud. Název se ujal a nyní ho používá mnoho dalších poskytovatelů cloudu.
VPC je virtuální síť SDN (Software Defined Network). Rozhodli jsme se nevymýšlet speciální protokoly na úrovních L2 a L3. Síť funguje na standardním Ethernetu a IP. Pro přenos po síti se provoz virtuálních strojů encapsulová do obalu našeho vlastního protokolu. V něm je uvedeno ID, které patří tenantovi VPC.
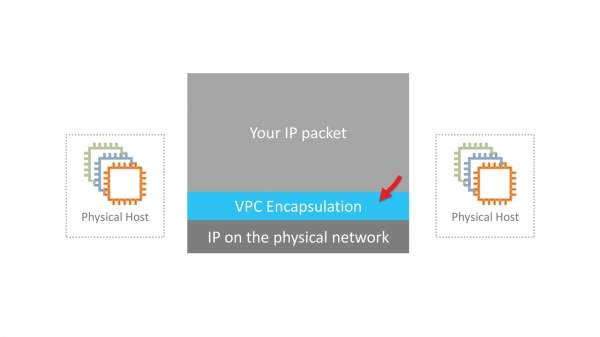
Zní to jednoduše. Nicméně je třeba vyřešit několik závažných technických úloh. Například kde a jak uchovávat data o mapování virtuálních MAC/IP adres, VPC ID a odpovídajících fyzických MAC/IP. V rámci AWS to je obrovská tabulka, která musí fungovat s minimálními zpožděními při přístupu. O to se stará mapovací služba, která je rozprostřena tenkou vrstvou po celé síti.
V nových generacích strojů je enkapsulace prováděna kartami Nitro na hardwarové úrovni. Ve starších instancích se enkapsulace a dekapsulace provádějí softwarem.
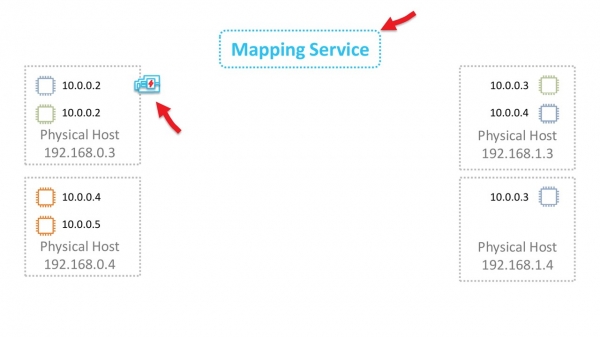
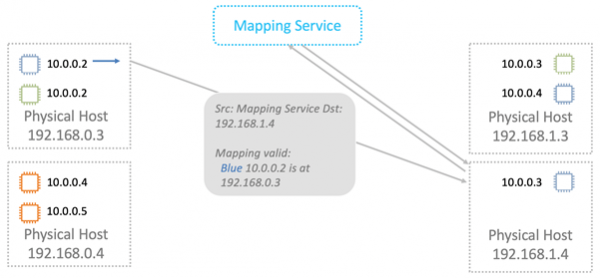
Pojďme se podívat, jak to funguje v obecných rysech. Začneme na úrovni L2. Předpokládejme, že máme virtuální stroj s IP 10.0.0.2 na fyzickém serveru 192.168.0.3. Ten posílá data virtuálnímu stroji 10.0.0.3, který se nachází na 192.168.1.4. Vytváří se ARP dotaz, který dopadne na síťovou Nitro kartu. Pro zjednodušení předpokládejme, že obě virtuální stroje jsou v jedné „modré“ VPC.
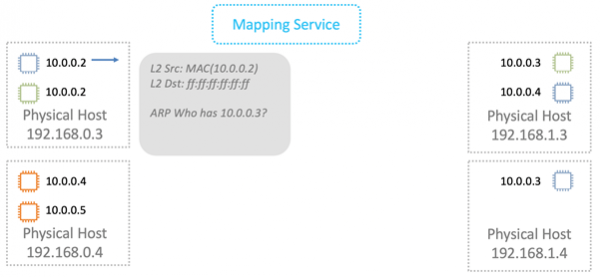
Karta nahradí adresu zdroje svou vlastní a přepošle ARP rámec mapovací službě.
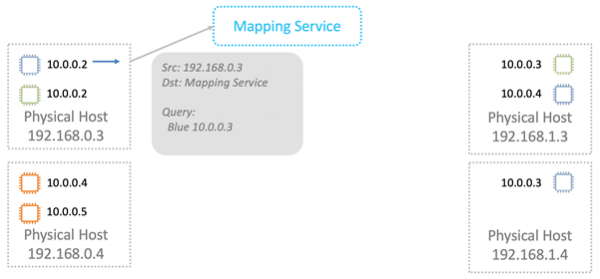
Mapovací služba vrátí informace, které jsou potřebné pro přenos po fyzické síti L2.
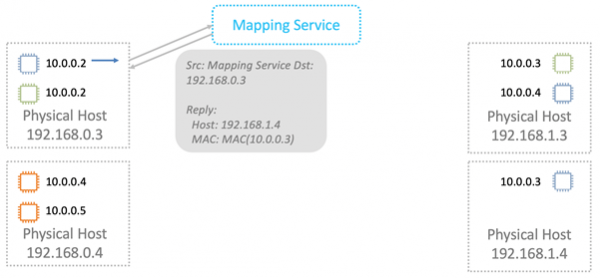
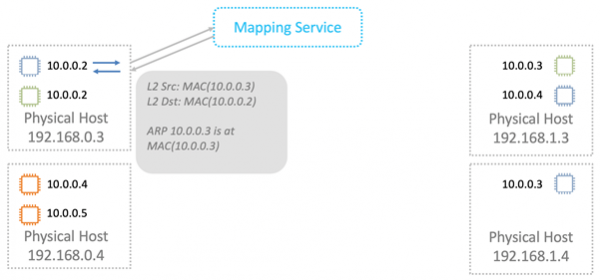
Nitro karta v ARP odpovědi nahradí MAC v fyzické síti adresou v VPC.
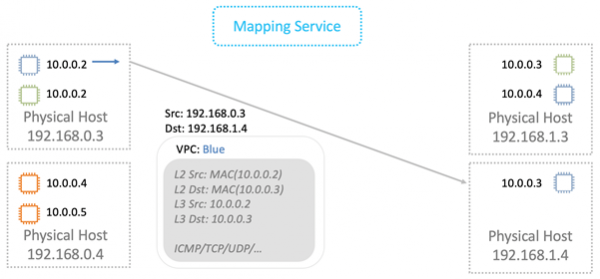
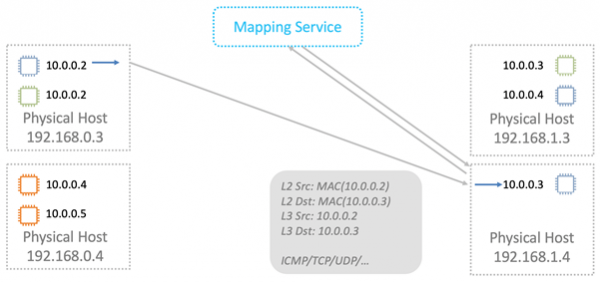
Při přenosu dat zabalíme logické MAC a IP do VPC obálky. Všechno to posíláme po fyzické síti s pomocí odpovídajících IP Nitro karet zdroje a cíle.
Fyzický stroj, kterému je paket určen, provede kontrolu. To je důležité, aby se předešlo možnosti podvržení adres. Stroj posílá speciální dotaz mapovací službě a ptá se: "Z fyzického stroje 192.168.0.3 jsem obdržela paket, který je určen pro 10.0.0.3 v 'modré' VPC. Je legální?"
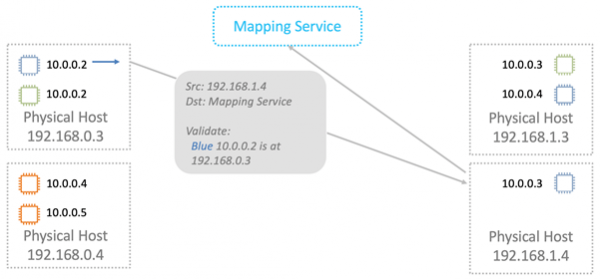
Mapovací služba porovná se svou tabulkou umístění zdrojů a buď povolí, nebo zakáže průchod paketu. Ve všech nových instancích je dodatečná validace zapracována do Nitro karet. Je nemožné ji obelstít, ani teoreticky. Proto spoofing na zdroje v jiné VPC nefunguje.
Dále jsou data odeslána virtuálnímu stroji, pro který jsou určena.
Mapovací služba také funguje jako logický směrovač pro přenos dat mezi virtuálními stroji v různých podsítích. Tam je konceptuálně vše jednoduché, nebudu to detailně rozebírat.
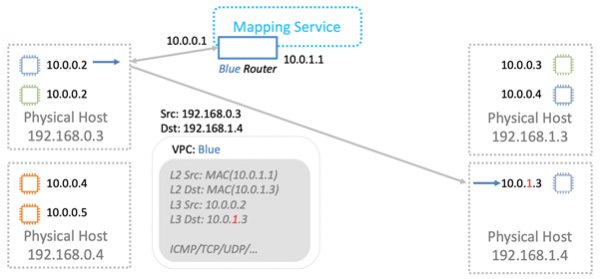
Z toho vyplývá, že při přenosu každého paketu se servery obracejí na mapovací službu. Jak se vyrovnat s nevyhnutelnými zpožděními? Mezipaměťováním, samozřejmě.
Celá krása spočívá v tom, že není nutné cachovat celou obrovskou tabulku. Na fyzickém serveru žijí virtuální instance ze relativně malého počtu VPC. Informace je třeba cachovat pouze o těchto VPC. Přenos dat do jiných VPC v 'výchozí' konfiguraci přesto není legální. Pokud se používá taková funkcionalita jako VPC-peering, pak se do cache dodatečně načítají informace o odpovídajících VPC.
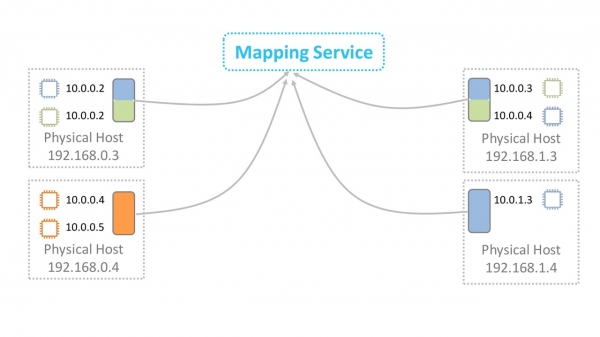
S přenosem dat do VPC jsme si poradili.
Blackfoot
Co dělat v případech, kdy je třeba přenést provoz ven, například na Internet nebo přes VPN na zem? Zde nám pomáhá Blackfoot — interní služba AWS. Byla vyvinuta naším jihoafrickým týmem. Proto se služba jmenuje po tučňákovi, který žije v Jižní Africe.
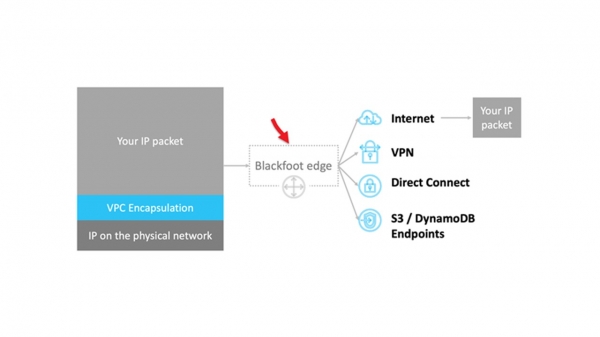
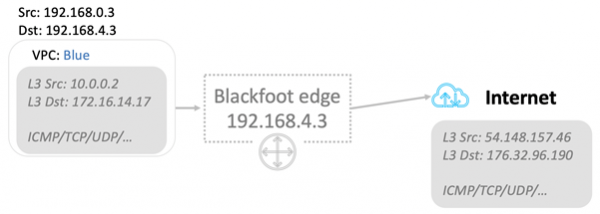
Blackfoot dekapsuluje provoz a dělá s ním to, co je třeba. data do Internetu se odesílají tak, jak jsou.
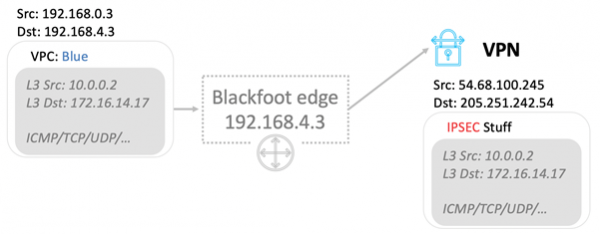
Data se dekapsulují a znovu obalují do IPsec při použití VPN.
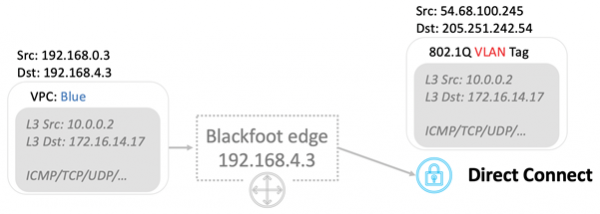
Při použití Direct Connect se provoz označuje a přenáší do odpovídajícího VLAN.
HyperPlane
Je to interní služba pro kontrolu toku. Mnoho síťových služeb vyžaduje kontrolu stavu datového toku. Například při použití NAT musí kontrola toku garantovat, že každému páru 'IP: cílový port' odpovídá unikátní výchozí port. V případě vyrovnávače zatížení NLB — Network Load Balancer, datový tok musí být vždy nasměrován na stejnou cílovou virtuální instanci. Security Groups jsou firewall s uchováním stavu. Sledují příchozí provoz a implicitně otevírají porty pro odchozí tok paketů.
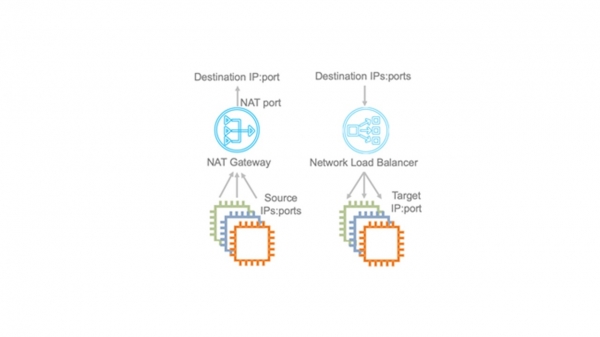
V cloudu AWS jsou požadavky na latence přenosu velmi vysoké. Proto HyperPlane to je kritické pro funkčnost celé sítě.
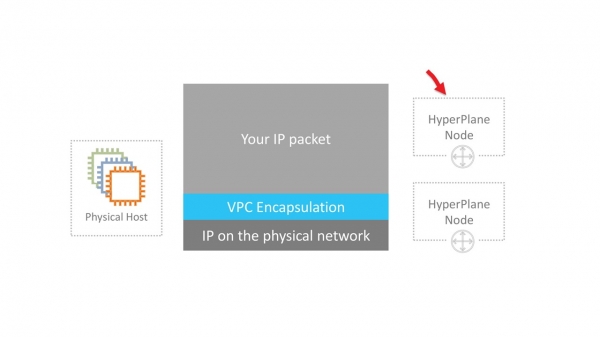
Hyperplane je postaven na virtuálních strojích EC2. Není zde žádná magie, pouze finta. Finta spočívá v tom, že to jsou virtuální stroje s velkým RAM. Transakční operace probíhají výhradně v paměti. To umožňuje dosáhnout latencí v rámci desítek mikrosekund. Práce s diskem by zabila veškerý výkon.
Hyperplane je distribuovaný systém z obrovského množství takových EC2 strojů. Každá virtuální instance má propustnost 5 GB/s. V rámci celé regionální sítě to poskytuje šílené terabity propustnosti a umožňuje zpracovat miliony spojení za sekundu..
HyperPlane funguje pouze s toky. VPC enkapsulace paketů je pro něj zcela průhledná. Potenciální zranitelnost v této interní službě přesto neumožní prolomit izolaci VPC. Za bezpečnost odpovídají nižší úrovně.
hlukový soused
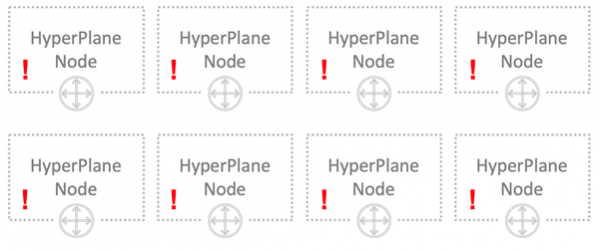
Existuje ještě jeden problém hlukového souseda — hlukový soused. Předpokládejme, že máme 8 uzlů. Tyto uzly zpracovávají toky všech uživatelů cloudu. Vypadá to dobře a zátěž by měla být rovnoměrně rozložena mezi všechny uzly. Uzly jsou velmi výkonné a je obtížné je přetížit.
Ale budujeme svou architekturu i na základě i nepravděpodobných scénářů.
Nízká pravděpodobnost neznamená nemožnost.
Můžeme si představit situaci, kdy jeden nebo několik uživatelů generují příliš vysokou zátěž. Do zpracování této zátěže jsou zapojeny všechny uzly HyperPlane a ostatní uživatelé mohou potenciálně pocítit určité snížení výkonu. To narušuje koncept cloudu, ve kterém nemají nájemci možnost ovlivňovat jeden druhého.
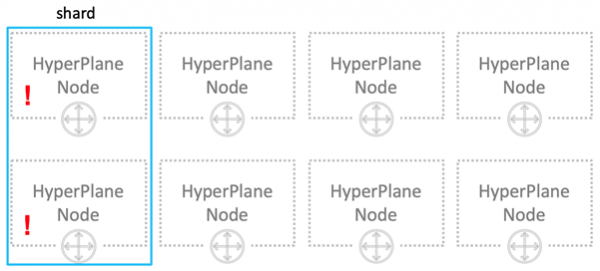
Jak vyřešit problém hlučného souseda? První, co mě napadne, je shardování. Našich 8 uzlů se logicky dělí na 4 shardy, přičemž každý má 2 uzly. Nyní hlučný soused ovlivní pouze čtvrtinu všech uživatelů, ale významně.
Uděláme to jinak. Každému uživateli přidělíme jen 3 uzly.
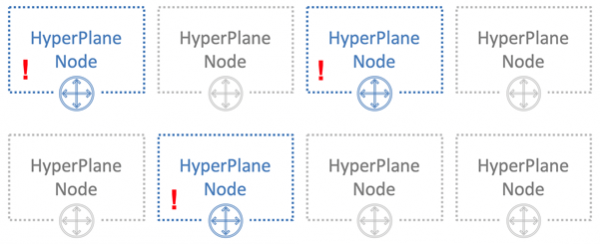
Finta spočívá v tom, že přiřazujeme uzly různým uživatelům náhodně. Na obrázku níže se modrý uživatel překrývá s uzly jednoho ze dvou dalších uživatelů — zeleným a oranžovým.
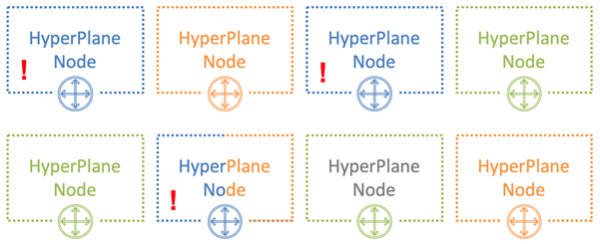
Při 8 uzlech a 3 uživatelích je pravděpodobnost, že se hlučný soused překryje s jedním z uživatelů, 54 %. S takovou pravděpodobností ovlivní modrý uživatel ostatní nájemce. a to pouze částí své zátěže. V našem příkladu bude toto vliv viditelný pouze pro třetinu všech uživatelů. To už je slušný výsledek.
Číslo uživatelů, kteří se překrývají
Pravděpodobnost v procentech
0
18%
1
54%
2
26%
3
2%
Přiblížíme situaci k reálné — vezmeme 100 uzlů a 5 uživatelů na 5 uzlech. V tomto případě se žádný z uzlů s pravděpodobností 77 % nepřekrývá.
Číslo uživatelů, kteří se překrývají
Pravděpodobnost v procentech
0
77%
1
21%
2
1,8%
3
0,06%
4
0,0006%
5
0,00000013%
Ve skutečné situaci, při velkém počtu uzlů HyperPlane a uživatelů, je potenciální vliv hlučného souseda na ostatní uživatele minimální. Tato metoda se nazývá míchání shardů — shuffle sharding. Minimalizuje negativní dopad na selhání uzlů.
Na HyperPlane je postaveno mnoho služeb: Network Load Balancer, NAT Gateway, Amazon EFS, AWS PrivateLink, AWS Transit Gateway.
Měřítko sítě
Nyní se podívejme na měřítko samotné sítě. K říjnu 2019 AWS nabízí své služby ve 22 regionech, přičemž dalších 9 je v plánu.
- Každý region obsahuje několik zón dostupnosti – Availability Zone. Celkem jich je po celém světě 69.
- Každá AZ se skládá z datových center. Jejich celkový počet nepřesahuje 8.
- V datovém centru je umístěno obrovské množství serverů, v některých až 300 000.
Nyní to všechno zprůměrujeme, vynásobíme a dostaneme impozantní číslo, které odráží měřítko cloudu Amazon.
Mezi zónami dostupnosti a datovými centry je položeno mnoho optických kanálů. Ve jednom z našich největších regionů je pouze pro spojení AZ mezi sebou a centry pro komunikaci s jinými regiony (Transit Centers) položeno 388 kanálů. To všechno dohromady dává šílených 5000 Tbit.
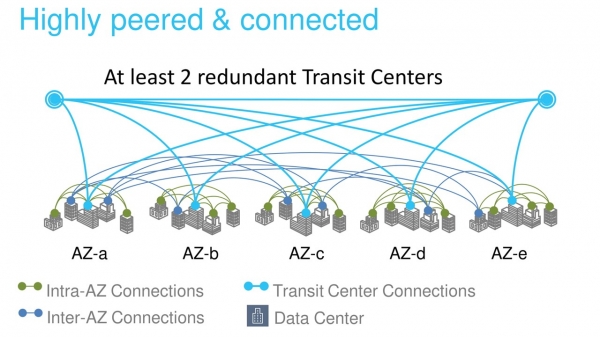
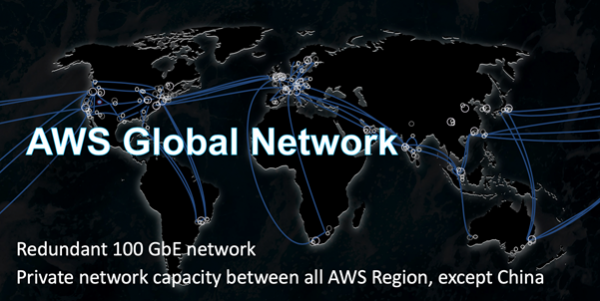
Backbone AWS byl speciálně postaven pro cloud a optimalizován pro jeho provoz. Budujeme ho na kanálech 100 Gbps. Kontrolujeme je úplně, s výjimkou regionů v Číně. Provoz se nedělí s zatíženími jiných společností.
Samozřejmě, nejsme jediný cloudový poskytovatel s privátní backbone sítí. Čím dál více velkých společností se vydává touto cestou. To potvrzují nezávislí výzkumníci, například od .
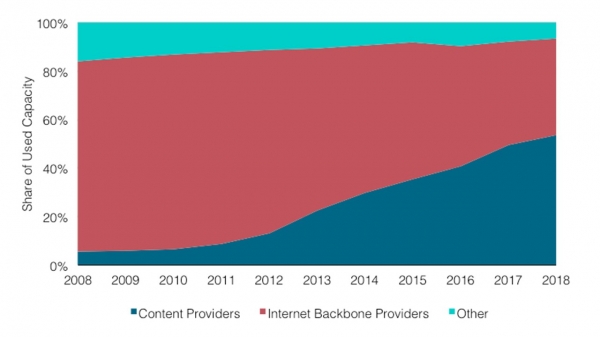
Na grafu je vidět, že podíl poskytovatelů obsahu a cloudových poskytovatelů roste. Z toho důvodu podíl internetového provozu poskytovatelů backbone neustále klesá.
Vysvětlím, proč se to děje. Dříve byly většina webových služeb dostupné a konzumovány přímo z Internetu. Nyní jsou stále více serverů umístěny v cloudu a dostupné prostřednictvím CDN — Content Distribution Network. Pro přístup k zdroji uživatel jde přes Internet pouze do nejbližšího PoP CDN – Point of Presence. Nejčastěji je to někde poblíž. Dále opustí veřejný Internet a po privátním backbone letí přes Atlantik, například, a dostává se přímo na zdroj.
Je zajímavé, jak se Internet změní za 10 let, pokud tato tendence přetrvá?
Fyzické kanály
Vědci zatím nevymysleli, jak zvýšit rychlost světla ve vesmíru, ale udělali značný pokrok v metodách jeho přenosu optickými vlákny. Dnes používáme kabely s 6912 vlákny. To výrazně pomáhá optimalizovat náklady na jejich pokládku.
V některých regionech musíme používat speciální kabely. Například v oblasti Sydney používáme kabely se speciálním potahem proti termitům.
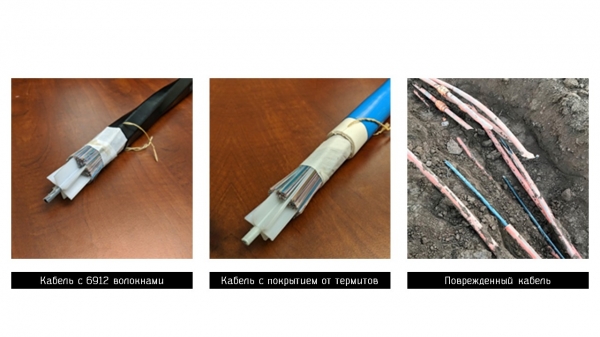
Nikdo není v bezpečí před nepříjemnostmi a někdy jsou naše kanály poškozeny. Na obrázku vpravo jsou optické kabely v jednom z amerických regionů, které byly přetrženy stavebními dělníky. Po havárii bylo ztraceno pouze 13 datových paketů, což je neuvěřitelné. Ještě jednou – pouze 13! Systém se doslova okamžitě přepnul na záložní kanály — škálování funguje.
Rychle jsme prošli některými službami a technologiemi cloudového prostředí Amazonu. Doufám, že máte alespoň nějakou představu o rozsahu úkolů, které našim inženýrům přicházejí na mysl. Osobně mě to moc baví.
Toto je poslední část trilogie od Vasily Pantučina o architektuře AWS. V části jsou popsány optimalizace serverů a škálování databází, a ve druhé — serverless funkce a Firecracker.
Na V listopadu Vasily Pantučin sdílí nové detaily architektury Amazonu. On o důvodech výpadků a návrhu distribuovaných systémů v Amazonu. Do 24. října si ještě můžete koupit vstupenku za dobrou cenu a zaplatit později. Těšíme se na vás na HighLoad++, přijďte — rádi si popovídáme!
Zdroj: habr.com
