

Ahoj, Habr! Právě teď je v OTUS otevřená registrace na nový běh kurzu Před začátkem kurzu jsme tradičně připravili překlad zajímavého materiálu pro vás.
Každý den navštíví Twitter více než sto miliónů lidí, aby se dozvěděli, co se děje ve světě, a o tom diskutovali. Každý tweet a jakákoli jiná uživatelská akce generují událost, která je k dispozici pro interní analýzu dat na Twitteru. Stovky zaměstnanců tyto údaje analyzují a vizualizují, a zlepšení jejich zkušeností je hlavním prioritou týmu Twitter Data Platform.
Domníváme se, že uživatelé s širokým spektrum technických dovedností by měli mít možnost najít data a mít přístup k dobře fungujícím nástrojům pro analýzu a vizualizaci založeným na SQL. To by umožnilo celé nové skupině uživatelů s menším technickým zázemím, včetně datových analytiků a produktových manažerů, čerpat informace z dat, což by jim umožnilo lépe porozumět a využívat možnosti Twitteru. Takto demokratičtěji přistupujeme k analýze dat na Twitteru.
S postupným vylepšováním našich nástrojů a schopností pro interní analýzu dat jsme byli svědky zlepšení služby Twitter. Něco však stále zbývá. Současné nástroje, jako je Scalding, vyžadují programátorské dovednosti. Nástroje pro analýzu založené na SQL, jako jsou Presto a Vertica, mají problémy s výkonem ve velkém měřítku. Také máme problém s distribucí dat mezi různými systémy bez trvalého přístupu k nim.
Minulý rok jsme oznámili , v rámci které přesouváme části naší na Google Cloud Platform (GCP). Došli jsme k závěru, že nástroje Google Cloud nás mohou podpořit v našich iniciativách zaměřených na demokratizaci analýzy, vizualizace a strojového učení na Twitteru:
- : úložiště podnikových dat se SQL enginem založeným na , které se vyznačuje rychlostí a jednoduchostí a vyrovná se s .
- nástroj pro vizualizaci velkých dat s funkcemi spolupráce, jako v Google Docs.
Z tohoto článku se dozvíte o naší zkušenosti s těmito nástroji: co jsme udělali, co jsme se naučili a co budeme dělat dál. Nyní se zaměříme na dávkovou a interaktivní analýzu. Analýzu v reálném čase probereme v dalším článku.
Historie datových úložišť na Twitteru
Než se ponoříme do BigQuery, stojí za to stručně shrnout historii datových skladů na Twitteru. V roce 2011 se analýza dat na Twitteru prováděla pomocí Vertica a Hadoop. Pro vytváření MapReduce pracovních úloh Hadoop jsme používali Pig. V roce 2012 jsme nahradili Pig za Scalding, který měl Scala API s výhodami jako možnost vytvářet složité potrubí a jednoduchost testování. Nicméně, pro mnohé datové analytiky a produktové manažery, pro něž bylo pohodlnější pracovat s SQL, to byla dost strmá křivka učení. Přibližně v roce 2016 jsme začali používat Presto jako SQL rozhraní pro data Hadoop. Spark nabízel Python rozhraní, což ho činilo vhodnou volbou pro ad hoc datové výzkumy a strojové učení.
Od roku 2018 jsme používali následující nástroje pro analýzu a vizualizaci dat:
- Scalding pro výrobní potrubí
- Scalding a Spark pro ad hoc analýzu dat a strojové učení
- Vertica a Presto pro ad hoc a interaktivní SQL analýzu
- Druid pro malou interaktivní, průzkumnou a přístup s nízkou latencí k metrikám časových řad
- Tableau, Zeppelin a Pivot pro vizualizaci dat
Zjistili jsme, že ačkoli tyto nástroje nabízejí velmi silné možnosti, měli jsme potíže s implementací dostupnosti těchto možností pro širší publikum na Twitteru. Při rozšiřování naší platformy prostřednictvím Google Cloud se soustředíme na zjednodušení našich analytických nástrojů pro celý Twitter.
Datový sklad BigQuery od Googlu
Několik týmů na Twitteru již začlenilo BigQuery do některých svých výrobních potrubí. Využívajíc jejich zkušenosti, jsme začali hodnotit možnosti BigQuery pro všechny scénáře použití na Twitteru. Naším cílem bylo nabídnout BigQuery celé společnosti, stejně jako standardizovat a podporovat ji v rámci sady nástrojů Data Platform. To bylo náročné z mnoha důvodů. Museli jsme vyvinout infrastrukturu pro spolehlivé přijímání velkých objemů dat, podporu správy dat v měřítku celé firmy, zajištění správné kontroly přístupu a zajištění důvěrnosti klientů. Také jsme museli vytvořit systémy pro rozdělování zdrojů, monitorování a vracení plateb, aby týmy mohly efektivně využívat BigQuery.
V listopadu 2018 jsme vydali alpha verzi BigQuery a Data Studio pro celou společnost. Zaměstnancům Twitteru jsme nabídli některé z našich nejčastěji používaných tabulek s vyčištěnými osobními údaji. BigQuery používalo více než 250 uživatelů z různých týmů, včetně inženýrských, finančních a marketingových. Nedávno vykonávali přibližně 8 tisíc dotazů, zpracovávajíc kolem 100 PB měsíčně, mimo naplánované dotazy. Po obdržení velmi pozitivních zpětných vazeb jsme se rozhodli pokračovat a nabídnout BigQuery jako hlavní zdroj pro práci s daty na Twitteru.
Zde je schéma vysoceúrovňové architektury našeho datového skladu Google BigQuery.
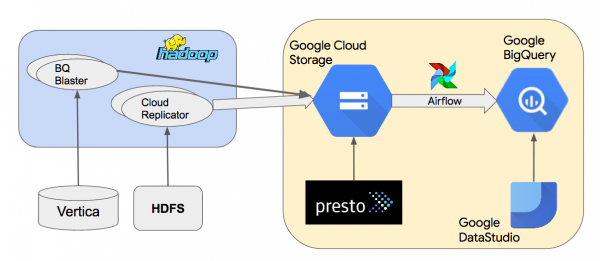
Kopírujeme data z lokálních klastrů Hadoop do Google Cloud Storage (GCS) pomocí interního nástroje Cloud Replicator. Poté používáme Apache Airflow k vytváření potrubí, která používají „“ pro načítání dat z GCS do BigQuery. Používáme Presto pro dotazování na datové sady Parquet nebo Thrift-LZO v GCS. BQ Blaster je interní nástroj Scalding pro načítání datových sad HDFS Vertica a Thrift-LZO do BigQuery.
V následujících sekcích budeme diskutovat o našem přístupu a znalostech v oblasti snadnosti použití, výkonu, správy dat, provozní efektivity a nákladů.
Snadnost použití
Zjistili jsme, že uživatelé se snadno začali s BigQuery, protože nevyžadoval instalaci softwaru a uživatelé k němu mohli přistupovat prostřednictvím intuitivního webového rozhraní. Nicméně uživatelé se museli seznámit s některými funkcemi GCP a jeho koncepty, včetně takových zdrojů, jako jsou projekty, datové sady a tabulky. Vyvinuli jsme vzdělávací materiály a tutoriály, abychom pomohli uživatelům začít. Po získání základního porozumění se uživatelům stalo snadné navigovat datovými sadami, prohlížet schéma a data tabulek, provádět jednoduché dotazy a vizualizovat výsledky v Data Studio.
Naším cílem ohledně vstupu dat do BigQuery bylo zajistit hladké načítání datových sad HDFS nebo GCS jedním kliknutím. Zvažovali jsme (řízený Airflow), ale nemohli jsme jej použít kvůli našemu modelu bezpečnosti „Domain Restricted Sharing“ (více o tom v části „Správa dat“ níže). Experimentovali jsme s použitím Google Data Transfer Service (DTS) pro organizaci zatěžovacích úloh BigQuery. I když se DTS rychle nastavilo, nebylo flexibilní pro vytváření potrubí se závislostmi. Pro naši alfa verzi jsme vytvořili vlastní prostředí Apache Airflow v GCE a připravujeme je na provoz a schopnost podporovat více zdrojů dat, jako je Vertica.
Pro transformaci dat v BigQuery uživatelé vytvářejí jednoduché datové potrubí SQL pomocí naplánovaných dotazů. Pro složitá vícestupňová potrubí se závislostmi plánujeme použít buď naši vlastní infrastrukturu Airflow, nebo Cloud Composer spolu s .
Výkon
BigQuery je navržen pro obecné SQL dotazy, které zpracovávají velké objemy dat. Není určen pro dotazy s nízkou latencí a vysokou propustností, které jsou potřebné pro transakční databáze, nebo pro analýzu časových řad s nízkou latencí, realizovanou . Pro interaktivní analytické dotazy naši uživatelé očekávají dobu odezvy pod jednu minutu. Museli jsme navrhnout použití BigQuery tak, aby vyhovovalo těmto očekáváním. Abychom zajistili předvídatelný výkon pro naše uživatele, využili jsme funkci BigQuery, dostupnou pro klienty na pevné platbě, která umožňuje vlastníkům projektů rezervovat minimální sloty pro své dotazy. BigQuery je jednotka výpočetní síly potřebná pro provádění SQL dotazů.
Analyzovali jsme více než 800 dotazů, které zpracovávají přibližně 1 TB dat každý, a zjistili jsme, že průměrný čas provedení byl 30 sekund. Také jsme se dozvěděli, že výkon silně závisí na použití našeho slotu v různých projektech a úkolech. Museli jsme jasně oddělit naše výrobní a ad hoc rezervy slotů, abychom udrželi výkon pro výrobní scénáře použití a interaktivní analýzu. To velmi ovlivnilo náš design rezervace slotů a hierarchie projektů.
O správě dat, funkčnosti a nákladech systémů si promluvíme již brzy ve druhé části překladu, ale nyní zveme všechny zájemce na , v rámci kterého se budete moci podrobně dozvědět o kurzu a také se ptát našeho experta — Egora Mateshuka (Senior Data Engineer, MaximaTelecom).
Číst víc:
Zdroj: habr.com
