

V tomto článku se podíváme na to, jak a proč jsme vyvinuli – mechanismus, který předává informace mezi klientskými aplikacemi a servery 1C:Enterprise – od zadání úkolu až po promýšlení architektury a detailů realizace.
Systém interakce (dále jen – SI) je distribuovaný systém pro výměnu zpráv s garantovaným doručením. SI je navržen jako vysoce zatěžovaný servis s vysokou škálovatelností, dostupný jak jako online služba (poskytovaná firmou 1C), tak jako licencovaný produkt, který lze nasadit na vlastních serverových zdrojích.
SI využívá distribuované úložiště a vyhledávací systém . Dále se také zmíníme o Javě a o tom, jak horizontálně škálujeme PostgreSQL.
Formulace úkolu
Abychom pochopili, proč jsme vyvinuli systém interakce, povím něco o tom, jak probíhá vývoj obchodních aplikací v 1C.
Nejprve něco o nás pro ty, kteří ještě nevědí, čemu se věnujeme :) Vyvíjíme technologickou platformu „1C:Enterprise“. Platforma zahrnuje nástroj pro vývoj obchodních aplikací a runtime, který umožňuje obchodním aplikacím fungovat v multiplatformním prostředí.
Klient-serverová paradigma vývoje
Obchodní aplikace vytvořené na „1C:Enterprise“ fungují ve třístupňové architektuře „DBMS – server aplikací – klient“. Aplikační kód napsaný v , může být prováděn na serveru aplikací nebo na klientovi. Veškerá práce s aplikačními objekty (adresáři, dokumenty atd.), stejně jako čtení a zápis do databáze, se provádějí pouze na serveru. Funkčnost formulářů a uživatelského rozhraní je také realizována na serveru. Na klientovi se provádí získávání, otevírání a zobrazování formulářů, “komunikace” s uživateli (upozornění, dotazy…), malé výpočty ve formulářích, které vyžadují rychlou reakci (např. násobení ceny množstvím), práce s místními soubory, práce se zařízením.
V aplikačním kódu je třeba v hlavičkách procedur a funkcí výslovně uvést, kde bude kód prováděn – pomocí direktiv &NaKlientovi / &NaServeru (&AtClient / &AtServer v anglické verzi jazyka). Vývojáři 1C mě právě opraví, že direktivy ve skutečnosti , ale pro nás to teď není podstatné.
Z klientského kódu lze volat serverový kód, ale ze serverového kódu nelze volat klientský. To je zásadní omezení, které jsme zavedli z několika důvodů. Mimo jiné proto, že serverový kód musí být napsán tak, aby se vykonával stejně, bez ohledu na to, odkud byl vyvolán – z klienta nebo ze serveru. V případě vyvolání serverového kódu z jiného serverového kódu klient jako takový chybí. A protože během vykonávání serverového kódu mohl klient, který ho vyvolal, zavřít aplikaci, server už nebude mít na koho volat.

Kód zpracovávající stisknutí tlačítka: vyvolání serverové procedury z klienta proběhne, vyvolání klientské procedury ze serveru – nikoli.
To znamená, že pokud bychom ze serveru chtěli poslat nějakou zprávu do klientské aplikace, například že se skončilo generování "dlouhotrvající" zprávy a zprávu lze zobrazit – takový způsob nemáme. Musíme uchopit k úskokům, například periodicky dotazovat server z klientského kódu. Ale takový přístup zatěžuje systém zbytečnými voláními a vypadá to celkově ne příliš elegantně.
A navíc je třeba například při příchozím telefonním -hovoru informovat o tom klientskou aplikaci, aby podle čísla volajícího našla jeho v databázi partnerů a zobrazila uživateli informace o volajícím partnerovi. Nebo například při přijetí objednávky na sklad informovat o tom klientskou aplikaci zákazníka. Obecně existuje spousta případů, kde by se takový mechanismus hodil.
Vlastně zadání
Vytvořit mechanismus pro výměnu zpráv. Rychlý, spolehlivý, s garantovaným doručením, s možností flexibilního vyhledávání zpráv. Na základě mechanizmu realizovat messenger (zprávy, videohovory), který bude fungovat uvnitř aplikací 1C.
Navrhnout systém horizontálně škálovatelný. Rostoucí zátěž by měla být pokryta zvyšováním počtu uzlů.
Implementace
Serverovou část SV jsme se rozhodli neintegrovat přímo do platformy 1C:Enterprise, ale implementovat jako samostatný produkt, jehož API lze volat z kódu aplikací 1C. To bylo provedeno z několika důvodů, z nichž hlavní je umožnit výměnu zpráv mezi různými aplikacemi 1C (například mezi Řízením Obchodu a Účetnictvím). Různé aplikace 1C mohou běžet na různých verzích platformy 1C:Enterprise, být umístěny na různých serverech atd. V takových podmínkách je realizace SV jako samostatného produktu, který je „na straně“ instalací 1C – optimálním řešením.
Takže jsme se rozhodli dělat SV jako samostatný produkt. Malým firmám doporučujeme používat server SV, který jsme nainstalovali v našem cloudu (wss://1cdialog.com), abychom se vyhnuli nákladům spojeným s lokální instalací a nastavením serveru. Velcí klienti mohou považovat za rozumné nainstalovat vlastní server SV na svých zdrojích. Podobný přístup jsme použili v našem cloudovém SaaS produktu. – vydává se jako sériový produkt pro instalaci u klientů, a také je nasazen v našem cloudu. .
Aplikace
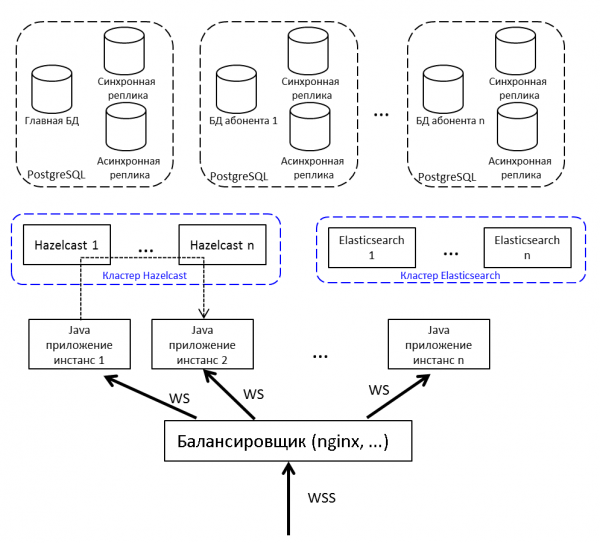
Pro rozložení zatížení a odolnost vůči výpadkům nasadíme více než jednu Java aplikaci a před ně umístíme vyrovnávač zatížení. Pokud je potřeba přenést zprávu z uzlu na uzel – použijeme publish/subscribe v Hazelcast.
Komunikace klienta se serverem – přes websocket. Ten je velmi vhodný pro systémy v reálném čase.
Distribuovaná cache
Zvolili jsme mezi Redis, Hazelcast a Ehcache. Je rok 2015. Redis právě uvedl nový cluster (příliš nový, obavy), je zde Sentinel s řadou omezení. Ehcache neumí vytvářet cluster (tato funkce se objevila později). Rozhodli jsme se zkusit Hazelcast 3.4.
Hazelcast se vytváří v clustru „out of the box“. V režimu jedné nody není příliš užitečný a může být použit pouze jako cache – neumí ukládat data na disku, ztratili jsme jedinou nodu – ztratili jsme data. Nasazujeme několik instance Hazelcast, mezi kterými zálohujeme kritická data. Cache nezálohujeme – není nám líto.
Pro nás je Hazelcast:
- Úložiště uživatelských relací. Každýkrát chodit pro relaci do databáze – trvá dlouho, proto všechny relace ukládáme do Hazelcast.
- Cache. Hledáš profil uživatele – zkontroluj v cache. Napsal jsi novou zprávu – ulož do cache.
- Témata pro komunikaci instancí aplikace. Uzlová instance generuje událost a umisťuje ji do tématu Hazelcast. Ostatní uzly aplikace, které jsou na toto téma přihlášeny, událost přijímají a zpracovávají.
- Klusterové zámky. Například vytváříme diskusi podle unikátního klíče (diskuse-singleton v rámci databáze 1C):
conversationKeyChecker.check("BENSKOLONKA");

      doInClusterLock("BENSKOLONKA", () -> {

          conversationKeyChecker.check("BENSKOLONKA");

          createChannel("BENSKOLONKA");
      });
Ověřili jsme, že kanál neexistuje. Získali jsme zámek, znovu ověřili a vytvořili. Pokud po získání zámku neprověříme, existuje riziko, že jiný vlákno v tuto chvíli také ověřilo a nyní se pokusí vytvořit stejnou diskusi – a ta už existuje. Zámky prostřednictvím synchronized nebo běžného java Lock nelze použít. Přes databázi – pomalu, a navíc je to škoda na databázi, přes Hazelcast – to je to pravé.
Vyberte DBMS
Máme bohaté a úspěšné zkušenosti s PostgreSQL a spoluprací s vývojáři této databáze.
S klustrem má PostgreSQL potíže – jsou zde , , , ale, obecně vzato, to není noSQL, které se škálují „out of the box“. NoSQL jako hlavní úložiště jsme nepovažovali, stačilo, že používáme Hazelcast, se kterým jsme dříve nepracovali.
Pokud potřebujeme škálovat relační DB – znamená to, . Jak víte, při sharding rozdělujeme databázi na jednotlivé části tak, aby každou z nich bylo možné přesunout na samostatný server.
První varianta našeho shardingu předpokládala možnost umístit každou z tabulek naší aplikace na různé servery v různých proporcích. Mnoho zpráv na serveru A – prosím, přesuňme část této tabulky na server B. Toto řešení prostě volalo po předčasné optimalizaci, takže jsme se rozhodli omezit přístup multi-tenant.
O multi-tenant přístupu si můžete přečíst například na stránkách .
V systému SV existují pojmy aplikace a předplatitele. Aplikace je konkrétní instalace obchodní aplikace, například ERP nebo účetnictví, se svými uživateli a obchodními daty. Předplatitel je organizace nebo fyzická osoba, jejímž jménem je aplikace registrována na serveru SV. Předplatitel může mít registrováno více aplikací a tyto aplikace mohou mezi sebou vyměňovat zprávy. Předplatitel se stal nájemníkem (tenant) v našem systému. Zprávy několika předplatitelů mohou být uloženy v jedné fyzické databázi; pokud vidíme, že nějaký předplatitel generuje velký provoz, přesuneme ho do samostatné fyzické databáze (nebo dokonce na samostatný server DB).
Máme hlavní databázi, kde je uložena tabulka směrování obsahující informace o umístění všech předplatitelských databází.
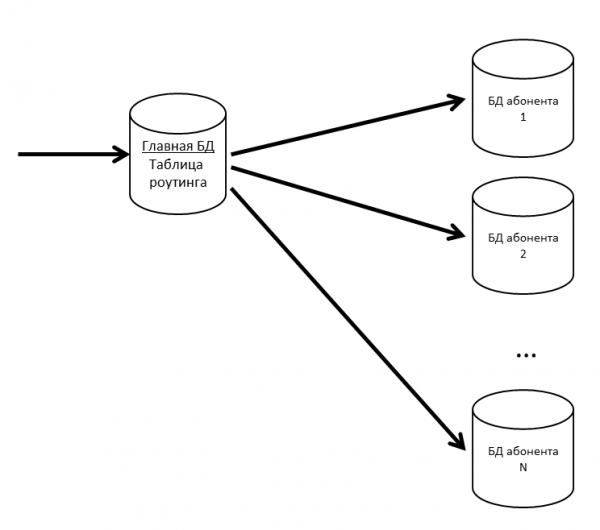
Aby hlavní databáze nebyla úzkým místem, držíme tabulku směrování (a další často používané data) v paměti.
Pokud začne databáze předplatitele zpomalovat, provedeme interně rozdělení na partitiony. Na jiných projektech pro partitionování velkých tabulek používáme .
Jelikož ztráta zpráv uživatelů je špatná, udržujeme naše databáze replikami. Kombinace synchronních a asynchronních replik nám umožňuje zajistit se pro případ ztráty hlavní databáze. Ztráta zprávy nastane pouze v případě současného selhání hlavní databáze a její synchronní repliky.
Pokud ztratíme synchronní repliku, asynchronní replika se stává synchronní.
Pokud ztratíme hlavní databázi, synchronní replika se stává hlavní databází a asynchronní replika se stává synchronní replikou.
Elasticsearch pro vyhledávání
Jelikož, kromě jiného, je SV také messenger, potřebujeme rychlé, pohodlné a flexibilní vyhledávání, které zohledňuje morfologii a neúplná shoda. Rozhodli jsme se nevynalézat kolo a použít volný vyhledávací systém Elasticsearch, který byl vytvořen na základě knihovny . Elasticsearch také nasazujeme v clusteru (master – data – data), abychom vyloučili problémy v případě selhání uzlů aplikace.
Na githubu jsme našli pro Elasticsearch a používáme ho. V indexu Elasticsearch ukládáme kořeny slov (definované pluginem) a N-gramy. Jakmile uživatel začíná zadávat text pro vyhledávání, hledáme zadaný text mezi N-gramy. Při ukládání do indexu se slovo „texty“ rozbije na následující N-gramy:
[te, tek, text, texty, ek, eks, ekst, eksty, ks, kst, ksty, st, sty, ty],
A také bude uložen kořen slova „text“. Tento přístup umožňuje vyhledávat jak na začátku, tak uprostřed a na konci slova.
Obrázek celkového pohledu
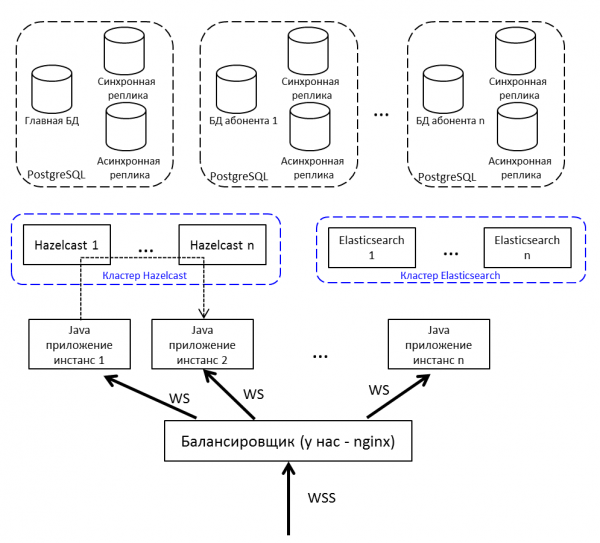
Opakování obrázku z úvodu článku, ale nyní s vysvětleními:
- Vyvažovač, vystavený na internet; máme – nginx, může být jakýkoli.
- Instance Java aplikace komunikují mezi sebou přes Hazelcast.
- Pro práci s webovým socketem používáme .
- Java aplikace je napsána v Java 8, skládá se z balíčků . V plánech je migrace na Java 10 a přechod na moduly.
Vývoj a testování
Během vývoje a testování Systému jsme narazili na řadu zajímavých zvláštností produktů, které používáme.
Zátěžové testování a úniky paměti
Každé vydání Systému zahrnuje zátěžové testování. Je úspěšné, když:
- Test běžel několik dní a nedošlo k výpadkům služeb
- Čas odezvy pro klíčové operace nepřekročil komfortní hranici
- Zhoršení výkonu ve srovnání s předchozí verzí není větší než 10%
Testovací databázi naplníme daty – k tomu získáme z produkčního serveru informace o nejaktivnějším uživateli, vynásobíme jeho čísla číslem 5 (počet zpráv, diskuzí, uživatelů) a takto testujeme.
Zátěžové testování systému interakce provádíme ve třech konfiguracích:
- Stresový test
- Pouze připojení
- Registrace uživatelů
Při stresovém testu spouštíme několik stovek vláken, která bez zastavení zatěžují systém: posílají zprávy, vytvářejí diskuze, získávají seznam zpráv. Napodobujeme činnosti běžných uživatelů (získat seznam svých nepřečtených zpráv, napsat někomu) a programových řešení (převést balík jinou konfigurací, zpracovat upozornění).
Například takto vypadá část stresového testu:
- Do systému se přihlašuje uživatel
- Žádá o své nepřečtené diskuze
- S 50% pravděpodobností čte zprávy
- S 50% pravděpodobností píše zprávy
- Dále uživatel:
- S 20% pravděpodobností vytváří novou diskusi
- Náhodně si vybírá jakoukoli ze svých diskusí
- Vstupuje dovnitř
- Žádá o zprávy, profily uživatelů
- Vytváří pět zpráv určených náhodným uživatelům z této diskuse
- Opouští diskusi
- Opakuje 20krát
- Odhlásí se, vrací se zpět na začátek scénáře
- Do systému se přihlašuje chatovací bot (emuluje výměnu zpráv z kódu aplikačních řešení)
- S 50% pravděpodobností vytváří nový kanál pro výměnu dat (speciální diskusi)
- S 50% pravděpodobností píše zprávu do jakéhokoli z existujících kanálů
Scénář "Pouze připojení" se neobjevil náhodou. Někdy nastává situace: uživatelé připojili systém, ale zatím se neangažují. Každý uživatel ráno v 09:00 zapne počítač, naváže spojení se serverem a mlčí. Tato skupina je nebezpečná, je jich mnoho – v paketech mají pouze PING/PONG, ale spojení se serverem drží (nemohou ho přerušit – co když přijde nová zpráva). Test reprodukuje situaci, kdy se během půl hodiny pokouší o autorizaci velké množství těchto uživatelů. Je to podobné stresovému testu, ale zaměřuje se právě na tento první vstup – aby nedocházelo k selháním (člověk systém nepoužívá, ale už se odpojuje – těžko si představit něco horšího).
Scénář registrace uživatelů začíná prvním spuštěním. Provedli jsme stresový test a byli jsme si jisti, že ve vyřizování systém nezpomaluje. Ale uživatelé začali přicházet a registrace začala selhávat kvůli časovým limitům. Při registraci jsme použili , který je vázán na entropii systému. Server nestíhal shromáždit dostatečné množství entropie a při žádosti o nový SecureRandom zamrzal na desítky sekund. Existuje mnoho způsobů, jak tuto situaci vyřešit, například: přejít na méně bezpečné /dev/urandom, nainstalovat speciální kartu, která generuje entropii, generovat náhodná čísla předem a uchovávat je v poolu. Prozatím jsme problém uzavřeli pomocí poolu, ale od té doby provádíme samostatný test na registraci nových uživatelů.
Jako generátor zátěže používáme . Pracovat s websocketem neumí, potřebuje plugin. První na výsledcích vyhledávání pro dotaz „jmeter websocket“ jsou , které doporučují .
Na tom jsme se rozhodli začít.
Téměř ihned po zahájení vážného testování jsme zjistili, že v JMeteru začalo docházet k únikům paměti.
Plugin – to je zvláštní velký problém, má 176 hvězd a 132 forků na githubu. Autor do něj od roku 2015 nekomitoval (vezli jsme ho v roce 2015, tehdy to nevzbudilo podezření), několik problémů na githubu ohledně úniků paměti, 7 neuzavřených pull requestů.
Pokud se rozhodnete provádět zátěžové testování pomocí tohoto pluginu, věnujte pozornost následujícím diskusím:
- V multithreadovém prostředí byl použit běžný LinkedList, nakonec jsme dostali během běhu. Řešením je buď přechod na ConcurrentLinkedDeque, nebo synchronized bloky. Vybrali jsme první variantu ().
- Únik paměti, při odpojení se informace o připojení neodstraní ().
- V režimu streamingu (kdy webový socket nekončí na konci vzorku, ale je dále používán v plánu) nefungují vzory odpovědi ().
To je to, co je na githubu. Co jsme udělali:
- Vzali jsme (@elyrank) – v něm byly opraveny problémy 1 a 3
- Vyřešili jsme problém 2
- Aktualizovali jsme jetty z 9.2.14 na 9.3.12
- Zabalili jsme SimpleDateFormat do ThreadLocal; SimpleDateFormat není thread-safe, což vedlo k NPE během běhu
- Odstranili jsme další únik paměti (připojení se nezavíralo správně při odpojení)
A přesto stále teče!
Paměť už nebyla na konci dne, ale na konci dvou dní. Času opravdu moc nezbylo, rozhodli jsme se spustit méně vláken, ale na čtyřech agentech. To by mělo stačit, alespoň na týden.
Uplynuly dva dny…
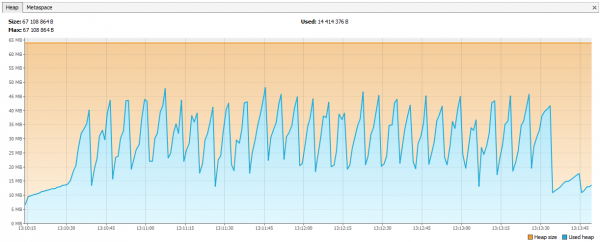
Teď se paměť začala vyčerpávat u Hazelcastu. V logách bylo vidět, že po pár dnech testování Hazelcast začíná stěžovat na nedostatek paměti, a po nějakém čase se cluster rozpadá a uzly pokračují v umírání osamoceně. Připojili jsme JVisualVM k hazelcastu a viděli jsme "stoupající pilu" – pravidelně vyvolával GC, ale nemohl vyčistit paměť.
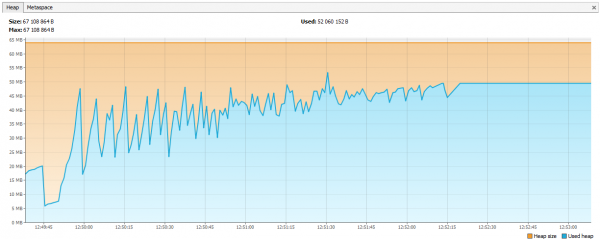
Zjistilo se, že v hazelcastu 3.4 při odstraňování mapy / multiMapy (map.destroy()) paměť není kompletně uvolněna:
Nyní je chyba opravena ve version 3.5, ale tehdy to byl problém. Vytvářeli jsme nové multiMapy s dynamickými názvy a odstraňovali podle naší logiky. Kód vypadal zhruba takto:
public void join(Authentication auth, String sub) {
    MultiMap sessions = instance.getMultiMap(sub);
    sessions.put(auth.getUserId(), auth);
}

public void leave(Authentication auth, String sub) {
    MultiMap sessions = instance.getMultiMap(sub);
    sessions.remove(auth.getUserId(), auth);

    if (sessions.size() == 0) {
        sessions.destroy();
    }
}
Výzva:
service.join(auth1, "NOVÁ_ZPRÁVA_V_DISKUSI_UUID1");
service.join(auth2, "NOVÁ_ZPRÁVA_V_DISKUSI_UUID1");
MultiMap byl vytvořen pro každé předplatné a odstraněn, když už nebyl potřeba. Rozhodli jsme se, že vytvoříme Map, kde jako klíč bude název předplatného a jako hodnoty identifikátory sezení (podle kterých lze později získat identifikátory uživatelů, pokud je to potřeba).
public void join(Authentication auth, String sub) {
    addValueToMap(sub, auth.getSessionId());
}

public void leave(Authentication auth, String sub) {
    removeValueFromMap(sub, auth.getSessionId());
}
Grafy se vyrovnaly.
Co ještě jsme se dozvěděli o testování zatížení
- JSR223 je potřeba psát v Groovy a zahrnout kompilaci do cache – to je výrazně rychlejší. .
- Grafy Jmeter-Plugins jsou jednodušší na pochopení než standardní. .
Naše zkušenosti se službou Hazelcast
Hazelcast pro nás byl novým produktem, začali jsme s ním pracovat od verze 3.4.1, nyní máme na našem produkčním serveru verzi 3.9.2 (v době psaní článku byla poslední verze Hazelcast – 3.10).
Generace ID
Začínali jsme s celočíselnými identifikátory. Řekněme, že potřebujeme další Long pro novou entitu. Sekvence v DB se nehodí, tabulky se účastní shardingu – může se stát, že existuje zpráva ID=1 v DB1 a zpráva ID=1 v DB2, do Elasticsearch takový ID nedáte, v Hazelcast také, ale nejhorší je, pokud budete chtít sloučit data ze dvou DB do jedné (například se rozhodnete, že jedna databáze je pro tyto předplatitele dostatečná). Můžete vytvořit v Hazelcast několik AtomicLong a držet čítač tam, tehdy výkon získání nového ID – incrementAndGet plus čas na dotaz do Hazelcast. Ale v Hazelcast je něco ještě optimálnějšího – FlakeIdGenerator. Každému klientovi při přístupu se vydá rozsah ID, například prvnímu – od 1 do 10 000, druhému – od 10 001 do 20 000 a tak dále. Nyní může klient vydávat nové identifikátory sám, dokud se nevyčerpá daný rozsah. Funguje to rychle, ale při restartu aplikace (a klienta Hazelcast) začíná nová posloupnost – odtud vynechání atd. Navíc vývojářům není úplně jasné, proč jsou ID celočíselná, ale jdou tak výrazně náhodně. Všechno jsme zvážili a přešli na UUID.
Mimochodem, pro ty, kteří chtějí být jako Twitter, existuje knihovna Snowcast – to je implementace Snowflake na Hazelcastu. Můžete se na to podívat zde:
Ale k tomu jsme se už nedostali.
TransactionalMap.replace
Ještě jedno překvapení: TransactionalMap.replace nefunguje. Tady je takový test:
@Test
public void replaceInMap_putsAndGetsInsideTransaction() {

    hazelcastInstance.executeTransaction(context -> {
        HazelcastTransactionContextHolder.setContext(context);
        try {
            context.getMap("map").put("key", "oldValue");
            context.getMap("map").replace("key", "oldValue", "newValue");

            String value = (String) context.getMap("map").get("key");
            assertEquals("newValue", value);

            return null;
        } finally {
            HazelcastTransactionContextHolder.clearContext();
        }
    });
}

Očekávaná hodnota: newValue
Skutečná hodnota: oldValue
Musel jsem napsat vlastní replace, použít getForUpdate:
protected  boolean replaceInMap(String mapName, K key, V oldValue, V newValue) {
    TransactionalTaskContext context = HazelcastTransactionContextHolder.getContext();
    if (context != null) {
        log.trace("[CACHE] Nahrazení hodnoty v transakční mapě");
        TransactionalMap map = context.getMap(mapName);
        V value = map.getForUpdate(key);
        if (oldValue.equals(value)) {
            map.put(key, newValue);
            return true;
        }

        return false;
    }
    log.trace("[CACHE] Nahrazení hodnoty v netransakční mapě");
    IMap map = hazelcastInstance.getMap(mapName);
    return map.replace(key, oldValue, newValue);
}
Testujte nejen běžné datové struktury, ale i jejich transakční verze. Někdy IMap funguje, ale TransactionalMap už ne.
Přidat nový JAR bez výpadku
Nejdříve jsme se rozhodli ukládat do Hazelcast objekty našich tříd. Například máme třídu Application, chceme ji uložit a přečíst. Ukládáme:
IMap map = hazelcastInstance.getMap("application");
map.set(id, application);
Čteme:
IMap map = hazelcastInstance.getMap("application");
return map.get(id);
Všechno funguje. Pak jsme se rozhodli vytvořit index v Hazelcast, abychom podle něj mohli hledat:
map.addIndex("subscriberId", false);A při zapisování nové entity jsme začali dostávat ClassNotFoundException. Hazelcast se pokusil doplnit index, ale nic nevěděl o naší třídě a chtěl, abychom mu dodali JAR s touto třídou. Udělali jsme to, všechno začalo fungovat, ale objevila se nová otázka: jak aktualizovat JAR bez úplného zastavení clusteru? Hazelcast při podání aktualizace nový JAR nepřijímá. V té chvíli jsme se rozhodli, že můžeme v klidu žít bez hledání podle indexu. Vždyť když používáme Hazelcast jako úložiště typu klíč-hodnota, tak to bude fungovat? Ne úplně. Zde se znovu objevilo různé chování IMap a TransactionalMap. Tam, kde je IMapu jedno, TransactionalMap vyhazuje chybu.
IMap. Zapisujeme 5000 objektů, čteme. Všechno očekávané.
@Test
void get5000() {
    IMap map = hazelcastInstance.getMap("application");
    UUID subscriberId = UUID.randomUUID();

    for (int i = 0; i < 5000; i++) {
        UUID id = UUID.randomUUID();
        String title = RandomStringUtils.random(5);
        Application application = new Application(id, title, subscriberId);

        map.set(id, application);
        Application retrieved = map.get(id);
        assertEquals(id, retrieved.getId());
    }
}
A v transakci to nefunguje, dostáváme ClassNotFoundException:
@Test
void get_transaction() {
    IMap map = hazelcastInstance.getMap("application_t");
    UUID subscriberId = UUID.randomUUID();
    UUID id = UUID.randomUUID();

    Application application = new Application(id, "qwer", subscriberId);
    map.set(id, application);

    Application retrievedOutside = map.get(id);
    assertEquals(id, retrievedOutside.getId());

    hazelcastInstance.executeTransaction(context -> {
        HazelcastTransactionContextHolder.setContext(context);
        try {
            TransactionalMap transactionalMap = context.getMap("application_t");
            Application retrievedInside = transactionalMap.get(id);

            assertEquals(id, retrievedInside.getId());
            return null;
        } finally {
            HazelcastTransactionContextHolder.clearContext();
        }
    });
}
Ve verzi 3.8 byl zaveden mechanismus nasazení uživatelských tříd. Můžete přiřadit jednu hlavní uzel a aktualizovat JAR soubor na ní.
Nyní jsme zcela změnili přístup: sami serializujeme do JSON a ukládáme do Hazelcast. Hazelcast nepotřebuje znát strukturu našich tříd, a my se můžeme aktualizovat bez prostoje. Správa verzí doménových objektů je v kompetenci aplikace. Současně mohou být spuštěny různé verze aplikace, a může nastat situace, kdy nová aplikace zapisuje objekty s novými poli, zatímco stará o těchto polích ještě neví. A zároveň nová aplikace čte objekty, které byly zapsány starou aplikací a neobsahují nová pole. Takové situace zpracováváme uvnitř aplikace, ale pro zjednodušení neměníme ani nemažeme pole, pouze rozšiřujeme třídy přidáním nových polí.
Jak zajišťujeme vysoký výkon
Čtyři přístupy do Hazelcast – dobře, dva do DB – špatně
Je lepší získávat data z cache než z databáze, ale nechtějí se uchovávat nevyužívané záznamy. Rozhodnutí, co cachovat, odkládáme na poslední fázi vývoje. Jakmile je nová funkčnost zakódována, zapneme v PostgreSQL logování všech dotazů (log_min_duration_statement na 0) a spustíme zátěžové testování na 20 minut. Z nasbíraných logů nástroje jako pgFouine a pgBadger umějí sestavit analytické zprávy. V těchto zprávách se nejprve zaměřujeme na pomalé a časté dotazy. Pro pomalé dotazy vytváříme plán vykonání (EXPLAIN) a hodnotíme, zda je možné takový dotaz zrychlit. Časté dotazy se stejnými vstupními daty se dobře ukládají do cache. Snažíme se udržovat dotazy „ploché“, tedy jeden dotaz na jeden stůl.
Provoz
Systém Vzájemného interakce byl spuštěn jako online služba na jaře 2017, jako samostatný produkt se Systém Vzájemného interakce objevil v listopadu 2017 (v té době v beta verzi).
Za více než rok provozu nedošlo k závažným problémům v činnosti online služby Systému Vzájemného interakce. Online službu monitorujeme prostřednictvím , sbíráme a nasazujeme z .
Distribuce serveru Systému Vzájemného interakce je dodávána ve formě nativních balíčků: RPM, DEB, MSI. Navíc poskytujeme pro Windows jednotného instalátora ve formátu EXE, který instaluje server, Hazelcast a Elasticsearch na jedno zařízení. Zpočátku jsme tuto verzi instalace nazývali „demonstrační“, ale nyní se ukázalo, že je to nejpopulárnější způsob nasazení.
Zdroj: habr.com
