

Vyvinuli jsme návrh sítě datových center, který umožňuje nasazení výpočetních klastrů o velikosti přes 100 tisíc serverů s vrcholovou šířkou pásma přenosu (bisection bandwidth) nad jeden petabyte za sekundu.
Z přednášky Dmitrije Afanaseva se dozvíte o hlavních principech nového designu, škálování topologií, vznikajících problémech, alternativních řešeních a o specifikách směrování a škálování funkcí forwarding plane moderních síťových zařízení v „hustých“ topologiích s velkým počtem ECMP tras. Dima také stručně přehledl organizaci vnější konektivity, fyzickou úroveň, kabelový systém a způsoby dalšího zvyšování kapacity.
— Dobrý den všem! Jmenuji se Dmitrij Afanasev, jsem síťový architekt Yandexu a převážně se zabývám návrhem sítí datových center.
Můj příběh bude o aktualizované síti datových center Yandexu. To je do značné míry evoluce návrhu, který jsme měli, ale zároveň obsahuje i některé nové prvky. Je to přehledná prezentace, protože jsme museli vměstnat dost informací do krátkého času. Začneme výběrem logické topologie. Následovat bude přehled control plane a problémů se škálovatelností data plane, výběr toho, co se bude dít na fyzické úrovni a podíváme se na některé specifikace zařízení. Také se dotkneme toho, co se děje v datovém centru s MPLS, o kterém jsme hovořili před nějakým časem.
Takže, co vlastně Yandex představuje z pohledu zátěží a služeb? Yandex je typický hyperscaler. Pokud se podíváme na uživatele, nejprve zde dochází k zpracování uživatelských dotazů. Také různé streamovací služby a dodávky dat, protože storage služby máme také. Pokud se podíváme blíž ke backendu, objevují se zde infrastrukturní zátěže a služby, jako jsou distribuované objektové úložiště, replikace dat a samozřejmě persistentní fronty. Jedním z hlavních typů zátěží jsou MapReduce a podobné systémy, streamové zpracování, strojové učení atd.
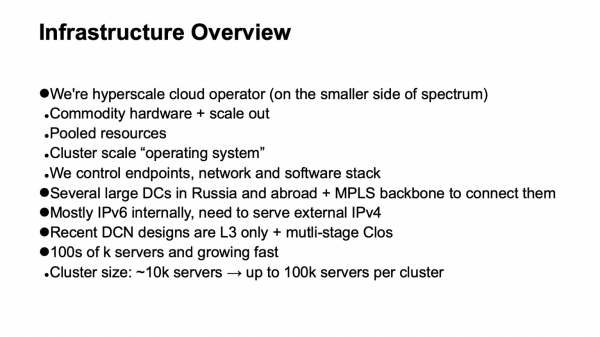
Jak je uspořádána infrastruktura, na které to všechno probíhá? Opět jsme poměrně typický hyperscaler, i když se možná nacházíme trochu blíže k té straně spektra, kde sídlí menší hyperscalery. Ale máme všechny atributy. Používáme commodity hardware a horizontální škálování všude, kde je to možné. Máme plně vybudovaný pooling zdrojů: nepracujeme s jednotlivými stroji, jednotlivými racky, ale spojujeme je do velkého poolu zaměnitelných zdrojů s nějakými dalšími službami, které se zabývají plánováním a alokací, a pracujeme se všemi tímto poolu.
Tak se nám vytváří další úroveň — operační systém na úrovni výpočetního clusteru. Je velmi důležité, že plně kontrolujeme technologický stack, který používáme. Kontrolujeme koncové body (servery), síť a softwarový stack.
Máme několik velkých datových center v Rusku i v zahraničí. Spojuje je backbone využívající technologii MPLS. Naše vnitřní infrastruktura je prakticky zcela postavena na IPv6, ale protože musíme obsluhovat externí provoz, který stále přichází převážně přes IPv4, musíme nějak doručovat požadavky přicházející přes IPv4 na frontend.servery, a trošku ještě chodit na externí IPv4 internet — například pro indexování.
Posledních několik iterací návrhu sítí datových center využívá vícestupňové Clos topologie a používá se pouze L3. Od L2 jsme se vzdali před nějakou dobou a s úlevou si oddechli. Nakonec naše infrastruktura zahrnuje stovky tisíc výpočetních (serverových) instancí. Maximální velikost clusteru byla před nějakou dobou okolo 10 tisíc serverů. To je do značné míry určeno tím, jak mohou pracovat ony operační systémy na úrovni clustera, plánovače, alokace zdrojů atd. Vzhledem k pokroku na straně infrastrukturního softwaru je nyní cílová velikost zhruba 100 tisíc serverů v jednom výpočetním clusteru, a máme úkol — umět stavět síťové továrny, které umožňují efektivně provádět pooling zdrojů v takovém clusteru.
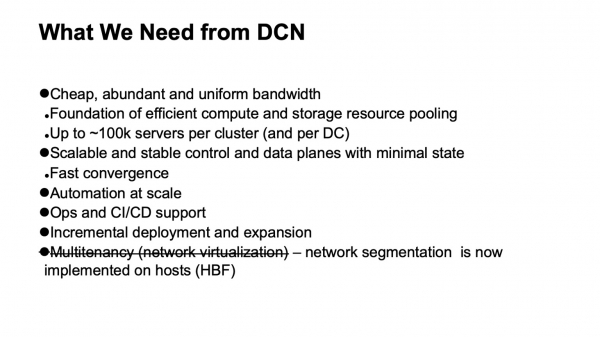
Co od sítě datového centra vlastně chceme? V první řadě hodně levné a dostatečně homogenně rozložené šířky pásma. Protože síť je to pozadí, díky kterému můžeme vykonávat pooling zdrojů. Nová cílová velikost by měla být kolem 100 000 serverů v jednom klastru.
Také samozřejmě toužíme po škálovatelném a stabilním control plane, protože na tak velké infrastruktuře vzniká dost bolesti hlavy i jen z náhodných událostí, a nechceme, aby nám přidával ještě další starosti control plane. Přitom chceme minimalizovat jeho stav. Čím méně stavu, tím lépe a stabilněji všechno funguje, snadněji se diagnostikuje.
Samozřejmě potřebujeme automatizaci, protože ruční řízení takové infrastruktury není možné, a to už není možné nějakou dobu. Potřebujeme jak podporu provozní činnosti, tak podporu CI/CD, jak to jen jde zajistit.
Při takových velikostech datových center a klastrů je již dost akutní úkol podporovat inkrementální nasazení a rozšíření bez přerušení služby. Pokud u klastrů velikosti tisíc strojů, možná blízko k deseti tisícům strojů, bylo možné je nasazovat jako jednu operaci – tedy plánujeme rozšíření infrastruktury a několik tisíc strojů je přidáno jako jedna operace, tak klastr velikosti pod sto tisíc strojů nevzniká najednou, buduje se během určité doby. A bylo by žádoucí, aby po celou tu dobu byla ta infrastruktura, která již byla nasazena, dostupná.
A jedno požadavek, který jsme měli a který zmizel: podpora multitenancy, tedy virtualizace nebo segmentace sítě. Nyní to nemusíme dělat na úrovni síťové fabriky, protože segmentace přešla na hostitele, a to nám velmi usnadnilo škálování. Díky IPv6 a velkému adresnímu prostoru jsme nemuseli ve vnitřní infrastruktuře používat duplicitní adresy, veškerá adresace byla už tak unikátní. A díky tomu, že jsme filtrace a segmentaci sítě přenesli na hostitele, nemusíme vytvářet žádné virtuální síťové entity v datových centrech.
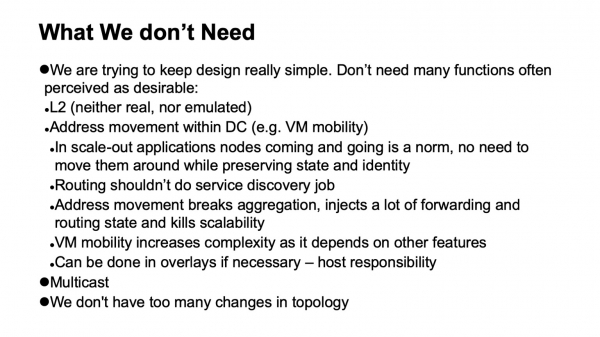
Jedna velmi důležitá věc je, že některé funkce nemusíme mít. Pokud lze některé funkce odstranit ze sítě, značně to usnadňuje život a obvykle rozšiřuje výběr dostupného hardwaru a softwaru, čímž se velmi usnadňuje diagnostika.
Co tedy nepotřebujeme, čeho jsme se byli schopni vzdát, i když ne vždy s radostí v okamžiku, kdy k tomu došlo, ale s velkým ulehčením, když byl proces dokončen?
Na prvním místě se vzdáváme L2. Ne potřebujeme L2 ani reálný, ani emulovaný. Používá se jen v malé míře díky tomu, že řídíme aplikační stack. Naše aplikace se horizontálně škálují, pracují s adresováním L3 a moc se nestarají o to, že nějaký konkrétní instance zhasla; jednoduše se nasadí nová bez potřeby zůstat na staré adrese, protože existuje samostatná úroveň objevování služeb a monitorování strojů v clusterech. Tuto úlohu nepřenášíme na síť. Úkolem sítě je doručovat pakety z bodu A do bodu B.
Také nemáme situace, kdy se adresy pohybují uvnitř sítě, což je třeba sledovat. Ve většině návrhů je to obvykle potřeba pro podporu mobility VM. Nepoužíváme mobilitu virtuálních strojů v interní infrastruktuře velkého Yandexu, a navíc věříme, že i kdyby se to dělalo, nemělo by to probíhat se podporou sítě. Pokud je to velmi nutné, mělo by se to řešit na úrovni hostitelů a posílat adresy, které mohou migrovat, do overlay, aby se příliš nezměnily dynamické změny v systému směrování samotné underlay (dopravní sítě).
Další technologie, kterou nepoužíváme, je multicast. Ti, kdo chtějí, mohu podrobně vysvětlit, proč. To výrazně usnadňuje život, protože pokud měl někdo s tímto co do činění a viděl, jak vypadá control plane multicastu — ve všech instalacích kromě nejjednodušších to je velká bolest hlavy. A navíc je obtížné najít dobře fungující otevřenou implementaci, například.
A nakonec, navrhujeme naše sítě tak, aby v nich nedocházelo k příliš mnoha změnám. Můžeme si být jisti, že tok externích událostí v systému směrování je malý.
Jaké problémy a omezení je třeba zohlednit při navrhování datového centra? Cena, samozřejmě. Škálovatelnost, do jaké míry chceme růst. Potřeba rozšíření bez zastavení služeb. Šířka pásma, dostupnost. Viditelnost toho, co se v síti děje, pro monitorovací systémy a operační týmy. Podpora automatizace — opět do té míry, jak je to možné, jelikož různé úkoly mohou být řešeny na různých úrovních, včetně zavádění dodatečných vrstev. A pak ne-[z pohledu možností]-závislost na dodavatelích. I když v různých historických obdobích, v závislosti na tom, na jaký úsek se díváme, byla tato nezávislost snadněji nebo obtížněji dosažitelná. Pokud vezmeme úsek síťových zařízení, až donedávna bylo velmi podmíněné hovořit o nezávislosti na dodavatelích, pokud jsme chtěli i čipy s vysokou šířkou pásma.
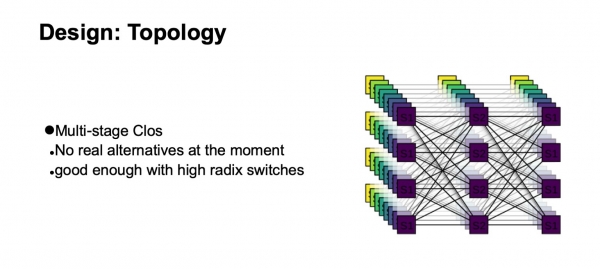
Jakou logickou topologii budeme používat pro stavbu naší sítě? Bude to víceúrovňový Clos. Ve skutečnosti v tuto chvíli neexistují žádné skutečné alternativy. A Clos-topologie je dostatečně dobrá, i když ji porovnáme s různými pokročilými topologiemi, které jsou v současnosti spíše předmětem akademického zájmu, pokud máme switche s vysokým radixem.
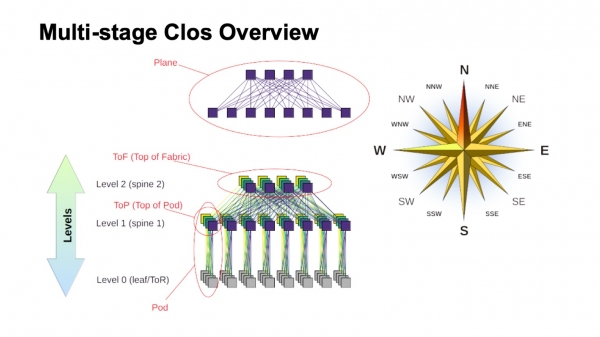
Jak přibližně funguje víceúrovňová Clos-síť a jak se v ní nazývají různé prvky? Nejprve růžice větrů, abychom se orientovali, kde je sever, kde je jih, kde je východ, kde je západ. Sítě tohoto typu obvykle budují ti, kteří mají velmi vysoký provoz z západu na východ. Co se týče ostatních prvků, nahoře je zobrazen virtuální switch sestavený z menších switchů. To je základní myšlenka rekurzivního budování Clos-sítí. Bereme prvky s nějakým radixem a spojujeme je tak, aby to, co vzniklo, mohlo být považováno za switch s vyšším radixem. Pokud potřebujeme ještě více, můžeme proceduru opakovat.
V případě například dvouúrovňových Clos, kdy lze jasně vyčlenit komponenty, které jsou na mé schématu vertikální, se jim běžně říká plošiny. Kdybychom stavěli Clos se třemi úrovněmi spine switchů (všechny, které nejsou okrajové a nejsou ToR switchi a které se používají pouze pro transit), plošiny by vypadaly složitěji, dvouúrovňové vypadají právě takto. Blok ToR nebo leaf switchů a s nimi asociované spine switche první úrovně nazýváme Pod. Spine switchi úrovně spine-1 na vrcholu Pod — to je top of Pod, vrchol Podu. Switchi, které se nacházejí na vrcholu celé fabriky — to je vrchní vrstva fabriky, Top of fabric.
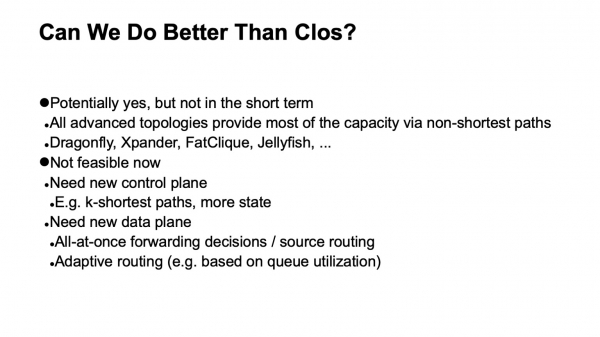
Samozřejmě, že vyvstává otázka: Clos sítě se budují už nějakou dobu, samotná myšlenka vůbec pochází z dob klasické telefonie, TDM sítí. Možná se objevilo něco lepšího, možná lze udělat něco lépe? A ano, i ne. Teoreticky ano, prakticky v nejbližší době rozhodně ne. Protože existuje určité množství zajímavých topologií, část z nich se dokonce používá v produkci, například Dragonfly se používá v HPC aplikacích; existují také zajímavé topologie jako Xpander, FatClique, Jellyfish. Pokud se podíváte na zprávy na konferencích jako SIGCOMM nebo NSDI v poslední době, můžete objevit poměrně velké množství prací na alternativních topologiích, které mají lepší vlastnosti (takové či onaké) než Clos.
Ale všechny tyto topologie mají jednu zajímavou vlastnost. Ta brání jejich zavedení v datových centrech, které se snažíme budovat na běžném hardwaru a které stojí dost rozumné peníze. Ve všech těchto alternativních topologiích je bohužel většina šířky pásma dostupná nikoli po nejkratších cestách. Proto se hned zbavujeme možnosti využít tradiční control plane.
Teoreticky je řešení úlohy známo. To jsou například modifikace link state s využitím k-nejkratších cest, ale znovu, takové protokoly, které by byly implementovány v produkci a masově dostupné na zařízení, neexistují.
Kromě toho, jelikož většina kapacity není dostupná po nejkratších cestách, musíme modifikovat nejen kontrolní rovinu, aby vybírala všechny tyto cesty (a mimochodem, to je mnohem větší stav v kontrolní rovině). Musíme také modifikovat forwarding plane a obvykle to vyžaduje alespoň dvě další funkce. První je schopnost přijímat všechna rozhodnutí o směrování paketů najednou, například na hostiteli. Skutečně se jedná o source routing, což je někdy v literatuře o interconnection networks označováno jako all-at-once forwarding decisions. A dále je to adaptivní směrování — to už je funkce, kterou potřebujeme na síťových prvcích, což se například týká výběru dalšího skoku na základě informace o nejmenší zátěži fronty. Jako příklad existují i jiné varianty.
Takže směr je zajímavý, ale bohužel ho teď nemůžeme použít.
Dobře, zastavili jsme se u logické topologie Clos. Jak ji budeme škálovat? Podívejme se, jak je uspořádána a co můžeme udělat.
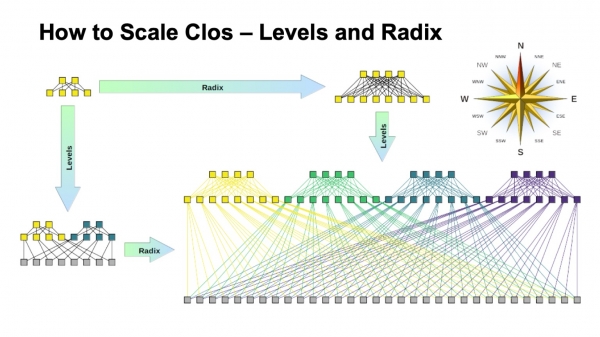
V Clos síti existují dva hlavní parametry, které můžeme nějak měnit a dosahovat různých výsledků: radix prvků a počet úrovní v síti. Mám schématicky zobrazeno, jak to ovlivňuje velikost. Ideálně kombinujeme obojí.
Je vidět, že konečná šířka Clos sítě — to je součin všech úrovní spine switchů jižního radixu, tedy kolik máme odkazů dolů, jak se větví. Takto škálujeme velikost sítě.
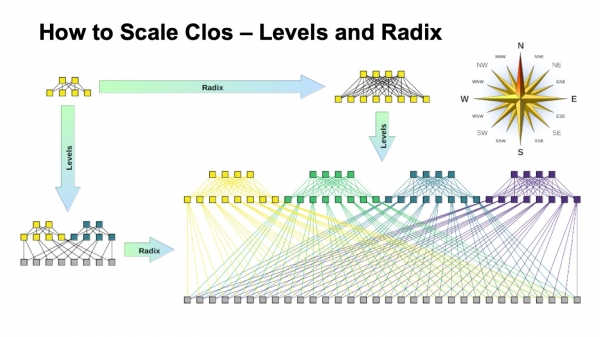
Pokud jde o kapacitu, zejména u ToR přepínačů, máme zde dvě možnosti škálování. Buď můžeme, při zachování celkové topologie, použít rychlejší odkazy, nebo můžeme přidat více rovin.
Pokud se podíváme na rozšířenou variantu Clos sítě (v pravém dolním rohu) a vrátíme se k této obrázku Clos sítě níže…
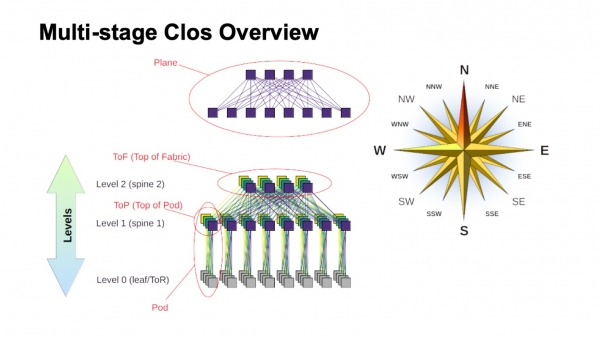
… tak je to přesně stejná topologie, ale na tomto slidu je zredukována na kompaktnější formu a vrstvy fabriky jsou na sobě. Je to totéž.
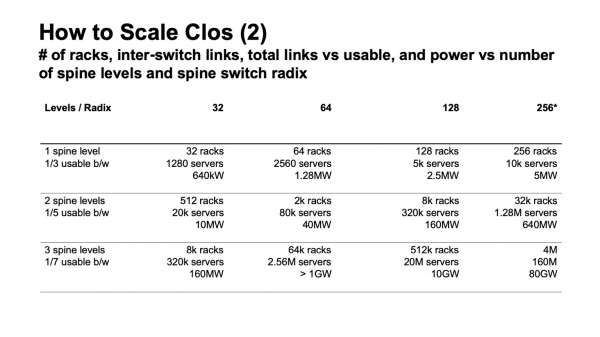
Jak vypadá škálování Clos sítě v číslech? Zde uvádím data, jaké maximální šířky může síť dosáhnout, jaké maximální množství skříní, ToR přepínačů nebo leaf přepínačů, pokud nejsou ve skříních, můžeme získat v závislosti na tom, jaký máme radix přepínačů použitých pro spine úrovně a kolik úrovní používáme.
Zde je uvedeno, kolik můžeme mít stojanů, kolik serverů a přibližně kolik energie to vše může spotřebovávat na základě 20 kW na stojan. O něco dříve jsem zmínil, že cílem je velikost clustera kolem 100 tisíc serverů.
Je vidět, že v celé této konstrukci tvoří dvě a půl varianty zajímavý pohled. Existuje varianta se dvěma vrstvami spine switchů a 64-portovými switche, která trochu zaostává. Poté se skvěle hodí varianty pro 128-portové (s radixem 128) spine switche se dvěma úrovněmi, nebo switche s radixem 32 se třemi úrovněmi. A ve všech případech, kdy je větší radix a více úrovní, je možné vytvořit velmi velkou síť, ale pokud se podíváte na očekávanou spotřebu, většinou se jedná o gigawaty. Kable lze natáhnout, ale tolik elektrické energie na jednom místě pravděpodobně nezískáme. Pokud se podíváte na statistiky, veřejné údaje o datových centrech - velmi málo datových center lze nalézt s odhadovaným výkonem větším než 150 MW. To, co je víc - obvykle jsou to datacentrové kampusy, několik velkých datových center umístěných dost blízko sebe.
Existuje ještě jeden důležitý parametr. Pokud se podíváte na levou kolonku, je tam uvedena použitelná šířka pásma. Není těžké si všimnout, že v Clos síti značná část portů slouží k propojení switchů mezi sebou. Použitelná šířka pásma - to, co může být předáno ven, směrem k serverům. Očividně mluvím o podmínkových portech a právě o šířce pásma. Obvykle jsou linky uvnitř sítě rychlejší než linky směrem k serverům, ale na jednotku šířky pásma, kterou můžeme vypravit ven k našemu serverovému vybavení, připadá ještě nějaká šířka pásma uvnitř samotné sítě. A čím více úrovní děláme, tím více proporční náklady na to, abychom tuto šířku pásma poskytli ven.
Více než to, i tato dodatečná šířka pásma není zcela jednotná. Dokud jsou vzdálenosti krátké, můžeme použít něco jako DAC (direct attach copper, tj. twinax kabely) nebo multimodové optiky, které ještě mají přijatelnou cenu. Jakmile přejdeme na delší vzdálenosti - obvykle se jedná o single mode optiku, a cena této dodatečné šířky pásma se výrazně zvyšuje.
A pokud se vrátíme k předchozímu slidu, pokud děláme Clos síť bez překreslování, není těžké se podívat na schéma a vidět, jak se síť buduje – přidáváním každé úrovně spine switchů opakujeme celou tu šířku, která byla dole. Plus úroveň – plus stejná šířka, ještě tolik portů na přepínačích, ještě tolik transceiverů. Proto je velmi žádoucí minimalizovat počet úrovní spine switchů.
Z této obrázku je jasné, že máme velkou touhu stavět na něčem jako přepínačích s radixem 128.
Tady je v podstatě to samé, co jsem teď popsal, tento slid je spíše k tomu, aby se podíval později.
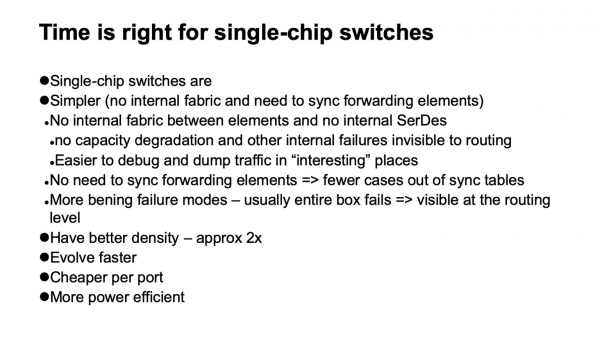
Jaké jsou možnosti, co můžeme vybrat jako takové přepínače? Velmi příjemná zpráva pro nás je, že nyní je možné tyto sítě konečně stavět na jednojárových přepínačích. A to je skvělé, mají spoustu příjemných vlastností. Například téměř postrádají interní strukturu. To znamená, že se snadněji rozbijí. Rozbijí se, kam bez toho, ale rozbijí se, naštěstí, celé. U modulárních zařízení je velké množství poruch (velmi nepříjemných), kdy z pohledu sousedů a control plane to vypadá, že funguje, ale například mu utekla část fabriky a nefunguje na plnou kapacitu. A provoz na něm se vyvažuje na základě toho, že je plně funkční, a můžeme dostat přetížení.
Nebo například se objevují problémy s backplánem, protože uvnitř modulárního zařízení také existují vysokorychlostní SerDes – má uvnitř skutečně složitou strukturu. Nebo se synchronizují či nesynchronizují tabulky mezi forwarding prvky. Obecně jakékoli výkonné modulární zařízení, které se skládá z velkého množství prvků, uvnitř sebe obvykle obsahuje stejnou Clos síť, kterou je velmi těžké diagnostikovat. Často je pro samotného dodavatele těžké ji diagnostikovat.
A existuje velké množství scénářů selhání, při kterých zařízení degraduje, ale úplně nevypadá z topologie. Vzhledem k tomu, že máme velkou síť, která aktivně využívá vyvažování mezi identickými prvky, a protože je síť velmi pravidelná, tedy jedna cesta, na které je vše v pořádku, se nijak neliší od druhé cesty, je pro nás výhodnější prostě ztratit část zařízení z topologie, než se dostat do situace, kdy některá z nich vypadají, že fungují, ale ve skutečnosti ne.
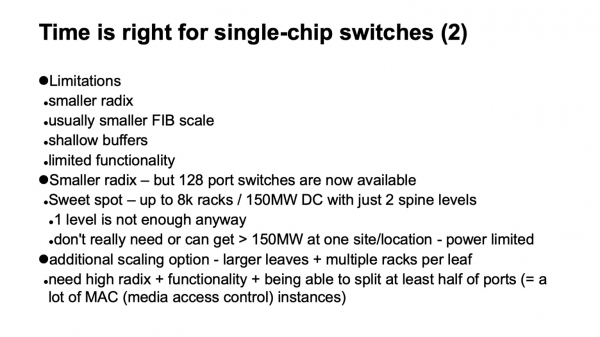
Další příjemná vlastnost jednočipových zařízení je, že se lépe evolučně vyvíjejí a rychleji. Také obvykle mají lepší kapacitu. Pokud vezmeme velké sestavené konstrukce, které máme, po obvodu, kapacita na rackovou jednotku podle portů téže rychlosti je téměř dvakrát lepší než u modulárních zařízení. Zařízení, postavená kolem jednoho čipu, se ukazují být výrazně levnější než modulární a spotřebovávají méně energie.
Ale samozřejmě to není tak snadné, jsou tu i nevýhody. Za prvé, prakticky vždy menší radix než u modulárních zařízení. Pokud můžeme získat zařízení, postavené kolem jednoho čipu, na 128 portů, tak modulární zařízení můžeme získat na několik stovek portů bez větších problémů.
To znamená výrazně menší velikosti forwarding tabulek a obecně všeho, co se týká škálovatelnosti datové roviny. Mělké buffery a obvykle poměrně omezená funkcionalita. Ukazuje se však, že pokud známe tato omezení a včas se postaráme o to, abychom je obcházeli nebo je jednoduše vzali v úvahu, není to tak hrozné. To, že je radix menší, na nedávno vyvinutých zařízeních s radixem 128 není problém, už můžeme postavit dvě vrstvy spine. A méně než dvě nemůžeme nic zajímavého pro nás vybudovat. S jednou vrstvou se vytvářejí velmi malé clustery. I naše předchozí návrhy a požadavky je převyšovaly.
Ve skutečnosti, pokud se řešení někde nachází na hraně, existuje další způsob, jak škálovat. Protože poslední (nebo první) nejnižší úroveň, na kterou se servery připojují, jsou ToR switche nebo leaf switche, nemusíme je připojovat k jedné skříni. Proto, pokud je řešení někde dvakrát slabé, můžeme zvažovat jednoduše použít switch s větším radixem na spodní úrovni a připojit například dvě až tři skříně k jednomu switchi. To je také možnost, má své náklady, ale funguje to a může to být dobré řešení, když je potřeba dvěma krátky rozšířit velikost.
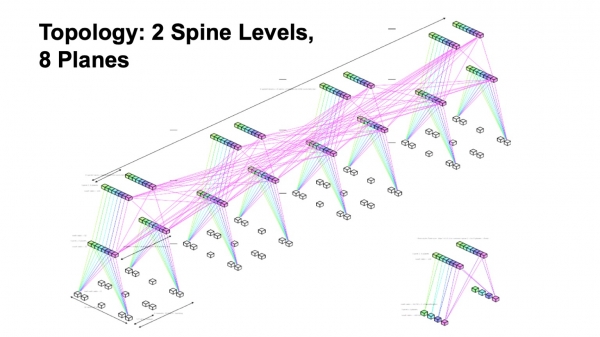
Shrnujeme, budujeme topologii se dvěma úrovněmi spine, s osmi vrstvami fabriky.
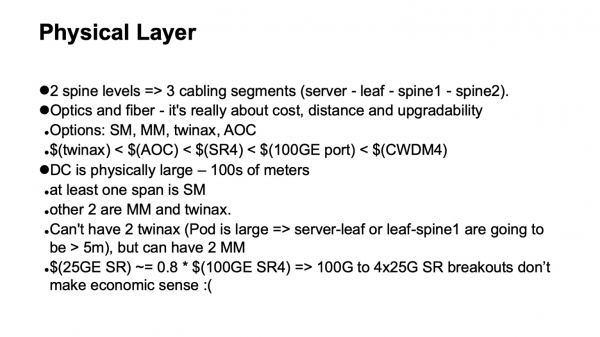
Co bude s fyzikou? Velmi jednoduché výpočty. Pokud máme dvě úrovně spine, znamená to, že máme celkem tři úrovně switchů a očekáváme, že v síti budou tři kabelové segmenty: od serverů k leaf switchům, k spine 1, k spine 2. Varianty, které můžeme použít - to jsou twinax, multimode, single mode. A zde je třeba brát v úvahu, jaká šířka pásma je k dispozici, kolik to bude stát, jaké jsou fyzické rozměry, jaké rozpětí můžeme projít a jak budeme upgradovat.
Co se týče nákladů, vše lze uspořádat do řady. Twinaxy stojí znatelně méně než aktivní optika, levněji než multimode transceivery, pokud to srovnáme podle rozpětí, několikrát levněji než 100-gigabitový port switche. A ten, pozor, stojí méně než single mode optika, protože na místech, kde je vyžadována single mode, má smysl v datových centrech z různých důvodů používat CWDM, s paralelní single mode (PSM) se moc dobře nepracuje, vznikají velmi velké balíky vláken, a pokud se zastavíme u těchto technologií, vychází přibližně taková hierarchie cen.
Ještě jedna poznámka: bohužel, není moc možné používat rozebrané 100 k 4x25 multimode porty. Vzhledem k vlastnostem konstrukce transceiverů SFP28 stojí ne mnohem méně než QSFP28 na 100 Gbit. A ta rozebraná varianta pro multimode nefunguje moc dobře.
Další omezení spočívá v tom, že kvůli velikosti výpočetních clusterů a počtu serverů jsou naše datová centra fyzicky velká. To znamená, že alespoň jeden úsek bude muset být proveden se single-mode. Opět, kvůli fyzické velikosti Pods není možné projít dvěma úseky twinax (měděnými kabely).
Takže, pokud optimalizujeme podle ceny a zohledníme geometrii této konstrukce, dostaneme jeden úsek twinaxem, jeden úsek multimodem a jeden úsek single-modem pomocí CWDM. To zohledňuje možné cesty k upgradu.
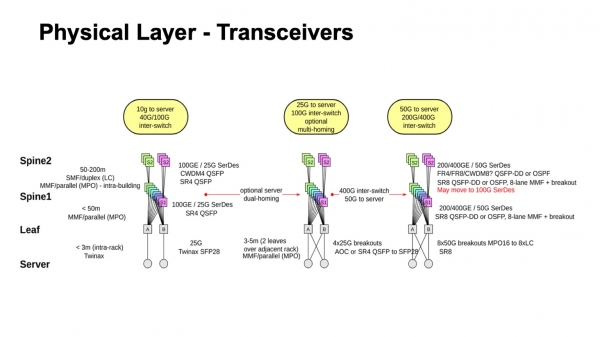
Zhruba takto vypadá, co bylo nedávno, kam směřujeme a co je možné. Je jasné, alespoň jak se pohybovat směrem k 50-gigabitovým SerDes a jak pro multimod, tak pro single-mod. Navíc, pokud se podíváme na to, co je nyní k dispozici u single-mode transceiverů a na perspektivu pro 400G, často se stává, že když přicházejí 50G SerDes z elektrické stránky, mohou do optiky odcházet již s 100 Gbps na kanál. Proto je velmi pravděpodobné, že místo přechodu na 50 dojde k přechodu na 100-gigabitové SerDes a 100 Gbps na kanál, protože podle slibů mnoha dodavatelů se jejich dostupnost očekává poměrně brzy. Období, kdy byly 50G SerDes nejrychlejší, se jeví jako krátké, protože první vzorky 100G SerDes se objeví již příští rok. A po nějaké době po tom mohou být k dispozici za rozumné ceny.
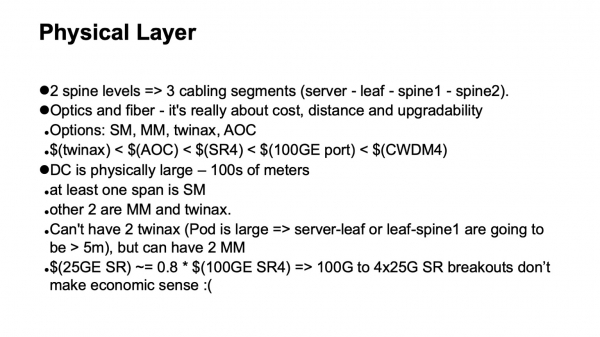
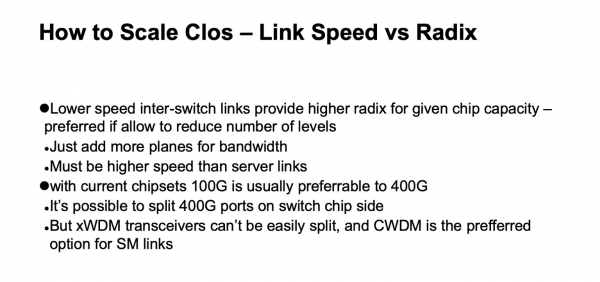
Další aspekt ohledně volby fyziky. V zásadě už teď můžeme používat 400- nebo 200-gigabitové porty za použití 50G SerDes. Ale ukazuje se, že to nemá zvláštní smysl, protože, jak jsem říkal dříve, chceme mít dostatečný radix na switchích, samozřejmě v rozumných mezích. Chceme 128. A pokud je kapacita čipu omezená a zvyšujeme rychlost linky, radix se přirozeně snižuje, žádné zázraky.
Celkovou kapacitu můžeme zvýšit přidáním více ploch, přičemž náklady nejsou vysoké, můžeme přidat počet ploch. Pokud ztratíme radix, budeme muset zavést další úroveň, takže při současných výpočtech, s aktuální maximální dostupnou kapacitou na jeden čip, se ukazuje, že efektivněji je používat 100-gigabitové porty, protože ty umožňují získat vyšší radix.
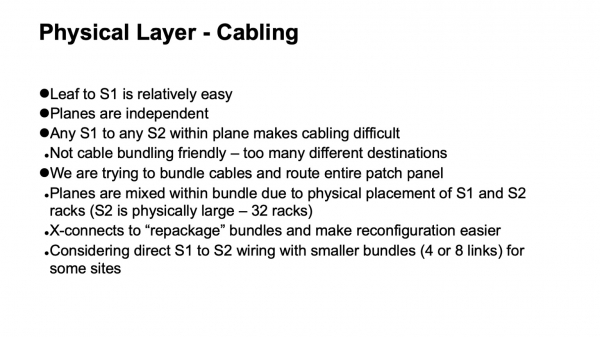
Další otázka je, jak je organizována fyzika, ale tentokrát z pohledu kabelové infrastruktury. Ukazuje se, že je organizována docela vtipně. Kabeláž mezi leaf switche a spine switche první úrovně — tam není tolik spojení, všechno je postaveno relativně jednoduše. Ale pokud vezmeme jednu rovinu, to, co se děje uvnitř — je třeba spojit všechny spine switche první úrovně se všemi spine switche druhé úrovně.
Kromě toho obvykle existují některé požadavky na to, jak by to mělo vypadat uvnitř datového centra. Například, velmi jsme chtěli spojovat kabely do svazků a táhnout je tak, aby jedna patch panel s vysokou hustotou kompletně zapadla do jednoho patch panel, aby nedocházelo k chaosu v délkách. Tento úkol se nám podařilo vyřešit. Pokud se podíváme na logickou topologii, je vidět, že roviny jsou nezávislé, každá rovina může být postavena samostatně. Ale když přidáme takové bundlování a chceme táhnout kompletní patch panel do patch panel, musíme uvnitř jednoho svazku míchat různé roviny a zavést mezilehlou konstrukci ve formě optických cross-connectů, abychom je přepakovali od toho, jak byly sestaveny na jednom segmentu, na to, jak budou sestaveny na jiném segmentu. Díky tomu získáváme příjemnou vlastnost: veškerá složitá komutace nepřesahuje hranice stojanů. Když je potřeba něco silně zamotat, „otočit roviny“, jak se tomu někdy říká v Clos sítích, všechno je soustředěno uvnitř jednoho stojanu. Nemáme silně rozebrané, dokonce až po jednotlivá spojení, komutace mezi stojany.
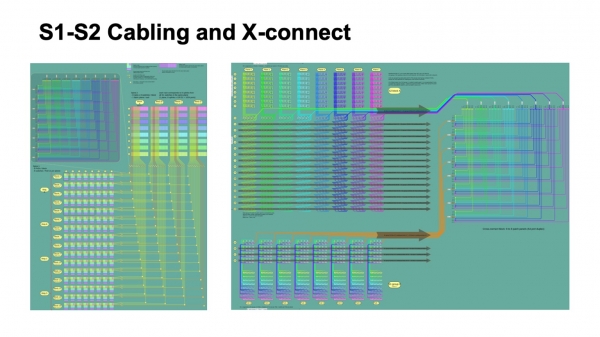
Tak to vypadá z pohledu logické organizace kabelové infrastruktury. Na obrázku vlevo různobarevné bloky představují bloky spine switchů první úrovně, po osmi kusech, a čtyři svazky kabelů, které od nich vedou a kříží se se svazky vedoucími od bloků spine 2 switchů.
Malé čtverce označují křižovatky. Vlevo nahoře je rozkreslení každé z těchto křižovatek, to je vlastně modul cross-connect 512 na 512 portů, které přehazují kabely tak, aby se dostaly zcela do jedné skříně, kde je pouze jedna rovina spine-2. A vpravo je rozkreslení tohoto obrázku o něco detailnější, vztahující se k několika Pods na úrovni spine-1, a jak to je zabaleno v cross-connectu, jak to přichází na úroveň spine-2.
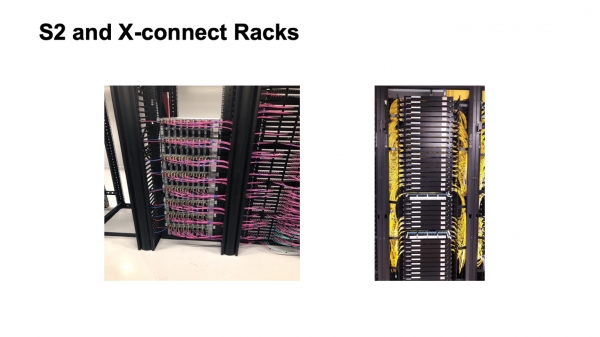
Takhle to vypadá. Ještě není úplně poskládaná skříň spine-2 (vlevo) a skříň cross-connectu. Bohužel tam není moc co vidět. Celá tato konstrukce se právě nyní rozvíjí v jednom z našich velkých datových center, které se rozšiřuje. Práce probíhá, bude to vypadat lépe, bude lépe zaplněno.
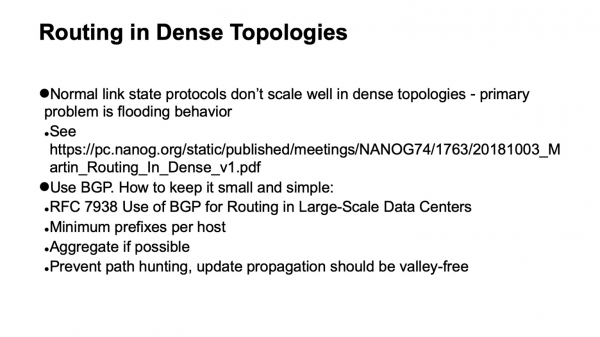
Důležitá otázka: vybrali jsme logickou topologii, postavili fyziku. Co bude s control plane? Je celkem dobře známo z provozních zkušeností, že existuje určité množství prezentací, že link state protokoly jsou dobré, je s nimi příjemné pracovat, ale bohužel se na hustě provázané topologii špatně škálují. A existuje jeden hlavní faktor, který tomu brání — je to způsob, jakým funguje flooding v link state protokolech. Pokud se podíváme na algoritmus flooding a zhodnotíme, jak je naše síť uspořádána, vidíme, že v každém kroku bude velmi vysoký fanout a bude jednoduše zaplavovat control plane aktualizacemi. Konkrétně takové topologie konkrétně s tradičním algoritmem flooding v link state protokolech se velmi špatně kombinují.
Volba — použít BGP. Jak ho správně připravit, je popsáno v RFC 7938 o používání BGP ve velkých datových centrech. Základní myšlenky jsou jednoduché: minimální počet prefixů na hostitele a obecně minimální počet prefixů v síti, používat agregaci, pokud je to možné, a potlačovat path hunting. Chceme velmi opatrné, velmi kontrolované šíření aktualizací, což se nazývá valley free. Chceme, aby se aktualizace, které procházejí sítí, rozvinuly právě jednou. Pokud vznikají dole, jdou nahoru, rozvinou se nejvýše jednou. Neměly by být žádné zigzagy. Zigzagy jsou velmi špatné.
Aby to udělali, používáme dost jednoduchou schéma pro využití základních mechanismů BGP. To znamená, že používáme eBGP, fungující na link local, a autonomní systémy jsou přidělovány následujícím způsobem: autonomní systém na ToR, autonomní systém pro celý blok spine-1 switchů jednoho Podu, a společný autonomní systém pro celý Top of Fabric. Není těžké se podívat a ujistit se, že i normální chování BGP nám dává to rozšíření aktualizací, které chceme.
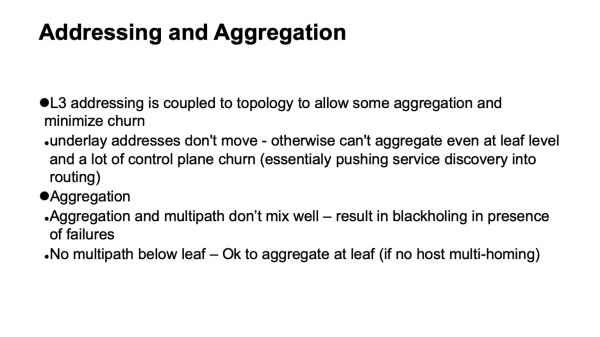
Samozřejmě je nutné navrhnout adresaci a agregaci adres tak, aby to bylo kompatibilní s tím, jak je postavena routování, aby to zajišťovalo stabilitu control plane. L3 adresace v transportu je spojena s topologií, protože bez toho nelze dosáhnout agregace, bez toho jednotlivé adresy projdou do systému routování. A další věcí je, že agregace, bohužel, se nespojuje příliš dobře s multi-path, protože když máme multi-path a agregaci, všechno je v pořádku, když je celá síť funkční, bez poruch. Bohužel, jakmile se v síti objeví poruchy a symetrie topologie se ztratí, můžeme se dostat do bodu, ze kterého byl oznámen agregát, což znemožňuje projít dále tam, kam potřebujeme. Proto je nejlepší agregovat tam, kde dále není multi-path, v našem případě to jsou ToR switche.
Ve skutečnosti je možné agregovat, ale opatrně. Pokud můžeme provést kontrolovanou deagregaci při výskytu poruch v síti. Ale to je dost složitý úkol, dokonce jsme zvažovali, zda to lze udělat, zda je možné přidat další automatiku, a konečné automaty, které správně vyhodí BGP, aby dosáhly požadovaného chování. Bohužel zpracování corner cases je velmi nejasné a složité, a připojením externího vybavení k BGP se tento úkol příliš dobře neřeší.
Velmi zajímavá práce byla v tomto ohledu provedena v rámci protokolu RIFT, o kterém bude hovořeno v následující prezentaci.
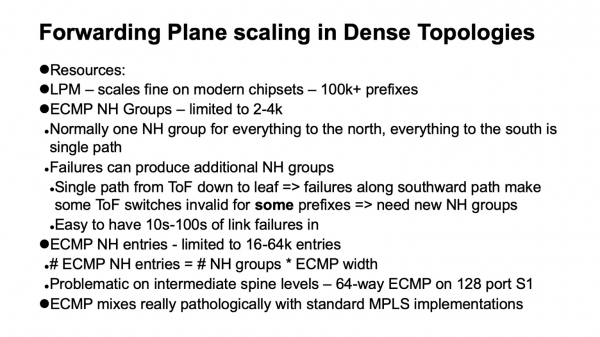
Další důležitou věcí je, jak se datová rovina škáluje v hustých topologiích, kde máme velký počet alternativních cest. K tomu se používá několik dalších datových struktur: skupiny ECMP, které popisují, na druhou stranu, skupiny Next Hop.
V normálně fungující síti, bez výpadků, když jdeme po Clos topologii nahoru, stačí použít pouze jednu skupinu, protože vše, co není místní, je popsáno výchozím nastavením, je možné jít nahoru. Když jdeme shora dolů na jih, všechny cesty nejsou ECMP, jsou to single path cesty. Všechno je v pořádku. Problém je v tom, a zvláštnost klasické Clos topologie je, že pokud se podíváme na vrchol tkaniny, na jakýkoli prvek, jakýkoli prvek na spodní straně má jednu cestu. Pokud se po této cestě vyskytnou výpadky, konkrétně tento prvek na vrcholu tkaniny se stává neplatným právě pro ty prefixy, které leží za porušenou cestou. A pro ostatní je platný, a musíme rozebrat ECMP skupiny a zavést nový stav.
Jak vypadá škálovatelnost data plane na moderních zařízeních? Pokud děláme LPM (nejdelší shoda prefixu), vše je dost dobré, nad 100k prefixů. Pokud mluvíme o skupinách Next Hop, tak je to horší, 2-4 tisíce. Pokud mluvíme o tabulce, která obsahuje popis Next Hop (nebo sousedství), tak je to někde mezi 16k a 64k. A to se může stát problémem. A tady se dostáváme k zajímavému odbočení: co se vlastně stalo s MPLS v datacentrech? V podstatě jsme to chtěli udělat.
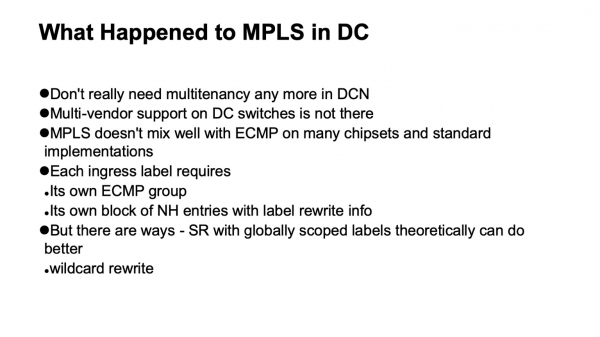
Staly se dvě věci. Udělali jsme mikrosegmentaci na hostech, a tak jsme to nemuseli dělat na síti. Podpora od různých dodavatelů a zejména otevřené implementace na white boxes s MPLS nebyla příliš dobrá. A také MPLS, alespoň jeho tradiční implementace, se bohužel velmi špatně slučuje s ECMP. A to je důvod.
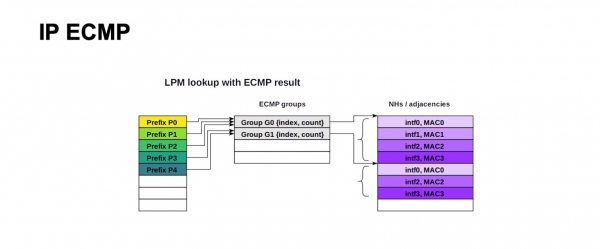
Takto vypadá struktura ECMP forwardingu pro IP. Velké množství prefixů může používat stejnou skupinu a stejný blok Next Hops (nebo sousedství, v různých dokumentacích na různé zařízení se to může nazývat různě). Smyslem je, že je to popsáno jako výstupní port a na co přepisovat MAC adresu, aby se dostali na správný Next Hop. Pro IP to vypadá jednoduše, lze použít na velmi velké množství prefixů na stejnou skupinu, stejný blok Next Hops.
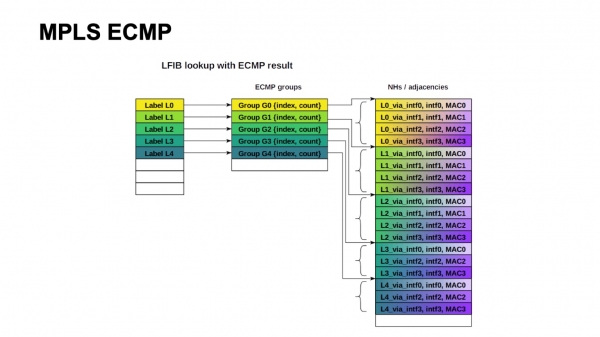
Klasická architektura MPLS předpokládá — v závislosti na výstupním rozhraní se může značka přepisovat na různé hodnoty. Proto musíme uchovávat skupinu a blok Next Hops na každou příchozí značku. A to, bohužel, není škálovatelné.
Není těžké si uvědomit, že jsme potřebovali kolem 4000 ToR switchů, maximální šířka — 64 cesty ECMP, pokud se přesuneme z spine-1 na spine-2. S obtížemi se vejdeme, na hranici, do jedné tabulky ECMP skupin, pokud pouze jeden prefix s ToR odchází, a vůbec se nevejdeme do tabulky Next Hops.
Všechno není beznadějné, protože architektury jako Segment Routing předpokládají globální značky. Formálně bychom mohli znovu zredukovat všechny tyto bloky Next Hops. K tomu je potřeba operace typu wild card: vzít značku a přepsat ji na stejnou bez konkrétní hodnoty. Ale bohužel v dostupných implementacích to moc není.
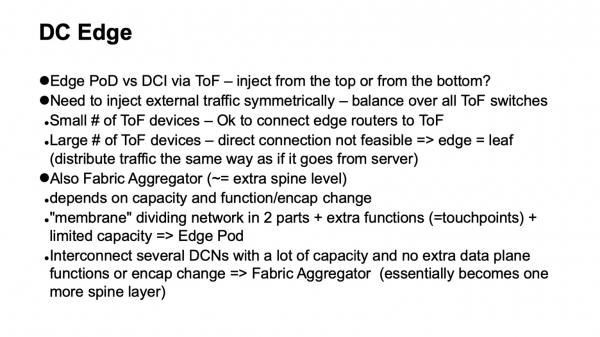
A konečně, musíme do datacentra přivádět externí provoz. Jak to udělat? Dříve byl provoz přiváděn do Clos sítí shora. To znamená, že existovaly hraniční směrovače, které se připojovaly ke všem zařízením na Top of fabric. Toto řešení funguje docela dobře v malých a středních velikostech. Bohužel, aby bylo možné přivést provoz tímto způsobem symetricky do celé sítě, je potřeba přicházet současně ke všem prvkům Top of fabric, a když jich je více než sto, zjistí se, že potřebujeme velký radix také na hraničních směrovačích. Opravdu, to stojí peníze, protože hraniční směrovače jsou funkčnější, porty na nich budou dražší, takže to nevypadá moc hezky.
Další možností je přivádět takový provoz zdola. Není těžké si ověřit, že Clos topologie je postavena tak, že provoz přicházející zdola, tedy ze strany ToR, se rovnoměrně rozděluje po úrovních na celé Top of fabric ve dvou iteracích, zatěžujíc celou síť. Proto zavádíme speciální typ Pod, Edge Pod, které zajišťují externí konektivitu.
Existuje ještě jedna možnost. Například Facebook to dělá. Nazývá se to Fabric Aggregator nebo HGRID. Zavádí se další úroveň spine, aby se spojilo několik datových center. Taková konstrukce je možná, pokud na spojích nemáme další funkce nebo změnu kapslování. Pokud existují, jsou to další touch points, což je složité. Obvykle se objevuje více funkcí a jakási membrána, která odděluje různé části datového centra. Není dobré dělat takovou membránu velkou, ale pokud je z nějakého důvodu opravdu potřebná, má smysl ji zvážit, udělat co nejširší a přesunout na hostitele. Tak to dělá mnoho cloudových operátorů. Mají overlays, které začínají na hostitelích.
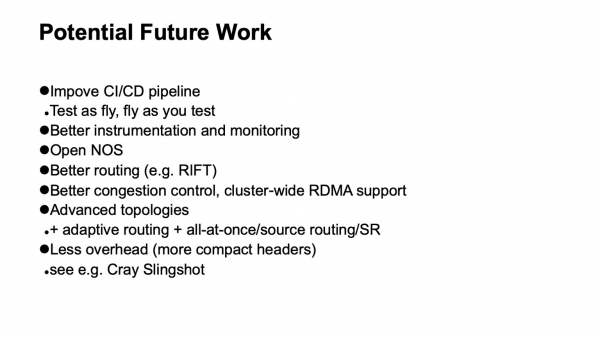
Jaké vidíme možnosti rozvoje? Především zlepšení podpory CI/CD pipeline. Chceme létat tak, jak testujeme, a testovat tak, jak létáme. To se však příliš nedaří, protože infrastruktura je rozsáhlá a nelze ji duplikovat pro testy. Je třeba pochopit, jak zavést prvky testování do pracovní infrastruktury, aniž bychom ji přitom snižovali.
Lepší instrumentace a lepší monitorování jsou prakticky vždy k nezaplacení. Celý problém spočívá v rovnováze mezi úsilím a výnosem. Pokud je možné přidat rozumným způsobem — je to velmi dobře.
Otevřené operační systémy pro síťová zařízení. Nejlepší protokoly a nejlepší směrovací systémy, například RIFT. Také jsou třeba výzkumy na používání nejlepších schémat řízení congestion control a možná zavedení, alespoň na některých místech, podpory RDMA v rámci clusteru.
Pokud se díváme na vzdálenější budoucnost, jsou zapotřebí pokročilé topologie a možná sítě s menšími overheady. Z nových věcí — nedávno byly publikace o technologii fabric pro HPC Cray Slingshot, která je založena na commodity Ethernet, ale s možností použití mnohem kratších hlaviček. Výsledkem je snížení overheadu.
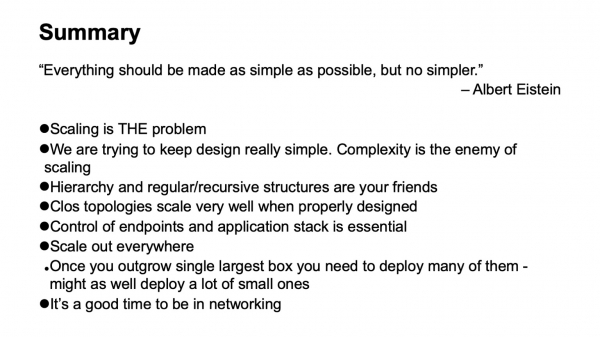
Vše by mělo být co nejjednodušší, jak to jen jde, ale ne jednodušší. Složitost je nepřítelem škálovatelnosti. Jednoduchost a pravidelné struktury jsou naši přátelé. Pokud je možné někde rozšířit — udělejte to. A vůbec, teď je skvělé se zabývat síťovými technologiemi. Děje se spousta zajímavého. Děkuji.
Zdroj: habr.com
