

Žijeme v úžasné době, kdy je možné rychle a jednoduše propojit několik hotových otevřených nástrojů, nastavit je s "vypnutým vědomím" podle rad ze stackoverflow, aniž bychom se zabývali "dlouhými výrazy", a uvést je do komerčního provozu. A když bude potřeba se aktualizovat/rozšiřovat, nebo někdo náhodou restartuje pár strojů — uvědomíme si, že začíná nějaký obtěžující zlý sen naživu, vše se náhle zkomplikovalo do nepoznání, cesta zpět není, budoucnost je nejasná a bezpečnější je místo programování chovat včely a vyrábět sýr.
Není divu, že zkušenější kolegové, s šedinami způsobenými bugy, pozorují neuvěřitelně rychlé nasazení balíčků "kontejnerů" v "kostkách" na desítkách serverů na "moderních jazycích" s vestavěnou podporou asynchronního-neblokovatelného vstupu-výstupu — skromně se usmívají. A tiše pokračují ve čtení "man ps", soustředí se do krve na zdrojové kódy "nginx" a píší-píší-píší unit testy. Kolegové vědí, že to nejzajímavější je teprve před námi, když se "to všechno" jednou stane nocí kolena pod Nový rok. A pomůže jim jen hluboké porozumění povaze unixu, naučené tabulky stavů TCP/IP a základní algoritmy třídění-hledání. Aby mohli s úderem hodin oživit systém.
Ach ano, trochu jsem se odklonil, ale doufám, že se mi podařilo předat stav očekávání.
Dnes bych se chtěl podělit o naši zkušenost s nasazením pohodlného a levného stacku pro DataLake, který řeší většinu analytických úkolů ve firmě pro úplně různé struktury.
Před nějakým časem jsme dospěli k názoru, že firmy čím dál více potřebují plody jak produktové, tak technické analytiky (o třešinkách na dortu v podobě strojového učení nemluvě) a pro pochopení trendů a rizik — je potřeba sbírat a analyzovat stále více a více metrik.
Základní technická analytika v "Bitrix24"
Před několika lety, spolu se spuštěním služby „Bitrix24“, jsme intenzivně investovali čas a zdroje do vytvoření jednoduché a spolehlivé analytické platformy, která by pomáhala rychle odhalit problémy v infrastruktuře a naplánovat další kroky. Samozřejmě, že nástroje bylo žádoucí mít hotové, co nejjednodušší a srozumitelné. Výsledkem byl výběr Nagios pro monitoring a Munin pro analytiku a vizualizaci. Nyní máme tisíce kontrol v Nagios, stovky grafů v Munin a kolegové je denně úspěšně využívají. Metry jsou srozumitelné, grafy jasné, systém funguje spolehlivě již několik let a pravidelně se do něj přidávají nové testy a grafy: zavádíme novou službu do provozu — přidáváme několik testů a grafů. Šťastnou cestu.
Ruka na pulsu — rozšířená technická analytika
Touha získávat informace o problémech „co nejrychleji“ nás přivedla k aktivním experimentům se jednoduchými a srozumitelnými nástroji — Pinba a XHProf.
Pinba nám odesílala statistiky o rychlosti fungování částí webových stránek na PHP v UDP paketech, a my jsme mohli v reálném čase vidět v úložišti MySQL (s Pinba jde vlastní engine MySQL pro rychlou analýzu událostí) krátký seznam problémů a reagovat na ně. A XHProf automaticky shromažďoval grafy vykonávání nejpomalejších PHP stránek u klientů a analyzoval, co to mohlo způsobit — v klidu, při šálku čaje nebo něčeho silnějšího.
Před nějakou dobou byl nástroj doplněn dalším poměrně jednoduchým a srozumitelným enginem na základě algoritmu obráceného indexu, skvěle implementovaného v legendární knihovně Lucene — Elastic/Kibana. Jednoduchá idea vícestupňového zapisování dokumentů do inverzního indexu Lucene na základě událostí v logech a rychlé vyhledávání pomocí fasetního dělení se ukázala jako skutečně užitečná.
Navzdory poněkud technickému vzhledu vizualizací v Kibana s „protékajícími nahoře“ nízkoúrovňovými koncepty jako „bucket“ a znovu vynalezenému jazyku dávno zapomenuté relační algebry — nástroj se nám začal dobře pomáhat při následujících úlohách:
- Kolik bylo chyb PHP u klienta Bitrix24 na portálu p1 za poslední hodinu a jaké? Pochopit, odpustit a rychle opravit.
- Kolik video hovorů proběhlo na portálech v Německu za posledních 24 hodin, jaká byla jejich kvalita a byly nějaké problémy s kanálem/sítí?
- Jak dobře funguje systémová funkce (naše rozšíření v C pro PHP), zkompilovaná z zdrojových kódů v poslední aktualizaci služby a distribuovaná klientům? Neobjevily se segfaulty?
- Jsou data klientů uložena v paměti PHP? Neobjevily se chyby překročení přidělené paměti procesům: „out of memory“? Najít a odstranit.
Zde je konkrétní příklad. I přes pečlivé a vícestupňové testování se u klienta objevila nepříjemná a nečekaná chyba při velmi atypickém případu a poškozených vstupních datech, zazněl alarm a začal proces jejího rychlého opravení:
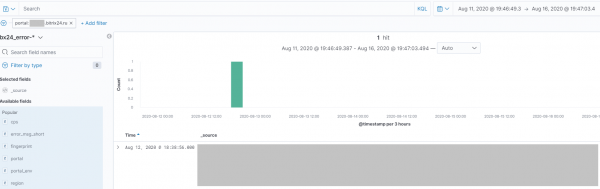
Kromě toho umožňuje Kibana uspořádat upozornění na vybrané události a během krátkého času začalo tímto nástrojem používat desítky zaměstnanců z různých oddělení – od technické podpory a vývoje až po QA.
Aktivitu jakéhokoli oddělení uvnitř společnosti bylo možné snadno sledovat a měřit – místo ručního analýzy logů na serverech stačilo jednou nastavit parsování logů a jejich odesílání do elastic clusteru, aby si člověk mohl užívat pohled na dashboardu Kibana, kolik prodaných dvouhlavých koťat bylo vytištěno na 3D tiskárně za minulý lunární měsíc.
Základní business analytika
Všichni ví, že často business analytika ve společnostech začíná extrémně aktivním používáním, ano, ano, Excelu. Ale hlavně, aby tímto nekončila. Olej do ohně ještě dobře přilévá cloudový Google Analytics – na dobrém si zvykneš rychle.
V naší harmonicky se rozvíjející společnosti se začali objevovat "proroci" intenzivnější práce s většími daty. Pravidelně se objevují potřeby po hloubkových a mnohostranných reportech a úsilím kluků z různých oddělení bylo před nějakým časem zorganizováno jednoduché a praktické řešení – spojení ClickHouse a PowerBI.
Poměrně dlouhou dobu toto flexibilní řešení výborně pomáhalo, ale postupně začalo docházet k chápání, že ClickHouse není guma a nemělo by se s ním takto zacházet.
Je důležité si dobře uvědomit, že ClickHouse, stejně jako Druid, Vertica a Amazon RedShift (který vychází z Postgresu), jsou analytické enginy optimalizované pro poměrně pohodlnou analytiku (sčítání, aggregace, minimum a maximum sloupce a občasné spojování), protože jsou navrženy pro efektivní ukládání sloupcových relačních tabulek, na rozdíl od známého MySQL a dalších (databází orientovaných na řádky).
V podstatě je ClickHouse jen prostornější "databáze", s trochu nepohodlným bodovým vkládáním (tak to bylo zamýšleno, v pořádku), ale příjemnou analytikou a sadou zajímavých silných funkcí pro práci s daty. Ano, můžete dokonce vytvořit klastr — ale chápete, že používat mikroskop na zatloukání hřebíků není úplně správné a začali jsme hledat jiná řešení.
Poptávka po Pythonu a analytikách
V naší společnosti je spousta vývojářů, kteří píší kód téměř každý den po dobu 10-20 let v PHP, JavaScriptu, C#, C/C++, Javě, Go, Rustu, Pythonu, Bash. Také je zde mnoho zkušených systémových administrátorů, kteří prošli nejednou zcela neuvěřitelnou katastrofou, která se nevleze do zákonů statistiky (například, když se při silném úderu blesku zničí většina disků v RAID-10). V takových podmínkách nebylo dlouho jasné, co je "analytik na Pythonu". Python je jako PHP, jen jméno je o něco delší a nežádoucí látky měnící vědomí jsou v původním kódu interpretru o něco méně. Nicméně, s vytvořením stále novějších a novějších analytických zpráv si zkušení vývojáři začali stále více uvědomovat důležitost úzké specializace v nástrojích typu numpy, pandas, matplotlib, seaborn.
Rozhodující roli, pravděpodobně, sehrály náhlé mdloby zaměstnanců při spojení slov "logistická regrese" a demonstrace efektivního vytváření zpráv na objemných datech pomocí ano, ano, pyspark.
Apache Spark, jeho funkční paradigma, na které se skvěle hodí relační algebra a možnosti, vyvolalo takový dojem na vývojáře zvyklé na MySQL, že potřeba posílení bojových řad zkušenými analytiky se stala jasnou jako den.
Další pokusy Apache Spark/Hadoop vzlétnout a co nešlo úplně podle scénáře
Brzy se však ukázalo, že se Sparkem, jak se zdá, něco systémově není v pořádku, nebo je třeba si prostě lépe umýt ruce. Pokud byl stack Hadoop/MapReduce/Lucene vytvořen dostatečně zkušenými programátory, což je zřejmé, pokud se důkladně podíváme na zdrojové kódy v Javě nebo na myšlenky Duga Cuttinga v Lucene, pak je Spark náhle napsán v velmi sporném z praktického hlediska a nyní již nerozvíjeném exotickém jazyce Scala. A pravidelný pokles výpočtů na clusteru Spark kvůli nelogické a málo přehledné práci s alokací paměti pro operace reduce (současně přijde mnoho klíčů) — vytvořil kolem něj aurou něčeho, co má prostor pro růst. Navíc situaci zhoršovalo velké množství podivných otevřených portů, dočasných souborů, rostoucích na naprosto nepochopitelných místech a závislostí na jar — což vyvolávalo u systémových administrátorů jedno a dobře známé od dětství pocity: zuřivou nenávist (možná bylo třeba si umýt ruce mýdlem).
Nakonec jsme "přežili" několik interních analytických projektů, které aktivně využívaly Apache Spark (včetně Spark Streaming, Spark SQL) a ekosystém Hadoop (a další a další). I když jsme se časem naučili "to" docela dobře připravovat a monitorovat a "to" téměř přestalo náhle padat kvůli změně povahy dat a nevyváženosti rovnoměrného hashování RDD, touha mít něco již připraveného, aktualizovaného a spravovaného někde v cloudu sílila čím dál více. V tuto dobu jsme se pokusili použít hotový cloudový balíček Amazon Web Services — a v důsledku toho jsme se snažili řešit úkoly již na něm. EMR je Amazonem připravený Apache Spark s dalšími programy z ekosystému, přibližně jako Cloudera/Hortonworks balíčky.
"Gumové" úložiště pro analýzu — naléhavá potřeba
Zkušenosti "přípravy" Hadoop/Spark s popáleninami různých částí těla nevyšly nadarmo. Stala se stále jasněji zřetelná potřeba vytvořit jednotné, cenově dostupné a spolehlivé úložiště, které by bylo odolné vůči hardwarovým haváriím a umožnilo ukládat soubory v různých formátech z různých systémů a efektivně vykonávat dotazy na tato data v rozumném čase pro zprávy.
Chtěli jsme, aby aktualizace softwaru této platformy nebyla noční můrou na Nový rok, s čtením 20stránkových Java stack trace a analýzou kilometrů podrobných logů provozu clustera pomocí Spark History Server a lupy s podsvícením. Potřebujeme jednoduchý a transparentní nástroj, který nevyžaduje pravidelnou diagnostiku pod kapotou, pokud přestane fungovat standardní MapReduce dotaz v důsledku selhání paměti pracovníka pro vyrovnávací data, kvůli nevhodně zvolenému algoritmu partitioningu vstupních dat.
Amazon S3 – kandidát na DataLake?
Zkušenosti s Hadoop/MapReduce mě naučily, že potřebuji škálovatelný a spolehlivý souborový systém a nad ním škálovatelné pracovníky, kteří se "přibližují" k datům, aby se nehnali data po síti. Pracovníci by měli umět číst data v různých formátech, ale ideálně by neměli číst zbytečné informace a data by měla být uložena v pro pracovníky vhodných formátech.
Ještě jednou – hlavní myšlenka. Nemám zájem "nahrávat" velká data do jediného clusterového analytického enginu, který se dříve nebo později stejně ucpou, a bude třeba jej nešikovně rozdělit. Chci ukládat soubory, prostě soubory, v srozumitelném formátu a efektivně provádět analytické dotazy různými, ale pochopitelnými nástroji. A souborů v různých formátech bude stále více a více. A je lepší rozdělit ne engine, ale vstupní data. Rozhodli jsme se, že potřebujeme rozšiřitelný a univerzální DataLake...
A co když uložíme soubory do známého a mnoha lidmi používaného škálovatelného cloudového úložiště Amazon S3, aniž bychom se starali o vlastní přípravu „kotlet“ z Hadoop?
Jasně, osobní údaje „ne”, ale co ostatní data, když je tam vyvedeme a „efektivně jimi manipulujeme“?
Klastr-velká data-analytická ekosystém Amazon Web Services – velmi jednoduchými slovy
Podle našich zkušeností s AWS se zde dlouho a aktivně používá různé varianty Apache Hadoop/MapReduce, například v službě DataPipeline (závidím kolegům, jak se naučili jej správně připravovat). Tady jsme nastavili zálohy z různých služeb z tabulek DynamoDB:
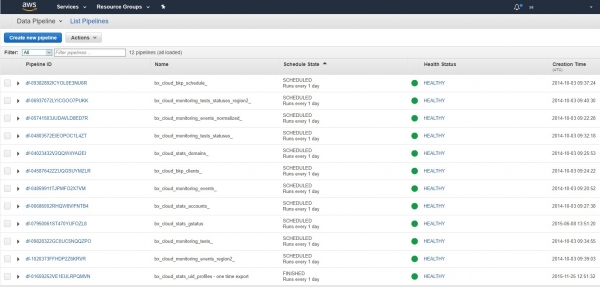
A ty se pravidelně provádějí na vestavěných clusterech Hadoop/MapReduce jako hodinky již několik let. "Nastavil a zapomněl":
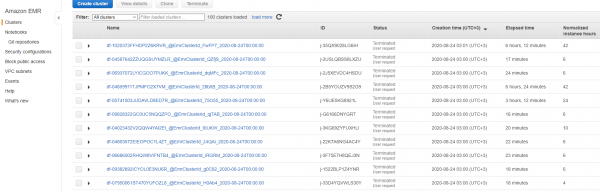
Také je možné efektivně provozovat datasantismus tím, že pro analytiky spustíme Jupiter notebooky v cloudu a použijeme je pro trénink a nasazení AI modelů v systému AWS SageMaker. Takhle to vypadá u nás:
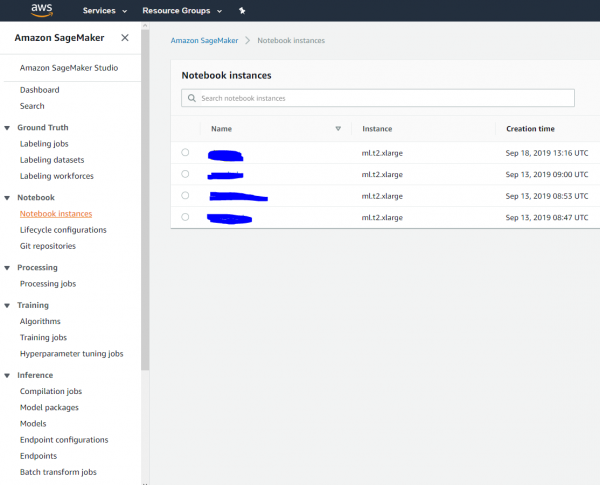
A ano, můžete si spustit notebook v cloudu nebo pro analytika napojit na Hadoop/Spark cluster, provést výpočty a pak to vše „přibít“:
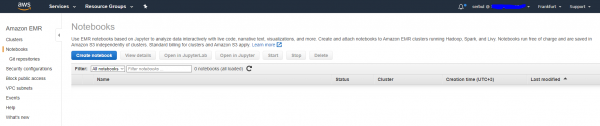
Opravdu pohodlné pro jednotlivé analytické projekty a pro některé jsme úspěšně používali službu EMR pro rozsáhlé výpočty a analýzu. A co systémové řešení pro DataLake, bude to možné? V tuto chvíli jsme byli na pokraji naděje a zoufalství a pokračovali v hledání.
AWS Glue — pečlivě zabalený Apache Spark „na steroidech“
Ukázalo se, že AWS má „svou“ verzi stacku „Hive/Pig/Spark“. Úlohu Hive, tedy katalogu souborů a jejich typů v DataLake, hraje služba „Data catalog“, která se ani netají svou kompatibilitou s formátem Apache Hive. Do této služby je třeba přidat informace o tom, kde se nacházejí vaše soubory a v jakém formátu jsou. Data mohou být nejen v S3, ale i v databázi, ale o tom v tomto příspěvku nepíšeme. Takhle je náš katalog dat DataLake uspořádán:
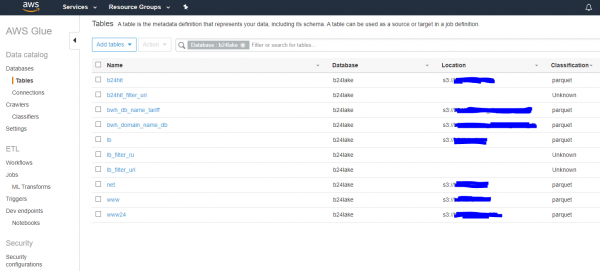
Soubory jsou registrovány, skvělé. Pokud se soubory aktualizovaly — spouštíme buď ručně, nebo podle plánu crawlers, které obnoví informace o nich z jezera a uloží je. Dále lze data z jezera zpracovávat a výsledky někam exportovat. V nejjednodušším případě — exportujeme také do S3. Zpracování dat lze provádět kdekoli, ale doporučuje se nastavit proces zpracování na Apache Spark clusterech s využitím rozšířených možností prostřednictvím API AWS Glue. V podstatě je možné vzít starý dobrý a známý kód v pythonu s použitím knihovny pyspark a nastavit jeho spuštění na N uzlech clustru s nějakým výkonem a monitoringem, aniž bychom se museli hrabat v podrobnostech Hadoopu a tahat dockerové kontejnery a řešit konflikty závislostí.
Ještě jednou — jednoduchá myšlenka. Není třeba nastavovat Apache Spark, stačí napsat kód v pythonu pro pyspark, otestovat ho lokálně na pracovním stole a poté ho spustit na velkém clusteru v cloudu, uvést, kde leží vstupní data a kam uložit výsledek. Někdy to je potřeba a užitečné, a takto je to u nás nastaveno:
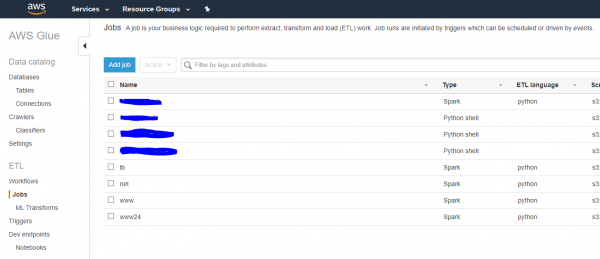
Takže, pokud je potřeba něco spočítat na Spark clusteru pomocí dat v S3 — napíšeme kód v pythonu/pyspark, otestujeme a hurá do cloudu.
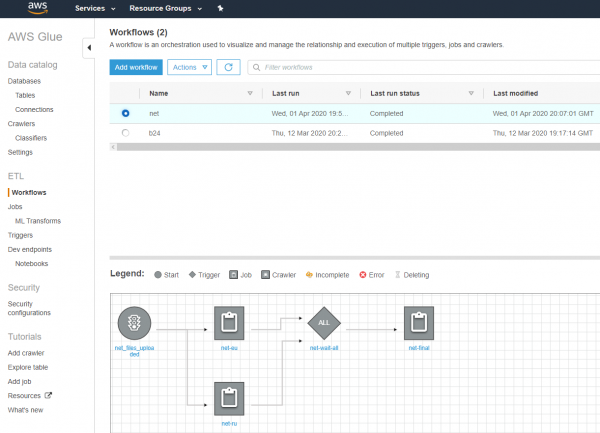
A co orchestrace? A pokud úkol spadne a zmizí? Ano, navrhuje se vytvořit hezkou pipeline ve stylu Apache Pig a my jsme je dokonce vyzkoušeli, ale rozhodli jsme se zatím použít naši hluboce přizpůsobenou orchestraci na PHP a JavaScriptu (chápu, vzniká kognitivní disonance, ale funguje to, roky a bez chyb).
Formát souborů uložených v jezeře – klíč k výkonnosti
Je velmi, velmi důležité pochopit ještě dva klíčové momenty. Aby byly dotazy na soubory v jezeře prováděny co nejrychleji a výkonnost se při přidávání nových informací nezhoršovala, je třeba:
- Sloupce souborů uchovávat odděleně (aby nebylo nutné číst všechny řádky pro zjištění, co je ve sloupcích). K tomu jsme zvolili formát parquet se zpracováním.
- Je velmi důležité shardovat soubory do složek ve smyslu: jazyk, rok, měsíc, den, týden. Enginy, které rozumí tomuto typu shardování, budou prohledávat pouze potřebné složky, aniž by musely procházet všechny data.
V podstatě tímto způsobem ukládáte vstupní data v nejefektivnějším formátu pro analytické enginy, které umí selektivně přistupovat do shardovaných složek a číst ze souborů pouze potřebné sloupce. Není třeba nikam "nahrávat" data (úložiště by se prostě roztrhlo) – jednoduše je rozumně uložte do souborového systému ve správném formátu. Samozřejmě, mělo by být jasné, že uchovávat v DataLake ohromný csv-soubor, který je třeba nejprve přečíst řádek po řádku, aby se extrahovaly sloupce – není příliš rozumné. Zvažte ještě jednou dvě výše uvedené body, pokud zatím není jasné, proč je to všechno důležité.
AWS Athena – "démon" z krabičky
A zde, při vytváření jezera, jsme jaksi mimochodem narazili na Amazon Athena. Najednou se ukázalo, že pokud pečlivě rozdělíme naše obrovské logové soubory do shardů-složek ve správném (parquet) sloupcovém formátu – můžeme na nich velmi rychle provádět mimořádně informativní dotazy a vytvářet zprávy BEZ Apache Spark/Glue clusteru.
Engin Athena, který pracuje s daty v s3, je založen na legendárním — zástupce rodiny MPP (masivně paralelní zpracování) přístupů k zpracování dat, který čerpá data tam, kde leží, od s3 a Hadoop až po Cassandru a běžné textové soubory. Stačí požádat Athenu, aby provedla SQL dotaz, a pak už „všechno funguje rychle a samo“. Je důležité poznamenat, že Athena je „inteligentní“, chodí jen do potřebných shardovaných složek a čte pouze potřebné sloupce v dotazu.
Taktéž tariface dotazů na Atheně je zajímavá. Platíme za . Tzn. ne za počet strojů v clusteru za minutu, ale… za skutečně prosklená na 100-500 strojích pouze nezbytná data pro vykonání dotazu.
A když požadujeme pouze potřebné sloupce z dobře shardovaných složek, ukázalo se, že služba Athena nás stojí desítky dolarů za měsíc. No, je to skvělé, téměř zdarma ve srovnání s analýzou na clusterech!
Tady je, jak shardujeme svá data v s3:
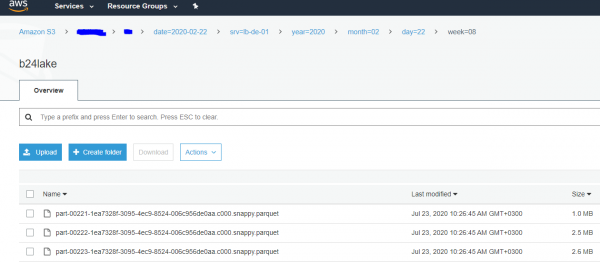
V důsledku toho začaly různé oddělení ve společnosti, od informační bezpečnosti po analytiku, aktivně vytvářet dotazy na Atheně a rychle, během sekund, dostávat užitečné odpovědi z „velkých“ dat za poměrně dlouhá období: měsíce, pololetí atd.
Ale šli jsme dál a začali hledat odpovědi v cloudu : analytik v obvyklé konzoli píše SQL dotaz, který na 100-500 strojích „za babku“ prohledává data v s3 a vrací odpověď obvykle za jednotky sekund. Pohodlné. A rychlé. Pořád tomu nemohu uvěřit.
Nakonec, když jsme se rozhodli ukládat data v s3, v efektivním sloupcovém formátu a s rozumným shardováním dat podle složek… získali jsme DataLake a rychlý a levný analytický engine — zdarma. A stal se velmi populární ve společnosti, protože rozumí SQL a pracuje mnohem rychleji než při spuštění/zastavení/nastavení clusterech. „A pokud je výsledek stejný, proč platit víc?“
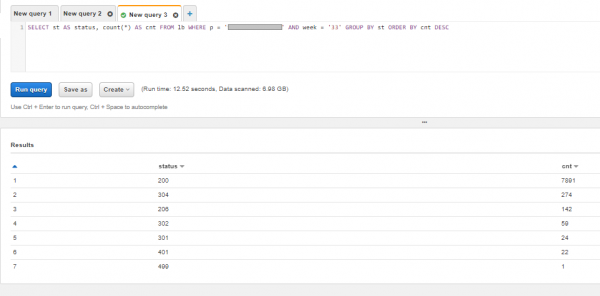
Dotaz na Atheně vypadá přibližně takto. Pokud si přejete, samozřejmě, můžete formulovat poměrně , ale omezíme se na jednoduché seskupení. Podíváme se, jaké kódy odpovědí měl klient před několika týdny v logech práce webového serveru a ujistíme se, že nebyly žádné chyby:
Závěry
Prošli jsme, neřekl bych, že dlouhou, ale bolestnou cestu, kdy jsme neustále adekvátně hodnotili rizika, úroveň složitosti a náklady na údržbu, a našli jsme řešení pro DataLake a analýzu, které nás nepřestává těšit jak rychlostí, tak náklady na vlastnictví.
Ukázalo se, že vybudovat efektivní, rychlé a levné DataLake pro potřeby zcela různých oddělení společnosti je úplně v silách i zkušených vývojářů, kteří nikdy nebyli architekty, neumí kreslit čtverce na čtvercích se šipkami a znají 50 termínů z ekosystému Hadoop.
Na začátku cesty mě bolela hlava z množství divokých zoologických zahrad otevřeného a uzavřeného softwaru a chápání zátěže odpovědnosti před potomky. Jen začněte budovat svůj DataLake od jednoduchých nástrojů: nagios\/munin -> elastic\/kibana -> Hadoop\/Spark\/s3…, shromážděním zpětné vazby a hlubokým pochopením fyziky probíhajících procesů. Vše složité a nejasné dejte nepřátelům a konkurentům.
Pokud nechcete do cloudu a rádi udržujete, aktualizujete a patchujete otevřené projekty, lze vybudovat podobnou naši schéma lokálně, na kancelářských levných strojích s Hadoop a Presto navrch. Hlavní je nezastavovat se, jít dál, počítat, hledat jednoduchá a jasná řešení a určitě to vyjde! Hodně štěstí všem a na shledanou!
Zdroj: habr.com
