

V posledních několika letech se databáze časových řad (Time-series databases) proměnily z kuriozity (užívané buď v otevřených monitorovacích systémech (a vázané na konkrétní řešení), nebo v projektech Big Data) na "spotřební zboží". Na území Ruské federace za to zasloužíme poděkování Yandxu a ClickHouse. Do té doby, pokud jste potřebovali uchovat velké množství časových dat, museli jste se smířit s nutností nasadit monumentální Hadoop stack a jeho udržování, nebo komunikovat s protokoly individuálními pro každý systém.
Může se zdát, že v roce 2019 bude článek o tom, jakou TSDB použít, sestávat z jedné věty: "jednoduše použijte ClickHouse". Ale… jsou tu nuanse.
Opravdu, ClickHouse aktivně roste, uživatelská základna se zvětšuje a podpora je velmi aktivní, ale nestali jsme se vězni jeho veřejného úspěchu, který zastínil možná efektivnější/rozumnější řešení?
Na začátku loňského roku jsme se pustili do přepracování našeho vlastního monitorovacího systému, během kterého jsme se dostali k otázce výběru vhodné databáze pro ukládání dat. O historii této volby bych zde chtěl vyprávět.
Formulace úkolu
Nejprve — nezbytné úvodní slovo. Proč potřebujeme vlastní monitorovací systém a jak byl uspořádán?
Služby podpory jsme začali poskytovat v roce 2008 a do roku 2010 bylo jasné, že agregovat data o procesech probíhajících v klientské infrastruktuře s řešeními, která existovala v té době, se stalo složitým (mluvíme o, promiňte, Cacti, Zabbixu a vznikajícím Graphite).
Našimi hlavními požadavky byly:
- zajištění podpory (v té době — desítek, a do budoucna — stovek) klientů v rámci jednoho systému a přitom mít centralizovaný systém správy upozornění;
- flexibilita v řízení systému upozornění (eskalace upozornění mezi službami, zohlednění harmonogramů, znalostní báze);
- možnost hluboké detailizace grafů (Zabbix tehdy kreslil grafy jako obrázky);
- dlouhodobé uchování velkého množství dat (rok a více) a možnost jejich rychlé výběru.
V tomto článku nás zajímá poslední bod.
Pokud jde o úložiště, požadavky byly následující:
- systém by měl fungovat rychle;
- bylo by žádoucí, aby systém měl SQL rozhraní;
- systém by měl být stabilní a mít aktivní uživatelskou základnu a podporu (někdy jsme se potýkali s potřebou podporovat takové systémy, jako je MemcacheDB, kterou přestali vyvíjet, nebo distribuované úložiště MooseFS, jehož bug tracker byl veden v čínštině; nechtěli jsme opakovat tento příběh pro náš projekt);
- shoda s CAP teorií: Consitency (nutné) — data musí být aktuální, nechceme, aby systém správy upozornění nedostal nová data a vyhazoval alerty o nepříchodu dat pro všechny projekty; Partition Tolerance (nutné) — nechceme mít Split Brain systém; Availability (není kritické, pokud existuje aktivní replikace) — můžeme přepnout na záložní systém v případě havárie, kódem.
Jak se ukázalo, ideálním řešením pro nás byla MySQL. Naše struktura dat byla maximálně jednoduchá: id serveru, id měřiče, timestamp a hodnota; rychlé vyhledávání aktuálních dat bylo zajištěno velkou velikostí buffer poolu, a vyhledávání historických dat — SSD.
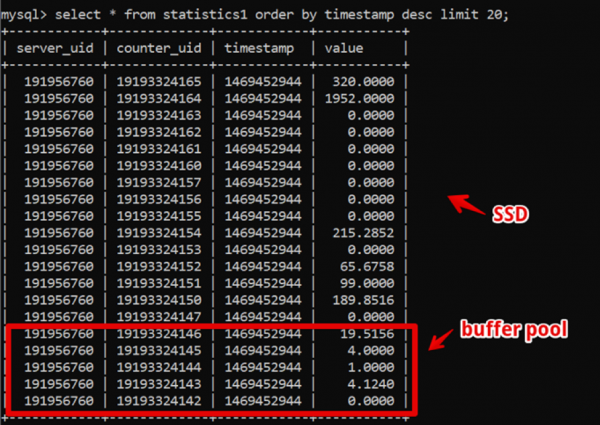
Tak jsme dosáhli vyhledávání čerstvých dvoutýdenních dat s detailností na sekundu za 200 ms do okamžiku úplného vykreslení dat, a v tomto systému jsme žili docela dlouho.
Mezitím ubíhal čas a množství dat rostlo. K roku 2016 objemy dat dosáhly desítek terabajtů, což v podmínkách pronajímaných SSD úložišť bylo významným nákladem.
V tuto chvíli se vyvíjela popularita sloupcových databází, o kterých jsme začali aktivně přemýšlet: ve sloupcových DB jsou data uchovávána, jak je zřejmé, ve sloupcích, a pokud se podíváme na naše data, je snadné vidět velké množství duplikátů, které by se daly v případě použití sloupcové DB stlačit kompresí.
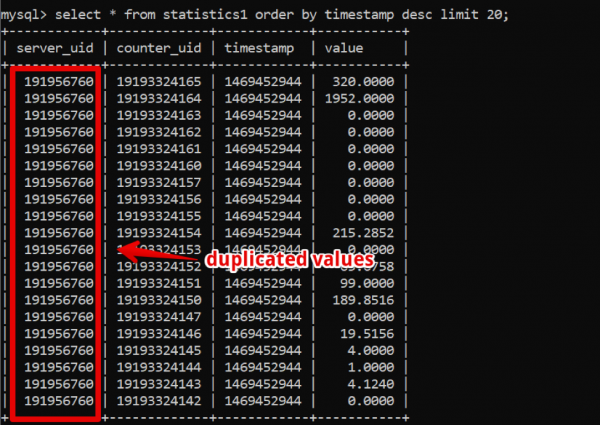
Nicméně klíčový systém pro fungování společnosti nadále fungoval stabilně, a experimentovat s přechodem na něco jiného jsme nechtěli.
V roce 2017 na konferenci Percona Live v San Jose se poprvé představili vývojáři Clickhouse. Na první pohled byla tato systém připravena na produkci (Yandex.Metrika je skutečná produkce), podpora byla rychlá a jednoduchá, a co je nejdůležitější, provoz byl snadný. Od roku 2018 jsme zahájili proces přechodu. Ale do té doby už existovalo mnoho "dospělých" a osvědčených systémů TSDB, a rozhodli jsme se věnovat významný čas srovnání alternativ, abychom se ujistili, že alternativy k Clickhouse podle našich požadavků neexistují.
Kromě již uvedených požadavků na úložiště se objevily nové:
- nový systém by měl zajišťovat alespoň stejný výkon jako MySQL na stejném množství hardwaru;
- úložiště nového systému by mělo zabírat výrazně méně místa;
- DBMS by stále měla být snadno spravovatelná;
- chtěli jsme minimálně měnit aplikaci při změně DBMS.
Jaké systémy jsme začali zvažovat
Apache Hive/Apache Impala
Starý osvědčený Hadoop stack. V podstatě je to SQL rozhraní postavené na vlastních formátech ukládání dat v HDFS.
Výhody.
- Při stabilním provozu je velmi snadné škálovat data.
- Existují sloupcová řešení pro ukládání dat (méně místa).
- Velmi rychlé vykonávání paralelizovaných úloh při dostatku zdrojů.
Nevýhody.
- To je Hadoop, a je složitý na provoz. Pokud nejsme připraveni vzít hotové řešení v cloudu (a to nejsme kvůli ceně), bude nutné celý stack sestavit a udržovat rukama administrátorů, a to se nám opravdu nechce.
- Data jsou agregována .
Nicméně:
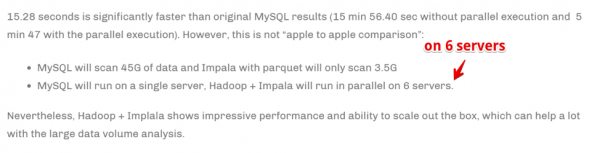
Rychlost se dosahuje škálováním počtu výpočetních serverů. Jinými slovy, pokud jsme velká firma, zabýváme se analytikou a je pro podnik kriticky důležité co nejrychleji agregovat informace (i za cenu využití velkého množství výpočetních zdrojů), může to být naše volba. Ale nebyli jsme připraveni mnohonásobně zvyšovat počet hardwaru pro rychlost vykonávání úloh.
Druid/Pinot
Již mnohem více o konkrétně TSDB, ale opět – Hadoop stack.
Existuje .
Pokud stručně: Druid/Pinot vypadají lépe než Clickhouse v případech, kdy:
- Máte heterogenní charakter dat (v našem případě zaznamenáváme pouze časové řady serverových metrik, a v podstatě to je jedna tabulka. Mohou však existovat i jiné případy: časové řady zařízení, ekonomické časové řady atd. — každý s vlastní strukturou, které je třeba agregovat a zpracovávat).
- Přitom těchto dat je skutečně hodně.
- Tabulky a data s časovými řadami se objevují a mizí (to znamená, že nějaká sada dat přišla, byla analyzována a odstraněna).
- Neexistuje jasné kritérium, podle kterého by mohla být data partitionována.
V opačných případech se lépe ukazuje ClickHouse, a to je náš případ.
ClickHouse
- Podobné SQL.
- Snadné na správu.
- Lidé říkají, že funguje.
Dostává se do užšího výběru pro testování.
InfluxDB
Zahraniční alternativa k ClickHouse. Mezi nevýhody patří: vysoká dostupnost je jen v komerční verzi, ale je třeba porovnat.
Dostává se do užšího výběru pro testování.
Cassandra
Na jedné straně víme, že se používá pro ukládání metrických časových řad v systémech monitorování, jako například nebo OkMeter. Nicméně je zde určitá specifičnost.
Cassandra není sloupcová databáze v obvyklém smyslu. Vypadá více jako řádková, ale v každém řádku může být různý počet sloupců, což usnadňuje organizaci sloupcového zobrazení. V tomto smyslu je jasné, že při omezení na 2 miliardy sloupců lze uložit nějaká data právě ve sloupcích (například časové řady). Například v MySQL je omezení na 4096 sloupců a je snadné narazit na chybu s kódem 1117, pokud se pokusíte udělat to samé.
Databázový systém Cassandra je navržen pro ukládání velkého objemu dat v distribuovaném systému bez centrálního uzlu a v výše zmíněné CAP teorii se více zaměřuje na AP, což znamená dostupnost dat a odolnost vůči rozdělení partition. Tím pádem je tento nástroj výbornou volbou, pokud potřebujete pouze zapisovat do této databáze a dostatečně zřídka z ní číst. V tomto případě je logické použít Cassandru jako "studena" úložiště. Tedy jako dlouhodobé spolehlivé místo pro ukládání velkých objemů historických dat, která jsou zřídka potřebná, ale pokud je třeba, mohou být snadno vytažena. Nicméně, abychom měli celkový obraz, otestujeme ji také. Jak jsem již zmínil, nemám v úmyslu aktivně přepisovat kod pro zvolené řešení databáze, takže jej budeme testovat v omezeném rozsahu — bez úpravy struktury databáze podle specifikace Cassandry.
Prometheus
A z čisté zvědavosti jsme se rozhodli otestovat výkon úložiště Prometheus — jen abychom zjistili, jestli jsme rychlejší než současná řešení nebo pomalejší a jak moc.
Metodika a výsledky testování
Takže jsme otestovali 5 databází v následujících 6 konfiguracích: ClickHouse (1 uzel), ClickHouse (distribuovaná tabulka na 3 uzly), InfluxDB, Mysql 8, Cassandra (3 uzly) a Prometheus. Plán testování je následující:
- nahráváme historická data za týden (840 milionů hodnot denně; 208 tisíc metrik);
- generujeme zátěž na zápis (zkoumali jsme 6 režimů zátěže, viz níže);
- paralelně se zápisem periodicky provádíme dotazy, simulující uživatele pracujícího s grafy. Abychom to příliš nezatěžovali, vybírali jsme data pro 10 metrických hodnot (přesně tolik je na grafu CPU) za týden.
Zatěžujeme, simulující chování našeho monitorovacího agenta, který zasílá do každé metriky hodnoty každých 15 sekund. Zajímá nás variabilita:
- celkový počet metrik, do kterých se zapisují data;
- interval zasílání hodnot do jedné metriky;
- velikost dávky.
O velikosti dávky. Vzhledem k tomu, že téměř všechny naše zkoumané databáze nedoporučují zatěžovat jednotlivými inserty, budeme potřebovat relé, které sbírá přicházející metriky, skupinuje je a zapisuje do databáze hromadným insertem.
Abychom lépe pochopili, jak následně interpretovat získaná data, představme si, že neposíláme pouze hromadu metrik, ale že jsou metriky uspořádány na servery – po 125 metrikách na server. Zde je server pouze virtuální entita – abychom pochopili, že například 10 000 metrik odpovídá přibližně 80 serverům.
A tedy, s ohledem na to všechno, našich 6 režimů zátěže databáze při zápisu:
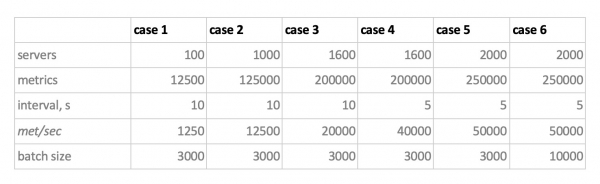
Zde jsou dva aspekty. Za prvé, pro Cassandru se tyto velikosti batchů ukázaly jako příliš velké, tam jsme používali hodnoty 50 nebo 100. A za druhé, jelikož Prometheus pracuje striktně v režimu pull, t.j. sám chodí a vybírá data ze zdrojů metrik (a dokonce pushgateway, navzdory názvu, situaci v základu nezmění), odpovídající zátěže byly realizovány pomocí kombinace statických konfigurací.
Výsledky testování jsou následující:
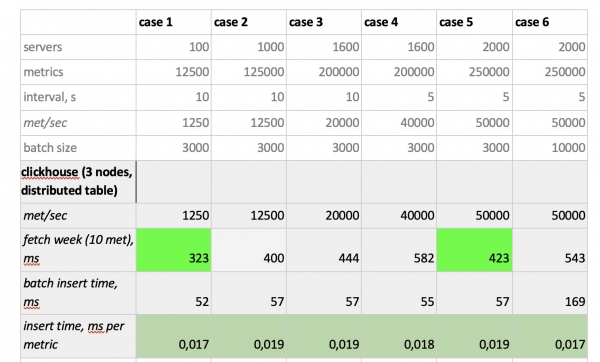
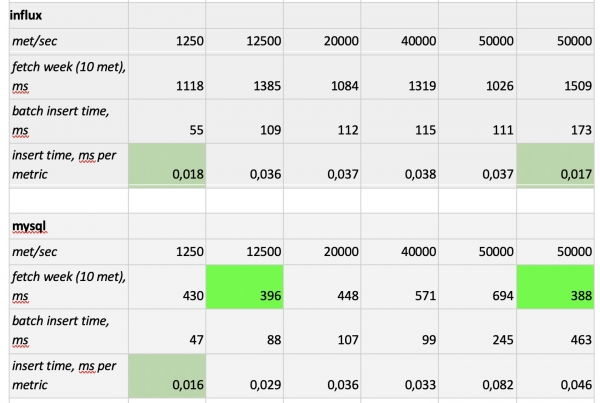
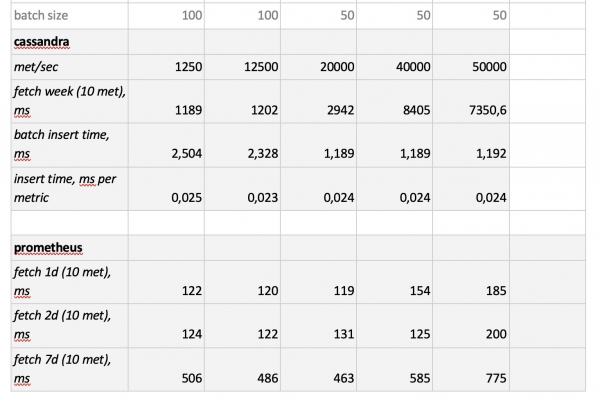
Co je dobré zdůraznit: fantasticky rychlé výběry z Prometheuse, hrůzostrašně pomalé výběry z Cassandry, nepřijatelně pomalé výběry z InfluxDB; co se rychlosti zápisu týče, všechno vyhrál ClickHouse, a Prometheus se soutěže nezúčastnil, protože provádí vklady uvnitř sebe a nic neměříme.
Nakonec: nejlépe se ukázaly ClickHouse a InfluxDB, ale cluster z Influxu lze postavit pouze na základě Enterprise verze, která stojí peníze, zatímco ClickHouse nic nestojí a byl vyvinut v Rusku. Je logické, že v USA by byl výběr pravděpodobně ve prospěch InfluxDB, zatímco u nás ve prospěch ClickHouse.
Zdroj: habr.com
