

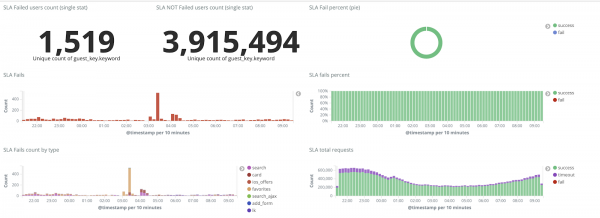
Ahoj všichni, jmenuji se Alexander, pracuji v CIAN jako inženýr a zabývám se systémovým administrativou a automatizací infrastrukturních procesů. V komentářích k jednomu z předchozích článků nás požádali, abychom se podělili o to, odkud bereme 4 TB logů denně a co s nimi děláme. Ano, logů máme hodně, a pro jejich zpracování byl vytvořen samostatný infrastrukturní klastr, který nám umožňuje rychle řešit problémy. V tomto článku se podělím o to, jak jsme za rok přizpůsobili jeho provoz pro stálé rostoucí množství dat.
Jak jsme začínali
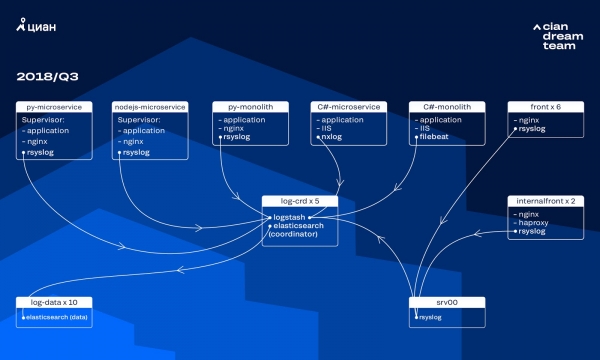
V posledních několika letech rostla zátěž na cian.ru velmi rychle, a ke třetímu čtvrtletí 2018 dosáhla návštěvnost webu 11,2 milionu unikátních uživatelů měsíčně. V té době jsme v kritických okamžicích ztráceli až 40% logů, což nám bránilo rychle řešit incidenty a strávili jsme tak hodně času a sil jejich řešením. Také jsme často nemohli najít příčinu problému a ta se opakovala po nějakém čase. To byl chaos, se kterým bylo třeba něco udělat.
V té době jsme pro ukládání logů používali klastr deseti datových uzlů s ElasticSearch verzí 5.5.2 s typickými nastaveními indexů. Bylo to nasazeno před více než rokem jako populární a dostupné řešení: tehdy byl tok logů ještě relativně malý, nemělo smysl vymýšlet nestandardní konfigurace.
Zpracování přicházejících logů zajišťoval Logstash na různých portech na pěti koordinátorech ElasticSearch. Jeden index, bez ohledu na velikost, se skládal z pěti shardů. Byla zavedena hodinová a denní rotace, takže každý hodinu se v klastru objevovalo přibližně 100 nových shardů. Dokud logů nebylo příliš mnoho, klastr to zvládal a nikdo se na jeho nastavení více nezaměřoval.
Problémy rychlého růstu
Objem generovaných logů rostl velmi rychle, protože se na sebe překrývaly dva procesy. Na jedné straně přibývalo uživatelů služby. Na druhé straně jsme začali aktivně přecházet na mikroslužbovou architekturu, rozdělující naše staré monolity na C# a Python. Několik desítek nových mikroslužeb, nahrazujících části monolitu, generovalo výrazně více logů pro infrastrukturní klastr.
Právě škálování nás dovedlo k tomu, že se cluster stal prakticky neříditelným. Když začaly logy přicházet rychlostí 20 tisíc zpráv za sekundu, častá zbytečná rotace zvýšila počet shardů na 6 tisíc, a na jeden uzel připadalo více než 600 shardů.
To vedlo k problémům s alokací operační paměti, a při pádu uzlu začal současný přesun všech shardů, což znásobilo provoz a zatěžovalo ostatní uzly, což prakticky znemožnilo zapisování dat do clusteru. A v této době jsme zůstali bez logů. A při problému s serverem jsme v podstatě ztráceli 1/10 clusteru. Velké množství malých indexů situaci dále komplikovalo.
Bez logů jsme nerozuměli důvodům incidentu a mohli jsme se dříve či později dostat do stejných problémů znovu, což bylo pro naši týmovou filozofii nepřijatelné, protože všechny mechanismy naší práce jsou zaměřené přesně na opak – nikdy neopakovat stejné problémy. K tomu jsme potřebovali plný objem logů a jejich praktickou dodávku v reálném čase, protože tým dozorujících inženýrů sledoval upozornění nejen z metrik, ale i z logů. Pro pochopení rozsahu problému – v té době byl celkový objem logů přibližně 2 TB za den.
Stanovili jsme si úkol – zcela vyloučit ztrátu logů a zkrátit dobu jejich dodávky do clusteru ELK na maximálně 15 minut během nouzových situací (na tento údaj jsme později spoléhali jako na interní KPI).
Nový mechanismus rotace a hot-warm uzly
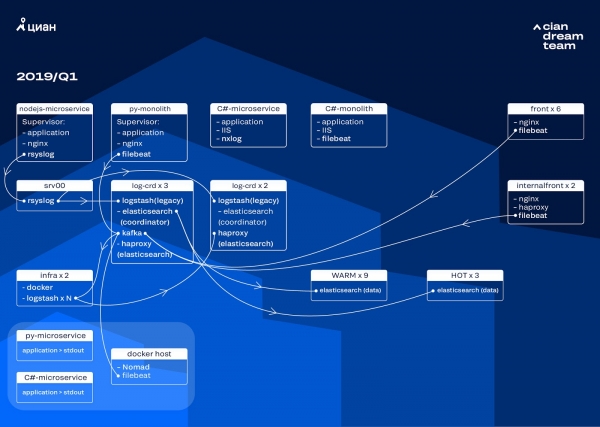
Transformaci clusteru jsme začali aktualizací verze ElasticSearch z 5.5.2 na 6.4.3. Opět nám selhal cluster 5. verze, a rozhodli jsme se ho vypnout a zcela aktualizovat – logy stejně nejsou. Takže tento přechod jsme uskutečnili za pouhé pár hodin.
Největší změnou v této fázi bylo zavedení Apache Kafka na třech nodech s koordinátorem jako mezistupněm. Zprávový broker nás zbavil ztráty logů během problémů s ElasticSearch. Zároveň jsme přidali 2 nody do klastru a přešli na hot-warm architekturu se třemi „horkými“ nody, které byly umístěny v různých skříních v datovém centru. Na ně jsme podle masky přesměrovali logy, které nelze za žádných okolností ztratit — nginx a také logy chyb aplikací. Na ostatní nody odcházely minoritní logy — debug, warning atd., a také po 24 hodinách byly přesouvány „důležité“ logy z „horkých“ nodů.
Abychom nezvyšovali počet malých indexů, přešli jsme z rotace podle času na mechanismus rollover. Na fórech bylo mnoho informací o tom, že rotace podle velikosti indexu je velmi nespolehlivá, proto jsme se rozhodli použít rotaci podle počtu dokumentů v indexu. Analyzovali jsme každý index a zaznamenali jsme počet dokumentů, po jehož dosažení by měla rotace nastat. Tímto způsobem jsme dosáhli optimální velikosti shardu — maximálně 50 GB.
Optimalizace klastru
Nicméně jsme se zcela nezbavili problémů. Bohužel se pořád objevovaly malé indexy: nedosahovaly stanoveného objemu, nebyly rotovány a byly odstraňovány globálním vyčištěním indexů starších tří dnů, protože jsme odstranili rotaci podle data. To vedlo ke ztrátě dat, protože index z klastru zcela zmizel, a pokus o zápis do neexistujícího indexu narušoval logiku curator, kterou jsme používali pro správu. Alias pro zápis se transformoval na index a narušoval logiku rollover, což vedlo k nekontrolovanému růstu některých indexů až na 600 GB.
Například pro konfigurační soubor rotace:
curator-elk-rollover.yaml

---
actions:
  1:
    action: rollover
    options:
      name: "nginx_write"
      conditions:
        max_docs: 100000000
  2:
    action: rollover
    options:
      name: "python_error_write"
      conditions:
        max_docs: 10000000
Při absenci rollover alias se objevila chyba:
ERROR     alias "nginx_write" not found.
ERROR     Failed to complete action: rollover.  : Unable to perform index rollover with alias "nginx_write".
Řešení tohoto problému jsme ponechali na další iteraci a zabývali se jinou otázkou: přešli jsme na pull logiku práce Logstash, který se zabývá zpracováním příchozích logů (odstraňováním nadbytečných informací a obohacováním). Umístili jsme jej do dockera, který spouštíme přes docker-compose, a tam také umístili logstash-exporter, který poskytuje metriky do Prometheusu pro aktuální monitoring toku logů. Tím jsme si umožnili plynule měnit počet instancí logstash, které zpracovávaly jednotlivé typy logů.
Zatímco jsme zdokonalovali cluster, návštěvnost cian.ru vzrostla na 12,8 milionu unikátních uživatelů za měsíc. V důsledku toho se ukázalo, že naše transformace mírně nezaostávaly za změnami na produkci, a my jsme se setkali s tím, že 'teplé' uzly nezvládaly zátěž a zpomalovaly celou dodávku logů. 'Horká' data jsme získávali bez problémů, ale do dodávky ostatních bylo nutné zasahovat a provádět ruční rollover, aby se rovnoměrně rozdělily indexy.
Přitom škálování a změna nastavení instancí logstash v clusteru byla komplikována tím, že to byl lokální docker-compose, a všechny akce se prováděly ručně (pro přidání nových konců bylo nutné ručně projít všechny servery a všude provést docker-compose up -d).
Přeorganizování logů
V září tohoto roku jsme stále pokračovali v dělení monolitu, zátěž na cluster rostla a tok logů se blížil k 30 tisícům zpráv za sekundu.
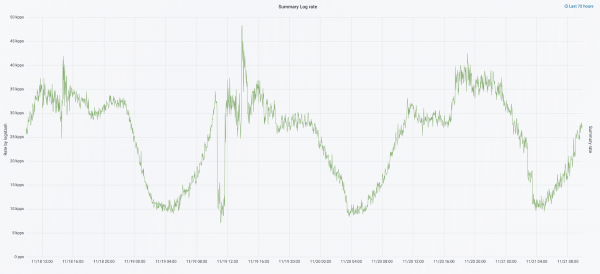
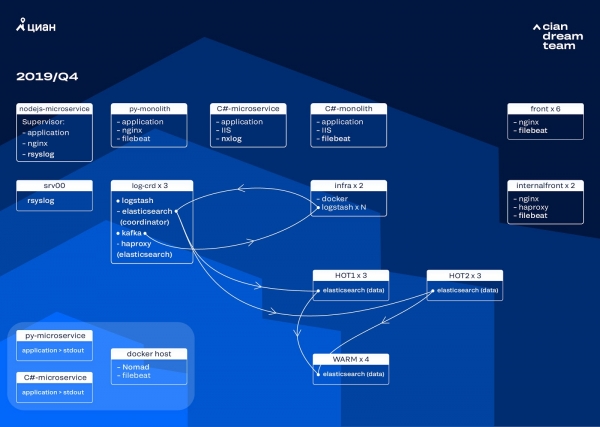
Další iteraci jsme začali aktualizací hardwaru. Z pěti koordinátorů jsme přešli na tři, vyměnili jsme datové uzly a získali jsme výhodu jak finančně, tak co do objemu úložiště. Pro uzly používáme dvě konfigurace:
- Pro 'horké' uzly: E3-1270 v6 / 960Gb SSD / 32 Gb x 3 x 2 (3 pro Hot1 a 3 pro Hot2).
- Pro 'teplé' uzly: E3-1230 v6 / 4Tb SSD / 32 Gb x 4.
Na této iteraci jsme převedli index s přístupovými logy mikroservisů, který zabírá stejné místo jako logy frontových nginx, do druhé skupiny ze tří 'horkých' uzlů. Data na 'horkých' uzlech nyní uchováváme 20 hodin a poté je převádíme na 'teplé' k ostatním logům.
Problém s mizícími malými indexy jsme vyřešili přenastavením jejich rotace. Nyní jsou indexy rotovány každých 23 hodin, i když obsahují málo dat. To mírně zvýšilo počet shardů (je jich asi 800), ale z pohledu výkonu clusteru je to přijatelné.
V důsledku toho má cluster šest "žhavých" a pouze čtyři "teplé" uzly. To způsobuje mírné zpoždění při dotazech na dlouhé časové intervaly, ale zvýšení počtu uzlů v budoucnu tento problém vyřeší.
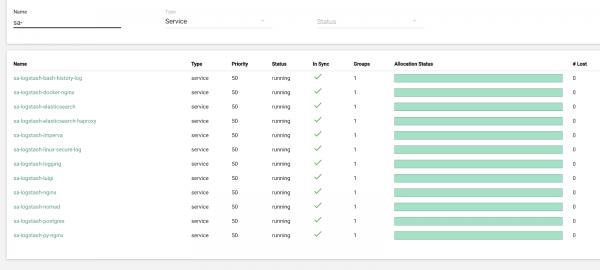
V této iteraci jsme také opravili problém s absencí polovičně automatického škálování. K tomu jsme nasadili infrastrukturní cluster Nomad – obdobný tomu, který již máme na produkci. Zatím se počet Logstash automaticky nemění podle zátěže, ale k tomu se také dostaneme.
Plány do budoucna
Realizovaná konfigurace se skvěle škáluje a nyní uchováváme 13,3 TB dat – všechny logy za 4 dny, což je nezbytné pro okamžité analýzy alertů. Část logů transformujeme na metriky, které ukládáme do Graphite. Abychom usnadnili práci inženýrům, máme metriky pro infrastrukturní cluster a skripty pro poloviční automatické opravy typických problémů. Po plánovaném zvýšení počtu datových uzlů v příštím roce přejdeme na ukládání dat z 4 na 7 dní. To bude dostatečné pro operativní práci, protože se vždy snažíme vyšetřovat incidenty co nejdříve, a pro dlouhodobá vyšetřování jsou k dispozici telemetry.
V říjnu 2019 vzrostla návštěvnost cian.ru již na 15,3 milionu unikátních uživatelů za měsíc. To byla vážná zkouška architektonického řešení dodávky logů.
Nyní se připravujeme na aktualizaci ElasticSearch na verzi 7. Pravda, pro to budeme muset aktualizovat mapping mnoha indexů v ElasticSearch, protože přešli z verze 5.5 a byly vyhlášeny jako zastaralé ve verzi 6 (ve verzi 7 již neexistují). A to znamená, že během aktualizace bude jistě nějaký mimořádný případ, který nás na čas ponechá bez logů. Z verze 7 nejvíce očekáváme Kibanu s vylepšeným rozhraním a novými filtry.
Hlavního cíle jsme dosáhli: přestali jsme ztrácet logy a zkrátili jsme dobu výpadku infrastruktury z 2-3 pádů týdně na pár hodin servisních prací měsíčně. Celá tato práce na produkci je téměř neviditelná. Nyní však můžeme přesně určit, co se děje s naším servisem, můžeme to rychle provádět v klidovém režimu a nemusíme se obávat, že logy zmizí. Obecně jsme spokojeni, šťastní a připravujeme se na nové úspěchy, o kterých se brzy podělíme.
Zdroj: habr.com
