

Znám mnoho Data Scientistů — a patrně se k nim také řadím — kteří pracují na strojích s GPU, ať už místních nebo virtuálních umístěných v cloudu, buď prostřednictvím Jupyter Notebooku, nebo v nějakém prostředí pro vývoj v Pythonu. Pracoval jsem jako expert na AI/ML po dobu dvou let a přesně takto jsem to dělal, přičemž jsem připravoval data na klasickém serveru nebo pracovní stanici, a trénink jsem spouštěl na virtuálním stroji s GPU v Azure.
Samozřejmě, všichni jsme slyšeli o — speciální cloudové platformě pro strojové učení. Nicméně po prvním pohledu na , vzniká dojem, že Azure ML vám způsobí více problémů, než vyřeší. Například v uvedeném tréninkovém příkladu se trénink na Azure ML spouští z Jupyter Notebooku, přičemž samotný tréninkový skript je navrhován na vytvoření a úpravu jako textový soubor v jedné z buněk — přičemž se nevyužívá automatické dokončování, zvýraznění syntaxe a další výhody normálního vývojového prostředí. Z tohoto důvodu jsme dlouhou dobu vážně nepoužívali Azure ML ve své práci.
Avšak nedávno jsem objevil způsob, jak efektivně začít používat Azure ML ve své práci! Zajímá vás, jaké detaily?
Hlavním tajemstvím je . Umožňuje vám vyvíjet tréninkové skripty přímo ve VS Code, přičemž využíváte všech výhod prostředí — a dokonce můžete spouštět skripty lokálně a poté je jednoduše odeslat na učení v klastru Azure ML několika kliknutími myši. Pohodlné, že?
Při tom získáváte následující výhody používání Azure ML:
- Můžete většinu času pracovat lokálně na svém stroji v pohodlném IDE a používat GPU pouze pro trénink modelu. Přitom se soubor tréninkových zdrojů může automaticky přizpůsobovat požadované zátěži, a pokud nastavíte minimální počet uzlů na 0, můžete automaticky spouštět virtuální stroj "na požádání", když máte úkoly k trénování.
- můžete uchovávat všechny výsledky učení na jednom místě, včetně dosažených metrik a získaných modelů — není třeba vymýšlet nějaký systém nebo pořádek pro uchovávání všech výsledků.
- Přitom na jednom projektu může pracovat několik osob — mohou používat stejný výpočetní klastr, všechny experimenty budou seřazeny do fronty a mohou vidět výsledky experimentů ostatních. Jedním z těchto scénářů je použití Azure ML při výuce Deep Learning, kdy místo toho, abyste každému studentovi poskytli virtuální stroj s GPU, můžete vytvořit jeden klastr, který bude centrálně využíván všemi. Kromě toho může být společná tabulka výsledků s přesností modelu dobrým soutěžním prvkem.
- S Azure ML můžete snadno provádět série experimentů, například pro optimalizaci hyperparametrů — to lze provést pomocí několika řádků kódu, není nutné provádět série experimentů ručně.
Doufám, že jsem vás přesvědčil vyzkoušet Azure ML! Zde je návod, jak začít:
- Ujistěte se, že máte nainstalované , stejně jako rozšíření a
- Naklonujte repozitář — obsahuje nějaký ukázkový kód pro trénink modelu rozpoznávání rukopisných číslic na datasetu MNIST.
- Otevřete naklonovaný repozitář ve Visual Studio Code.
- Pokračujte dále!
Azure ML Workspace a Azure ML Portal
Azure ML je organizováno kolem konceptu práce — Workspace. V pracovním prostoru mohou být uchovány údaje, experimenty pro trénink se do něj odesílají, tam se také uchovávají výsledky tréninku — získané metriky a modely. Co se nachází uvnitř pracovního prostoru lze zobrazit prostřednictvím — a odsud lze provádět řadu operací, od nahrávání dat po sledování experimentů a nasazování modelů.
Vytvoření pracovního prostoru je možné prostřednictvím webového rozhraní (viz ), nebo pomocí příkazového řádku Azure CLI ():
az extension add -n azure-cli-ml
az group create -n myazml -l northeurope
az ml workspace create -w myworkspace -g myazml
S pracovním prostorem jsou také spojeny některé výpočetní zdroje (Výpočetní). Poté, co vytvoříte skript pro trénink modelu, můžete odeslat experiment k provedení do pracovního prostoru a specifikovat výpočetní cíl — skript bude zabalen, spuštěn v požadovaném výpočetním prostředí, a všechny výsledky experimentu budou uloženy v pracovním prostoru pro další analýzu a použití.
Tréninkový skript pro MNIST
Zvažme klasický úkol s použitím datasetu MNIST. Podobně pak budete moci spouštět jakékoli své tréninkové skripty.
V našem repozitáři je skript train_local.py, který trénuje nejjednodušší model lineární regrese s použitím knihovny SkLearn. Samozřejmě chápu, že to není nejlepší způsob, jak vyřešit úkol — používáme ho jako příklad, jak nejjednodušší.
Skript nejprve stáhne data MNIST z OpenML a následně použije třídu LogisticRegression k trénování modelu a poté vytiskne získanou přesnost:
mnist = fetch_openml('mnist_784')
mnist['target'] = np.array([int(x) for x in mnist['target']])

shuffle_index = np.random.permutation(len(mnist['data']))
X, y = mnist['data'][shuffle_index], mnist['target'][shuffle_index]

X_train, X_test, y_train, y_test =
  train_test_split(X, y, test_size = 0.3, random_state = 42)

lr = LogisticRegression()
lr.fit(X_train, y_train)
y_hat = lr.predict(X_test)
acc = np.average(np.int32(y_hat == y_test))

print('Celková přesnost:', acc)
Skript můžete spustit na svém počítači a za pár sekund dostanete výsledek.
Spouštíme skript v Azure ML
Pokud spustíme skript na trénink přes Azure ML, budeme mít dvě hlavní výhody:
- Spuštění trénování na libovolném výpočetním zdroji, který je obvykle výkonnější než místní počítač. Azure ML se přitom postará o to, aby zabalil náš skript se všemi soubory z aktuálního adresáře do docker-kontejneru, nainstaloval požadované závislosti a odeslal jej k provedení.
- Zápis výsledků do jednotného registru v pracovním prostoru Azure ML. Abychom mohli tuto možnost využít, musíme přidat pár řádků kódu do našeho skriptu pro záznam výsledné přesnosti:
from azureml.core.run import Run
...
try:
    run = Run.get_submitted_run()
    run.log('accuracy', acc)
except:
    pass
Odpovídající verze skriptu se nazývá train_universal.py (je o něco složitější než to, co bylo napsáno výše, ale ne o moc). Tento skript lze spouštět jak lokálně, tak na vzdáleném výpočetním zdroji.
Abychom jej mohli spustit v Azure ML z VS Code, je třeba provést následující:
Ujistěte se, že Azure Extension je připojeno k vaší předplatné. Vyberte ikonu Azure v levém menu. Pokud nejste připojeni, v pravém dolním rohu se zobrazí upozornění (), na které kliknutím se můžete přihlásit přes prohlížeč. Můžete také stisknout Ctrl-Shift-P pro vyvolání příkazového řádku VS Code a zadat Azure Sign In.
Po tom, v sekci Azure (ikona vlevo) najděte sekci STROJNÍ UČENÍ:
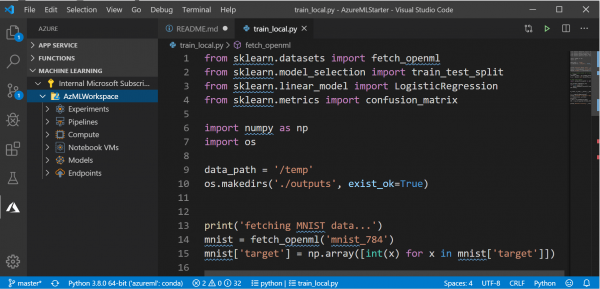
Zde byste měli vidět různé skupiny objektů uvnitř pracovního prostoru: výpočetní zdroje, experimenty atd.
- Přejděte na seznam souborů a klikněte pravým tlačítkem na skript
train_universal.pya vyberte si Azure ML: Spustit jako experiment v Azure.
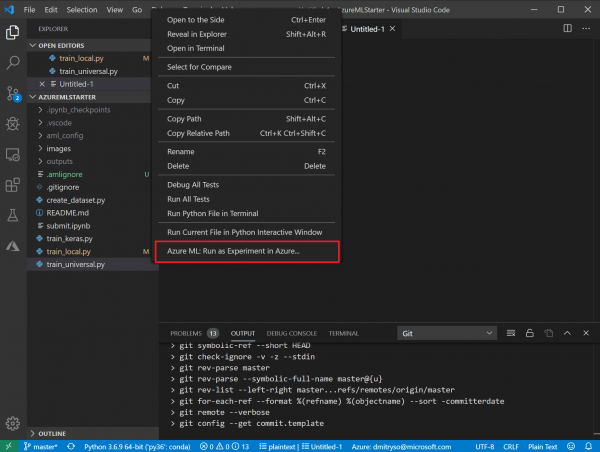
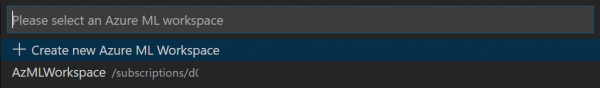
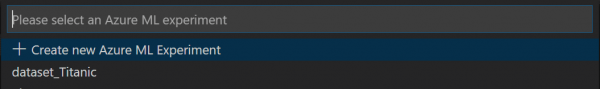
- Následovat bude série dialogů v terminálu VS Code: potvrďte používané předplatné a pracovní prostor Azure ML a také vyberte Vytvořit nový experiment:
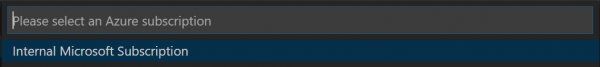
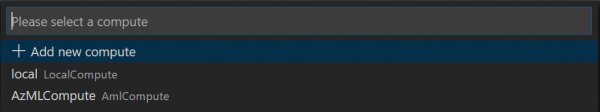
Vyberte možnost vytvoření nového výpočetního zdroje Vytvořit nový výpočet:
- Výpočetní určuje výpočetní zdroj, na kterém se bude provádět učení. Můžete vybrat místní počítač nebo cloudový clust AmlCompute. Doporučuji vytvořit škálovatelný cluster strojů
STANDARD_DS3_v2, s minimálním počtem strojů 0 (a maximálním počtem 1 nebo více, podle vašich požadavků). To lze provést prostřednictvím rozhraní VS Code, nebo předem přes .

- Výpočetní určuje výpočetní zdroj, na kterém se bude provádět učení. Můžete vybrat místní počítač nebo cloudový clust AmlCompute. Doporučuji vytvořit škálovatelný cluster strojů
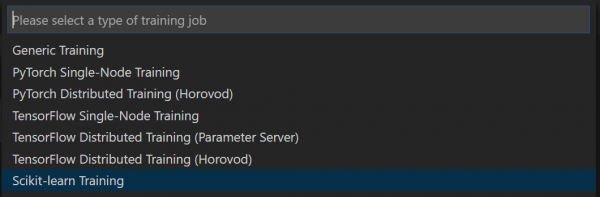
Dále je nutné vybrat konfiguraci Konfigurace výpočtu, která určuje parametry vytvářeného kontejneru pro učení, zejména všechny potřebné knihovny. V našem případě, protože používáme Scikit Learn, vybíráme SkLearn, a pak jednoduše potvrďte navrhovaný seznam knihoven stisknutím Enter. Pokud používáte nějaké další knihovny — je nutné je zde uvést.


Poté se otevře okno s JSON souborem, popisujícím experiment. V něm lze upravit některé parametry — například název experimentu. Poté klikněte na odkaz Odeslat experiment přímo uvnitř tohoto souboru:
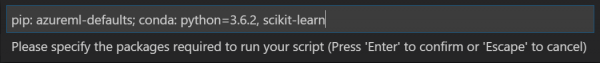
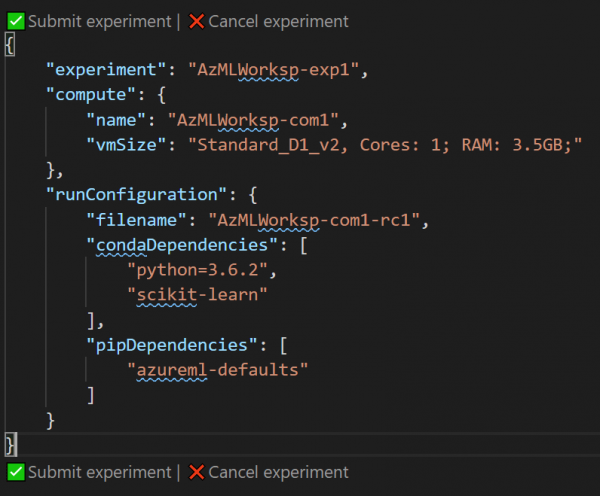
- Po úspěšném odeslání experimentu prostřednictvím VS Code uvidíte doprava v oblasti upozornění odkaz na , kde budete moci sledovat stav a výsledky experimentu.
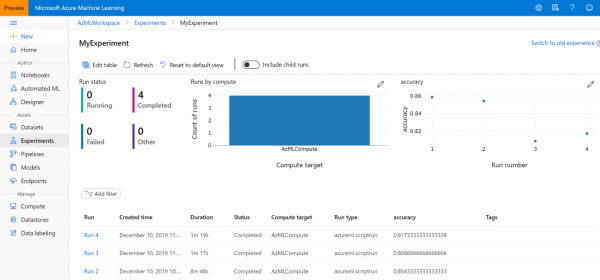
Později ho vždy naleznete v sekci Experimenty , nebo v sekci Azure Machine Learning ve seznamu experimentů:
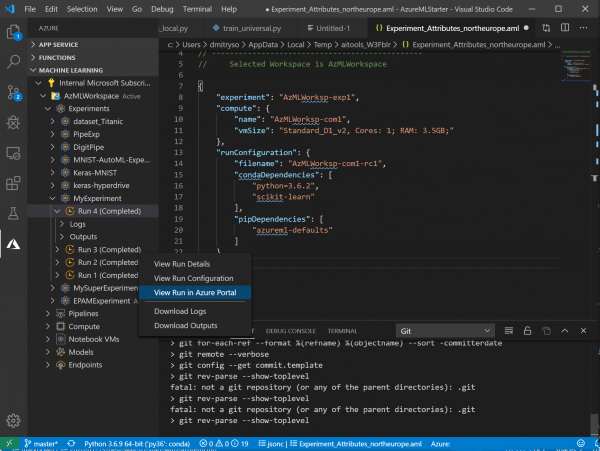
- Pokud jste po tomto provedli v kódu nějaké opravy nebo změnili parametry — opětovné spuštění experimentu bude mnohem rychlejší a jednodušší. Klikněte pravým tlačítkem na soubor a uvidíte nový položku menu Opakovat poslední spuštění — stačí si ji vybrat a experiment se okamžitě spustí:
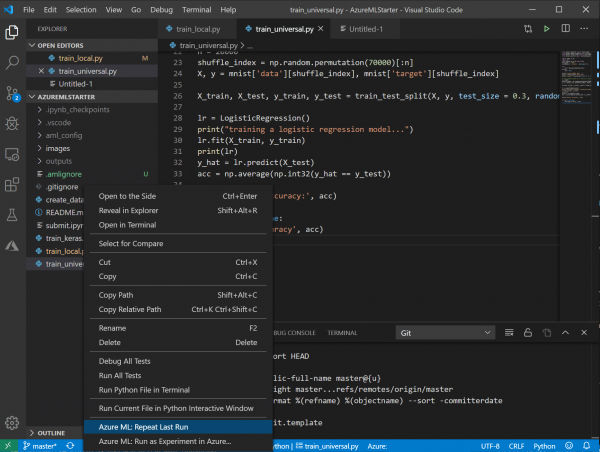
Výsledky metrik ze všech spuštění najdete vždy na Azure ML Portal, není nutné je zapisovat.
Nyní víte, že spouštění experimentů pomocí Azure ML je jednoduché a bezbolestné, a navíc získáváte řadu příjemných výhod.
Můžete si však také všimnout nedostatků. Například spuštění skriptu trvalo výrazně déle. Samozřejmě, že zabalení skriptu do kontejneru a jeho nasazení na server vyžaduje čas. Pokud byl klastr zredukován na velikost 0 uzlů, trvá ještě déle spustit virtuální stroj, a to je velmi patrné, když experimentujeme na jednoduchých úlohách, jako je MNIST, které se řeší během několika sekund. V reálném životě však, když školení trvá několik hodin, nebo dokonce dnů či týdnů, se tento další čas stává nevýznamným, zejména vzhledem k výrazně vyšší výkonnosti, kterou může výpočetní klastr poskytnout.
Co dál?
Doufám, že po přečtení tohoto článku budete schopni a budete chtít používat Azure ML ve své práci pro spuštění skriptů, správu výpočetních zdrojů a centralizované ukládání výsledků. Nicméně Azure ML vám může poskytnout ještě více výhod!
Uvnitř pracovního prostoru můžete uchovávat data, a tím vytvářet centralizované úložiště pro všechny své úkoly, ke kterému je snadné přistupovat. Navíc můžete spouštět experimenty nejen z Visual Studio Code, ale také pomocí API – to může být obzvlášť užitečné, pokud potřebujete provést optimalizaci hyperparametrů a skript spustit mnohokrát s různými parametry. Navíc Azure ML obsahuje speciální technologii , která umožňuje efektivnější vyhledávání a optimalizaci hyperparametrů. O těchto možnostech se zmíním ve své příští poznámce.
Užitečné zdroje
Pro podrobnější studium Azure ML se vám mohou hodit následující kurzy Microsoft Learn:
Zdroj: habr.com
