

V tomto článku je popsána realizace potrubí v jádře Unixu. Byl jsem mírně zklamán, že nedávný článek s názvem „“ se ukázal být ne o vnitřním uspořádání. Zaujal mě to a začal jsem hledat odpovědi ve starých zdrojích.
O čem je řeč?
Potrubí — „pravděpodobně nejdůležitější vynález v Unixu“ — jsou charakteristickým znakem filozofie Unixu spojující drobné programy, a také známý příkaz v příkazovém řádku:
$ echo hello | wc -c
6
Tato funkčnost závisí na systémovém volání poskytovaném jádrem pipe, které je popsáno na stránkách dokumentace a :
Potrubí poskytují jednosměrný kanál pro mezivstupování procesů. Potrubí má vstup (write end) a výstup (read end). Data zapsaná do vstupu potrubí mohou být přečtena na výstupu.
Potrubí se vytváří pomocí volání
pipe(2), které vrací dva deskriptory souborů: jeden odkazuje na vstup potrubí, druhý na výstup.
Výsledky sledování výše uvedeného příkazu demonstrují vytvoření potrubí a tok dat skrze něj z jednoho procesu do druhého:
$ strace -qf -e execve,pipe,dup2,read,write
    sh -c 'echo hello | wc -c'

execve("/bin/sh", ["sh", "-c", "echo hello | wc -c"], …)
pipe([3, 4])                            = 0
[pid 2604795] dup2(4, 1)                = 1
[pid 2604795] write(1, "hellon", 6)    = 6
[pid 2604796] dup2(3, 0)                = 0
[pid 2604796] execve("/usr/bin/wc", ["wc", "-c"], …)
[pid 2604796] read(0, "hellon", 16384) = 6
[pid 2604796] write(1, "6n", 2)        = 2
Rodičovský proces volá pipe(), aby získal propojené deskriptory souborů. Jeden podřízený proces zapisuje do jednoho deskriptora, zatímco druhý proces čte stejná data z druhého deskriptora. Shell pomocí dup2 "přejmenuje" deskriptory 3 a 4, aby odpovídaly stdin a stdout.
Bez potrubí by shell musel zapisovat výsledek jednoho procesu do souboru a předávat ho jinému procesu, aby ten mohl přečíst data ze souboru. To by vedlo k větší spotřebě prostředků a prostoru na disku. Nicméně potrubí není dobré jen tím, že umožňuje vyhnout se používání dočasných souborů:
Pokud se proces pokusí číst z prázdného potrubí, pak
read(2)se zablokuje, dokud nebudou data k dispozici. Pokud se proces pokusí zapsat do plného potrubí, pakwrite(2)bude zablokován, dokud nebude z pipeline přečteno dostatek dat pro zápis.
Stejně jako požadavek POSIX, to je důležitá vlastnost: zápis do pipeline až do PIPE_BUF bytů (alespoň 512) by měl být atomický, aby procesy mohly interagovat mezi sebou prostřednictvím pipeline tak, jak to obyčejné soubory (které takové záruky neposkytují) nemohou.
Při používání běžného souboru může proces zapsat všechny své výstupy a předat je jinému procesu. Nebo mohou procesy fungovat v režimu tvrdého paralelizace, s pomocí externího signálního mechanismu (například semaforu), aby si vzájemně signalizovaly dokončení zápisu nebo čtení. Pipelines nás zbavují všech těchto potíží.
Co hledáme?
Vysvětlím vám to jednoduše, abyste si lépe představili, jak může pipeline fungovat. Budete potřebovat vyhradit v paměti buffer a nějaký stav. Budou potřeba funkce pro přidání a odstranění dat z bufferu. Bude potřeba nějaký prostředek k volání funkcí během operací čtení a zápisu do souborových popisovačů. A budou potřeba zámky pro realizaci výše popsaného speciálního chování.
Nyní jsme připraveni podívat se pod jasným světlem lampy na zdrojový kód jádra, abychom potvrdili nebo vyvrátili náš nejasný mentální model. Ale vždy buďte připraveni na překvapení.
Kde hledáme?
Nevím, kde se nachází má kopie známé knihy „„ se zdrojovým kódem Unix 6, ale díky můžeme hledat online ještě starších verzí Unixu.
Bloudění po archivech TUHS je podobné návštěvě muzea. Můžeme nahlédnout do naší společné historie a cítím úctu k mnohaletému úsilí o obnovení všech těchto materiálů bit po bitu ze starých kazet a výtisků. A ostře si uvědomuji ty fragmenty, které stále chybí.
S uspokojením svého zvědavého ohledně prastaré historie pipelines se pro srovnání můžeme podívat na moderní jádra.
Mimochodem, pipe je systémový zavolání číslo 42 v tabulce sysent[]. Náhoda?
Tradiční jádra Unixu (1970–1974)
Nenašel jsem žádné stopy pipe(2) ani v (leden 1970), ani v (listopad 1971), ani v neúplném zdrojovém kódu (červen 1972).
TUHS tvrdí, že (únor 1973) se stal první verzí s trubkami:
Třetí vydání Unixu bylo poslední verzí s jádrem napsaným v assembleru, ale bylo také první verzí s trubkami. Během roku 1973 probíhaly práce na zlepšení třetího vydání, jádro bylo přepsáno v C, a tak vzniklo čtvrté vydání Unixu.
Jeden z čtenářů našel sken dokumentu, ve kterém Doug McIlroy navrhnul myšlenku „spojování programů podle principu zahradní hadice“.
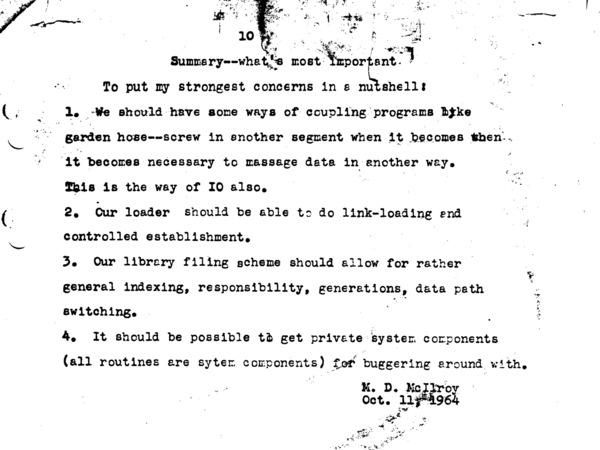
V knize Briana Kernighana „“ je o vzniku trubek také zmíněn tento dokument: „… visel na zdi mé kanceláře v Bell Labs po dobu 30 let“. Tady je , a ještě jeden příběh z :
Když se objevil Unix, moje nadšení pro korutiny mě přimělo požádat autora OS, Kena Thompsona, aby umožnil datům zapsaným v nějakém procesu jít nejen na zařízení, ale také na výstup do jiného procesu. Ken usoudil, že je to možné. Nicméně jako minimalisté chtěl, aby každá systémová funkce hrála významnou roli. Má opravdu přímé zápis mezi procesy velkou výhodu oproti zápisu do mezipaměti? A teprve když jsem předložil konkrétní návrh s atraktivním názvem „trubka“ a popisem syntaxe interakce procesů, Ken konečně vykřikl: „Udělám to!“.
A udělal. Jedno osudové večer Ken změnil jádro a shell, opravil několik standardních programů a standardizoval jejich proceduru přijímání vstupních dat (která může pocházet z trubky) a také změnil názvy souborů. Druhý den byly trubky široce využívány v aplikacích. Na konci týdne sekretářky pomocí nich posílaly dokumenty z textových editorů na tiskárnu. O něco později Ken nahradil původní API a syntaxi pro shell používání trubek čistějšími dohodami, které se od té doby praktikuje.
Bohužel, zdrojový kód třetí verze Unixu je ztracen. Ačkoliv máme zdrojový kód jádra napsaného v C , vydané v listopadu 1973, vyšla však několik měsíců před oficiálním vydáním a neobsahuje implementaci trubek. Je škoda, že zdrojový kód legendární funkce Unix je ztracen, možná navždy.
Máme text dokumentace k pipe(2) z obou vydání, takže můžeme začít hledáním v dokumentaci (podle určitých slov, podtržených „ručně“, řetězec literálů ^H, za kterým následuje podtržítko!). Tento proto-pipe(2) je napsán v assembleru a vrací pouze jeden deskriptor souboru, ale již poskytuje očekávanou základní funkčnost:
Systémové volání pipe vytváří mechanismus vstupu a výstupu, který se nazývá potrubí. Vrácený deskriptor souboru lze použít pro operace čtení a zápisu. Když se do potrubí něco zapíše, je přihráno do 504 bajtů dat, poté je proces zápisu pozastaven. Při čtení z potrubí jsou vybrána zbufrovaná data.
Následující rok bylo jádro přepsáno do C, a získalo svůj moderní vzhled s prototypem „pipe(fildes)»:
Systémové volání pipe vytváří mechanismus vstupu a výstupu, který se nazývá potrubí. Vrácené deskriptory souborů lze používat v operacích čtení a zápisu. Když se něco zapíše do potrubí, používá se deskriptor vrácený v r1 (odpovídající fildes[1]), a je přihráno do 4096 bajtů dat, poté je proces zápisu pozastaven. Při čtení z potrubí deskriptor vrácený v r0 (odpovídající fildes[0]) vybírá data.
Předpokládá se, že po určení potrubí dva (nebo více) spolupracujících procesů (vytvořených následnými voláními fork) budou přenášet data z potrubí pomocí volání read a write.
V shellu existuje syntaxe pro definování lineárního pole procesů, propojených prostřednictvím potrubí.
Volání pro čtení z prázdného potrubí (které neobsahuje bufrovaná data), má pouze jeden konec (všechny zapisující deskriptory souborů jsou zavřeny), vrací „konec souboru“. Volání pro zápis v podobné situaci jsou ignorována.
Nejranější se vztahuje (červen 1974), ale je téměř identická s tou, která se objevila v následujícím vydání. Byly přidány pouze komentáře, takže pátou edici lze přeskočit.
Šestá edice Unixu (1975)
Začínáme číst zdrojový kód Unixu (květen 1975). Převážně díky Lions je mnohem snazší ho najít než zdroje dřívějších verzí:
Mnoho let kniha Lions byla jediným dokumentem týkajícím se jádra Unix, který byl k dispozici mimo závody Bell Labs. Ačkoli licence šesté verze umožňovala učitelům používat její zdrojový kód, licence sedmé verze tuto možnost vyloučila, a proto se kniha šířila v podobě nelegálních strojopisů.
Dnes je možné zakoupit reprint knihy, na jejíž obálce jsou studenti u kopírovacího stroje. A díky Warrenovi Toomeyovi (který zahájil projekt TUHS) si můžete stáhnout . Chci vám poskytnout představu, kolik práce stálo vytvoření souboru:
Před více než 15 lety jsem přepsal kopii zdrojového kódu, uvedeného v Lions, protože se mi nelíbila kvalita mé kopie z neznámého počtu dalších kopií. TUHS ještě neexistovalo a neměl jsem přístup ke starým zdrojům. Ale v roce 1988 jsem našel starou pásku s 9 stopami, na které byla záloha z počítače PDP11. Bylo těžké zjistit, zda funguje, ale bylo tam nepoškozené stromové struktury /usr/src/, ve kterém většina souborů byla označena rokem 1979, což už tehdy vypadalo jako pravěk. Byla to sedmá verze nebo její odvozenina PWB, jak jsem si myslel.
Toto nález jsem použil jako základ a ručně jsem upravil zdroje do stavu šesté verze. Některé části kódu zůstaly stejné, jiné bylo třeba mírně upravit, když jsem moderní token += změnil na zastaralé =+. Něco jsem prostě smazal, něco jsem musel úplně přepsat, ale ne příliš mnoho.
A dnes můžeme online číst na TUHS zdrojový kód šesté verze z .
Mimochodem, na první pohled je hlavní vlastností C-kódu před obdobím Kernighan a Ritchie jeho stručnost. Ne tak často se mi daří vkládat fragmenty kódu bez rozsáhlého editování, aby se vešly do relativně úzké oblasti zobrazení na mém webu.
Na začátku je vysvětlující komentář (a ano, tam je ještě ):
/*
 * Max allowable buffering per pipe.
 * This is also the max size of the
 * file created to implement the pipe.
 * If this size is bigger than 4096,
 * pipes will be implemented in LARG
 * files, which is probably not good.
 */
#define    PIPSIZ    4096
Velikost bufferu se od čtvrté verze nezměnila. Ale zde vidíme bez jakékoli veřejné dokumentace, že kdysi používaly potrubí soubory jako záložní úložiště!
Pokud jde o soubory LARG, odpovídají , který se používá "algoritmem velkého adresování" pro zpracování za účelem podpory větších souborových systémů. Pokud Ken říkal, že je lepší je nepoužívat, rád mu věřím.
Toto je skutečný systémový volání pipe:
/*
 * The sys-pipe entry.
 * Allocate an inode on the root device.
 * Allocate 2 file structures.
 * Put it all together with flags.
 */
pipe()
{
    register *ip, *rf, *wf;
    int r;

    ip = ialloc(rootdev);
    if(ip == NULL)
        return;
    rf = falloc();
    if(rf == NULL) {
        iput(ip);
        return;
    }
    r = u.u_ar0[R0];
    wf = falloc();
    if(wf == NULL) {
        rf->f_count = 0;
        u.u_ofile[r] = NULL;
        iput(ip);
        return;
    }
    u.u_ar0[R1] = u.u_ar0[R0]; /* wf's fd */
    u.u_ar0[R0] = r;           /* rf's fd */
    wf->f_flag = FWRITE|FPIPE;
    wf->f_inode = ip;
    rf->f_flag = FREAD|FPIPE;
    rf->f_inode = ip;
    ip->i_count = 2;
    ip->i_flag = IACC|IUPD;
    ip->i_mode = IALLOC;
}
V komentáři je jasně popsáno, co se zde děje. Ale porozumět kódu není tak snadné, částečně kvůli tomu, jak se pomocí "" a registrů R0 a R1 předávají parametry systémových volání a vracené hodnoty.
Zkusíme pomocí alokovat na disku , a pomocí — alokovat v paměti dva . Pokud vše proběhne dobře, nastavíme příznaky pro určení těchto souborů jako obou konců potrubí, uvedeme je ve stejném inode (jehož čítač referencí se zvýší na 2), a označíme inode jako změněný a používaný. Všimněte si odkazů na v chybových cestách (error paths) pro snížení počtu odkazů v novém inode.
pipe() musí přes R0 a R1 vracet čísla deskriptorů souborů pro čtení a zápis. falloc() vrací ukazatel na strukturu souboru, ale také "vrací" přes u.u_ar0[R0] a deskriptor souboru. To znamená, že kód ukládá do jsou rovny nule. deskriptor souboru pro čtení a přiřazuje deskriptor pro zápis přímo z u.u_ar0[R0] po druhém volání falloc().
Přepínač FPIPE, které jsme zadali při vytváření potrubí, řídí chování funkce , která volá konkrétní podprogramy vstupu-výstupu I/O:
/*
 * common code for read and write calls:
 * check permissions, set base, count, and offset,
 * and switch out to readi, writei, or pipe code.
 */
rdwr(mode)
{
    register *fp, m;

    m = mode;
    fp = getf(u.u_ar0[R0]);
        /* … */

    if(fp->f_flag&FPIPE) {
        if(m==FREAD)
            readp(fp); else
            writep(fp);
    }
        /* … */
}
Poté funkce readp() v pipe.c čte data z potrubí. Ale sledovat realizaci je lépe začít od writep(). Opakuji, kód se zkomplikoval kvůli zvláštnostem dohody o předávání argumentů, ale některé podrobnosti lze opomenout.
writep(fp)
{
    register *rp, *ip, c;

    rp = fp;
    ip = rp->f_inode;
    c = u.u_count;

loop:
    /* Pokud je vše hotovo, vraťte. */

    plock(ip);
    if(c == 0) {
        prele(ip);
        u.u_count = 0;
        return;
    }

    /*
     * Pokud nejsou obě strany pro čtení a zápis potrubí aktivní, vraťte chybu a signalizujte také.
     *
     */

    if(ip->i_count i_size1 == PIPSIZ) {
        ip->i_mode |= IWRITE;
        prele(ip);
        sleep(ip+1, PPIPE);
        goto loop;
    }

    /* Napište, co je možné, a vraťte se zpět. */

    u.u_offset[0] = 0;
    u.u_offset[1] = ip->i_size1;
    u.u_count = min(c, PIPSIZ-u.u_offset[1]);
    c -= u.u_count;
    writei(ip);
    prele(ip);
    if(ip->i_mode & IREAD) {
        ip->i_mode &= ~IREAD;
        wakeup(ip+2);
    }
    goto loop;
}
Do vstupu potrubí chceme zapsat bajty u.u_count. Nejprve požádáme o zablokování indexového deskriptoru (viz níže plock/prele).
Nejprve zkontrolujeme počítadlo odkazů inode. Dokud oba konce potrubí zůstávají otevřené, měl by být počítadlo rovno 2. Držíme jeden odkaz (z rp->f_inode), takže pokud bude počítadlo menší než 2, mělo by to znamenat, že čtecí proces uzavřel svůj konec potrubí. Jinými slovy, snažíme se zapisovat do uzavřeného potrubí, což je chyba. Chybový kód EPIPE a signál SIGPIPE se objevily v šesté edici Unixu.
Ale i když je potrubí otevřené, může být zaplněno. V takovém případě odkládáme zámek a jdeme spát, doufajíc, že nějaký jiný proces přečte z potrubí a uvolní v něm dostatek místa. Po probuzení se vrátíme na začátek, znovu zavěsíme zámek a spustíme nový cyklus zápisu.
Pokud je v potrubí dostatek volného místa, zapisujeme do něj data pomocí . Parametr i_size1 inode (u prázdného potrubí může být roven 0) udává konec dat, která v něm již jsou. Pokud je místo pro zápis dostatek, můžeme naplnit potrubí až i_size1 do PIPESIZ. Poté uvolníme zámek a pokusíme se probudit jakýkoli proces, který čeká na možnost přečíst z potrubí. Vracíme se na začátek, abychom zjistili, zda se nám podařilo zapsat tolik bajtů, kolik jsme potřebovali. Pokud ne, začínáme nový zápisový cyklus.
Obvykle se parametr i_mode inode používá k uchovávání oprávnění. jsou rovny nule., w a x. Ale v případě potrubí signalizujeme čekání nějakým procesem zápisu nebo čtení pomocí bitů IREAD a IWRITE podle toho. Proces nastaví příznak a zavolá sleep(), a čeká se, že v budoucnu nějaký jiný proces zavolá wakeup().
Skutečné kouzlo se děje v sleep() a wakeup(). Jsou implementovány v , zdroji proslulého komentáře „Nemusíte tomu rozumět“ (You are not expected to understand this). Naštěstí, nemusíme rozumět kódu, prostě se podíváme na některé komentáře:
/*
 * Give up the processor till a wakeup occurs
 * on chan, at which time the process
 * enters the scheduling queue at priority pri.
 * The most important effect of pri is that when
 * pri<0 a signal cannot disturb the sleep;
 * if pri>=0 signals will be processed.
 * Callers of this routine must be prepared for
 * premature return, and check that the reason for
 * sleeping has gone away.
 */
sleep(chan, pri) /* … */

/*
 * Wake up all processes sleeping on chan.
 */
wakeup(chan) /* … */
Proces, který volá sleep() pro určité kanál, může být později probuzen jiným procesem, který zavolá wakeup() pro stejný kanál. writep() a readp() koordinují své akce prostřednictvím těchto párových volání. Všimněte si, že pipe.c vždy dává přednost PPIPE při volání, takže všechny sleep()mohou být přerušeny signálem. sleep() Nyní máme všechno, abychom porozuměli funkci
Nyní máme všechno, abychom porozuměli funkci readp():
readp(fp)
int *fp;
{
    register *rp, *ip;

    rp = fp;
    ip = rp->f_inode;

loop:
    /* Velmi konzervativní zamykání. */

    plock(ip);

    /*
     * Pokud hlava (čtení) dohonila
     * ocas (zápis), resetujeme oba na 0.
     * /

    if(rp->f_offset[1] == ip->i_size1) {
        if(rp->f_offset[1] != 0) {
            rp->f_offset[1] = 0;
            ip->i_size1 = 0;
            if(ip->i_mode&IWRITE) {
                ip->i_mode =& ~IWRITE;
                wakeup(ip+1);
            }
        }

        /*
         * Pokud nejsou aktivní oba čtenář a
         * zapisovatel, vrať se bez
         * splnění čtení.
         * /

        prele(ip);
        if(ip->i_count i_mode =| IREAD;
        sleep(ip+2, PPIPE);
        goto loop;
    }

    /* Čti a vrať */

    u.u_offset[0] = 0;
    u.u_offset[1] = rp->f_offset[1];
    readi(ip);
    rp->f_offset[1] = u.u_offset[1];
    prele(ip);
}
Možná vám bude snazší číst tuto funkci shora dolů. Větev „čti a vrať“ se obvykle používá, když je v potrubí nějaká data. V tomto případě pomocí čteme tolik dat, kolik je k dispozici, počínaje aktuálním f_offset čtením, a poté aktualizujeme odpovídající posun.
Při následujícím čtení bude potrubí prázdné, pokud posun čtení dosáhl hodnoty i_size1 u inode‘a. Resetujeme pozici na 0 a pokoušíme se probudit jakýkoli proces, který chce do potrubí zapsat. Víme, že když bude potrubí plné, writep() usne na ip+1. A teď, když je potrubí prázdné, jej můžeme probudit, aby obnovil svůj cyklus zápisu.
Pokud není co číst, pak readp() může nastavit flag IREAD a usnout na ip+2. Víme, že jej probudí writep(), když do potrubí zapíše nějaká data.
Komentáře k pomohou pochopit, že místo předávání parametrů přes „u“ můžeme s nimi zacházet jako s běžnými funkcemi vstupu-výstupu, které berou soubor, pozici, buffer v paměti a počítají počet bajtů k přečtení nebo zapsání.
/*
 * Read the file corresponding to
 * the inode pointed at by the argument.
 * The actual read arguments are found
 * in the variables:
 *    u_base        core address for destination
 *    u_offset    byte offset in file
 *    u_count        number of bytes to read
 *    u_segflg    read to kernel/user
 */
readi(aip)
struct inode *aip;
/* … */

/*
 * Write the file corresponding to
 * the inode pointed at by the argument.
 * The actual write arguments are found
 * in the variables:
 *    u_base        core address for source
 *    u_offset    byte offset in file
 *    u_count        number of bytes to write
 *    u_segflg    write to kernel/user
 */
writei(aip)
struct inode *aip;
/* … */
Pokud jde o „konzervativní“ zamykání, tak readp() a writep() zamykají inode, dokud neskončí práci nebo nedostanou výsledek (tj. nezavolají wakeup). plock() a prele() fungují jednoduše: pomocí jiného souboru volání sleep a wakeup nám umožňuje probouzet jakýkoli proces, který potřebuje zámek, který jsme právě odstranili:
/*
 * Lock a pipe.
 * If its already locked, set the WANT bit and sleep.
 */
plock(ip)
int *ip;
{
    register *rp;

    rp = ip;
    while(rp->i_flag&ILOCK) {
        rp->i_flag =| IWANT;
        sleep(rp, PPIPE);
    }
    rp->i_flag =| ILOCK;
}

/*
 * Unlock a pipe.
 * If WANT bit is on, wakeup.
 * This routine is also used to unlock inodes in general.
 */
prele(ip)
int *ip;
{
    register *rp;

    rp = ip;
    rp->i_flag =& ~ILOCK;
    if(rp->i_flag&IWANT) {
        rp->i_flag =& ~IWANT;
        wakeup(rp);
    }
}
Zprvu jsem nemohl pochopit, proč readp() nevolá prele(ip) před voláním wakeup(ip+1). První, covyvolává ve svém cyklu, je writep() plock(ip), který vede k vzájemné blokaci, pokudještě nesundal svůj zámek, takže kód nějak musí fungovat správně. Když se podíváte na readp() tak to vypadá, že v tom může být háček. wakeup(), tak se stává jasné, že pouze označuje spící proces jako připravený k provedení, aby v budoucnu sched() skutečně jej spustila. Takže readp() vyvolává wakeup(), odstraní zámek, nastaví IREAD a vyvolává sleep(ip+2)— to vše předtím, než writep() obnoví cyklus.
Tímto se popis potrubí v šesté edici uzavírá. Jednoduchý kód, dalekosáhlé důsledky.
(leden 1979) byla novým hlavním vydáním (po čtyřech letech), které přineslo mnoho nových aplikací a vlastností jádra. Také došlo k významným změnám v souvislosti s použitím typového převodu, unionů a typovaných ukazatelů na struktury. Nicméně se prakticky nezměnil. Můžeme tuto edici přeskočit.
Xv6, jednoduché jádro podobné Unixu
Na vytvoření jádra měla vliv šestá edice Unixu, ale je napsána v moderním C, aby běžela na procesorech x86. Kód se snadno čte, je srozumitelný. Navíc, na rozdíl od zdrojových kódů Unixu z TUHS, můžete jej zkompilovat, modifikovat a spustit na něčem jiném než PDP 11/70. Proto je toto jádro široce používáno na univerzitách jako učební materiál o operačních systémech. Zdrojové kódy .
Kód obsahuje srozumitelnou a promyšlenou implementaci , podpořenou vyrovnávací pamětí v paměti místo inodu na disku. Zde uvádím pouze definici "strukturálního potrubí" a funkce pipealloc():
#define PIPESIZE 512

struct pipe {
  struct spinlock lock;
  char data[PIPESIZE];
  uint nread;     // number of bytes read
  uint nwrite;    // number of bytes written
  int readopen;   // read fd is still open
  int writeopen;  // write fd is still open
};

int
pipealloc(struct file **f0, struct file **f1)
{
  struct pipe *p;

  p = 0;
  *f0 = *f1 = 0;
  if((*f0 = filealloc()) == 0 || (*f1 = filealloc()) == 0)
    goto bad;
  if((p = (struct pipe*)kalloc()) == 0)
    goto bad;
  p->readopen = 1;
  p->writeopen = 1;
  p->nwrite = 0;
  p->nread = 0;
  initlock(&p->lock, "pipe");
  (*f0)->type = FD_PIPE;
  (*f0)->readable = 1;
  (*f0)->writable = 0;
  (*f0)->pipe = p;
  (*f1)->type = FD_PIPE;
  (*f1)->readable = 0;
  (*f1)->writable = 1;
  (*f1)->pipe = p;
  return 0;

 bad:
  if(p)
    kfree((char*)p);
  if(*f0)
    fileclose(*f0);
  if(*f1)
    fileclose(*f1);
  return -1;
}
pipealloc() nastavuje stav celé ostatní implementace, která zahrnuje funkce piperead(), pipewrite() a pipeclose(). Skutečné systémové volání sys_pipe je obálka implementovaná v . Doporučuji přečíst celý jeho kód. Obtížnost na úrovni zdrojového kódu šesté edice, ale čtení je mnohem snazší a příjemnější.
Linux 0.01
Lze najít zdrojový kód Linuxu 0.01. Bude poučné prostudovat implementaci potrubí v jeho fs/pipe.c. Zde pro představování potrubí se používá inode, ale samo potrubí je napsáno v moderním C. Pokud jste prošli kódem šesté edice, zde nenarazíte na obtíže. Takto vypadá funkce write_pipe():
int write_pipe(struct m_inode * inode, char * buf, int count)
{
    char * b=buf;

    wake_up(&inode->i_wait);
    if (inode->i_count != 2) { /* žádní čtenáři */
        current->signal |= (1<0) {
        while (PIPE_FULL(*inode)) {
            wake_up(&inode->i_wait);
            if (inode->i_count != 2) {
                current->signal |= (1<i_wait);
        }
        ((char *)inode->i_size)[PIPE_HEAD(*inode)] =
            get_fs_byte(b++);
        INC_PIPE( PIPE_HEAD(*inode) );
        wake_up(&inode->i_wait);
    }
    wake_up(&inode->i_wait);
    return b-buf;
}
I bez nahlédnutí do definic struktur je jasné, jak se počítadlo odkazů inode používá pro zjištění, zda zápisová operace vede k SIGPIPE. Kromě byte-by-byte operací je tuto funkci snadné porovnat s výše uvedenými myšlenkami. Dokonce logika sleep_on/wake_up nepůsobí tak cize.
Moderní jádra Linuxu, FreeBSD, NetBSD, OpenBSD
Rychle jsem prozkoumal některá moderní jádra. V žádném z nich už není realizace, která by používala disk (což není překvapující). Linux má svou vlastní realizaci. A i když tři moderní BSD jádra obsahují implementace založené na kódu, který napsal John Dyson, v průběhu let se natolik od sebe odlišila.
Abychom mohli číst fs/pipe.c (na Linuxu) nebo sys/kern/sys_pipe.c (na *BSD), vyžaduje to skutečné odhodlání. Dnes je v kódu klíčová výkonnost a podpora funkcí takových, jako jsou vektorové a asynchronní operace vstupu/výstupu. Detaily o alokaci paměti, zámcích a konfiguraci jádra se velmi liší. To nejsou témata, která by univerzity chtěly pokrýt v úvodním kursu operačních systémů.
Tak či onak, zajímalo mě odkryjící několik starých vzorů (například generování SIGPIPE a návrat EPIPE při zápisu do uzavřeného potrubí) ve všech těchto, tak různých, moderních jádrech. Pravděpodobně nikdy neuvidím počítač PDP-11 naživo, ale stále je co se naučit z kódu, který byl napsán několik let před mým narozením.
Článek od Divi Kapura z roku 2011 "" je přehledem toho, jak (stále) fungují potrubí v Linuxu. A ilustruje model interakce potrubí, jehož možnosti překračují možnosti dočasných souborů; a také ukazuje, jak daleko se potrubí vzdálila od "velmi konzervativního zámku" v jádře Unixu šesté edice.
Zdroj: habr.com
