

Obrázky ve formátu JPEG se v naší digitální životě nacházejí všude, ale za touto povrchní znalostí se skrývají algoritmy, které eliminují detaily, jež lidské oko nevnímá. Výsledkem je nejvyšší vizuální kvalita při minimální velikosti souboru – ale jak přesně to funguje? Pojďme se podívat, co přesně naše oči nevidí!
Je snadné považovat za samozřejmost možnost poslat fotku kamarádovi a nezabývat se tím, jaké zařízení, prohlížeč nebo operační systém používá – ale tak tomu nebylo vždy. Na začátku 80. let 20. století uměly počítače ukládat a zobrazovat digitální obrázky, ale existovalo mnoho konkurenčních myšlenek o tom, jak to udělat nejlépe. Nebylo možné jen tak poslat obrázek z jednoho počítače na druhý a doufat, že to bude fungovat.
Aby se tento problém vyřešil, byl v roce 1986 sestaven výbor odborníků z celého světa pod názvem „“ (Joint Photographic Experts Group, JPEG), založený v rámci spolupráce Mezinárodní organizace pro normalizaci (ISO) a Mezinárodní elektro-technické komise (IEC) – dvou mezinárodních normalizačních organizací se sídlem v Ženevě (Švýcarsko).
Skupina lidí zvaná JPEG vytvořila standard pro kompresi digitálních obrázků JPEG v roce 1992. Každý, kdo používal internet, se pravděpodobně setkal s obrázky ve formátu JPEG. Je to nejrozšířenější způsob kódování, odesílání a ukládání obrázků. Od webových stránek po e-maily a sociální sítě, JPEG se používá miliardykrát denně – prakticky vždy, když se podíváme na obrázek online nebo ho pošleme. Bez JPEG by byl web méně živý, pomalejší a pravděpodobně by na něm bylo méně kočičích fotek!
Tento článek je o tom, jak dekódovat JPEG obrázek. Jinými slovy, o tom, co je potřeba k převodu komprimovaných dat uložených na počítači na obrázek, který se zobrazuje na obrazovce. O tom je dobré vědět nejen proto, že je to důležité pro pochopení technologie, kterou používáme každý den, ale také proto, že odhalováním úrovní komprese lépe poznáváme vnímání a zrak, stejně jako to, na jaké detaily jsou naše oči nejvíce citlivé.
Kromě toho je velmi zajímavé hrát si s obrázky tímto způsobem.
Nahlédnutí do JPEG
Na počítači jsou všechna data uložena jako sekvence binárních čísel. Obvykle se tyto bity, nuly a jedničky, seskupují po osmi a tvoří bajty. Když otevřete JPEG obrázek na počítači, něco (prohlížeč, operační systém nebo něco jiného) musí dekódovat bajty a obnovit původní obrázek jako seznam barev, které lze zobrazit.
Pokud si stáhnete tento roztomilý a otevřete jej v textovém editoru, uvidíte spoustu nesmyslných znaků.
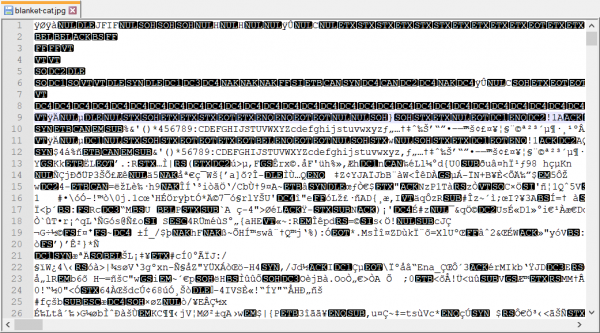
Zde používám Notepad++ k prozkoumání obsahu souboru, protože běžné textové editory, jako je Notepad z Windows, poškodí binární soubor po jeho uložení a ten přestane splňovat formát JPEG.
Když otevřete obrázek v textovém editoru, zmátete počítač stejně, jako zmátete svůj mozek, když si třete oči a začnete vidět barevné skvrny!
Tyto skvrny, které vidíte, jsou známy jako , a nejsou výsledkem působení světelného podnětu nebo halucinací vyvolaných myslí. Vznikají proto, že váš mozek předpokládá, že jakékoliv elektrické signály v očních nervech přenášejí informace o světle. Mozku je nutné dělat taková předpokládání, protože nelze jinak poznat, zda je signál zvukem, viděním nebo něčím jiným. Všechny nervy v těle přenášejí naprosto stejné elektrické impulzy. Tlak na oči posílá signály, které nejsou vizuální, ale aktivují receptory oka, což váš mozek interpretuje – v tomto případě chybně – jako něco vizuálního. Doslova vidíte tlak!
Je zábavné přemýšlet o tom, jak moc jsou počítače podobné mozku, nicméně to také slouží jako užitečná analogie, ilustrující, jak silně závisí význam dat – přenášených nervy tělem, nebo uchovávaných na počítači – na jejich interpretaci. Všechna binární data se skládají z nul a jedniček, základních komponentů schopných předávat informace jakéhokoli druhu. Váš počítač často hádá, jak je interpretovat pomocí indicií, jako jsou přípony souborů. A nyní ho nutíme, aby je interpretoval jako text, protože to právě očekává textový editor.
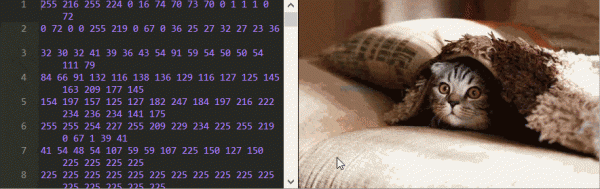
Abychom pochopili, jak dešifrovat JPEG, musíme vidět samotné původní signály – binární data. Toho lze dosáhnout pomocí hexadecimálního editoru, nebo přímo na ! Tam je obrázek, vedle kterého je v textovém poli uvedena veškerá jeho data (kromě headeru), prezentovaná v desítkové soustavě. Můžete je měnit a skript je překóduje a na místě vygeneruje nový obrázek.
Mnoho toho lze zjistit prostým hraním si s tímto editorem. Například, můžete říct, v jakém pořadí jsou uloženy pixely?
Na tomto příkladu je podivné to, že změna některých čísel vůbec neovlivní obrázek, ale pokud například v první řádku změníte číslo 17 na 0, fotka se úplně zhorší!
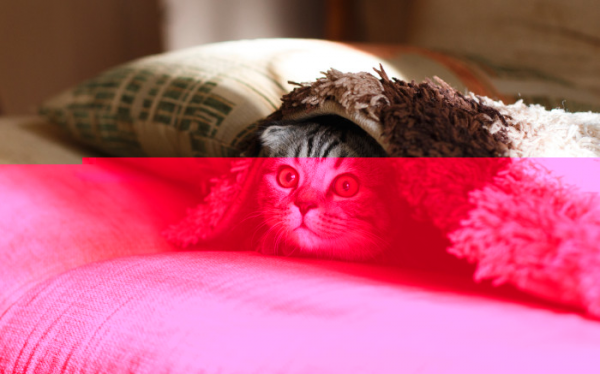
Jiné změny, například změna 7 na řádku 1988 na číslo 254, změní barvu, ale pouze následujících pixelů.
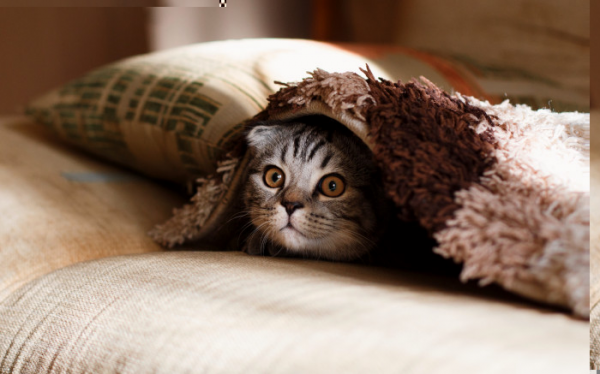
Možná nejpodivnější je to, že některá čísla mění nejen barvu, ale i tvar obrázku. Změňte 70 v řádku 12 na 2 a podívejte se na horní řadu obrázku, abyste viděli, co tím myslím.
A bez ohledu na to, jaký JPEG obrázek použijete, vždy narazíte na tyto tajemné šachové sekvence při úpravě bytů.
Při hraní si s editorem je obtížné pochopit, jak se obrázek z těchto bytů rekonstruktivuje, protože JPEG komprese se skládá ze tří různých technologií, které se aplikují za sebou na úrovních. Každou z nich podrobně prozkoumáme, abychom odhalili tajemné chování, které pozorujeme.
Tři úrovně JPEG komprese:
- .
- .
- , a
Aby jste si mohli představit rozsah komprese, vezměte na vědomí, že obrázek uvedený výše obsahuje 79 819 čísel, tedy přibližně 79 kB. Kdybychom ho ukládali bez komprese, pro každý pixel by bylo potřeba tři čísla – pro červenou, zelenou a modrou složku. To by činilo 917 700 čísel, tedy přibližně 917 kB. V důsledku JPEG komprese se výsledný soubor zmenšil více než 10krát!
Ve skutečnosti lze tento obrázek komprimovat ještě více. Níže jsou uvedeny dvě obrázky vedle sebe – fotka vpravo byla zmenšena na 16 kB, tedy 57krát méně než nekomprimovaná verze!
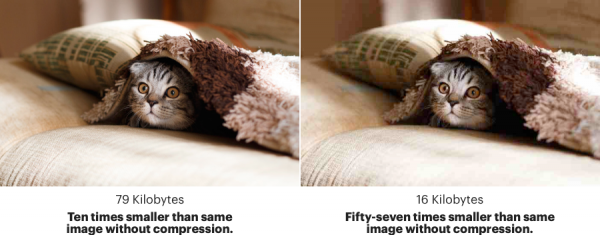
Pokud se podíváte blíže, uvidíte, že tyto obrázky nejsou identické. Oba jsou obrázky s JPEG kompresí, avšak ten vpravo je mnohem menší. Také vypadá o něco hůře (podívejte se na čtverečky barev pozadí). Proto se JPEG také nazývá komprese se ztrátami; při kompresi se obrázek mění a ztrácí některé detaily.
1. Barevná subdiskretizace
Toto je obrázek s použitím pouze prvního stupně komprese.
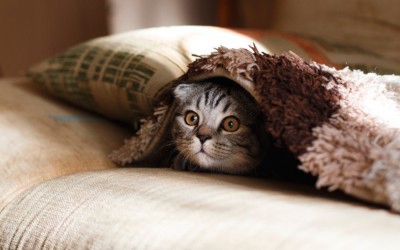
(Interaktivní verze – v článku). Odstranění jednoho čísla zničí všechny barvy. Ovšem pokud odstraníte přesně šest čísel, má to na obrázek prakticky zanedbatelný vliv.
Nyní jsou čísla o něco snazší na dešifrování. Je to skoro jednoduchý seznam barev, kde každý byte mění přesně jeden pixel, ale přitom je už dvakrát menší než nekomprimovaný obrázek (který by zabíral přibližně 300 kB v takto zmenšené velikosti). Uhodnete proč?
Je vidět, že tato čísla neoznačují standardní červené, zelené a modré komponenty, protože pokud všechny čísla nahradíme nulami, získáme zelený obrázek (a ne bílý).

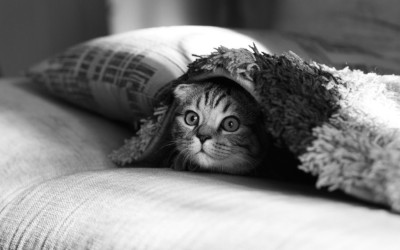
Je to proto, že tyto byty označují Y (jasnost),
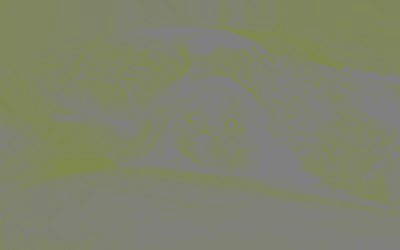
Cb (relativní modrost),
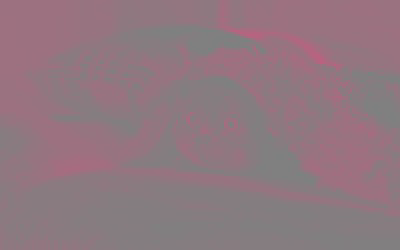
a Cr (relativní červenost) obrázku.
Proč nepoužívat RGB? Vždyť takto funguje většina moderních obrazovek. Váš monitor může zobrazit jakoukoli barvu, včetně červené, zelené a modré barvy s různou intenzitou pro každý pixel. Bílá vzniká zapnutím všech třech na plnou jasnost, zatímco černá je jejich vypnutím.
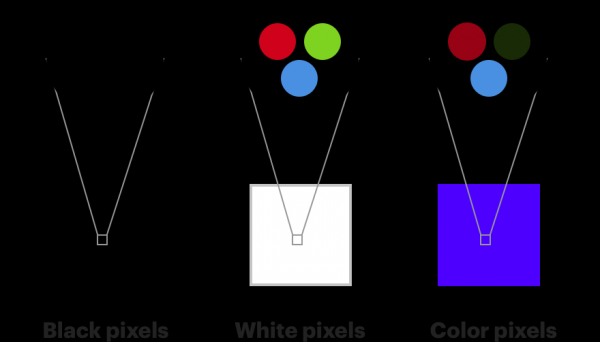
To je také velmi podobné fungování lidského oka. Barevné receptory našich očí se nazývají „«, a dělí se na tři typy, z nichž každý je více citlivý buď na červenou, zelenou nebo modrou barvu [S-typ čípků je citlivý na fialovo-modrém (S z anglického Short – krátkovlnný spektrum), M-typ – na zeleno-žlutém (M z anglického Medium – středněvlnný), a L-typ – na žluto-červeném (L z anglického Long – dlouhovlnný) části spektra. Přítomnost těchto tří typů čípků (a tyčinek, které jsou citlivé na smaragdově zelenou část spektra) dává člověku barevné vidění. / pozn. přev.]. , druhý typ fotoreceptorů v našich očích, je schopen zachycovat změny v jasnosti, avšak je mnohem citlivější na barvu. V našich očích je přibližně 120 milionů tyčinek a pouze 6 milionů čípků.
Proto naše oči mnohem lépe zaznamenávají změny v jasnosti, než změny v barvě. Pokud oddělíte barvu od jasnosti, můžete trochu barvy ubrat a nikdo si toho nevšimne. Barevná subdiskretizace je proces reprezentace barevných komponentů obrazu v nižším rozlišení ve srovnání s komponenty jasnosti. V uvedeném příkladu má každý pixel přesně jednu komponentu Y a každá jednotlivá skupina ze čtyř pixelů má přesně jednu komponentu Cb a jednu Cr. Proto obrázek obsahuje čtyřikrát méně barevných informací, než měl originál.
Barevný prostor YCbCr se používá nejen v JPEG. Byla původně vymyšlena v roce 1938 pro televizní vysílání. Ne všichni mají barevnou televizi, proto oddělení barvy a jasnosti umožnilo všem přijímat stejný signál, a televize bez barev používala pouze komponentu jasnosti.
Proto odstranění jednoho čísla z editoru úplně zničí všechny barvy. Komponenty jsou uloženy ve formátu Y Y Y Y Cb Cr (ve skutečnosti nemusí být v tomto pořadí – pořadí uložení je určeno v hlavičce souboru). Odstranění prvního čísla způsobí, že první hodnota Cb bude vnímána jako Y, Cr jako Cb, a v celkovém efektu dojde k domino efektu, který přepíná všechny barvy obrázku.
Specifikace JPEG vás nenutí používat YCbCr. Ale ve většině souborů se používá, protože poskytuje obrázky lepší kvality po subdiskretizaci ve srovnání s RGB. Ale nemusíte mi věřit na slovo. Podívejte se sami v tabulce níže, jak bude vypadat subdiskretizace každé jednotlivé složky jak v RGB, tak v YCbCr.
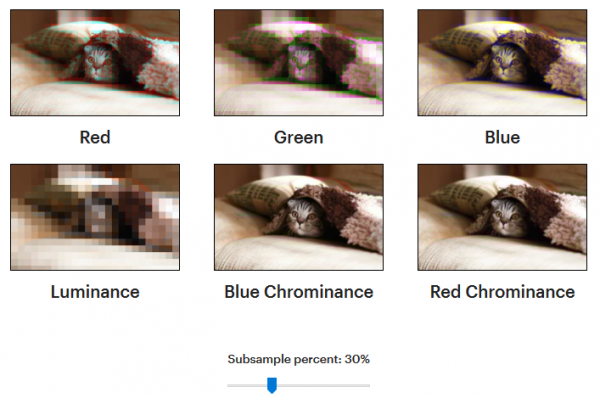
(Interaktivní verze – v články).
Odstranění modré není tak nápadné jako červené nebo zelené. Je to proto, že z šesti milionů čípků ve vašich očích je přibližně 64 % citlivých na červenou, 32 % na zelenou a 2 % na modrou.
Subdiskretizace složky Y (v levém dolním rohu) je nejvíce viditelná. I malá změna je patrná.
Převod obrázku z RGB na YCbCr nesnižuje velikost souboru, ale usnadňuje hledání méně nápadných detailů, které lze odstranit. Ztrátová komprese probíhá ve druhé fázi. Její myšlenka spočívá v prezentaci dat v komprimovatelnějším formátu.
2. Diskrétní kosinová transformace a diskretizace
Tato úroveň komprese do značné míry určuje podstatu JPEG. Po převedení barev na YCbCr se složky komprimují jednotlivě, takže se můžeme dále soustředit pouze na složku Y. A takto vypadají bajty složky Y po aplikaci této úrovně.
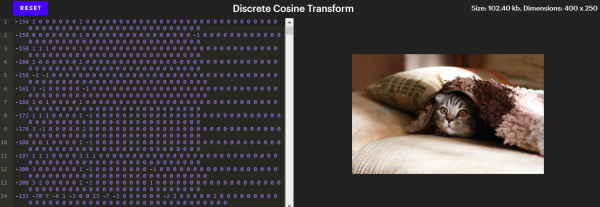
(Interaktivní verze – v články). V interaktivní verzi kliknutí na pixel posune editor na řádek, který jej označuje. Zkuste odstranit čísla na konci nebo přidat několik nul k určitému číslu.
Na první pohled to vypadá jako velmi špatná komprese. Na obrázku je 100 000 pixelů a pro označení jejich jasnosti (Y-složky) je potřeba 102 400 čísel – to je lepší než kdyby se nic nescompressovalo!
Všimněte si však, že většina těchto čísel je nulová. Navíc všechny tyto nuly na konci řádků lze odstranit, aniž by se změnil obrázek. Zůstává přibližně 26 000 čísel, což je téměř čtyřikrát méně!
Na této úrovni se skrývá tajemství šachovnicových vzorů. Na rozdíl od jiných efektů, které jsme viděli, se objevování těchto vzorů nedá považovat za glitch. Jsou to stavební bloky celého obrázku. V každém řádku editoru je přesně 64 čísel, koeficienty diskrétní kosinové transformace (DCT), odpovídající intenzitám 64 unikátních vzorů.
Tyto vzory se vytvářejí na základě kosinového grafu. Zde je, jak některé z nich vypadají:
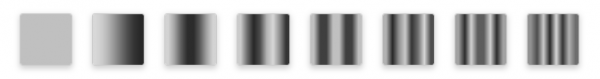
8 z 64 koeficientů
Níže je obrázek, který ukazuje všech 64 vzorů.
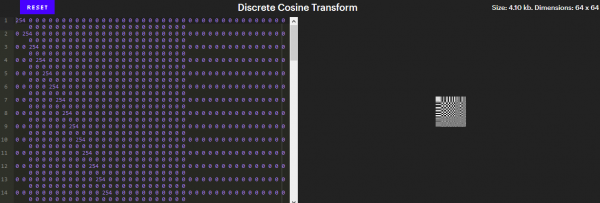
(Interaktivní verze – v články).
Tyto vzory mají zvláštní význam, neboť tvoří základ obrazů o velikosti 8x8. Pokud nejste obeznámeni s lineární algebrou, znamená to, že jakýkoli obraz o velikosti 8x8 lze získat z těchto 64 vzorů. DCT je proces rozdělování obrazů na bloky 8x8 a převodu každého bloku na kombinaci z těchto 64 koeficientů.
Že je možné sestavit jakýkoli obraz z 64 specifických vzorů, se zdá býti kouzlem. Nicméně to samé se dá říct o jakémkoli místě na Zemi – že lze popsat dvěma čísly – šířkou a délkou [s uvedením polokoulí / pozn. překl.]. Často považujeme povrch Země za dvourozměrný, takže nám stačí pouze dvě čísla. Obraz 8x8 má 64 rozměrů, proto potřebujeme 64 čísel.
Zatím není jasné, jak nám to pomáhá v kontextu komprese. Pokud potřebujeme 64 čísel k reprezentaci obrazu 8x8, proč by tento způsob měl být lepší než prostě uložit 64 komponentů jasu? Děláme to ze stejného důvodu, proč jsme převedli tři čísla RGB na tři čísla YCbCr: umožňuje nám to odstranit neznatelné detaily.
Je obtížné vidět, které konkrétní detaily jsou v tomto kroku odstraňovány, protože JPEG aplikuje DCT na bloky 8x8. Nicméně nám nikdo nebrání aplikovat ho na celý obrázek. Tady je, jak vypadá DCT na Y komponentě aplikovaném na celý obrázek:
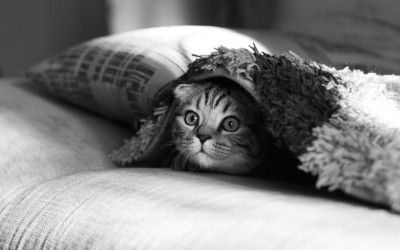
Z konce lze odstranit více než 60 000 čísel prakticky bez znatelné změny na fotografii.
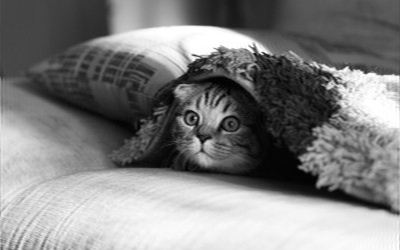
Však si povšimněte, že pokud bychom vynulovali prvních pět čísel, rozdíl by byl zřejmý.
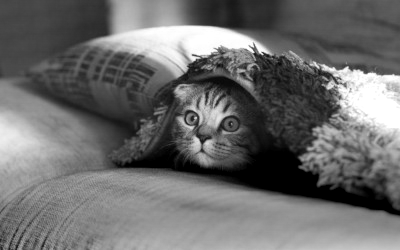
Čísla na začátku označují změny nízké frekvence v obraze, a naše oči je vnímají nejlépe. Čísla blíž k konci označují změny vysokých frekvencí, které jsou obtížnější postřehnout. Abychom "viděli to, co není vidět okem", můžeme izolovat tyto detaily vysoké frekvence vynulováním prvních 5000 čísel.
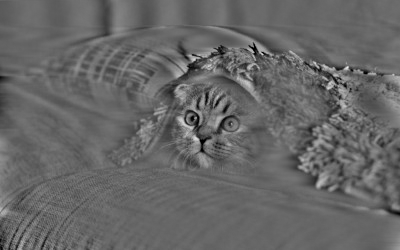
Vidíme všechny oblasti obrazu, kde k největším změnám dochází z pixelu na pixel. Vyzdvihují se oči kočky, její vousky, huňatý přehoz a stíny v levém dolním rohu. Můžeme pokračovat dál a vynulovat prvních 10 000 čísel:
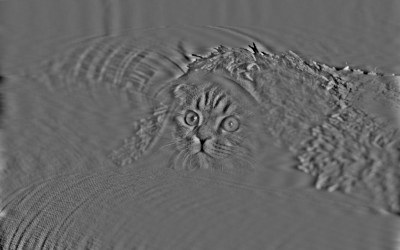
20 000:
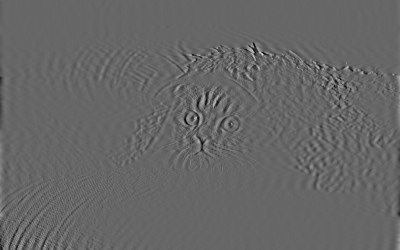
40 000:
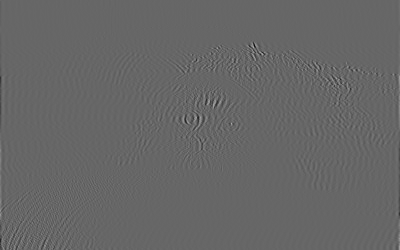
60 000:
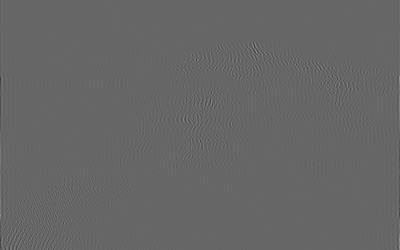
Tyto vysoko-frekvenční detaily JPEG se odstraňují ve fázi komprese. Převod barev na DCT koeficienty je bezztrátový. Ztráty vznikají ve fázi diskretizace, kde jsou odstraněny hodnoty vysoké frekvence nebo blízké nule. Když snížíte kvalitu ukládání JPEG, program zvyšuje práh počtu odstraňovaných hodnot, což vede k zmenšení velikosti souboru, ale dělá obrázek více pixelizovaným. Proto obrázek v první části, který byl 57krát menší, vypadal takto. Každý blok 8x8 byl reprezentován mnohem menším množstvím DCT koeficientů ve srovnání s kvalitnější verzí.
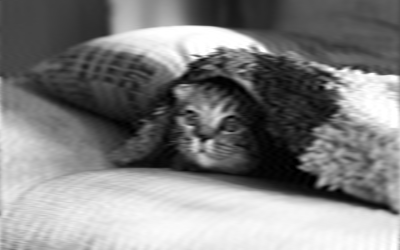
Můžete vytvořit úžasný efekt, jako je postupné streamování obrázků. Můžete zobrazit rozmazaný obrázek, který se stává stále podrobnějším, jak se stahuje čím dál více koeficientů.
Tady je, jen pro zajímavost, co se stane, když použijete pouze 24 000 čísel:
Nebo pouze 5000:
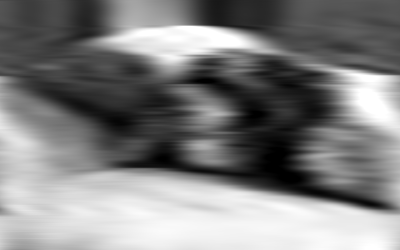
Hodně rozmazané, ale jaksi rozpoznatelné!
3. Kódování dlouhých sekvencí, delta a Huffman
Doposud všechny fáze komprese probíhaly se ztrátami. Poslední fáze, naopak, probíhá bezztrátově. Neodstraňuje informace, ale značně zmenšuje velikost souboru.
Jak můžete něco komprimovat, aniž byste odmítli informace? Představte si, jak bychom popsali jednoduchý černý obdélník 700 x 437.
JPEG k tomu používá 5000 čísel, ale lze dosáhnout mnohem lepšího výsledku. Můžete si představit kódovací schéma, které by popisovalo takový obrázek co nejmenším počtem bytů?
Nejmenší schéma, které jsem dokázal vymyslet, používá čtyři: tři k označení barvy a čtvrtý - kolik pixelů má takovou barvu. Myšlenka reprezentace opakujících se hodnot takto komprimovaným způsobem se nazývá kódování dlouhých sekvencí. Je bezztrátová, protože můžeme obnovit zakódovaná data do původní podoby.
Velikost JPEG souboru s černým obdélníkem je mnohem větší než 4 bajty – vzpomeňte si, že na úrovni DCT se komprese aplikuje na bloky 8x8 pixelů. Proto potřebujeme alespoň jeden DCT koeficient na každých 64 pixelech. Jeden potřebujeme, protože místo toho, abychom uchovávali jeden DCT koeficient, za nímž následuje 63 nul, kódování běhů nám umožňuje uchovat jedno číslo a označit, že „všechny ostatní – jsou nuly“.
Delta kódování je technika, při které každý bajt obsahuje rozdíl od určité hodnoty, a ne absolutní velikost. Proto úprava určitých bajtů změní barvu všech ostatních pixelů. Například místo uchovávání
12 13 14 14 14 13 13 14
Mohli bychom začít od 12 a pak jednoduše označovat, kolik je třeba přidat nebo odebrat, abychom získali další číslo. A tato sekvence v delta kódování získává podobu:
12 1 1 0 0 -1 0 1
Transformovaná data nejsou menší než původní, ale je snadnější je komprimovat. Aplikace delta kódování před kódováním běhů může výrazně pomoci, zatímco zůstává bezztrátovou kompresí.
Delta kódování je jednou z mála technik používaných mimo bloky 8x8. Z 64 DCT koeficientů je jeden – prostě konstantní vlnová funkce (jednotná barva). Reprezentuje průměrnou jasnost každého bloku pro jasnost komponenty, nebo průměrnou modrost pro komponenty Cb atd. První hodnota každého DCT bloku se nazývá DC hodnota, a každá DC hodnota prochází delta kódováním ve vztahu k předchozím. Proto změna jasnosti prvního bloku ovlivní všechny bloky.
Zůstává poslední záhada: jak změna jediného čísla zcela kazí celý obrázek? Dosud takové vlastnosti kompresních úrovní nebyly. Odpověď leží v hlavičce JPEG. Prvních 500 bajtů obsahuje metadata o obrázku – šířku, výšku atd., a pokud s nimi nepracujeme.
Bez hlavičky je prakticky nemožné (no, nebo velmi obtížné) dekódovat JPEG. Vypadalo by to, jako bych se vám snažil popsat obraz a začínal bych vymýšlet slova, abych předal svůj dojem. Popis bude pravděpodobně velmi zhuštěný, protože mohu vymýšlet slova pouze s tím významem, který chci předat, avšak pro všechny ostatní nedává smysl.
Zní to hloupě, ale právě tak to funguje. Každý obraz JPEG je komprimován pomocí kódů specifických pro něj. Slovník kódů se ukládá do hlavičky. Tato technika se nazývá „Huffmanův kód“ a slovník je Huffmanova tabulka. V hlavičce je tabulka označena dvěma bajty – 255 a poté 196. Každá barevná složka může mít svou vlastní tabulku.
Změny v tabulkách radikálně ovlivní každý obraz. Dobrým příkladem je změnit v 15. řádku 1 na 12.
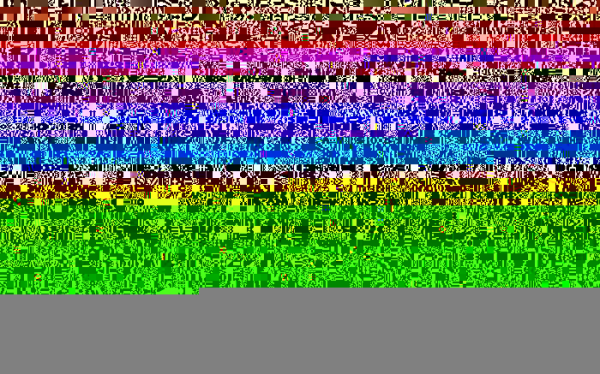
K tomu dochází, protože v tabulkách se uvádí, jak číst jednotlivé bity. Zatím jsme pracovali pouze s binárními čísly v desítkovém formátu. Ale to nám zakrývá skutečnost, že pokud chcete uložit číslo 1 v bajtu, bude vypadat jako 00000001, protože každý bajt musí mít přesně osm bitů, i když potřebujete pouze jeden.
Potenciálně to představuje velké plýtvání místem, pokud máte hodně malých čísel. Huffmanův kód je technika, která nám umožňuje uvolnit tuto podmínku, že každé číslo musí zabírat osm bitů. To znamená, že pokud vidíte dva bajty:
234 115
Pak, v závislosti na Huffmanově tabulce, to mohou být tři čísla. Abyste je extrahovali, musíte je nejprve rozdělit na jednotlivé bity:
11101010 01110011
Pak se obrátíme na tabulku, abychom pochopili, jak je seskupit. Například to mohou být první čtyři bity (111010), nebo 58 v desítkové soustavě, za nimiž následují čtyři bity (10011), nebo 19, a nakonec poslední čtyři bity (0011), nebo 3.
Proto je velmi obtížné se v bytech na této fázi komprese orientovat. Bajty nepředstavují to, co se zdá. Nebudu se v tomto článku zabývat detaily práce s tabulkou, ale o této tématice na internetu .
Jedním z zajímavých triků, které lze udělat, když to víte, je oddělit hlavičku od JPEG a uchovávat ji samostatně. V podstatě se ukáže, že soubor budete moci přečíst pouze vy. Facebook to dělá, aby ještě více snížil velikost souborů.
Co dalšího můžete udělat – trochu pozměnit Huffmanovu tabulku. Pro ostatní to bude vypadat jako poškozený obrázek. A jen vy budete vědět kouzelnou variantu její opravy.
Shrňme to: co potřebujete k dekódování JPEG? Je nutné:
- Extrahovat Huffmanovu tabulku (tabulky) z hlavičky a dekódovat bity.
- Vyjměte koeficienty diskrétní kosinové transformace pro každou komponentu barvy a jasu pro každý blok 8x8 provedením inverzních transformací kódování dlouhých sekvencí a delta.
- Kombinujte kosinové hodnoty na základě koeficientů pro získání hodnot pixelů pro každý blok 8x8.
- Škaluje komponenty barev, pokud probíhala subdiskretizace (tato informace je obsažena v hlavičce).
- Převést získané hodnoty YCbCr pro každý pixel na RGB.
- Zobrazte obrázek na obrazovce!
Závažná práce pro jednoduché prohlížení fotky s kočkou! Avšak, co se mi na tom líbí – je vidět, jak je technologie JPEG orientována na člověka. Je založena na specifikách našeho vnímání, což umožňuje dosáhnout mnohem lepšího kompresního poměru než běžné technologie. A nyní, když chápeme, jak JPEG funguje, můžeme si představit, jak by tyto technologie mohly být přeneseny do jiných oblastí. Například delta-kódování ve videu může vážně zmenšit velikost souboru, protože existují často celé oblasti, které se nemění z rámce na rámec (například pozadí).
, je otevřený a obsahuje pokyny pro výměnu obrázků za vaše vlastní.
Zdroj: habr.com
