

Úvod
Přišel čas koupit úložiště. Které vybrat, koho poslouchat? Dodavatel A vysvětluje dodavatele B, a také je tu integrátor C, který říká opak a doporučuje dodavatele D. V takové situaci se i zkušenému architektu systémů ukládání může zamotat hlava, obzvlášť s všemi novými dodavateli a dnes populárními SDS a hyperkonvergencí.
Jak se v tom všem vyznat a nezůstat hloupý? My ( Anton Žbankov a Evgenij Elizarov) se to pokusíme vysvětlit jasně a srozumitelně.
Článek se do značné míry překrývá a v podstatě je rozšířením “” v oblasti výběru systémů ukládání dat a přehledu technologií systémů ukládání. Krátce probereme obecnou teorii, ale doporučujeme se také seznámit s uvedeným článkem.
Proč
Často lze pozorovat situaci, kdy nový člověk na fóru nebo ve specializovaném chatu, jako je třeba Storage Discussions, položí otázku: “nabízejí mi dvě varianty úložiště — ABC SuperStorage S600 a XYZ HyperOcean 666v4, co doporučíte?”
A začne se měřit, kdo má jaké zvláštní vlastnosti realizace strašidelných a nepochopitelných funkcí, které pro nepřipraveného člověka zcela vypadají jako čínské písmo.
Takže klíčová a první otázka, kterou si musíte položit dlouho před porovnáváním specifikací v komerčních nabídkách — PROČ? Proč je toto úložiště potřeba?
Odpověď bude překvapivá a velmi ve stylu Tonyho Robbins — abychom ukládali data. Díky, kapitáne! A přesto někdy tak hluboce zabředáme do porovnávání detailů, že zapomínáme, proč to všechno vlastně děláme.
Takže úlohou systému ukládání dat je ukládat a poskytovat přístup k DATŮM s požadovaným výkonem. Od těchto dat také začneme.
Údaje
Typ dat
Jaká data plánujeme ukládat? Velmi důležitá otázka, která může vyřadit mnoho úložišť z dalšího zvažování. Například plánujeme ukládání videozáznamů a fotografií. Okamžitě můžeme vyřadit systémy určené pro náhodný přístup k malým blokům, nebo systémy s proprietárními funkcemi komprese / deduplikace. Tyto systémy mohou být skvělé, nechceme na nich nic zlé říct. Ale v tomto případě jejich silné stránky se stanou naopak slabými (video a fotografie se nekomprimují) nebo výrazně zvýší náklady na systém.
A naopak, pokud je cílové použití zatížená transakční databáze, pak skvělé streamovací systémy pro multimédia, schopné vyoutputovat gigabyty za sekundu, budou špatnou volbou.
Objem dat
Kolik dat plánujeme ukládat? Množství se vždy přetváří v kvalitu, na to bychom neměli nikdy zapomínat, zvlášť v naší době exponenciálního růstu objemu dat. Systémy petabajtové třídy již nejsou vzácností, ale čím více petabajtů objemu, tím specifickejší systém se stává, a tím méně obvyklé funkcionality systémů s náhodným přístupem malého a středního objemu bude dostupné. Prostě proto, že pouze tabulky statistiky přístupu po blocích se stávají většími než dostupné množství operační paměti na řadičích. Nemluvě o kompresi / tieringu. Předpokládejme, že chceme přepnout algoritmus komprese na výkonnější a zkomprimovat 20 petabajtů dat. Kolik to zabere: půl roku, rok?
Na druhou stranu, proč stavět továrnu, pokud je třeba ukládat a zpracovávat 500 GB dat? Pouze 500. Spotřebitelské SSD (s nízkým DWPD) takového objemu stojí jen pár korun. Proč k tomu stavět Fiber Channel a kupovat externí úložiště vysoké třídy za cenu železného mostu?
Jaký podíl z celkového objemu představují horká data? Jak nerovnoměrné je zatížení podle objemu dat? Právě zde může velmi pomoci technologie vícestupňového ukládání nebo Flash Cache, pokud je objem horkých dat zanedbatelný v porovnání s celkovým. Naopak, při rovnoměrnějším zatížení v celém objemu, což je běžné v streamovacích systémech (kamerové sledování, některé analytické systémy), tyto technologie nic nepřinesou a jen zvýší náklady / složitost systému.
IS
Opačná strana dat je informační systém, který tato data používá. IS má soubor požadavků, které jsou odvozeny od dat. Podrobněji o IS viz "Návrh virtualizovaného datového centra".
Požadavky na odolnost vůči poruchám / dostupnost
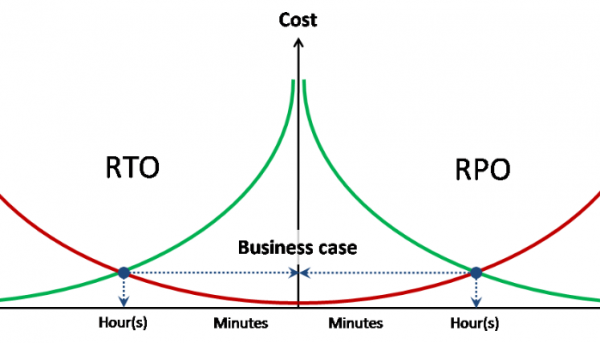
Požadavky na odolnost vůči poruchám / dostupnost dat jsou odvozeny od IS, který je využívá, a vyjadřují se třemi číslicemi — RPO, RTO, dostupnost.
Dostupnost — podíl za dané časové období, během kterého jsou data dostupná pro práci s nimi. Obvykle se vyjadřuje v počtu devítek. Například dvě devítky za rok znamenají, že dostupnost je 99 %, tedy je přípustných 95 hodin nedostupnosti ročně. Tři devítky — 9,5 hodiny za rok.
RPO / RTO — to jsou ukazatele nesouhrnné, ale pro každou událost (havárii), na rozdíl od dostupnosti.
RPO — objem dat ztracených při havárii (v hodinách). Například, pokud se zálohování provádí jednou za den, pak RPO = 24 hodin. Tedy při havárii a úplné ztrátě úložného systému mohou být ztracena data až do objemu 24 hodin (od okamžiku zálohy). Na základě stanoveného RPO pro IS se například vytváří pravidlo pro zálohování. Také na základě RPO lze pochopit, jak moc je potřeba synchronní / asynchronní replikace dat.
RTO — doba obnovení služby (přístupu k datům) po havárii. Na základě stanovené hodnoty RTO můžeme posoudit, zda je potřebný metroklastor, nebo zda postačuje jednosměrná replikace. Je také potřeba vyhodnotit, zda je nutný vícestupňový úložný systém vyšší třídy.
Požadavky na výkon
I když se jedná o zcela zřejmou otázku, právě s ní vzniká většina potíží. V závislosti na tom, zda již máte nějakou infrastrukturu, nebo ne, se budou budovat cesty k získání nezbytné statistiky.
Máte již úložné zařízení a hledáte jeho náhradu, nebo chcete zakoupit další pro rozšíření. Zde je to jednoduché. Chápete, jaké služby již máte a jaké plánujete zavést v blízké budoucnosti. Na základě aktuálních služeb máte možnost shromáždit statistiku výkonnosti. Musíte se rozhodnout pro aktuální počet IOPS a současné latence — jaké jsou tyto hodnoty a zda jsou dostatečné pro vaše úkoly? To lze zjistit jak na samotném úložném systému, tak na hostitelích, které k němu jsou připojeny.
Je třeba se dívat nejen na aktuální zátěž, ale i na nějaké období (nejlépe měsíc). Podívejte se na to, jaké jsou maximální vrcholy ve dne, jakou zátěž vytváří zálohování atd. Pokud vaše úložné zařízení nebo software k němu neposkytuje kompletní sadu těchto dat, můžete využít bezplatný RRDtool, který dokáže pracovat s většinou nejpopulárnějších úložných zařízení a switchů a poskytne vám podrobné statistiky o výkonnosti. Také je dobré sledovat zátěž na hostitelích, které pracují s tímto úložným zařízením, konkrétně podle virtuálních strojů nebo podle toho, co přesně na daném hostiteli běží.
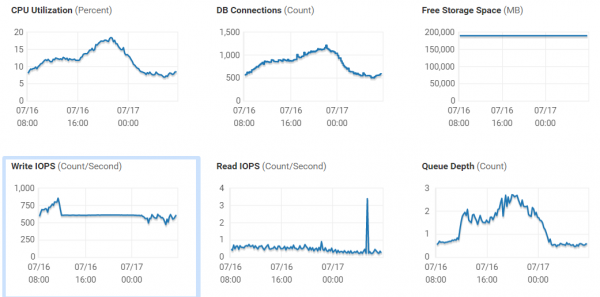
Je třeba vyzdvihnout, že pokud se latence na svazku a datastoru, který se nachází na tomto svazku, výrazně liší — měli byste se zaměřit na svou SAN síť, je vysoká pravděpodobnost, že s ní jsou problémy, a než zakoupíte nový systém, stojí za to se tímto problémem zabývat, protože je velmi pravděpodobné, že zvýšíte výkon aktuálního systému.
Budujete infrastrukturu od nuly, nebo kupujete systém pro nějakou novou službu, o které nevíte, jaké bude zatížení. Zde je několik možností: promluvit si s kolegy na specializovaných zdrojích, abyste se pokusili zjistit a předpovědět zátěž, obrátit se na integrátora, který má zkušenosti s implementací podobných služeb a který vám může vypočítat zatížení. A třetí možnost (obvykle nejnáročnější, zejména pokud se jedná o vlastní nebo vzácné aplikace) se pokusit zjistit výkonové požadavky u vývojářů systému.
A, a dávejte pozor, nejvhodnější variantou z pohledu praktického použití je pilot na aktuálním zařízení nebo zařízení poskytnutém k testování dodavatelem / integrátorem.
Speciální požadavky
Speciální požadavky zahrnují vše, co nespadá pod požadavky na výkon, odolnost a funkčnost při zpracování a poskytování dat.
Jedním z nejjednodušších speciálních požadavků na systém ukládání dat lze nazvat „odstranitelné informační nosiče“. Je zřejmé, že tento systém ukládání dat musí zahrnovat páskovou knihovnu nebo prostě streamera, na který se ukládá záloha. Poté speciálně vyškolený člověk podepíše pásek a hrdě ho nese do speciální trezoru.
Dalším příkladem speciálního požadavku je ochrana proti nárazům.
Kde
Druhým hlavním faktorem při výběru konkrétního SŘD je informace o tom, KDE bude toto SŘD umístěno. Od geografických nebo klimatických podmínek až po personál.
Objednatel
Pro koho je tento SŘD plánován? Otázka má následující opodstatnění:
Státní objednatel / komerční.
Komerční objednatel nemá žádná omezení a ani není povinen vyhlašovat veřejné soutěže, kromě vlastních interních předpisů.
Státní objednatel – to je jiná záležitost. 44. zákon a další výhody s tendry a technickými specifikacemi, které mohou být napadnuty.
Objednatel pod sankcemi
Tady je otázka velmi jednoduchá – výběr je omezen pouze na nabídky dostupné pro tohoto objednatele.
Interní předpisy / povolení k nákupu od dodavatelů / modely
Otázka je také velmi jednoduchá, ale je potřeba ji mít na paměti.
Kde fyzicky
V této části zkoumáme všechny otázky týkající se geografie, komunikačních kanálů a mikroklimatu v místnosti, kde je systém umístěn.
Personál
Kdo bude pracovat s tímto SŘD? To je stejně důležité, jako to, co SŘD skutečně umí.
Ať je SŘD od dodavatele A jakkoli perspektivní, skvělé a úžasné, nedává smysl ji nasazovat, pokud personál umí pracovat pouze s dodavatelem B a další nákupy a trvalá spolupráce s A se neplánují.
A samozřejmě, další otázka je, jak dostupný je kvalifikovaný personál přímo v dané společnosti a potenciálně na trhu práce v této geografické oblasti. Pro regiony může mít velký význam výběr TZS s jednoduchými rozhraními nebo možností vzdáleného centrálního řízení. Jinak se může v určitém okamžiku stát nesmírně bolestivé. Internet je plný příběhů o tom, jak nový zaměstnanec, včerejší student, nastavoval něco tak, že celá firma zkolabovala.
Prostředí
No a samozřejmě je důležitá otázka — v jakém prostředí bude tato TZS fungovat.
- Co s napájením / chlazením?
- Jaké připojení
- Kam bude nainstalována
- A tak dále.
Často jsou tyto otázky považovány za samozřejmé a není jimi zvlášť zabýváno, ale někdy právě tyto otázky mohou všechno převrátit naruby.
Co
dodavatel
K dnešnímu dni (polovina roku 2019) lze ruský trh TZS rozdělit do přibližně 5 kategorií:
- První divize — zavedené společnosti s širokou nabídkou od nejjednodušších diskových polí po hi-end (HPE, DellEMC, Hitachi, NetApp, IBM / Lenovo)
- Druhá divize — společnosti s omezeným sortimentem, nišoví hráči, vážní prodejci SDS nebo nováčci (Fujitsu, Datacore, Infinidat, Huawei, Pure atd.)
- Třetí divize — nišová řešení nízké úrovně, levný SDS, DIY řešení na ceph a jiných otevřených projektech (Infortrend, Starwind atd.)
- SOHO segment — malé a super malé TZS na úrovni domácnost / malá kancelář (Synology, QNAP atd.)
- Importované TZS — sem spadají jak hardware první divize s přelepenými etiketami, tak vzácní zástupci druhé (RAIDIX, dáme jim kredit za druhou), ale většinou to je třetí divize (Aerodisk, Baum, Depo atd.)
Rozdělení je dost podmíněné a rozhodně neznamená, že třetí nebo SOHO segmenty jsou špatné a nelze je používat. V specifických projektech s jasně definovaným souborem dat a profilem zatížení mohou fungovat velmi dobře, daleko překonávající první divizi co do poměru cena/kvalita. Je důležité nejprve si ujasnit úkoly, perspektivy růstu, potřebnou funkcionalitu — a pak vám Synology bude sloužit věrně, a vlasy budou jemné a hedvábné.
Jedním z důležitých faktorů při výběru dodavatele je aktuální prostředí. Kolik a jaké úložiště máte již k dispozici, s jakými systémy dokážou vaši inženýři pracovat. Potřebujete dalšího dodavatele, další kontaktní osobu, nebo budete postupně migrovat veškerou zátěž z dodavatele A na dodavatele B?
Není třeba vytvářet entity nad rámec nutnosti.
iSCSI / FC / File
O problematice přístupových protokolů neexistuje jednotný názor mezi inženýry, a spory připomínají spíše teologické diskuse než inženýrské. Obecně lze však uvést následující body:
FCoE je spíše mrtvá než živá.
FC vs iSCSI. Jednou z klíčových výhod FC v roce 2019 oproti IP úložištím, vyhrazené síti pro přístup k datům, je vyvážena vyhrazenou IP sítí. Globální výhody FC oproti IP sítím neexistují a na IP lze budovat úložiště jakékoliv úrovně zátěže, včetně systémů pro těžké databázové aplikace pro velkou banku. Na druhé straně se FC nevydalo nahoru již několik let, ale stále mu něco brání. Například dnes někteří hráči na trhu úložišť aktivně rozvíjejí standard NVMEoF. Rozdělí se osud FCoE - ukáže čas.
Soubory přístup také není nic, co by stálo za ignoraci. NFS / CIFS se skvěle osvědčují v produktivních prostředích a při správném návrhu mají stejně málo výhrad jako blokové protokoly.
Hybridní / All Flash Array
Klasická úložiště jsou dvou typů:
- AFA (All Flash Array) - systémy optimalizované pro použití SSD.
- Hybridní - umožňují používání jak HDD, tak SSD nebo jejich kombinaci.
Hlavním rozdílem je podpora technologií pro efektivitu ukládání a maximální úroveň výkonu (vysoké hodnoty IOPS a nízké latence). Obě systémy (ve většině svých modelů, s výjimkou low-end segmentu) mohou fungovat jako bloková zařízení i jako souborová. Úroveň systému určuje podporovanou funkcionalitu, která je u nižších modelů často omezena na minimální úroveň. Na to je třeba brát zřetel při studiu specifikací konkrétního modelu, nikoli pouze možností celé řady jako celku. Také samozřejmě od úrovně systému závisí jeho technické charakteristiky, jako jsou procesor, objem paměti, cache, počet a typy portů atd. Z pohledu správy však AFA od hybridních (diskových) systémů liší pouze v otázkách implementace mechanismů práce se SSD disky, a i když používáte SSD v hybridním systému, neznamená to, že dosáhnete úrovně výkonu jako u AFA systému. Také ve většině případů jsou inline mechanismy efektivního ukládání v hybridních systémech vypnuté a jejich aktivace vede ke ztrátě výkonu.
Speciální SDD
Kromě SDD pro obecné účely, orientovaných především na operativní zpracování dat, existují speciální SDD s klíčovými principy, které se zásadně liší od běžných (nízká latence, mnoho IOPS):
Média.
Tyto systémy jsou určeny pro ukládání a zpracování mediálních souborů, které se vyznačují velkým rozměrem. Odpovídající latence se stává téměř nepodstatnou, a na přední místo se dostává schopnost odesílat a přijímat data širokým pásmem ve více paralelních tocích.
Deduplikační SDD pro zálohy.
Protože zálohy se v běžných podmínkách liší minimální podobností (průměrná záloha se od včerejší liší o 1-2 %), je tato třída systémů extrémně efektivní při balení uložených dat na poměrně malém množství fyzických médií. Například, v některých případech mohou dosahovat koeficienty komprese dat až 200:1.
Objektové SDD.
V těchto úložných systémech neexistují obvyklé svazky s blokovým přístupem a sdílené soubory, spíše připomínají obrovskou databázi. Přístup k objektu uloženému v takovém systému se realizuje podle jedinečného identifikátoru nebo podle metadat (například všechny objekty formátu JPEG, vytvořené mezi XX-XX-XXXX a YY-YY-YYYY).
Compliance systémy.
Dnes se v Rusku nevyskytují tak často, ale zmínit je stojí za to. Účelem takových úložných systémů je garantované ukládání dat, které odpovídá bezpečnostním politikám nebo požadavkům regulátorů. V některých systémech (například EMC Centera) byla implementována funkce zákazu mazání dat — jakmile je klíč otočen a systém přešel do tohoto režimu, ani administrátor, ani nikdo jiný fyzicky nemohou smazat již uložená data.
Patentované technologie
Flash cache
Flash Cache je obecný název pro všechny patentované technologie používání flash paměti jako druhé úrovně cache. Při používání flash cache se obvykle počítá tak, aby se vyrovnala zátěž z magnetických disků, zatímco vrcholová zátěž je obsluhována cache.
Přitom je nutné chápat profil zátěže a míru lokalizace požadavků na bloky úložných svazků. Flash cache je technologie pro zátěže s vysokou lokalizací požadavků a je prakticky neaplikovatelná pro rovnoměrně zatížené svazky (například pro analytické systémy).
Na trhu jsou k dispozici dvě realizace flash cache:
- Read Only. V tomto případě se ukládají pouze data pro čtení, zatímco zápis probíhá přímo na disky. Někteří výrobci, jako například NetApp, tvrdí, že zápis na jejich úložných systémech probíhá optimálně, a cache nijak nepomůže.
- Read/Write. Ukládá se nejen čtení, ale i zápis, což umožňuje bufferovat proud a snížit vliv RAID penalizace, a tím zvýšit celkový výkon pro úložné systémy s méně optimálním mechanizmem zápisu.
Tiering
Víceúrovňové ukládání (tiering) je technologie spojování různých úrovní diskových jednotek s rozdílným výkonem do jednotného diskového poolu, jako například SSD a HDD. V případě výrazné nerovnoměrnosti přístupů k blokům dat bude systém schopen automaticky vyvážit bloky dat, přičemž zatížené přesune na vysoce výkonnou úroveň, a chladné na pomalejší.
Hybridní systémy nižších a středních tříd využívají vícestupňové ukládání s přemísťováním dat mezi úrovněmi podle plánu. Velikost bloku vícestupňového ukládání u nejlepších modelů dosahuje 256 MB. Tyto vlastnosti neumožňují považovat technologii vícestupňového ukládání za technologii zvyšování výkonu, jak si mnozí mylně myslí. Vícestupňové ukládání v systémech nižší a střední třídy je technologií optimalizace nákladů na ukládání pro systémy s výraznou nerovnoměrností zatížení.
Snímek
Kolik bychom o spolehlivosti úložišť neřekli, existuje mnoho možností, jak ztratit data, které nezávisí na hardwarových problémech. Může to být virus, hacker nebo jakékoliv jiné neúmyslné smazání/poškození dat. Z tohoto důvodu je zálohování produktivních dat nedílnou součástí práce inženýra.
Snapshot je snímek svazku v určitém okamžiku. Při práci většiny systémů, jako je virtualizace, databáze atd. potřebujeme pořídit takový snímek, ze kterého budeme kopírovat data do zálohy, zatímco naše IS mohou bez obav pokračovat v práci s tímto svazkem. Ale je třeba si uvědomit, že ne všechny snímky jsou stejně užitečné. Různí dodavatelé mají různé přístupy k vytvoření snímků, které souvisejí s jejich architekturou.
CoW (Copy-On-Write). Při pokusu o zápis bloku dat se jeho původní obsah zkopíruje do speciální oblasti, po které probíhá zápis normálně. Tímto se zabrání poškození dat uvnitř snímku. Samozřejmě všechny tyto "parazitní" manipulace s daty způsobují dodatečné zatížení úložiště a z tohoto důvodu dodavatelé s podobnou realizací nedoporučují používat více než deset snímků a na vysoce zatížených svazcích je vůbec nepoužívat.
RoW (Redirect-on-Write). V tomto případě je původní svazek přirozeně zmražen, a při pokusu o zápis bloku dat úložiště zapisuje data do speciální oblasti v volném prostoru, mění umístění tohoto bloku v tabulce metadat. To umožňuje snížit počet přepisovacích operací, což nakonec neutralizuje pokles výkonu a odstraňuje omezení na snímky a jejich množství.
Snapshots exist in two types concerning applications:
Aplikace konzistentní. Při vytváření snapshotu úložiště vyžaduje agenta v operačním systému klienta, který nuceně zároveň vyprázdní diskové cache z paměti na disk a přinutí aplikaci to udělat. V tomto případě budou data při obnovení ze snapshotu konzistentní.
Konsistentní havarijní. V tomto případě k ničemu podobnému nedochází a snapshot se vytváří tak, jak je. Při obnovení z takového snapshotu je situace stejná, jako kdyby došlo k náhlému výpadku napájení a může dojít k nabytí některých dat, která byla v cache a nestihla se dostat na disk. Takové snapshoty jsou jednodušší na realizaci a nezpůsobují pokles výkonu aplikací, ale jsou méně spolehlivé.
Proč jsou snapshoty potřebné v systémech pro ukládání dat?
- Bezagentní zálohování přímo z úložiště
- Vytváření testovacích prostředí na základě reálných dat
- V případě sdílených úložišť lze využít pro vytváření prostředí VDI pomocí snapshotů úložiště místo hypervisoru
- Zajištění nízkých RPO vytvářením snapshotů v plánovaných intervalech mnohem častěji, než je frekvence zálohování
Klonování
Klonování objemu funguje na podobném principu jako snapshoty, ale slouží nejen pro čtení dat, ale pro plnohodnotnou práci s nimi. Máme možnost získat přesnou kopii našeho objemu se všemi daty na něm, aniž bychom vytvářeli fyzickou kopii, což umožní ušetřit místo. Klonování objemů se obvykle používá v Test&Dev nebo pokud chcete zkontrolovat funkčnost nějakých aktualizací ve vašem IS. Klonování to umožní udělat co nejrychleji a ekonomicky z hlediska diskových zdrojů, protože budou zapsány pouze změněné bloky dat.
Replikace / žurnálování
Replikace je mechanismus pro vytváření kopií dat na jiném fyzickém úložišti. Obvykle existuje proprietární technologie od každého dodavatele, která funguje pouze v rámci jeho vlastní řady. Existují však i třetí strany, které fungují, včetně těch, které operují na úrovni hypervisoru, jako například VMware vSphere Replication.
Funkcionalita proprietárních technologií a jejich snadnost použití obvykle výrazně převyšují univerzální, ale jsou nevhodné, když například potřebujete provést replikaci z NetApp na HP MSA.
Replikace se dělí na dva podtypy:
Synchronní. Při synchronní replikaci je operace zápisu okamžitě přenesena na druhé úložiště a není potvrzena, dokud vzdálené úložiště nepotvrdí úspěšné provedení. Tím se zvyšuje latence přístupu, ale máme přesnou zrcadlovou kopii dat. Tedy RPO = 0 v případě ztráty hlavního úložiště.
Asynchronní. Zápisové operace se provádějí pouze na hlavním úložišti a jsou okamžitě potvrzeny, zatímco se hromadí v paměti pro dávkový přenos na vzdálené úložiště. Tento typ replikace je relevantní pro méně cenná data, nebo pro kanály s nízkou propustností či s vysokou latencí (typické pro vzdálenosti přes 100 km). Odpovídající RPO odpovídá frekvenci dávkového odesílání.
Často existuje vedle replikace také mechanismus žurnalizace diskových operací. V tomto případě je vyhrazen zvláštní prostor pro žurnalizaci a uchovávají se zápisové operace určité hloubky v čase, nebo omezené objemem žurnálu. Pro některé proprietární technologie, jako je například EMC RecoverPoint, existuje integrace se systémovým softwarem, která umožňuje připojit konkrétní záložky k určitému zápisu v žurnálu. Díky tomu je možné vrátit stav svazku (nebo vytvořit klon) nejen na 23. dubna ve 11 hodin 59 minut 13 milisekund, ale na okamžik těsně před „DROP ALL TABLES; COMMIT“.
Metro cluster
Metro cluster je technologie, která umožňuje vytvořit obousměrnou synchronní replikaci mezi dvěma úložišti tak, že tato dvojice vypadá jako jedno úložiště. Používá se k vytvoření clusterů s geograficky vzdálenými rameny na metro-vzdálenostech (méně než 100 km).
Při použití v prostředí virtualizace umožňuje metrocluster vytvořit datastore s virtuálními stroji, který je možné zapisovat přímo z obou datových center. V tomto případě se vytváří cluster na úrovni hypervisorů, sestávající z hostitelů v různých fyzických datových centrech, připojený k tomuto datastore. To umožňuje následující:
- Plná automatizace procesu obnovy po havárii jednoho z datových center. Bez jakýchkoliv dodatečných prostředků budou všechny VM, které pracovaly v mrtvém datovém centru, automaticky restartovány v zbývajícím. RTO = časový limit clusteru vysoké dostupnosti (15 sekund pro VMware) + čas potřebný k načtení operačního systému a spuštění služeb.
- Vyhýbání se haváriím. Pokud jsou plánovány práce na napájení v datovém centru 1, máme možnost migrovat celou důležitou zátěž do datového centra 2 bez přerušení, a to ještě před zahájením prací.
Virtualizace
Virtualizace SDD — to je technicky využití objemů z jiné SDD jako disků. SDD-virtualizátor může jednoduše přesměrovat cizí objem k uživateli jako svůj, navíc ho zrcadlíc na další SDD, nebo dokonce vytvořit RAID z externích objemů.
Klasické příklady ve třídě virtualizace SDD — to jsou EMC VPLEX a IBM SVC. A samozřejmě SDD s funkcí virtualizace — NetApp, Hitachi, IBM / Lenovo Storwize.
K čemu to může být potřebné?
- Zálohování na úrovni SDD. Vytváří se zrcadlo mezi objemy, přičemž jedna polovina může být na HP 3Par a druhá na NetApp. A virtualizátor od EMC.
- Přenos dat s minimálním výpadkem mezi SDD různých výrobců. Představme si, že data je třeba migrovat ze starého 3Par, který půjde k vyřazení, na nový Dell. V tomto případě se spotřebitelé odpojí od 3Par, objemy se přesměrují pod VPLEX a znovu se prezentují spotřebitelům. Protože se na objemu nezměnilo ani bit, práce pokračuje. Na pozadí se spouští proces zrcadlení objemu na nový Dell, a po dokončení se zrcadlo rozbije a 3Par se odpojí.
- Organizace metroclusterů.
Komprese / deduplikace
Komprese a deduplikace — to jsou technologie, které vám umožňují šetřit diskový prostor na vaší SDD. Je třeba hned poznamenat, že ne všechna data podléhají kompresi a/nebo deduplikaci, zároveň některé typy dat se komprimují a deduplikují lépe, zatímco jiné naopak.
Komprese a deduplikace jsou dvou typů:
Inline — komprese a deduplikace bloků dat probíhá před jejich zápisem na disk. Tímto způsobem systém pouze spočítá hash bloku a porovná jej v tabulce s už existujícími. Za prvé, toto se provádí rychleji než pouhý zápis na disk, a za druhé, neplýtváme dalším diskovým prostorem.
Post — když tyto operace probíhají na již zapsaných datech, která se nacházejí na discích. Odpovídajícím způsobem jsou data nejprve zapsána na disk a teprve poté se počítá hash a dochází k odstranění nadbytných bloků a uvolnění diskových zdrojů.
Je třeba říci, že většina dodavatelů používá oba typy, což umožňuje optimalizovat tyto procesy a tím zvýšit jejich efektivitu. Většina dodavatelů SÚS má k dispozici nástroje, které umožňují analyzovat vaše datové sady. Tyto nástroje fungují na stejné logice, která je implementována také v SÚS, a proto bude odhadovaný úroveň efektivity shodná. Také bychom neměli zapomínat, že mnozí dodavatelé mají programy záruky efektivity, které slibují úroveň ne nižší, než je uvedeno pro určitý (nebo všechny) typy dat. A neměli bychom podceňovat tento program, protože při kalkulaci systému pro své úkoly, s ohledem na koeficient efektivity konkrétního systému, můžete ušetřit na objemu. Je také třeba mít na paměti, že tyto programy jsou navrženy pro AFA systémy, ale díky nákupu menšího objemu SSD než HDD v klasických systémech, to umožní snížit jejich cenu, a pokud se nevyrovnají ceně diskového systému, tak se k ní přiblíží poměrně silně.
Model
A zde se dostáváme k správně položené otázce.
“Nabízejí mi dva varianty SÚS — ABC SuperStorage S600 a XYZ HyperOcean 666v4, co byste doporučil?”
Převádí se na “Nabízejí mi dva varianty SÚS — ABC SuperStorage S600 a XYZ HyperOcean 666v4, co byste doporučil?
Cílová zátěž smíšené virtuální stroje VMware s konturami produkce / testování / vývoje. Test = produkčnímu. 150 TB na každý s vrcholovou výkonem 80 000 IOPS s blokem 8kb 50% náhodného přístupu 80/20 čtení-zápis. 300 TB na vývoj, tam 50 000 IOPS bude stačit, 80 náhodný, 80 zápis.
Producent předpokládaně v metroklastru RPO = 15 minut RTO = 1 hodina, vývoj v asynchronní replikaci RPO = 3 hodiny, test na jednom místě.
Bude 50 TB databáze, bylo by dobré mít pro ně logging.
Máme všude servery Dell, staré úložiště Hitachi, jen tak tak zvládají, plánujeme růst o 50 % zátěže na objemu a výkonu.
Jak se říká, ve správně formulované otázce je 80 % odpovědi.
Další informace
S čím by se mělo dále seznámit podle autorů.
Knihy
- Olífer a Olifer „Počítačové sítě“. Kniha pomůže systematizovat a možná lépe pochopit, jak funguje prostředí přenosu dat pro IP / Ethernet systémů úložiště.
- „EMC Information Storage and Management“. Skvělá kniha o základech úložišť, proč, jak a proč.
Fóra a chaty
Obecná doporučení
Ceny
Pokud jde o ceny — obecně se ceny úložišť, pokud se objeví, obvykle jedná o doporučené maloobchodní ceny, ze které každý zákazník dostává individuální slevu. Velikost slevy se skládá z mnoha parametrů, takže předpovědět, jakou koncovou cenu dostane právě vaše společnost, bez dotazu k distributorovi je prostě nemožné. Nicméně v poslední době se modely low-end objevují v běžných počítačových obchodech, jako například. nebo . V nich lze okamžitě zakoupit zajímavý systém za pevnou cenu, jako jakékoli počítačové komponenty.
Je však třeba okamžitě poznamenat, že přímé srovnání podle TB/$ není správné. Pokud přistupujete tímto způsobem, nejlevnějším řešením bude jednoduché JBOD + server, což nenabídne tu flexibilitu ani spolehlivost, jakou zajišťuje plnohodnotné, dvouřadičové úložiště. To vůbec neznamená, že JBOD je hrozné a špatné, je jen třeba velmi jasně pochopit — jak a k jakým účelům budete tento systém používat. Často lze slyšet, že v JBOD není co se rozbít, je tam jen jeden backplane. Nicméně i backplany se mohou porouchat. Všechno se dříve nebo později pokazí.
Celkem
Srovnávat systémy mezi sebou je potřeba nejen podle ceny, nebo jen podle výkonnosti, ale podle souhrnu všech ukazatelů.
Kupujte HDD pouze v případě, že si jste jisti, že je opravdu potřebujete. Pro nízké zátěže a neslučitelné typy dat se vyplatí zvážit programy záruky efektivity ukládání na SSD, které nyní nabízí většina dodavatelů (a skutečně fungují, i v Česku), ale záleží na aplikacích a datech, které budou uloženy na tomto úložném systému.
Nepodléhejte pouze ceně. Často se za ní skrývá řada nepříjemných aspektů, z nichž jeden popsal Evgenij Elizarov ve svých článcích o . A co může nakonec vaše úspora být ve své podstatě nevýhodná. Nezapomínejte – "kdo šetří, dvojí platí".
Zdroj: habr.com
