

Ahoj, Habráci. Dnes začíná výuka v první skupině kurzu . V souvislosti s tím bychom vám chtěli říct, jak probíhal otevřený webinář o tomto kurzu.
V mluvili jsme o tom, s jakými výzvami se SQL databáze potýkají v éře cloudů a Kubernetes. Zároveň jsme prozkoumali, jak se SQL databáze přizpůsobují a mutují pod vlivem těchto výzev.
Webinář vedl , Google Cloud Practice Delivery Manager v EPAM Systems.
Když byly stromy malé...
Nejprve si připomeňme, jak se na konci minulého století začínal výběr SŘBD. Nicméně to nebude obtížné, protože výběr SŘBD v té době začínal a končil Oracle.
Na konci 90. let a na začátku nultých let, ve skutečnosti nebylo moc na výběr, pokud hovoříme o průmyslově škálovatelných DB. Ano, existovaly IBM DB2, Sybase a ještě nějaké další databáze, které se objevily a zmizely, ale celkově nebyly příliš viditelné na pozadí Oracle. Podle toho byly dovednosti inženýrů té doby vázány na ten jediný výběr, který existoval.
Oracle DBA musel umět:
- nainstalovat Oracle Server z distribučního balíčku;
- nastavit Oracle Server:
- init.ora;
- listener.ora;
— vytvářet:
- tabulková prostory;
- schémy;
- uživatelé;
— provádět zálohování a obnovu;
— monitorovat;
— bojovat s neoptimálními dotazy.
Přitom se od Oracle DBA zvlášť nežádalo, aby:
- uměl vybírat optimální SŘBD nebo jinou technologii pro uchovávání a zpracování dat;
- zajišťoval vysokou dostupnost a horizontální škálovatelnost (to nebyla vždy otázka DBA);
- dobře znal obor, infrastrukturu, aplikační architekturu, OS;
- prováděl načítání a vykládání dat, migraci dat mezi různými SŘBD.
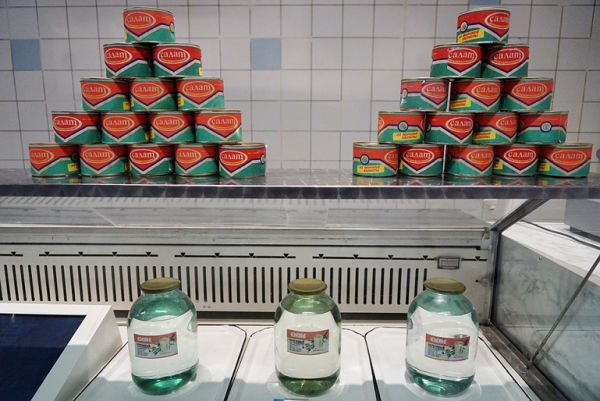
Obecně platí, že pokud hovoříme o výběru v té době, připomíná to výběr v sovětském obchodě na konci 80. let:
Naše doba
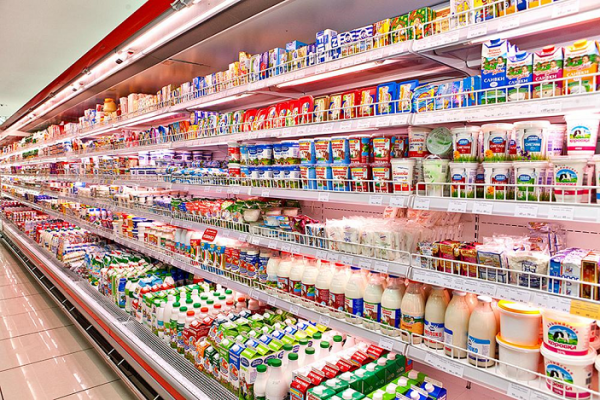
Od té doby se samozřejmě stromy vyrostly, svět se změnil a stalo se to nějak takto:
Změnil se i trh SŘBD, což je dobře vidět na čerstvé zprávě společnosti Gartner:
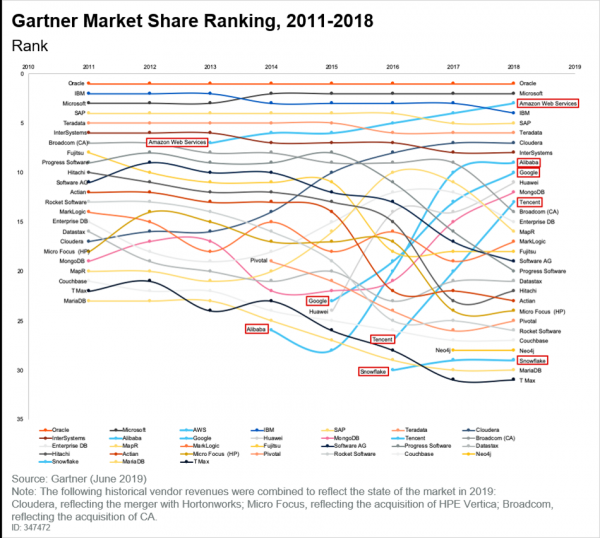
A zde nelze opomenout, že svou niku obsadily cloudy, jejichž popularita roste. Pokud si přečteme stejnou zprávu společnosti Gartner, uvidíme následující závěry:
- Mnoho zákazníků je na cestě k migraci aplikací do cloudu.
- Nové technologie se nejprve objevují v cloudu a není jisté, zda se vůbec někdy přesunou do necloudové infrastruktury.
- Model cenotvorby na principu pay-as-you-go se stal běžným. Všichni chtějí platit pouze za to, co využívají, a to už ani není trend, ale prostě konstatování faktu.
Co se děje teď?
Dnes jsme všichni v cloudu. A otázky, které nás zajímají, jsou otázkami výběru. Ten je obrovský, i když mluvíme pouze o výběru technologií DBMS v On-premises formátu. A máme také managed services a SaaS. Výběr se tedy s každým rokem jen ztěžuje.
Kromě otázek výběru existují také omezující faktory:
- cena. Mnoho technologií stále stojí peníze;
- dovednosti. Pokud mluvíme o open-source software, vyvstává otázka dovedností, protože bezplatný software vyžaduje od lidí, kteří jej nasazují a provozují, dostatečnou kompetenci;
- funkce. Ne všechny služby, které jsou dostupné v cloudu a postavené například na základě Postgres, mají stejné vlastnosti jako Postgres On-premises. To je zásadní faktor, který je třeba znát a porozumět mu. A co víc, tento faktor nabývá většího významu než znalost nějakých skrytých možností konkrétního DBMS.
Co nyní očekávají od DA/DE:
- dobré porozumění oboru a aplikační architektury;
- schopnost správně vybrat vhodnou technologii DBMS s ohledem na daný úkol;
- schopnost zvolit optimální metodu realizace vybrané technologie v kontextu existujících omezení;
- schopnost provádět migraci a přenos dat;
- schopnost realizovat a provozovat vybraná řešení.
Následující příklad na základě GCP ukazuje, jak se vybírá ta nebo ona technologie pro práci s daty v závislosti na jejich struktuře:
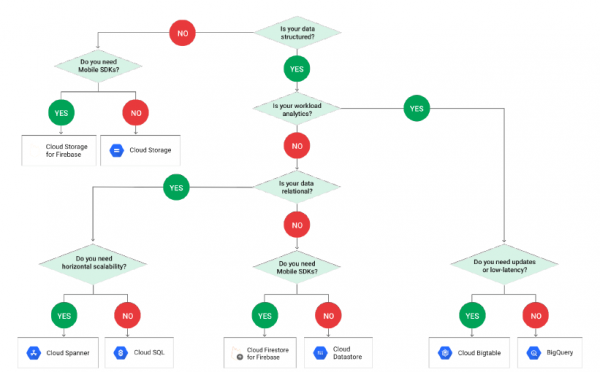
Všimněte si, že ve schématu chybí PostgreSQL, a to proto, že se skrývá pod terminologií Cloud SQL. A když se dostaneme do Cloud SQL, musíme opět učinit výběr:
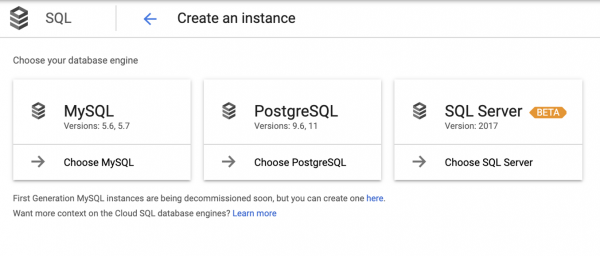
Je třeba poznamenat, že tento výběr není vždy jasný, a proto vývojáři aplikací často řídí svou intuicí.
Celkem:
- Čím dál, tím více se stává otázka výběru aktuální. A i když se zaměříme pouze na GCP, managed services a SaaS, nějaká zmínka o RDBMS se objevuje až ve čtvrtém kroku (a tam je vedle něj Spanner). Navíc, volba PostgreSQL se objevuje vůbec až v pátém kroku, přičemž vedle jsou ještě MySQL a SQL Server, tedy je toho hodně, ale je třeba vybírat.
- Nelze zapomínat ani na omezení v kontextu svodů. V zásadě, všichni chtějí Spanner, ale ten je drahý. Nakonec typická poptávka vypadá přibližně takto: „Uděláte nám prosím Spanner, ale za cenu Cloud SQL, vy jste přece profesionálové!“
A co teď dělat?
Bez nároku na pravdu v poslední instanci, řekněme následující:
Je třeba změnit přístup k výuce:
- učit tak, jak se učilo dříve DBA, nemá smysl;
- znalost jednoho produktu je nyní již nedostačující;
- a znát desítky na úrovni jednoho — nemožné.
Je třeba znát nejen a ne tolik produkt, ale:
- use case jeho použití;
- různé metody nasazení;
- výhody a nevýhody každé z metod;
- podobné a alternativní produkty, abychom mohli učinit vědomou a optimální volbu a ne vždy ve prospěch známého produktu.
A také je třeba umět migrovat data a rozumět základním principům integrace s ETL.
Skutečný případ
V nedávné minulosti bylo třeba vytvořit backend pro mobilní aplikaci. K okamžiku zahájení práce na ní byl backend již vyvinut a připraven k nasazení, a tým vývojářů strávil na tomto projektu přibližně dva roky. Byly stanoveny následující úkoly:
- vybudovat CI/CD;
- provést revizi architektury;
- spustit to celé do provozu.
Aplikace byla mikroslužbová a kód na Python/Django byl vyvinut od nuly přímo v GCP. Co se týče cílové skupiny, předpokládalo se, že budou dvě oblasti — US a EU, a provoz byl rozdělen přes Global Load balancer. Všechny Workloads a výpočetní zátěž pracovaly v Google Kubernetes Engine.
Pokud jde o data, existovaly 3 struktury:
- Cloud Storage;
- Datastore;
- Cloud SQL (PostgreSQL).
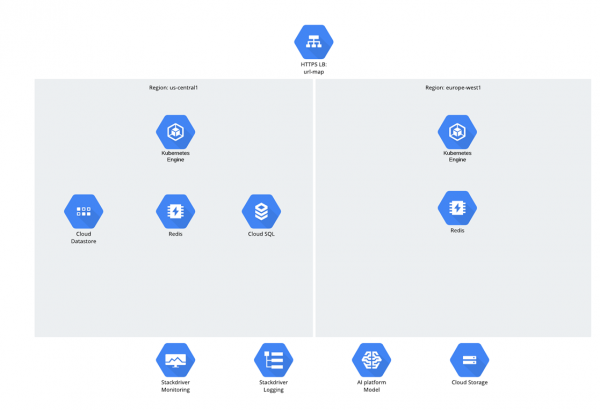
Může se objevit otázka, proč byl vybrán Cloud SQL? Řeknu pravdu, taková otázka v posledních letech vyvolává jakousi trapnou pauzu — zdá se, že se lidé začali stydět za relační databáze, ale přesto je i nadále aktivně používají ;-).
Co se týče našeho případu, Cloud SQL byl vybrán z následujících důvodů:
- Jak bylo uvedeno, aplikace byla vyvinuta pomocí Django, a obsahuje model pro zobrazení trvalých dat ze SQL databáze do objektů Python (Django ORM).
- Sám framework podporoval dostatečně konečný seznam DBMS:
- PostgreSQL;
- MariaDB;
- MySQL;
- Oracle;
- SQLite.
Proto jsme intuitivně zvolili PostgreSQL z tohoto seznamu (no přece ne Oracle).
Co chybělo:
- aplikace byla nasazena pouze ve dvou regionech, a ve plánech se objevil třetí (Asie);
- DB se nacházela v severoamerickém regionu (Iowa);
- ze strany objednavatele byly obavy ohledně možných zpoždění v přístupu z Evropy a Asie a výpadků v provozu v případě výpadku DB.
I když samotný Django může pracovat s několika DB paralelně a rozdělovat je podle čtení a zápisu, zápisů v aplikaci nebylo zas tolik (více než 90 % — čtení). Celkově, pokud by bylo možné vytvořit read-replikaci hlavní databáze v Evropě a Asii, bylo by to kompromisním řešením. Co na tom může být těžkého?
Těžkost spočívala v tom, že objednavatel nechtěl opustit používání managed services a Cloud SQL. A možnosti Cloud SQL jsou momentálně omezené. Cloud SQL podporuje vysokou dostupnost (HA) a Read Replica (RR), ale stejná RR je podporována pouze v jednom regionu. Vytvořením DB v americkém regionu nelze vytvořit read-replikaci v evropském regionu pomocí Cloud SQL, i když samotný PostgreSQL to nebrání. Korespondence s pracovníky Google nijak nepomohla a skončila sliby ve stylu „známe problém a pracujeme na jeho vyřešení, jednou to bude vyřešeno“.
Pokud shrneme možnosti Cloud SQL bodově, vypadalo by to přibližně takto:
1. Vysoká dostupnost (HA):
- v rámci jednoho regionu;
- prostřednictvím diskové replikace;
- mechanismy PostgreSQL nejsou používány;
- možnost automatického a ručního řízení — failover/failback;
- při přepnutí není DB k dispozici po dobu několika minut.
2. Read Replica (RR):
- v rámci jednoho regionu;
- hot standby;
- streaming replikace PostgreSQL.
Navíc, jak je běžné, při výběru technologie se vždy setkáváte s nějakými omezeními,:
- objednavatel nechtěl zbytečně rozšiřovat entity a používat IaaS, kromě jak GKE;
- objednavatel nechtěl nasazovat self-service PostgreSQL/MySQL;
- A vlastně, Google Spanner by byl docela vhodný, kdyby to nebylo tak drahé, pravda, s ním Django ORM nepracuje, ale jinak je to dobrá věc.
Vzhledem k situaci přišla od klienta otázka na zamyšlení: „Můžete udělat něco podobného, aby to fungovalo jako Google Spanner, ale také to fungovalo s Django ORM?“
Varianta řešení č. 0
První, co mě napadlo:
- zůstat u CloudSQL;
- nebudou žádné vestavěné replikace mezi regiony;
- pokusit se připojit replikaci k existujícímu Cloud SQL by PostgreSQL;
- někde a nějak spustit instanci PostgreSQL, ale alespoň neměnit master.
Bohužel, ukázalo se, že to nejde, protože není přístup k hostiteli (ten je vůbec v jiném projektu) — pg_hba a tak dále, a navíc není přístup pod superuživatelem.
Varianta řešení č. 1
Po dalším zamyšlení a s ohledem na předchozí okolnosti se myšlení trochu změnilo:
- stále se snažíme zůstat u CloudSQL, ale přecházíme na MySQL, protože Cloud SQL by MySQL má externí master, který:
— je proxy pro externí MySQL;
— vypadá jako instance MySQL;
— byl vynalezen pro migraci dat z jiných cloudů nebo on-premises.
Protože nastavení replikace MySQL nevyžaduje přístup k hostiteli, v zásadě všechno fungovalo, ale velmi nestabilně a nepohodlně. A když jsme se dostali dál, začalo to být opravdu děsivé, protože jsme celou strukturu vytvářeli pomocí terraformu, a najednou se ukázalo, že externí master není terraformem podporován. Ano, Google má CLI, ale z nějakého důvodu to zde fungovalo nevyzpytatelně — někdy se vytvoří, někdy ne. Možná proto, že CLI bylo navrženo pro migraci dat z vnějšku, nikoli pro repliky.
Ve skutečnosti se ukázalo, že Cloud SQL rozhodně nevyhovuje. Jak se říká, udělali jsme vše, co jsme mohli.
Varianta řešení č. 2
Protože se nám nepodařilo zůstat v rámci Cloud SQL, pokusili jsme se formulovat požadavky na kompromisní řešení. Požadavky byly následující:
- fungování v Kubernetes, maximální využití zdrojů a možností Kubernetes (DCS,...) a GCP (LB,...);
- absenci balastu z hromady zbytečných věcí v cloudu, jako je HA proxy;
- možnost provozovat v hlavním regionu HA PostgreSQL nebo MySQL; v ostatních regionech — HA z RR hlavního regionu plus její kopii (pro spolehlivost);
- multimaster (s ním se nechtělo spojovat, ale to nebylo příliš zásadní)
.
V důsledku těchto požadavků se na obzoru konečně objevilo pvhodné možnosti DBMS a vazby:
- MySQL Galera;
- CockroachDB;
- nástroje PostgreSQL
:
— pgpool-II;
— Patroni.
MySQL Galera
Technologie MySQL Galera byla vyvinuta společností Codership a představuje plugin pro InnoDB. Vlastnosti:
- multi master;
- synchronní replikace;
- čtení z jakéhokoli uzlu;
- zápis na libovolný uzel;
- vestavěný mechanismus HA;
- existuje Helm chart od Bitnami.
CockroachDB
Podle popisu je to naprosto úžasná věc a představuje open source projekt napsaný v Go. Hlavním účastníkem je Cockroach Labs (založená bývalými pracovníky Googlu). Tato relační DBMS byla od samého začátku navržena jako distribuovaná (s horizontálním škálováním „z krabice“) a odolná vůči chybám. Její autoři mají cíl „sloučit bohatství funkcí SQL s horizontální dostupností typickou pro NoSQL řešení“.
Jako příjemný bonus — podpora PostgreSQL protokolu připojení.
Pgpool
Je to nadstavba nad PostgreSQL, ve skutečnosti nová entita, která na sebe přebírá všechna připojení a zpracovává je. Má svůj load balancer a parser, licencuje se pod licencí BSD. Nabízí široké možnosti, ale vypadá poněkud zastrašujícím způsobem, protože existence nové entity mohla přinést určité dodatečné komplikace.
Patroni
Toto bylo poslední, co upoutalo pozornost, a jak se ukázalo, nebylo to zbytečné. Patroni je open-source nástroj, který v zásadě představuje daemon napsaný v Pythonu, umožňující automaticky spravovat PostgreSQL clustery s různými typy replikace a automatickým přepínáním rolí. Ukázalo se to jako velmi zajímavé, protože se to dobře integruje s Kubernetes a nenese žádné nové entity.
Co jsme nakonec vybrali
Výběr nebyl snadný:
- CockroachDB — skvělý, ale riskantní;
- MySQL Galera — také dobré, hodně používané, ale MySQL;
- Pgpool — spousta nadbytečných entit, integrace s cloudem a K8s nic moc;
- Patroni — skvělá integrace s K8s, žádné nadbytečné entity, dobře se integruje s GCP LB.
Takže výběr padl na Patroni.
Závěry
Nyní je čas shrnout stručné závěry. Ano, svět IT infrastruktury se výrazně změnil a to je teprve začátek. A pokud dříve byly cloudd technologie pouze jiným typem infrastruktury, nyní je to jinak. Navíc inovace v oblacích neustále přicházejí, budou pokračovat a možná se budou objevovat pouze v oblacích a následně, díky startupům, se budou přesouvat na On-premises.
Co se týče SQL, SQL zde zůstane. To znamená, že PostgreSQL a MySQL je potřeba znát a umět s nimi pracovat, ale ještě důležitější je umět je správně aplikovat.
Zdroj: habr.com
