

Pozadí
Jako milovník retro hardware jsem si jednou koupil od prodejce z Velké Británie ZX Spectrum+. Spolu s počítačem jsem dostal několik audiokazet se hry (v originálním balení s návody) a také programy nahrané na kazetách bez jakýchkoliv označení. Překvapivě se na kazetách starých 40 let data dobře četla a podařilo se mi načíst skoro všechny hry a programy.
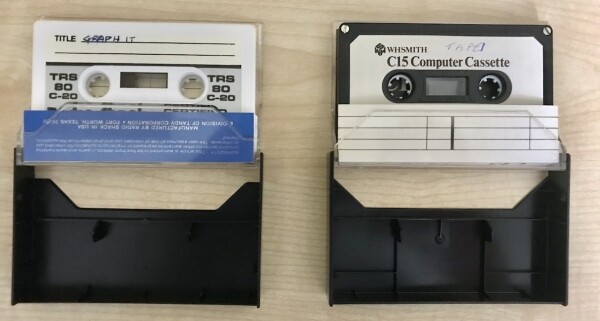
Nicméně na některých kazetách jsem objevil nahrávky, které byly jasně provedeny nikoliv počítačem ZX Spectrum. Zněly úplně jinak a na rozdíl od nahrávek z uvedeného počítače nezačínaly krátkým BASIC načítačem, který obvykle přítomný ve všech nahrávkách programů a her.
Nějaký čas mi to nedávalo spát — velmi jsem chtěl zjistit, co je v nich skryto. Kdybych mohl přečíst audio signál jako sekvenci bajtů, bylo by možné hledat v nich symboly nebo něco, co ukazuje na původ signálu. Takový druh retro-archaeologie.
Teď, když jsem prošel celou cestu a dívám se na štítky samotných kazet, usmívám se, protože
odpověď byla po celou dobu přímo před očima
Na štítku levé kazety je název počítače TRS-80 a kousek níže název výrobce: „Vyrobeno společnosti Radio Shack v USA“
(Pokud chcete uchovat napětí do konce, nečtěte pod spoilerem)
Srovnání audio signálů
Jako první digitalizujeme audi nahrávky. Můžete si poslechnout, jak to zní:
A jak obvykle zní nahrávka z počítače ZX Spectrum:
V obou případech se na začátku nahrávky objevuje tzv. pilotní tón — zvuk jedné frekvence (v první nahrávce je velmi krátký <1 sek, avšak rozpoznatelný). Pilotní tón slouží jako signál počítači, že se má připravit na příjem dat. Obvykle každý počítač rozpoznává pouze „svůj“ pilotní tón podle tvaru signálu a jeho frekvence.
Je třeba zmínit také samotný tvar signálu. Například na ZX Spectrum má tvar obdélníku:
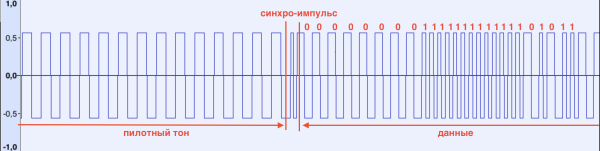
Při detekci pilotního tónu ZX Spectrum zobrazuje střídající se červené-modré pruhy na okrajové části obrazovky, ukazujíc, že signál byl rozpoznán. Pilotní tón končí synchronizačním impulsem, který signalizuje počítači, že by měl začít přijímat data. Je charakterizován kratší (ve srovnání s pilotním tónem a následujícími daty) délkou (viz obrázek)
Poté, co je synchronizační impuls přijat, počítač zaznamenává každý nárůst/klesání signálu, měří jeho délku. Pokud je délka kratší než stanovená hranice, do paměti se zapíše bit 1, jinak 0. Bity se shromažďují do bytů a proces se opakuje, dokud není získáno N bytů. Číslo N je obvykle převzato z hlavičky načítaného souboru. Pořadí načítání je následující:
- pilotní tón
- hlavička (pevné délky), která obsahuje velikost načítaných dat (N), název a typ souboru
- pilotní tón
- samotná data
Aby se ujistil, že byla data načtena správně, ZX Spectrum jako poslední byte čte takzvaný paritní byte , který se počítá při ukládání souboru operací XOR nad všemi byty zapsaných dat. Při čtení souboru počítač počítá paritní byte z přijatých dat a pokud je výsledek odlišný od uloženého, zobrazí chybové hlášení „R Tape loading error“. Přísně vzato může počítač toto hlášení vydat i dříve, pokud při čtení není schopen rozpoznat impuls (vynechán nebo jeho délka neodpovídá stanoveným hranicím)
Tak se nyní podívejme, jak vypadá neznámý signál:
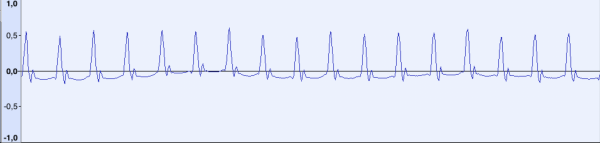
To je pilotní tón. Tvar signálu se značně liší, ale je zřejmé, že signál se skládá z opakujících se krátkých impulsů určité frekvence. Při vzorkovací frekvenci 44100 Hz je vzdálenost mezi „vrcholy“ přibližně 48 vzorků (což odpovídá frekvenci ~918 Hz). Zapamatujme si toto číslo.
Podívejme se nyní na fragment s daty:
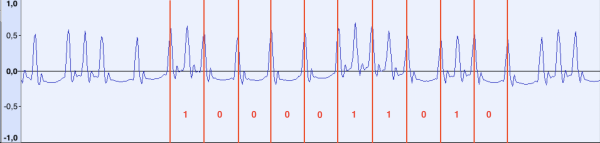
Pokud změříme vzdálenost mezi jednotlivými impulsy, ukáže se, že mezi „dlouhými“ impulsy zůstává vzdálenost přibližně ~48 vzorků, zatímco mezi krátkými je ~24. Trochu předbíhám, ale řeknu, že nakonec se ukázalo, že „referenční“ impulsy s frekvencí 918 Hz probíhají nepřetržitě, od začátku až do konce souboru. Můžeme předpokládat, že při přenosu dat, pokud se mezi referenčními impulsy objeví další impuls, považujeme ho za bit 1, jinak 0.
Co se stalo se synchronizačním impulsem? Podívejme se na začátek dat:
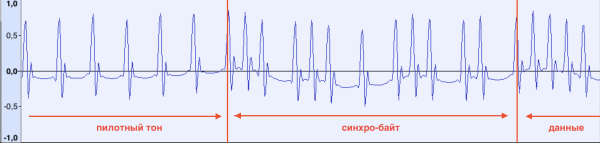
Pilotní tón končí a pak ihned začínají data. O něco později, po analýze několika různých zvukových záznamů, jsem zjistil, že první byte dat je vždy stejný (10100101b, A5h). Je možné, že počítač začne číst data, poté co je obdrží.
Také je možné si povšimnout posunu prvního reference pulzu hned po poslední 1 v synchronizačním bajtu. To se podařilo odhalit mnohem později v procesu vývoje programu pro rozpoznávání dat, kdy nebylo možné stabilně číst data na začátku souboru.
Teď se pokusíme popsat algoritmus, který zpracuje zvukový soubor a načte data.
Načítání dat
Nejprve zvážíme několik předpokladů, abychom nekomplikovali algoritmus:
- Budeme zvažovat soubory pouze ve formátu WAV;
- Zvukový soubor musí začínat pilotním tónem a nesmí obsahovat ticho na začátku.
- Základní soubor musí mít vzorkovací frekvenci 44100 Hz. V tomto případě je vzdálenost mezi reference pulzy 48 vzorků již definována a nemusíme ji programově počítat;
- Formát vzorků může být jakýkoli (8/16 bit/floating point) – při čtení je můžeme převést na potřebný;
- Předpokládáme, že základní soubor je normalizován podle amplitudy, což by mělo stabilizovat výsledek;
Algoritmus čtení bude následující:
- Načteme soubor do paměti a zároveň převedeme formát vzorků na 8 bit;
- Určíme pozici prvního impulsu v audio datech. K tomu je třeba spočítat číslo vzorku s maximální amplitudou. Pro zjednodušení to spočítáme jednou ručně. Uložíme do proměnné prev_pos;
- Přidáme k pozici posledního impulsu 48 (pos := prev_pos + 48)
- Zvýšení pozice o 48 nezaručuje, že se dostaneme na pozici následujícího referenčního impulzu (defekty pásky, nestabilní práce páskového mechanismu a další), je třeba upravit pozici impulzu pos. K tomu vezmeme malou část dat (pos-8;pos+8) a na ní najdeme maximum hodnoty amplitudy. Pozici, která odpovídá maximu, si uložíme do pos. Tady 8 = 48/6 — experimentálně získaná konstanta, která zaručuje, že určíme správné maximum a nezasáhneme do jiných impulzů, které mohou běžet vedle. V případech s velmi malou nebo velkou vzdáleností mezi impulzy lze implementovat nucené vyhledávání impulzu, ale v rámci článku to nebudu popisovat v algoritmu;
- Na předchozím kroku je také nutné zkontrolovat, zda byl referenční impuls skutečně nalezen. Jinými slovy, samotné hledání maxima nezaručuje, že impuls je v daném úseku přítomen. Ve své poslední implementaci programu pro čtení kontroluji rozdíl mezi maximální a minimální hodnotou amplitudy v úseku, a pokud tento rozdíl překročí určitý práh, považuji impuls za přítomný. Otázka také je, co dělat, pokud referenční impuls nebyl nalezen. Zde jsou dvě možnosti: buď data skončila a následuje ticho, nebo by to mělo být považováno za chybu čtení. To však pro zjednodušení algoritmu vynecháme;
- V dalším kroku je třeba určit přítomnost datového impulzu (bit 0 nebo 1), za tímto účelem vezmeme střed úseku (prev_pos;pos) middle_pos rovný middle_pos := (prev_pos+pos)/2 a v určitém okolí middle_pos v úseku (middle_pos-8;middle_pos+8) spočítáme maximum a minimum amplitudy. Pokud je rozdíl mezi nimi větší než 10, zapíšeme do výsledku bit 1, jinak 0. 10 — konstanta získaná empiricky;
- Uložíme aktuální pozici do prev_pos (prev_pos := pos)
- Opakujeme začínající krokem 3, dokud nepřečteme celý soubor;
- Získaný bitový aray je nutné uložit jako sadu bajtů. Protože jsme při čtení nezohlednili synchronizační bajt, může se ukázat, že počet bitů není dělitelný 8 a také není známo potřebné posunutí v bitech. V první implementaci algoritmu jsem nevěděl o existenci synchronizačního bajtu a proto jsem prostě uložil 8 souborů s různým počtem bitů posunutí. Jeden z nich obsahoval správná data. Ve finálním algoritmu jednoduše odstraním všechny bity až do A5h, což umožňuje okamžitě získat správný soubor na výstupu.
Algoritmus v Ruby, pro zájemce.
Jako jazyk pro psaní programu jsem si vybral Ruby, protože většinu času programuju v něm. Varianta není vysoce výkonná, ale úkolem není udělat čtení co nejrychlejší.
# Используем gem 'wavefile'
require 'wavefile'

reader = WaveFile::Reader.new('input.wav')
samples = []
format = WaveFile::Format.new(:mono, :pcm_8, 44100)

# Читаем WAV файл, конвертируем в формат Mono, 8 bit
# Массив samples будет состоять из байт со значениями 0-255
reader.each_buffer(10000) do |buffer|
  samples += buffer.convert(format).samples
end

# Позиция первого импульса (вместо 0)
prev_pos = 0
# Расстояние между импульсами
distance = 48
# Значение расстояния для окрестности поиска локального максимума
delta = (distance / 6).floor
# Биты будем сохранять в виде строки из "0" и "1"
bits = ""

loop do
  # Рассчитываем позицию следующего импульса
  pos = prev_pos + distance

  # Выходим из цикла если данные закончились
  break if pos + delta >= samples.size

  # Корректируем позицию pos обнаружением максимума на отрезке [pos - delta;pos + delta]
  (pos - delta..pos + delta).each { |p| pos = p if samples[p] > samples[pos] }

  # Находим середину отрезка [prev_pos;pos]
  middle_pos = ((prev_pos + pos) / 2).floor

  # Берем окрестность в середине
  sample = samples[middle_pos - delta..middle_pos + delta]

  # Определяем бит как "1" если разница между максимальным и минимальным значением на отрезке превышает 10
  bit = sample.max - sample.min > 10
  bits += bit ? "1" : "0"
end

# Определяем синхро-байт и заменяем все предшествующие биты на 256 бит нулей (согласно спецификации формата)
bits.gsub! /^[01]*?10100101/, ("0" * 256) + "10100101"

# Сохраняем выходной файл, упаковывая биты в байты
File.write "output.cas", [bits].pack("B*")
Výsledek
Poté, co jsem vyzkoušel několik variant algoritmu a konstant, měl jsem štěstí, že jsem získal něco mimořádně zajímavého:
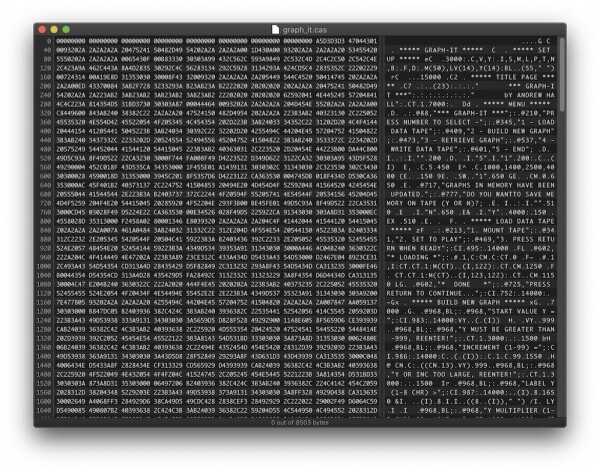
Takže podle symbolových řetězců máme program pro vykreslování grafů. Nicméně v textu programu chybí klíčová slova. Všechna klíčová slova jsou zakódována jako bajty (hodnota každého > 80h). Teď je potřeba zjistit, jaký počítač z 80. let mohl ukládat programy v takovém formátu.
Ve skutečnosti to velmi připomíná program v jazyce BASIC. Přibližně ve stejném formátu počítač ZX Spectrum ukládá v paměti a ukládá programy na pásce. Pro jistotu jsem zkontroloval klíčová slova na shodu s Avšak výsledek byl očividně negativní.
Také jsem zkontroloval klíčová slova BASIC populárních počítačů té doby, jako jsou Atari, Commodore 64 a několika dalších, na které se mi podařilo najít dokumentaci, ale bez úspěchu – moje znalosti o druzích retro počítačů nebyly tak široké.
Poté jsem se rozhodl jít podle a tady mi padl zrak na název výrobce Radio Shack a počítače TRS-80. Právě tyto názvy byly napsány na etiketách kazet, které ležely na mém stole! Předtím jsem tato jména neznal a s počítačem TRS-80 jsem nebyl obeznámen, proto jsem měl pocit, že Radio Shack je výrobce audiokazet, jako je BASF, Sony nebo TDK, a TRS-80 – délka přehrávání. Proč ne?
Počítač Tandy/Radio Shack TRS-80
Je velmi pravděpodobné, že záznam, který jsem uvedl jako příklad na začátku článku, byl pořízen na takovém počítači:
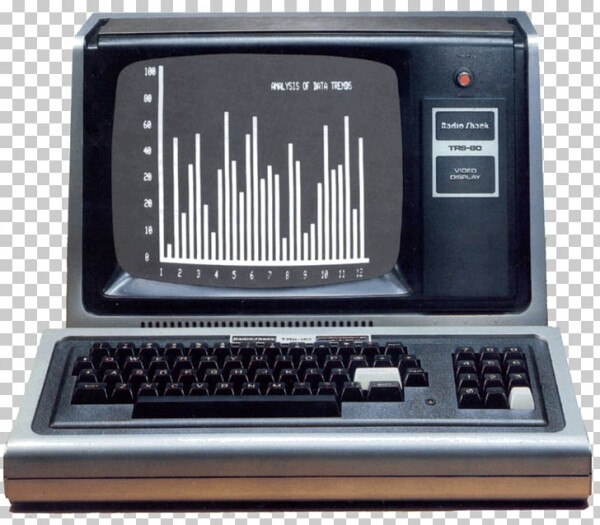
Ukázalo se, že tento počítač a jeho varianty (Model I/Model III/Model IV atd.) byly v minulosti velmi populární (samozřejmě nejen v Rusku). Zajímavé je, že procesor, který byl v nich použit — také Z80. O tomto počítači lze na internetu nalézt . V 80. letech se informace o počítači šířily v . V současnosti existuje několik počítače pro různé platformy.
Stáhl jsem emulátor a poprvé jsem mohl vidět, jak tento počítač fungoval. Samozřejmě, počítač nepodporoval barevný výstup, rozlišení obrazovky bylo pouze 128x48 bodů, ale existovalo mnoho rozšíření a modifikací, které mohly zvyšovat rozlišení obrazovky. Kromě toho existovalo mnoho variant operačních systémů pro tento počítač a variant implementace jazyka BASIC (který, na rozdíl od ZX Spectrum, v některých modelech ani nebyl „nahraný“ v ROM a jakákoli varianta mohla být načtena z disket, stejně jako samotný OS)
Také jsem našel pro převod audio nahrávek do formátu CAS, které emulátory podporují, avšak z nějakého důvodu se mi nepodařilo přečíst nahrávky z mých kazet pomocí tohoto nástroje.
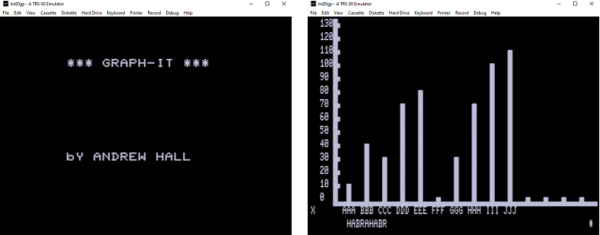
Když jsem se podíval na formát souboru CAS (který se ukázal být pouze bitovou kopií dat z pásky, kterou jsem měl v ruce, s výjimkou hlavičky se synchronizačním bajtem), provedl jsem několik změn ve svém programu a podařilo se mi získat funkční CAS soubor, který fungoval v emulátoru (TRS-80 Model III):
Poslední verzi nástroje pro převod s automatickým určením prvního impulzu a vzdáleností mezi referenčními impulzy jsem vytvořil jako GEM balíček, zdrojový kód je k dispozici na .
Závěr
Cesta, kterou jsem urazil, byla fascinující cestou do minulosti, a jsem rád, že jsem nakonec našel rozluštění. Kromě jiného jsem:
- Porozuměl formátu ukládání dat v ZX Spectrum a prostudoval vestavěné v ROM podprogramy pro ukládání/čtení dat z audio kazet
- Seznámil se s počítačem TRS-80 a jeho variantami, prostudoval operační systém, podíval se na příklady programů a dokonce měl možnost se zabývat laděním v strojových kódech (všechny mnemoniky Z80 mi jsou dobře známy)
- Vytvořil jsem kompletní nástroj pro převod zvukových záznamů do formátu CAS, který dokáže číst data, která 'oficiální' nástroj nedokáže rozpoznat.
Zdroj: habr.com
