

Ahoj, Habráci! Tato kniha je vhodná pro každého vývojáře, který se chce ponořit do problematiky streamového zpracování. Pochopení distribuovaného programování vám pomůže lépe porozumět Kafce a Kafka Streams. Bylo by dobrou výhodou znát také samotný framework Kafka, ale není to nutné: povím vám vše, co potřebujete. Zkušení vývojáři Kafky i nováčci díky této knize zvládnou vytváření zajímavých aplikací pro streamové zpracování pomocí knihovny Kafka Streams. Vývojáři Javy střední a vyšší úrovně, kteří jsou již obeznámeni s takovými pojmy jako serializace, se naučí aplikovat své dovednosti na vytváření aplikací Kafka Streams. Zdrojový kód knihy je napsán v Javě 8 a významně využívá syntaxi lambda výrazů Javy 8, takže dovednost práce s lambda funkcemi (i v jiném programovacím jazyce) se vám bude hodit.
Úryvek. 5.3. Agregace a oknové operace
V této části se přeneseme k prozkoumání nejnadějnějších částí Kafka Streams. Dosud jsme prozkoumali následující aspekty Kafka Streams:
- vytváření zpracovatelské topologie;
- využití stavu ve streamových aplikacích;
- provádění spojení datových proudů;
- rozdíly mezi událostmi (KStream) a aktualizacemi (KTable).
V následujících příkladech všechny tyto prvky spojíme dohromady. Navíc se seznámíte s oknovými operacemi — dalším skvělým využitím streamových aplikací. Naším prvním příkladem bude jednoduchá agregace.
5.3.1. Agregace objemu prodeje akcií podle průmyslových odvětví
Agregace a skupinování jsou životně důležité nástroje při práci s proudovými daty. Zkoumání jednotlivých záznamů při jejich příjmu se často ukazuje jako nedostatečné. Pro získání dalších informací z dat je nutné je seskupit a zkombinovat.
V tomto příkladu se stanete intradenním obchodníkem, který potřebuje sledovat objemy prodeje akcií firem v několika průmyslových odvětvích. Zvlášť vás zajímá pět firem s největšími objemy prodeje akcií v každém z průmyslových odvětví.
Pro takovou agregaci bude potřeba několik následujících kroků k převedení dat do požadované podoby (pokud mluvíme obecně).
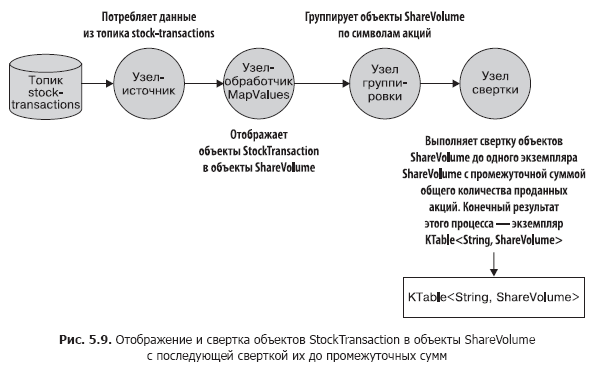
- Vytvořte zdroj na základě tématu, který publikuje neupravené informace o obchodování s akciemi. Musíme převést objekt typu StockTransaction na objekt typu ShareVolume. Skutečností je, že objekt StockTransaction obsahuje metadata prodeje, ale my potřebujeme pouze údaje o počtu prodaných akcií.
- Seskupte údaje ShareVolume podle akciových symbolů. Po seskupení podle symbolů je možné tyto údaje zkrátit na mezisouhrny objemů prodeje akcií. Je třeba poznamenat, že metoda KStream.groupBy vrací instanci typu KGroupedStream. A instanci KTable lze získat voláním metody KGroupedStream.reduce.
Co je rozhraní KGroupedStream
Metody KStream.groupBy a KStream.groupByKey vrací instanci KGroupedStream. KGroupedStream je mezivrstvové zobrazení toku událostí po seskupení podle klíčů. Není určeno pro přímou práci s ním. Místo toho se KGroupedStream používá pro operační aggregraci, jejíž výsledkem je vždy KTable. A protože výsledkem operační agregace je KTable a používá se úložiště stavu, možná ne všechna aktualizace jsou posílány dále v potrubí.
Metoda KTable.groupBy vrací podobný KGroupedTable — mezivrstvové zobrazení toku aktualizací přeorganizovaných podle klíče.
Uděláme si malou přestávku a podíváme se na obr. 5.9, kde vidíme, co jsme dosáhli. Tato topologie by vám měla být již dobře známá.
Podívejme se nyní na kód pro tuto topologii (najdete jej v souboru src/main/java/bbejeck/chapter_5/AggregationsAndReducingExample.java) (výpis 5.2).
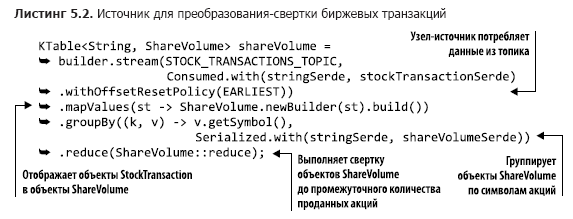
Uvedený kód se vyznačuje stručností a mnoha provedenými akcemi v několika řádcích. V prvním parametru metody builder.stream si můžete všimnout něčeho nového: hodnota výčtového typu AutoOffsetReset.EARLIEST (existuje také LATEST), která je nastavena pomocí metody Consumed.withOffsetResetPolicy. Pomocí tohoto výčtového typu můžete určit strategii resetování offsetů pro každou z KStream nebo KTable, má přednost před parametrem resetování offsetů v konfiguraci.
GroupByKey a GroupBy
V rozhraní KStream existují dvě metody pro skupinování záznamů: GroupByKey a GroupBy. Obě vrací KGroupedTable, takže se může objevit oprávněná otázka: jaký je mezi nimi rozdíl a kdy který z nich použít?
Metoda GroupByKey se používá, když jsou klíče v KStream již neprázdné. Hlavně, příznak „vyžaduje nové rozdělení“ nikdy nebyl nastaven.
Metoda GroupBy předpokládá, že jste měnili klíče pro seskupení, takže příznak nového rozdělení je nastaven na true. Provádění po metodě GroupBy, jako jsou spojení, agregace atd., povede k automatickému novému rozdělení.
Shrnutí: při jakékoliv příležitosti byste měli použít GroupByKey, nikoli GroupBy.
Co dělají metody mapValues a groupBy – je jasné, takže se podívejme na metodu sum() (tu můžete najít v souboru src/main/java/bbejeck/model/ShareVolume.java) (listing 5.3).
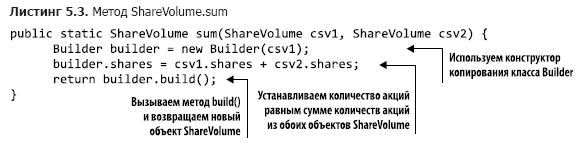
Metoda ShareVolume.sum vrací meziprodukt součtu objemu obchodovaných akcií a výsledek celé řetězec výpočtů představuje objekt KTable. Nyní chápete, jakou roli hraje KTable. Při přijetí objektů ShareVolume je v odpovídajícím objektu KTable uchováváno poslední aktuální aktualizace. Je důležité nezapomínat, že všechna aktualizace se odráží v předchozím shareVolumeKTable, ale ne všechny jsou zasílány dále.
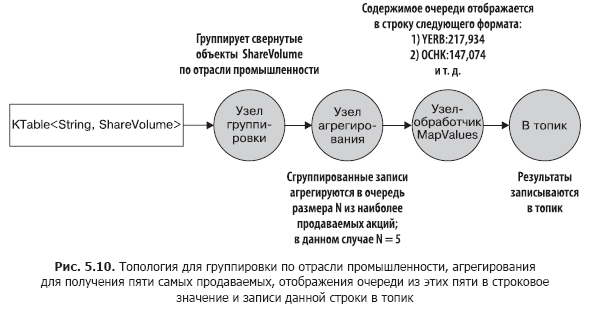
Dále pomocí tohoto KTable provádíme agregaci (podle počtu obchodovaných akcií), abychom získali pět společností s nejvyššími objemy prodeje akcií v každém odvětví. Naše kroky budou při tom podobné těm při prvním agregování.
- Proveďte další operaci groupBy pro seskupení jednotlivých objektů ShareVolume podle odvětví.
- Začněte součtování objektů ShareVolume. Tentokrát je objekt agregace prioritní fronta pevné velikosti. V takové prioritní frontě pevné velikosti jsou uchovávány pouze pět společností s nejvyšším počtem prodaných akcií.
- Zobrazte fronty z předchozího bodu jako řetězcovou hodnotu a vraťte pět nejprodávanějších podle počtu akcií v jednotlivých odvětvích.
- Zapište výsledky v řetězcové podobě do tématu.
Na obr. 5.10 je zobrazen graf topologie toku dat. Jak vidíte, druhý cyklus zpracování je dost jednoduchý.
Nyní, když máte jasnou představu o struktuře tohoto druhého cyklu zpracování, můžete se podívat na jeho zdrojový kód (nalezneme ho v souboru src/main/java/bbejeck/chapter_5/AggregationsAndReducingExample.java) (listing 5.4).
V tomto inicializátoru se nachází proměnná fixedQueue. Je to uživatelský objekt - adaptér pro java.util.TreeSet, který se používá k sledování N největších výsledků podle klesajícího počtu prodaných akcií.
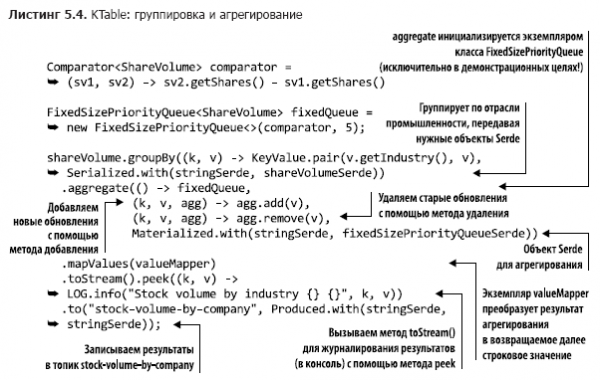
Již jste se setkali s výzvami groupBy a mapValues, takže se na ně nebudeme zdržovat (voláme metodu KTable.toStream, protože metoda KTable.print je považována za zastaralou). Ale ještě jste neviděli KTable verzi metody aggregate(), takže si na její diskusi vezmeme chvíli čas.
Jak víte, KTable se vyznačuje tím, že záznamy se stejnými klíči se považují za aktualizace. KTable nahrazuje starý záznam novým. Agregování probíhá podobným způsobem: agregují se poslední záznamy se stejným klíčem. Při přijetí záznamu se přidává do instance třídy FixedSizePriorityQueue pomocí sčítacího (druhý parametr v volání metody aggregate), ale pokud již existuje jiný záznam se stejným klíčem, starý záznam se odstraní pomocí odečítacího (třetí parametr v volání metody aggregate).
To vše znamená, že náš agregátor, FixedSizePriorityQueue, vůbec neaggreguje všechna hodnoty se stejným klíčem, ale uchovává klouzavou sumu N nejprodávanějších druhů akcií. V každém novém záznamu je obsaženo celkové množství prodaných akcií dosud. KTable vám poskytne informace o tom, které akcie firem se aktuálně prodávají nejvíce, a není třeba klouzavé agregování každé z aktualizací.
Naučili jsme se dělat dvě důležité věci:
- skupinovat hodnoty v KTable podle společného klíče;
- provádět nad těmito seskupenými hodnotami takové užitečné operace, jako je shrnutí a agregace.
Schopnost provádět tyto operace je důležitá pro pochopení smyslu dat, která procházejí aplikací Kafka Streams, a pro zjištění, jaké informace nesou.
Spojili jsme také některé klíčové pojmy, které byly dříve probírány v této knize. V kapitole 4 jsme hovořili o důležitosti odolného lokálního stavu pro streamovací aplikaci. První příklad z této kapitoly ukázal, proč je lokální stav tak důležitý — umožňuje sledovat, jaké informace jste již viděli. Lokální přístup eliminuje síťové zpoždění, což zvyšuje výkon aplikace a její odolnost vůči chybám.
Při provádění jakékoli operace agregace nebo shrnutí je nutné zadat název úložiště stavu. Operace agregace a shrnutí vracejí instanci KTable a KTable využívá úložiště stavu k nahrazení starých výsledků novými. Jak jste viděli, ne všechny aktualizace jsou dále posílány potrubím, což je důležité, protože operace agregace jsou určeny k získávání konečných informací. Pokud není používán lokální stav, KTable bude posílat všechny výsledky agregace a shrnutí dále.
Nyní se podíváme na provádění takových operací, jako je agregace, v rámci konkrétního časového intervalu — takzvané oknové operace.
5.3.2. Oknové operace
V předchozí části jsme se seznámili s „klouzajícími“ shrnutími a agregacemi. Aplikace prováděla kontinuální shrnutí objemu obchodování s akciemi a následné agregace pěti nejprodávanějších akcií na burze.
Někdy jsou takové kontinuální agregace a shrnutí výsledků nezbytné. Jindy je potřeba provádět operace pouze nad daným časovým intervalem. Například spočítat, kolik burzovních operací se uskutečnilo s akciemi konkrétní společnosti za posledních 10 minut. Nebo kolik uživatelů kliklo na nový reklamní banner za posledních 15 minut. Aplikace může tyto operace provádět opakovaně, ale s výsledky vztahujícími se pouze k daným časovým intervalům (časovým oknům).
Počítání burzovních transakcí podle kupujícího
V následujícím příkladu se zaměříme na sledování burzovních transakcí několika obchodníků — buď velkých organizací, nebo bystrých individuálních finančníků.
Existují dvě možné příčiny pro takové sledování. Jednou z nich je potřeba vědět, co kupují/prodávají lídři trhu. Pokud tito velcí hráči a zkušení investoři vidí příležitosti, má smysl sledovat jejich strategii. Druhá příčina spočívá v touze zaznamenat jakékoli možné známky nezákonných obchodů s využitím vnitřních informací. K tomu je třeba analyzovat korelaci velkých nárůstů prodeje s důležitými tiskovými zprávami.
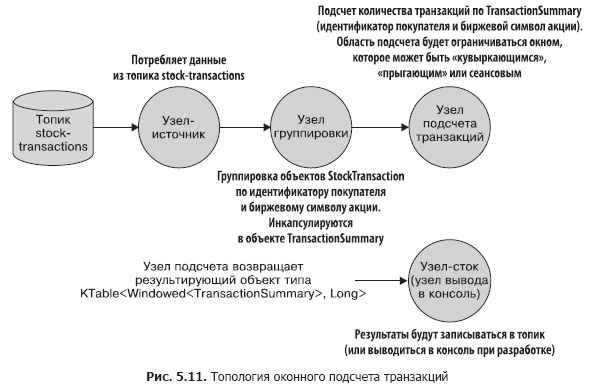
Takové sledování se skládá z následujících fází:
- vytvoření proudu pro čtení z tématu stock-transactions;
- seskupení příchozích záznamů podle identifikátoru kupujícího a burzovního symbolu akcie. Volání metody groupBy vrací instanci třídy KGroupedStream;
- vracení metodou KGroupedStream.windowedBy proudu dat omezeného časovým oknem, což umožňuje provádět agregaci v oknech. V závislosti na typu okna se vrací buď TimeWindowedKStream, nebo SessionWindowedKStream;
- počítání transakcí pro agregaci operace. Okno proudových dat určuje, zda se daný záznam zahrnuje do tohoto počtu;
- zaznamenání výsledků do tématu nebo jejich výstup na konzoli během vývoje.
Topologie této aplikace je jednoduchá, ale názorný obrázek neublíží. Podívejme se na obr. 5.11.
Dále se budeme zabývat funkcionalitou oknových operací a odpovídajícím kódem.
Typy oken
V Kafka Streams existují tři typy oken:
- sezónní;
- kollabované (tumbling);
- klouzavé/„skáčící“ (sliding/hopping).
Jaké z nich vybrat, závisí na obchodních požadavcích. „Koulené“ a „skáčící” okna jsou časově omezená, zatímco omezení sezónních vyplývá z uživatelských akcí – délka sezení(-í) je určena výhradně tím, jak aktivně se uživatel chová. Hlavní je nezapomínat, že všechny typy oken jsou založeny na datech/časech záznamů, nikoli na systémovém čase.
Dále implementujeme naši topologii pro každý typ oken. Kompletní kód bude uveden pouze v první ukázce; pro ostatní typy oken se nic nezmění, kromě typu operace okna.
Sezónní okna
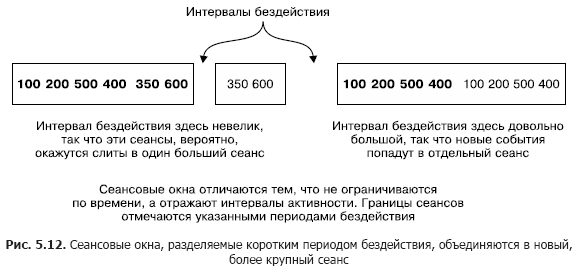
Sezónní okna se výrazně liší od všech ostatních typů oken. Jsou omezená nejen časem, ale také aktivitou uživatele (nebo aktivitou entity, kterou chcete sledovat). Sezónní okna jsou vymezená obdobími neaktivity.
Obrázek 5.12 ilustruje pojem sezónních oken. Menší seance se sloučí se seancí nalevo od něj. A seance napravo bude oddělená, protože následuje dlouhé období neaktivity. Sezónní okna se zakládají na aktivitách uživatelů, ale používají časová razítka z záznamů k určení, k jaké seanci daný záznam patří.
Použití sezónních oken pro sledování burzovních transakcí
Využijeme sezónní okna k zachycení informací o burzovních transakcích. Implementace sezónních oken je znázorněna v úryvku 5.5 (který naleznete v souboru src/main/java/bbejeck/chapter_5/CountingWindowingAndKTableJoinExample.java).
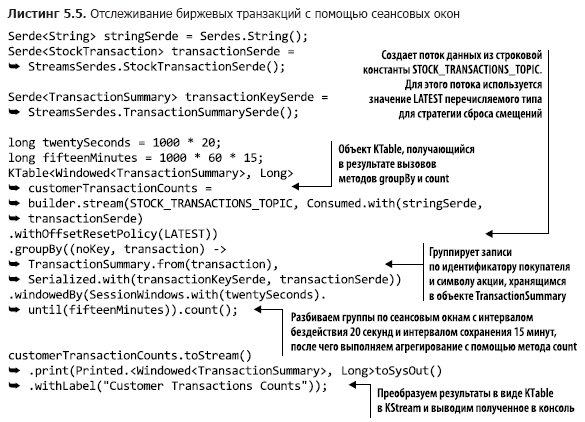
Většinu operací této topologie jste již viděli, takže není nutné je znovu procházet. Ale jsou tu i některé nové prvky, které si nyní probereme.
Při každé operaci groupBy se obvykle provádí nějaká agregační operace (agregace, sloučení nebo počítání). Můžete provést buď kumulativní agregaci s průběžným součtem, nebo oknovou agregaci, při níž se zohledňují záznamy v rámci daného časového okna.
Kód z úryvku 5.5 počítá počet transakcí v rámci sezónních oken. Na obr. 5.13 jsou tyto akce analyzovány krok za krokem.
Pomocí volání windowedBy(SessionWindows.with(twentySeconds).until(fifteenMinutes)) vytváříme sezónní okno s intervalem neaktivity 20 sekund a uchovávacím intervalem 15 minut. Interval neaktivity 20 sekund znamená, že aplikace zahrnuje jakýkoli záznam, který přichází během 20 sekund od konce nebo začátku aktuální seance do aktuální (aktivní) seance.
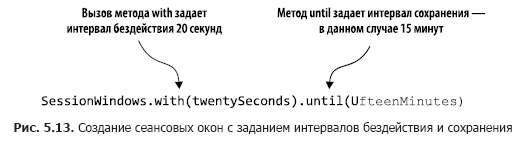
Dále uvádíme, jakou agregační operaci je třeba provést ve sezení — v tomto případě count. Pokud příchozí záznam přesáhne dobu nečinnosti (z kterékoliv strany od časové značky), aplikace vytvoří nové sezení. Interval uchování znamená udržet sezení po určitou dobu a umožňuje zpožděná data, která vycházejí za období nečinnosti sezení, ale stále mohou být připojena. Kromě toho začátek a konec nového sezení, které vzniklo sloučením, odpovídají nejstarší a nejnovější časové značce.
Podíváme se na několik záznamů z metody count, abychom viděli, jak se sezení chovají (tab. 5.1).
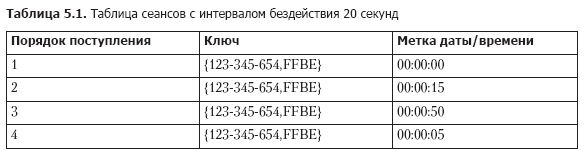
Při přijímání záznamů hledáme již existující sezení se stejným klíčem, u nichž je čas ukončení menší než aktuální časová značka — interval nečinnosti a čas zahájení větší než aktuální časová značka + interval nečinnosti. S ohledem na to se čtyři záznamy z tab. 5.1 sloučí do jednoho sezení následujícím způsobem.
1. Jako první přichází záznam 1, takže čas zahájení je rovný času ukončení a odpovídá 00:00:00.
2. Dále přichází záznam 2, a hledáme sezení končící nejdříve v 23:59:55 a začínající nejpozději v 00:00:35. Nalezneme záznam 1 a spojíme sezení 1 a 2. Bereme čas zahájení sezení 1 (starší) a čas ukončení sezení 2 (pozdější), takže naše nové sezení začíná v 00:00:00 a končí v 00:00:15.
3. Přichází záznam 3, hledáme sezení mezi 00:00:30 a 00:01:10 a nenajdeme žádné. Přidáváme druhé sezení pro klíč 123-345-654,FFBE, které začíná a končí v 00:00:50.
4. Přichází záznam 4, a hledáme sezení mezi 23:59:45 a 00:00:25. Tentokrát se naleznou obě sezení — 1 a 2. Všechna tři sezení se sloučí do jednoho, s časem zahájení 00:00:00 a časem ukončení 00:00:15.
Z toho, co jsme probrali v této kapitole, si zapamatujte následující důležité skutečnosti:
- sezení — nejsou okna pevné velikosti. Délka sezení je určena aktivitou v rámci daného časového intervalu;
- časové značky v datech určují, zda událost spadá do existujícího sezení nebo do období nečinnosti.
Dále probereme další variantu oken — „kotoučová“ okna.
„Kotoučová“ okna
„Tumbling“ okna zachycují události, které přicházejí v určitém časovém intervalu. Představte si, že potřebujete zachytit všechny burzovní transakce určité společnosti každých 20 sekund, takže shromažďujete všechny události za tento časový úsek. Po uplynutí 20sekundového intervalu se okno „přetáčí“ a přechází na nový 20sekundový interval sledování. Obrázek 5.14 ilustruje tuto situaci.
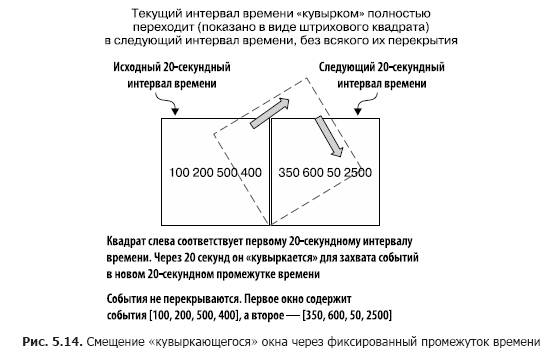
Jak vidíte, všechny události, které přišly za posledních 20 sekund, jsou zahrnuty do okna. Po uplynutí tohoto časového úseku se vytvoří nové okno.
V výpisu 5.6 je uveden kód, který demonstruje použití „tumbling“ oken pro zachytávání burzovních transakcí každých 20 sekund (nachází se v souboru src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java).
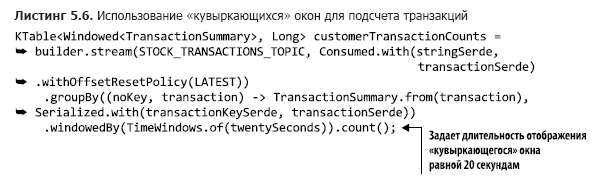
Díky této malé změně v volání metody TimeWindows.of je možné použít „tumbling“ okno. V tomto příkladu není volání metody until(), což znamená, že bude použito výchozí uchovávací období, tedy 24 hodin.
Nakonec přejdeme k poslednímu typu oken — „hopping“ (skákací) oknům.
Klouzavá („hopping“) okna
Klouzavá/„hopping“ (sliding/hopping) okna jsou podobná „tumbling“ oknům, ale s menším rozdílem. Klouzavá okna nečekají na skončení časového intervalu, než vytvoří nové okno pro zpracování nedávných událostí. Nové výpočty spouštějí po intervalu čekání, který je kratší než doba okna.
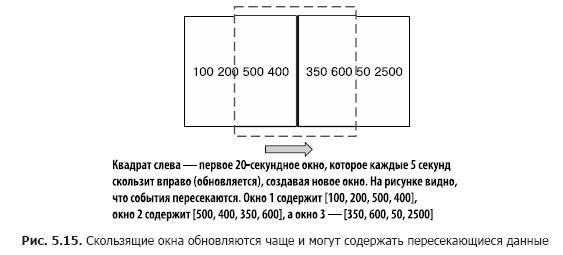
Abychom ilustrovali rozdíly mezi „tumbling“ a „hopping“ okny, vraťme se k příkladu s počítáním burzovních transakcí. Naším cílem zůstává počítat počet transakcí, ale nechceme čekat celý časový úsek před aktualizací počítače. Místo toho budeme aktualizovat počítadlo v kratších časových intervalech. Například budeme nadále počítat počet transakcí každých 20 sekund, ale počítadlo budeme aktualizovat každých 5 sekund, jak je ukázáno na obr. 5.15. Tímto získáme tři výsledková okna s překrývajícími se daty.
V výpisu 5.7 je uveden kód pro nastavení klouzavých oken (nachází se v souboru src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java).
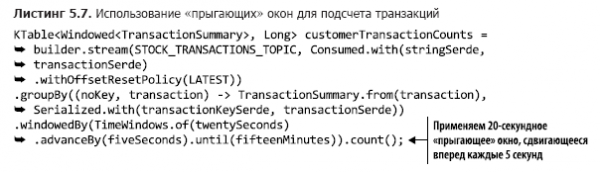
Okno „skákající“ lze převést na „převržené“ pomocí přidání volání metody advanceBy(). V uvedeném příkladu je interval uchovávání nastaven na 15 minut.
V této části jste se dozvěděli, jak omezit výsledky agregace časovými okny. Zejména si zapamatujte z této části následující tři věci:
- velikost sezení není omezena časovým intervalem, ale aktivitou uživatelů;
- „převržená“ okna poskytují pohled na události v rámci stanoveného časového období;
- doba trvání „skákajících“ oken je pevně stanovena, ale často se aktualizují a mohou obsahovat v různých oknech překrývající se záznamy.
Dále se dozvíme, jak převést KTable zpět na KStream pro spojení.
5.3.3. Spojení objektů KStream a KTable
V kapitole 4 jsme probírali spojení dvou objektů KStream. Nyní se musíme naučit spojit KTable a KStream. Může to být potřeba z následujícího jednoduchého důvodu. KStream je proud záznamů, zatímco KTable je proud aktualizací záznamů, ale někdy může být nutné přidat další kontext k proudu záznamů pomocí aktualizací z KTable.
Vezmeme si data o počtu burzovních transakcí a spojíme je s burzovními novinkami podle odpovídajících průmyslových odvětví. Tady je to, co musíme udělat, abychom toho dosáhli s ohledem na již existující kód.
- Převést objekt KTable s daty o počtu burzovních transakcí na KStream, přičemž klíč nahradíme klíčem, který označuje průmyslové odvětví odpovídající danému akciovému symbolu.
- Vytvořit objekt KTable, který čte data z tématu s burzovními novinkami. Tento nový KTable bude kategorizován podle průmyslových odvětví.
- Spojit aktualizace zpráv s informacemi o počtu burzovních transakcí podle průmyslových odvětví.
Nyní se podívejme, jak tento plán realizovat.
Převod KTable na KStream
Pro převod KTable na KStream je třeba učinit následující.
- Zavolat metodu KTable.toStream().
- Pomocí volání metody KStream.map nahradit klíč názvem průmyslového odvětví a poté extrahovat z instance Windowed objekt TransactionSummary.
Tyto operace zřetězíme následujícím způsobem (kód lze nalézt v souboru src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java) (listing 5.8).
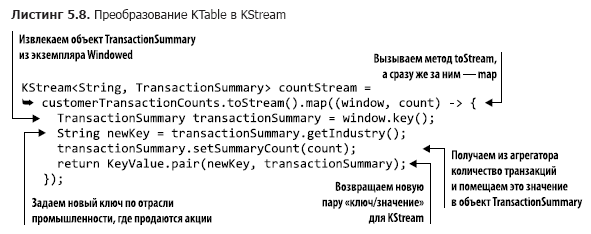
Pokud vykonáváme operaci KStream.map, je opětovné členění pro vrácený instance KStream provedeno automaticky při jeho použití v joinu.
Dokončili jsme proces transformace, nyní musíme vytvořit objekt KTable pro čtení burzovních zpráv.
Vytváření KTable pro burzovní zprávy
Naštěstí stačí k vytvoření objektu KTable jediný řádek kódu (tento kód lze nalézt v souboru src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java) (výpis 5.9).
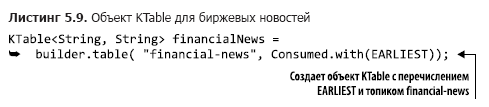
Je třeba poznamenat, že není nutné uvádět žádné objekty Serde, protože v nastavení jsou použity řetězcové Serde. Díky použití enumerace EARLIEST je tabulka plněna záznamy na samém začátku.
Nyní se můžeme přesunout k poslednímu kroku — joinu.
Spojení aktualizací zpráv s údaji o počtu transakcí
Vytvoření spojení není nijak složité. Použijeme levé spojení pro případ, že v příslušné oblasti není žádná burzovní zpráva (potřebný kód lze nalézt v souboru src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java) (výpis 5.10).
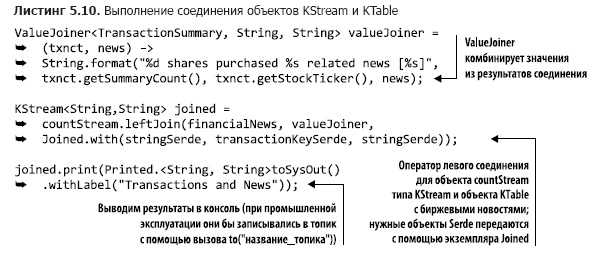
Tento operátor leftJoin je dost jednoduchý. Na rozdíl od spojení z kapitoly 4 se metoda JoinWindow nepoužívá, protože při provádění spojení KStream-KTable je pro každý klíč v KTable přítomen pouze jeden záznam. Toto spojení není časově omezeno: záznam buď je v KTable, nebo není. Hlavní závěr: s pomocí objektů KTable lze obohacovat KStream méně často aktualizovanými referenčními daty.
A nyní se podíváme na efektivnější způsob obohacení událostí z KStream.
5.3.4. Objekty GlobalKTable
Jak jste pochopili, existuje potřeba obohacení proudení událostí nebo přidání kontextu. V kapitole 4 jste viděli spojení dvou objektů KStream, a v předchozí části spojení KStream a KTable. Ve všech těchto případech je nutné opětovné členění datového proudu při mapování klíčů na nový typ nebo hodnotu. Někdy se opětovné členění provádí explicitně, jindy to Kafka Streams dělá automaticky. Opětovné členění je nutné, protože klíče se změnily a záznamy musí být v nových sekcích, jinak nebude spojení možné (to bylo diskutováno v kapitole 4, v bodě „Opětovné členění dat“ podkapitoly 4.2.4).
Opakované dělení má svou cenu
Opakované dělení vyžaduje náklady – další náklady na vytváření mezilehlých témat, uchovávání duplicitních dat v dalším tématu; také to znamená zvýšení latence v důsledku zápisu a čtení z tohoto tématu. Kromě toho, pokud je třeba provést spojení na více než jednom aspektu nebo dimenzi, je nutné uspořádat spojení v řetězci, zobrazit záznamy s novými klíči a znovu provést proces opakovaného dělení.
Spojení s menšími datovými sadami
V některých případech je objem referenčních dat, se kterými se plánuje spojení, relativně malý, takže jejich úplné kopie se mohou pohodlně vejít lokálně na každém z uzlů. Pro takové situace je v Kafka Streams k dispozici třída GlobalKTable.
Instancí GlobalKTable je unikátní, protože aplikace replikují všechna data na každý z uzlů. A protože na každém z uzlů jsou všechna data, není nutné dělit tok událostí podle klíče referenčních dat, aby byl dostupný všem sekcím. Pomocí objektů GlobalKTable lze také provádět bezklíčová spojení. Vraťme se k jednomu z předchozích příkladů, abychom demonstrovali tuto možnost.
Spojení objektů KStream s objekty GlobalKTable
V pododdíle 5.3.2 jsme provedli okno agregace burzovních transakcí podle zákazníků. Výsledky této agregace vypadaly přibližně takto:
{customerId='074-09-3705', stockTicker='GUTM'}, 17
{customerId='037-34-5184', stockTicker='CORK'}, 16
I když tyto výsledky odpovídaly stanovenému cíli, bylo by pohodlnější, kdyby se také zobrazovalo jméno zákazníka a úplný název společnosti. Chcete-li přidat jméno zákazníka a název společnosti, můžete provádět běžná spojení, ale bude třeba provést dvě mapování klíčů a opakované dělení. S pomocí GlobalKTable lze těmto nákladům předejít.
K tomu využijeme objekt countStream z výpisu 5.11 (příslušný kód naleznete v souboru src/main/java/bbejeck/chapter_5/GlobalKTableExample.java), který spojíme se dvěma objekty GlobalKTable.
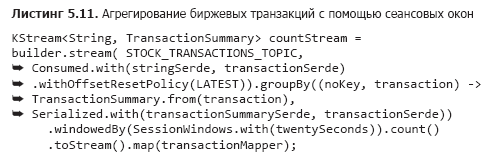
O této záležitosti jsme již hovořili dříve, takže se nebudu opakovat. Ale rád bych poznamenal, že kód v funkci toStream().map byl pro lepší čitelnost abstrahován do objektu-funkce namísto vloženého lambda výrazu.
Dalším krokem je deklarace dvou instancí GlobalKTable (přiložený kód najdete v souboru src/main/java/bbejeck/chapter_5/GlobalKTableExample.java) (listing 5.12).
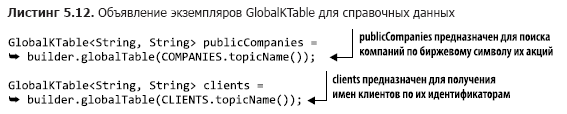
Všimněte si, že názvy témat jsou popsány pomocí výčtových typů.
Nyní, když jsme připravili všechny komponenty, zbývá napsat kód pro spojení (který lze nalézt v souboru src/main/java/bbejeck/chapter_5/GlobalKTableExample.java) (listing 5.13).
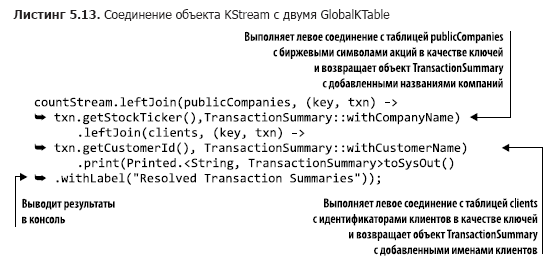
I když tento kód obsahuje dvě spojení, jsou organizována do řetězce, protože ani jeden z jejich výsledků není používán samostatně. Výsledky se zobrazují na konci celé operace.
Při spuštění výše uvedené operace spojení získáte výsledky následujícího druhu:
{customer='Barney, Smith' company="Exxon", transactions= 17}Podstata se nezměnila, ale tyto výsledky vypadají mnohem srozumitelněji.
Pokud počítáte kapitolu 4, již jste viděli několik typů spojení v akci. Jsou uvedeny v tab. 5.2. Tato tabulka zobrazuje možnosti spojení aktuální pro verzi 1.0.0 Kafka Streams; v budoucích vydáních se může něco změnit.
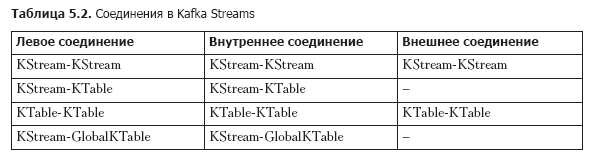
Na závěr bych chtěl připomenout hlavní myšlenku: můžete spojovat streamy událostí (KStream) a streamy aktualizací (KTable) pomocí lokálního stavu. Navíc, pokud není velikost referenčních dat příliš velká, je možné využít objekt GlobalKTable. GlobalKTable replikuje všechny sekce na každý uzel aplikace Kafka Streams, což zajišťuje dostupnost všech dat bez ohledu na to, která sekce se zprávě odpovídá klíč.
Dále uvidíme možnost Kafka Streams, která umožňuje sledovat změny stavu bez spotřeby dat z tématu Kafka.
5.3.5. Dostupný stav pro dotazy
Již jsme provedli několik operací se stavem a vždy jsme zobrazovali výsledky v konzoli (pro vývojové účely) nebo je zapisovali do tématu (pro průmyslové účely). Při zápisu výsledků do tématu je nutné použít spotřebitele Kafka pro jejich zobrazení.
Čtení dat z těchto témat lze považovat za formu materializovaných zobrazení. Pro naše účely můžeme použít definici materializovaného zobrazení z „Wikipedie“: „…fyzický objekt databáze, který obsahuje výsledky provedení dotazu. Například může být lokální kopií vzdálených dat, nebo podmnožinou řádků a/nebo sloupců tabulky či výsledků spojení, nebo souhrnnou tabulkou získanou pomocí agregace“ (https://en.wikipedia.org/wiki/Materialized_view).
Kafka Streams také umožňuje provádět interaktivní dotazy na úložištích stavu, což umožňuje přímé čtení těchto materializovaných zobrazení. Je důležité poznamenat, že dotaz na úložiště stavu má charakter operace „pouze pro čtení“. Díky tomu se nemusíte obávat náhodného vzniku nesouladu stavu během zpracování dat aplikací.
Možnost přímých dotazů na úložiště stavu má velký význam. Znamená to, že lze vytvářet aplikace — informační panely, aniž by bylo nutné nejprve získávat data od spotřebitele Kafka. Zvyšuje také efektivitu aplikace díky tomu, že není potřeba znovu zapisovat data:
- díky lokalitě dat k nim lze rychle přistupovat;
- vylučuje se duplicita dat, protože se neukládají do externího úložiště.
Hlavní, co bych chtěl, abyste si zapamatovali: dotazy na stav lze provádět přímo z aplikace. Nelze podceňovat možnosti, které vám to dává. Místo spotřeby dat z Kafka a ukládání záznamů do databáze pro aplikaci můžete provádět dotazy na úložiště stavu se stejným výsledkem. Přímé dotazy na úložiště stavu znamenají menší objem kódu (žádný spotřebitel) a méně softwaru (žádná potřeba tabulky databáze pro ukládání výsledků).
V této kapitole jsme pokryli značné množství informací, proto nyní přerušíme naši diskusi o interaktivních dotazech na úložiště stavu. Ale nebojte se: v kapitole 9 vytvoříme jednoduchou aplikaci – informační panel s interaktivními dotazy. Kromě toho, že v něm budou demonstrovány interaktivní dotazy a možnosti jejich začlenění do aplikací Kafka Streams, budou zde použity některé příklady z této a předchozí kapitoly.
Shrnutí
- Objekty KStream představují proudy událostí, které se podobají vkládání do databáze. Objekty KTable představují proudy aktualizací, jsou více podobné aktualizacím v databázi. Velikost objektu KTable se nezvyšuje, staré záznamy jsou nahrazovány novými.
- Objekty KTable jsou nezbytné pro agregace.
- Pomocí oknových operací je možné rozdělit agregovaná data do časových kontejnérů.
- Díky objektům GlobalKTable je možné přistupovat k referenčním datům z jakéhokoli místa aplikace, bez ohledu na rozdělení podle částí.
- Možná spojení mezi objekty KStream, KTable a GlobalKTable.
Dosud jsme se soustředili na vytváření aplikací Kafka Streams pomocí vysoceúrovňového DSL KStream. Ačkoli vysoceúrovňový přístup umožňuje psát elegantní a stručné programy, jeho použití představuje určitou kompromis. Práce s DSL KStream znamená zlepšení stručnosti kódu na úkor kontroly. V následující kapitole prozkoumáme nízkoúrovňové API uzlů zpracovatelů a vyzkoušíme další kompromisy. Programy se stanou delšími, než byly dosud, ale získáme možnost vytvářet prakticky jakýkoli uzel zpracovatele, který budeme potřebovat.
→ O knize se lze podrobněji seznámit na
→ Pro uživatele Habr slevový kód 25% — Kafka Streams
→ Po úhradě tištěné verze knihy bude na e-mail odeslána elektronická kniha.
Zdroj: habr.com
