

Rád bych vám představil zajímavý mechanismus práce s konfigurací distribuovaného systému. Konfigurace je přímo představena v kompilovaném jazyce (Scala) s využitím bezpečných typů. V tomto příspěvku bude rozebrán příklad takové konfigurace a prozkoumáno více aspektů zavádění kompilované konfigurace do celkového vývoje.
()
Úvod
Budování spolehlivého distribuovaného systému znamená, že na všech uzlech je používána správná konfigurace, která je synchronizována s ostatními uzly. Obvykle se používají technologie DevOps (terraform, ansible nebo něco podobného) k automatickému generování konfiguračních souborů (často vlastních pro každý uzel). Také bychom chtěli mít jistotu, že na všech interagujících uzlech jsou používány identické protokoly (včetně stejné verze). Jinak bude naše distribuovaná soustava obsahovat nesoulad. Ve světě JVM jedním z důsledků tohoto požadavku je potřeba používat všude tutéž verzi knihovny, která obsahuje zprávy protokolu.
Jak je to s testováním distribuovaného systému? Předpokládáme, že pro všechny komponenty jsou zajištěny unit-testy před tím, než přejdeme k integračnímu testování. (Abychom mohli extrapolovat výsledky testování na runtime, musíme také zajistit identickou sadu knihoven v testovací fázi a v runtime.)
Při práci s integračními testy je často jednodušší používat všude jednotný classpath na všech uzlech. Musíme pouze zajistit, aby byl stejný classpath aktivován i v runtime. (I když je možné spouštět různé uzly s různými classpathy, to komplikuje celou konfiguraci a ztěžuje nasazení a integrační testy.) V rámci tohoto příspěvku předpokládáme, že na všech uzlech bude použit stejný classpath.
Konfigurace se vyvíjí spolu s aplikací. Pro identifikaci různých fází evoluce programů používáme verze. Zdá se logické také identifikovat různé verze konfigurací. A samotnou konfiguraci umístit do systému správy verzí. Pokud v produkci existuje jediná konfigurace, můžeme použít prostě číslo verze. Pokud však existuje více instancí produkce, budeme potřebovat několik
větví konfigurace a další označení kromě verze (například název větve). Tímto způsobem budeme moci jednoznačně identifikovat přesnou konfiguraci. Každý identifikátor konfigurace odpovídá konkrétní kombinaci distribuovaných uzlů, portů, externích zdrojů a verzí knihoven. V rámci tohoto příspěvku budeme vycházet z toho, že existuje pouze jedna větev, a můžeme identifikovat konfiguraci běžným způsobem použitím tří čísel oddělených tečkou (1.2.3).
V moderních prostředích se konfigurační soubory ručně vytvářejí poměrně zřídka. Častěji jsou generovány během nasazení a poté se s nimi už nejedná (abychom ). Vzniká logická otázka, proč stále používáme textový formát pro ukládání konfigurací? Poměrně životaschopnou alternativou se jeví možnost používat běžný kód pro konfiguraci a získat výhody díky kontrole během kompilace.
V tomto příspěvku právě zkoumáme myšlenku reprezentace konfigurace uvnitř kompilovaného artefaktu.
Kompilovaná konfigurace
V této části je uveden příklad statické kompilovatelné konfigurace. Realizovány jsou dvě jednoduché služby - echo služba a klient echo služby. Na základě těchto dvou služeb jsou sestaveny dvě varianty systému. V jedné variantě jsou obě služby umístěny na jednom uzlu, v druhé variantě - na různých uzlech.
Obvykle distribuovaný systém obsahuje několik uzlů. Uzly lze identifikovat pomocí hodnot určitého typu NodeId:
sealed trait NodeId
case object Backend extends NodeId
case object Frontend extends NodeId
nebo
case class NodeId(hostName: String)nebo dokonce
object Singleton
type NodeId = Singleton.type
Uzlse plní různé role, na nich běží služby a mezi nimi mohou být navázána TCP/HTTP spojení.
Pro popis TCP spojení potřebujeme alespoň číslo portu. Také bychom chtěli reflektovat protokol, který je podporován na tomto portu, abychom zajistili, že jak klient, tak server používají stejný protokol. Budeme popisovat spojení pomocí následující třídy:
case class TcpEndPoint[Protocol](node: NodeId, port: Port[Protocol])kde Port — prostě celé číslo Int s uvedením rozsahu povolených hodnot:
type PortNumber = Refined[Int, Closed[_0, W.`65535`.T]]Upřesněné typy
Viz knihovna a . Stručně řečeno, knihovna umožňuje přidávat k typům omezení, která se ověřují při kompilaci. V tomto případě jsou povolenými hodnotami čísla portu celá 16bitová čísla. Pro kompilovanou konfiguraci použití knihovny refined není povinné, ale umožňuje vylepšit schopnosti kompilátoru při kontrole konfigurace.
Pro protokoly HTTP (REST) kromě čísla portu rovněž může být potřeba cesta k službě:
type UrlPathPrefix = Refined[String, MatchesRegex[W.`"[a-zA-Z_0-9\/]*"`.T]]
case class PortWithPrefix[Protocol](portNumber: PortNumber, pathPrefix: UrlPathPrefix)
Fantomové typy
Pro identifikaci protokolu během kompilace používáme parametr typu, který se uvnitř třídy nepoužívá. Toto řešení vychází z toho, že v runtime instance protokolu nepoužíváme, ale chtěli bychom, aby kompilátor kontroloval kompatibilitu protokolů. Určením protokolu nemůžeme předat nevhodnou službu jako závislost.
Jedním z běžných protokolů je REST API s Json-serializací:
sealed trait JsonHttpRestProtocol[RequestMessage, ResponseMessage]kde RequestMessage — typ požadavku, ResponseMessage — typ odpovědi.
Samozřejmě, že lze použít i další popisy protokolů, které zajišťují požadovanou přesnost popisu.
Pro účely tohoto příspěvku budeme používat zjednodušenou verzi protokolu:
sealed trait SimpleHttpGetRest[RequestMessage, ResponseMessage]Zde požadavek představuje řetězec přidávaný k url, a odpověď — vracený řetězec v těle HTTP odpovědi.
Konfigurace služby je popsána jménem služby, porty a závislostmi. Tyto prvky lze v Scala představit několika způsoby (např. HList-y, algebraickými typy dat). Pro účely tohoto příspěvku budeme používat Cake Pattern a představovat moduly pomocí traitů. (Cake Pattern není povinnou součástí popisovaného přístupu. Je to jen jedna z možných realizací.)
Závislosti mezi službami lze představit jako metody, které vracejí porty EndPointy dalších uzlů:
  type EchoProtocol[A] = SimpleHttpGetRest[A, A]

  trait EchoConfig[A] extends ServiceConfig {
    def portNumber: PortNumber = 8081
    def echoPort: PortWithPrefix[EchoProtocol[A]] = PortWithPrefix[EchoProtocol[A]](portNumber, "echo")
    def echoService: HttpSimpleGetEndPoint[NodeId, EchoProtocol[A]] = providedSimpleService(echoPort)
  }
Pro vytvoření echo služby stačí pouze číslo portu a určení, že tento port podporuje echo protokol. Mohli bychom také neuvedit konkrétní port, protože trait'y umožňují deklarovat metody bez implementace (abstraktní metody). V tomto případě by při vytváření konkrétní konfigurace kompilátor vyžadoval, abychom poskytli implementaci abstraktní metody a uvedli číslo portu. Protože jsme metodu implementovali, při vytváření konkrétní konfigurace můžeme jiný port neuvedit. Bude použita výchozí hodnota.
V konfiguraci klienta deklarujeme závislost na echo službě:
  trait EchoClientConfig[A] {
    def testMessage: String = "test"
    def pollInterval: FiniteDuration
    def echoServiceDependency: HttpSimpleGetEndPoint[_, EchoProtocol[A]]
  }
Závislost má stejný typ jako exportovaná služba echoService. Konkrétně v echo klientu vyžadujeme stejný protokol. Proto při spojení dvou služeb můžeme být jisti, že vše bude fungovat správně.
Implementace služeb
Pro spuštění a zastavení služby potřebujeme funkci. (Možnost zastavit službu je kriticky důležitá pro testování.) Opět existuje několik variant implementace takové funkce (například bychom mohli použít typové třídy na základě typu konfigurace). Pro účely tohoto příspěvku využijeme Cake Pattern. Budeme představovat službu pomocí třídy cats.Resource, protože v této třídě jsou již zahrnuty prostředky pro bezpečné zajištění uvolnění prostředků v případě problémů. Abychom získali prostředek, musíme poskytnout konfiguraci a připravený runtime kontext. Funkce spuštění služby může mít následující podobu:
  typ ResourceReader[F[_], Config, A] = Reader[Config, Resource[F, A]]

  trait ServiceImpl[F[_]] {
    type Config
    def resource(
      implicit
      resolver: AddressResolver[F],
      timer: Timer[F],
      contextShift: ContextShift[F],
      ec: ExecutionContext,
      applicative: Applicative[F]
    ): ResourceReader[F, Config, Unit]
  }
kde
Nastavení— typ konfigurace pro tuto službuAddressResolver— objekt doby běhu, který umožňuje zjistit adresy dalších uzlů (viz níže)
a další typy z knihovny cats:
F[_]— typ efektu (v nejjednodušším případěF[A]může být prostou funkcí() => A. V tomto příspěvku budeme používatcats.IO.)Reader[A,B]— více či méně synonyma funkceA => Bcats.Resource— prostředek, který může být získán a uvolněnTimer— časovač (umožňuje vytvářet zpoždění a měřit časové intervaly)ContextShift— analogExecutionContextApplicative— typová třída efektu, která umožňuje spojit jednotlivé efekty (téměř monáda). V složitějších aplikacích se zřejmě lépe používáMonad/ConcurrentEffect.
Používáním této signatury funkce můžeme implementovat několik služeb. Například služba, která nic nedělá:
  trait ZeroServiceImpl[F[_]] extends ServiceImpl[F] {
    type Config  Resource.pure[F, Unit](()))
  }
(Viz. , ve které jsou implementovány jiné služby — ,
a .)
Uzlový objekt může spouštět několik služeb (spuštění řetězce zdrojů je zajištěno pomocí vzoru Cake):
object SingleNodeImpl extends ZeroServiceImpl[IO]
  with EchoServiceService
  with EchoClientService
  with FiniteDurationLifecycleServiceImpl
{
  type Config = EchoConfig[String] with EchoClientConfig[String] with FiniteDurationLifecycleConfig
}
Všimněte si, že uvádíme přesný typ konfigurace, který je potřebný pro tento uzel. Pokud zapomeneme uvést některý z typů konfigurace požadovaných jednotlivou službou, dojde k chybě při kompilaci. Také nebudeme moci spustit uzel, pokud neposkytujeme nějaký objekt, který má vhodný typ se všemi potřebnými daty.
Resoluce uzlových názvů
K připojení k vzdálenému uzlu potřebujeme skutečnou IP adresu. Je docela možné, že adresa bude známa později než ostatní části konfigurace. Proto potřebujeme funkci, která mapuje identifikátor uzlu na adresu:
case class NodeAddress[NodeId](host: Uri.Host)
trait AddressResolver[F[_]] {
  def resolve[NodeId](nodeId: NodeId): F[NodeAddress[NodeId]]
}
Můžeme navrhnout několik způsobů implementace takové funkce:
- Pokud se adresy stanou známými před nasazením, můžeme vygenerovat Scala kód s
adresami a poté spustit sestavení. Během toho bude provedena kompilace a provedeny testy.
V takovém případě bude funkce známa staticky a může být v kódu představena jako mapováníMap[NodeId, NodeAddress]. - V některých případech se skutečná adresa stane známou až po spuštění uzlu.
V takovém případě můžeme implementovat „objevovací službu“ (discovery), která bude spuštěna před ostatními uzly a všechny uzly se zaregistrují v této službě a požádají o adresy ostatních uzlů. - Pokud můžeme modifikovat
/etc/hosts, můžeme použít předem definovaná jména hostitelů (jako napříkladmy-project-main-nodeaecho-backend) a jednoduše tato jména
svázat s IP adresami během nasazení.
V rámci tohoto příspěvku se těmto případům nebudeme věnovat podrobněji. Pro náš
hračkový příklad budou mít všechny uzly jednu IP adresu — 127.0.0.1.
Nyní se podívejme na dvě varianty distribuované soustavy:
- Umístění všech služeb na jednom uzlu.
- A umístění echo služby a echo klienta na různých uzlech.
Konfigurace pro :
Konfigurace pro jeden uzel
objekt SingleNodeConfig extends EchoConfig[String]
  s EchoClientConfig[String] s FiniteDurationLifecycleConfig
{
  případný objekt Singleton

  typ NodeId = Singleton.type
  def nodeId = Singleton


  /** Specifikace portu služby typu safe. */
  override def portNumber: PortNumber = 8088


  /** Použijeme službu poskytovanou stejným hostitelem. */
  def echoServiceDependency = echoService

  override def testMessage: UrlPathElement = "hello"

  def pollInterval: FiniteDuration = 1.second


  def lifetime: FiniteDuration = 10500.milliseconds
}
Objekt implementuje konfiguraci jak klienta, tak serveru. Také se používá konfigurace životnosti, aby po uplynutí intervalu životnosti ukončila činnost programu. (Ctrl-C také funguje a správně uvolňuje všechny zdroje.)
Stejná sada traitů konfigurace a implementací může být použita k vytvoření systému, který se skládá z :
Konfigurace pro dva uzly
  objekt NodeServerConfig extends EchoConfig[String] with SigTermLifecycleConfig
  {
    typ NodeId = NodeIdImpl

    def nodeId = NodeServer

    override def portNumber: PortNumber = 8080
  }

  objekt NodeClientConfig extends EchoClientConfig[String] with FiniteDurationLifecycleConfig
  {

    def echoServiceDependency = NodeServerConfig.echoService

    def pollInterval: FiniteDuration = 1.second

    def lifetime: FiniteDuration = 10500.milliseconds

    def testMessage: String = "dolly"
  }
Důležité! Všimněte si, jak se provádí propojení služeb. Určujeme službu, kterou implementuje jeden uzel, jako implementaci závislostní metody jiného uzlu. Typ závislosti kontroluje kompilátor, protože obsahuje typ protokolu. Při spuštění bude závislost obsahovat správný identifikátor cílového uzlu. Díky této schémě uvádíme číslo portu pouze jednou a vždy se spolehlivě odkazujeme na správný port.
Implementace dvou uzlů systému
Pro tuto konfiguraci používáme stejné implementace služeb bez změn. Jediný rozdíl spočívá v tom, že nyní máme dva objekty, které implementují různé sady služeb:
  objekt TwoJvmNodeServerImpl extends ZeroServiceImpl[IO] with EchoServiceService with SigIntLifecycleServiceImpl {
    typ Config = EchoConfig[String] with SigTermLifecycleConfig
  }

  objekt TwoJvmNodeClientImpl extends ZeroServiceImpl[IO] with EchoClientService with FiniteDurationLifecycleServiceImpl {
    typ Config = EchoClientConfig[String] with FiniteDurationLifecycleConfig
  }
První uzel implementuje server a potřebuje pouze serverovou konfiguraci. Druhý uzel implementuje klienta a používá jinou část konfigurace. Také oba uzly potřebují správu životního cyklu. Serverový uzel běží neomezeně dlouho, dokud není zastaven SIGTERMa klientský uzel končí po nějaké době. Viz .
Celkový proces vývoje
Podívejme se, jak tento přístup k konfiguraci ovlivňuje celkový proces vývoje.
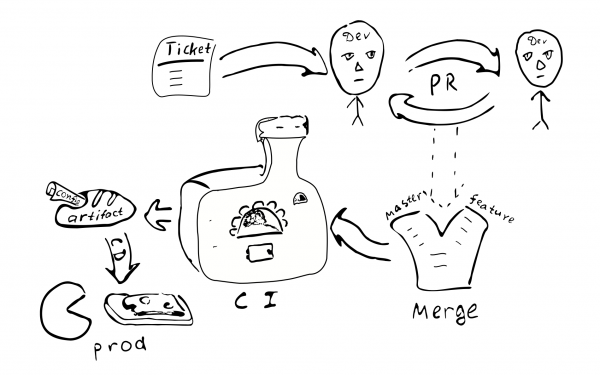
Konfigurace bude zkompilována společně s ostatním kódem a bude generován artefakt (.jar). Očividně dává smysl umístit konfiguraci do samostatného artefaktu. To souvisí s tím, že můžeme mít mnoho konfigurací na základě stejného kódu. Opět lze generovat artefakty odpovídající různým větvím konfigurace. Spolu s konfigurací se ukládají závislosti na konkrétní verze knihoven a tyto verze jsou uchovávány navždy, kdykoli se rozhodneme nasadit tuto verzi konfigurace.
Jakákoli změna konfigurace se promění ve změnu kódu. A proto každá taková
změna bude zahrnuta do běžného procesu zajištění kvality:
Ticket v bugtrackeru -> PR -> revize -> sloučení s příslušnými větvemi ->
integrace -> nasazení
Hlavní důsledky zavedení kompilovatelné konfigurace:
Konfigurace bude synchronizována na všech uzlech distribuovaného systému. Vzhledem k tomu, že všechny uzly získávají stejnou konfiguraci z jednoho zdroje.
Odmítnutí změny konfigurace pouze na jednom z uzlů je problematické. Proto je „desynchronizace konfigurace“ (configuration drift) velmi nepravděpodobná.
Stává se obtížnějším provádět malé změny v konfiguraci.
Většina změn konfigurace bude probíhat v rámci celého procesu vývoje a bude podrobena revizi.
Je potřeba samostatný repozitář pro ukládání produkční konfigurace? Taková konfigurace může obsahovat hesla a další tajné informace, k nimž bychom chtěli omezit přístup. Z toho vyplývá, že má smysl uchovávat konečnou konfiguraci v samostatném repozitáři. Můžeme rozdělit konfiguraci na dvě části — jednu obsahující veřejné konfigurační parametry a druhou, která obsahuje parametry s omezeným přístupem. To umožní většině vývojářů přístup k obecným parametrům. Takového rozdělení lze dosáhnout snadno pomocí mezitříd, které obsahují výchozí hodnoty.
Možné varianty
Pokud porovnáme kompilovanou konfiguraci s některými běžnými alternativami:
- Textový soubor na cílovém stroji.
- Centralizované úložiště klíč-hodnota (
etcd/zookeeper). - Komponenty procesu, které mohou být rekonfigurovány/ znovu spuštěny bez restartování procesu.
- Ukládání konfigurace mimo artefakt a kontrolu verzí.
Textové soubory poskytují značnou flexibilitu, pokud jde o malé změny. Systémový administrátor může přistoupit k vzdálenému uzlu, provést změny v odpovídajících souborech a restartovat službu. Pro větší systémy však může být taková flexibilita nežádoucí. Po provedených změnách nezůstávají stopy v jiných systémech. Nikdo nenabízí revizi změn. Obtížně se určuje, kdo přesně změny provedl a z jakého důvodu. Změny nejsou testovány. Pokud je systém distribuovaný, může administrátor zapomenout provést odpovídající změnu na dalších uzlech.
(Je třeba také poznamenat, že použití kompilované konfigurace neuzavírá možnost používání textových souborů v budoucnu. Stačí přidat parser a validator, které na výstupu dají stejný typ Nastavení, a můžeme používat textové soubory. Odtud přímo vyplývá, že složitost systému s kompilovanou konfigurací je o něco menší než složitost systému používajícího textové soubory, protože textové soubory vyžadují další kód.)
Centralizované úložiště klíč-hodnota je dobrým mechanismem pro distribuci metaparametrů distribuované aplikace. Měli bychom si ujasnit, co jsou konfigurační parametry a co jsou jednoduše data. Nechť máme funkci C => A => B, přičemž parametry C se zřídka mění, zatímco data A — se mění často. V takovém případě můžeme říci, že C — jsou konfigurační parametry, a A — jsou data. Zdá se, že konfigurační parametry se od dat liší tím, že se obecně mění méně často než data. Také data obvykle pocházejí z jednoho zdroje (od uživatele), zatímco konfigurační parametry z jiného (od administrátora systému).
Pokud je třeba zřídka se měnící parametry aktualizovat bez restartování programu, může to často vést ke zkomplikování programu, neboť budeme potřebovat nějakým způsobem dodávat parametry, uchovávat je, parsovat a kontrolovat, zpracovávat nesprávné hodnoty. Proto, z pohledu snížení složitosti programu, má smysl omezit počet parametrů, které se mohou měnit během chodu programu (nebo takové parametry vůbec nepodporovat).
Z pohledu tohoto příspěvku budeme rozlišovat mezi statickými a dynamickými parametry. Pokud logika služby vyžaduje změnu parametrů během běhu programu, nazveme tyto parametry dynamickými. V opačném případě jsou parametry statické a mohou být nakonfigurovány pomocí kompilovatelné konfigurace. Pro dynamickou rekonfiguraci může být potřeba mechanismus restartu částí programu s novými parametry, podobně jako je tomu u restartu procesů operačního systému. (Podle našeho názoru je lepší se vyhnout rekonfiguraci v reálném čase, protože tím roste složitost systému. Pokud je to možné, je lepší využívat standardní funkce OS pro restartování procesů.)
Jedním z důležitých aspektů používání statické konfigurace, který nutí lidi uvažovat o dynamickém rekonfigurování, je doba, kterou systém potřebuje na restart po aktualizaci konfigurace (downtime). Opravdu, pokud potřebujeme provést změny ve statické konfiguraci, budeme muset systém restartovat, aby nové hodnoty nabyly účinnosti. Problém downtime má různou závažnost pro různé systémy. V některých případech lze naplánovat restart na dobu, kdy je zátěž minimální. V případě, že je třeba zajistit nepřetržitou službu, můžeme implementovat . Když musíme restartovat systém, spustíme paralelní instanci tohoto systému, přepneme vyvažovač zátěže na něj a čekáme, až se stará spojení uzavřou. Jakmile se všechna stará spojení uzavřou, vypneme starou instanci systému.
Nyní se podívejme na otázku ukládání konfigurace uvnitř artefaktu nebo mimo něj. Pokud ukládáme konfiguraci uvnitř artefaktu, máme alespoň možnost během sestavení artefaktu zajistit správnost konfigurace. Pokud se konfigurace nachází mimo řízený artefakt, je těžké sledovat, kdo a proč provedl změny v tomto souboru. Jak důležité to je? Podle našeho názoru je pro mnoho produkčních systémů důležité mít stabilní a kvalitní konfiguraci.
Verze artefaktu umožňuje určit, kdy byl vytvořen, jaké hodnoty obsahuje, jaké funkce jsou zapnuté/vypnuté a kdo nese odpovědnost za jakékoli změny v konfiguraci. Samozřejmě, uchovávání konfigurace v artefaktu vyžaduje určité úsilí, proto je třeba učinit vědomé rozhodnutí.
Pro a proti
Chtěl bych se zaměřit na výhody a nevýhody navrhované technologie.
Výhody
Níže je uveden seznam hlavních funkcí kompilované konfigurace distribuovaného systému:
- Statická kontrola konfigurace. Umožňuje být si jisti, že
konfigurace je správná. - Bohatý jazyk konfigurace. Obvykle jsou jiné metody konfigurace omezeny maximálně na substituci řetězcových proměnných. Při použití Scaly se otevírá široká škála možností jazyka pro zlepšení konfigurace. Například můžeme použít
traity pro výchozí hodnoty, pomocí objektů skupinovat parametry, můžeme se odkazovat na valy, které jsou deklarovány jednou (DRY) ve zvané oblasti viditelnosti. Můžeme přímo uvnitř konfigurace instancovat jakékoli třídy (Seq,Mapa, vlastní třídy). - DSL. Scala má řadu jazykových možností, které usnadňují vytváření DSL. Můžeme využít tyto možnosti a realizovat jazyk konfigurace, který by byl pohodlnější pro cílovou skupinu uživatelů, takže by bylo minimálně čitelné odborníky v dané oblasti. Odborníci mohou například participovat na procesu revize konfigurace.
- Integrita a synchronizace mezi uzly. Jednou z výhod toho, že konfigurace celého distribuovaného systému je uchovávána na jediném místě, je to, že všechny hodnoty jsou deklarovány právě jednou a poté znovu použity všude, kde jsou potřeba. Použití fantomových typů pro deklarace portů umožňuje zaručit, že ve všech správných konfiguracích systému uzly používají kompatibilní protokoly. Přítomnost explicitních povinných závislostí mezi uzly zaručuje, že všechny služby budou navzájem propojeny.
- Vysoká kvalita provádění změn. Provádění změn v konfiguraci pomocí společného vývojového procesu zajišťuje vysoké standardy kvality i pro konfiguraci.
- Současná aktualizace konfigurace. Automatické nasazení systému po provedení změn v konfiguraci zajišťuje, že všechny uzly budou aktualizovány.
- Zjednodušení aplikace. Aplikace nepotřebuje parsování, kontrolu konfigurace a zpracování nesprávných hodnot. Tím se snižuje složitost aplikace. (Některé ztížení konfigurace, které pozorujeme v našem příkladu, není atributem kompilované konfigurace, nýbrž vědomým rozhodnutím, vyplývajícím z touhy zajistit větší typovou bezpečnost.) Je snadné se vrátit k obvyklé konfiguraci – stačí implementovat chybějící části. Proto je možné například začít s kompilovanou konfigurací, přičemž odložíme realizaci nadbytečných částí na dobu, kdy budou skutečně potřebné.
- Verzovaná konfigurace. Protože změny konfigurace následují běžný osud jakýchkoliv jiných změn, získáváme na výstupu artefakt s unikátní verzí. To nám například umožňuje vrátit se k předchozí verzi konfigurace, pokud je to nutné. Můžeme dokonce využít konfiguraci roční starosti a přitom systém bude fungovat přesně stejně. Stabilní konfigurace zlepšuje předvídatelnost a spolehlivost distribuovaného systému. Protože je konfigurace zafixována ve stádiu kompilace, je obtížné ji podvrhnout v produkci.
- Modularita. Navrhovaný rámec je modulární a moduly mohou být kombinovány v různých variantách pro získání různých systémů. Zvlášť je možné v jedné variantě konfigurovat systém pro spuštění na jednom uzlu, a v jiné – na více uzlech. Lze vytvořit několik konfigurací pro produkční instance systému.
- Testování. Nahrazením jednotlivých služeb mock-objekty lze získat několik verzí systému vhodných pro testování.
- Integrační testování. Přítomnost jednotné konfigurace celé distribuované systému umožňuje spouštění všech komponent v kontrolovaném prostředí v rámci integračního testování. Například je snadné emulovat situaci, kdy některé uzly jsou nedostupné.
Nevýhody a omezení
Kompilovaná konfigurace se liší od jiných přístupů k konfiguraci a pro některé aplikace může být nevhodná. Zde jsou některé nevýhody:
- Statická konfigurace. Někdy je potřeba rychle upravit konfiguraci v produkci, obejít všechny ochranné mechanismy. V rámci tohoto přístupu to může být složitější. V každém případě bude stále vyžadována kompilace a automatizované nasazení. To je zároveň užitečná vlastnost přístupu a nevýhoda v některých případech.
- Generování konfigurace. V případě, že je konfigurační soubor generován automatickým nástrojem, může být potřeba další úsilí pro integraci skriptu sestavení.
- Nástroje. V současnosti jsou utility a metodiky určené pro práci s konfigurací založeny na textových souborech. Ne všechny tyto utility/metodiky budou dostupné v případě kompilované konfigurace.
- Je potřeba změna pohledu. Vývojáři a DevOps si zvykli na textové soubory. Samotný nápad na kompilaci konfigurace může být poněkud nečekaný a nezvyklý a vyvolávat odpor.
- Požaduje kvalitní proces vývoje. Aby bylo možné pohodlně používat kompilovanou konfiguraci, je potřeba úplná automatizace procesu sestavení a nasazení aplikace (CI/CD). Jinak to bude dost nepohodlné.
Také se zaměříme na některá omezení uvedeného příkladu, která nejsou spojena s myšlenkou kompilované konfigurace:
- Pokud poskytujeme nadbytečné konfigurační informace, které uzel nepoužívá, kompilátor nám nepomůže zjistit, že implementace chybí. Tento problém lze vyřešit, pokud se vzdáme Cake Patternu a použijeme přísnější typy, například
HListnebo algebraické datové typy (case classy) pro reprezentaci konfigurace. - V konfiguračním souboru jsou řetězce, které se netýkají přímo konfigurace: (
balíček,import, prohlášení objektů;override defPro parametry s výchozími hodnotami se to dá částečně vyhnout, pokud implementujete vlastní DSL. Kromě toho jiné typy konfigurace (například XML) také ukládají určité omezení na strukturu souboru. - V rámci tohoto příspěvku se nezabýváme dynamickou rekonfigurací klastra podobných uzlů.
Závěr
V tomto příspěvku jsme prozkoumali myšlenku prezentace konfigurace v zdrojovém kódu za použití rozvinutých možností typu systému Scala. Tento přístup může najít uplatnění v různých aplikacích jako náhrada tradičních přístupů k konfiguraci založených na xml nebo textových souborech. I když je náš příklad implementován v Scala, stejné myšlenky lze aplikovat na jiné kompilované jazyky (jako Kotlin, C#, Swift, …). Tento přístup lze vyzkoušet v jednom z následujících projektů, a pokud nebude vyhovovat, přejít na textové soubory a přidat chybějící detaily.
Samozřejmě, kompilovaná konfigurace vyžaduje vysoce kvalitní proces vývoje. Na oplátku to zajišťuje vysokou kvalitu a spolehlivost konfigurací.
Prozkoumaný přístup je možné rozšířit:
- Lze použít makra k provádění kontrol během kompilace.
- Lze implementovat DSL pro prezentaci konfigurace ve formátu přístupném koncovým uživatelům.
- Lze implementovat dynamické řízení zdrojů s automatickou úpravou konfigurace. Například při změně počtu uzlů v klastru je třeba, aby (1) každý uzel obdržel mírně odlišnou konfiguraci; (2) manažer klastra obdržel informace o nových uzlech.
Poděkování
Chtěl bych poděkovat Andreji Saksonovovi, Pavlu Popovovi a Antónu Nechájevovi za konstruktivní kritiku návrhu článku.
Zdroj: habr.com
