

Platforma umožňuje zautomatizovat vytváření , a to jak v infrastruktuře poskytovatelů cloudových služeb, na virtualizačních platformách, nebo v bare-metal systémech. Abychom vytvořili skutečně cloudovou platformu, museli jsme mít pod přísnou kontrolou všechny používané prvky, což zvýšilo spolehlivost složitého procesu automatizace.
Evidentním řešením se stalo použití jako standardu Red Hat Enterprise Linux CoreOS (varianty Red Hat Enterprise Linux) a CRI-O, a to z následujících důvodů...
Jelikož je námořní tematika velmi vhodná pro hledání analogií při vysvětlování fungování Kubernetes a kontejnerů, pokusíme se přiblížit obchodní problémy, které řeší CoreOS a CRI-O, na příkladu . V roce 1803 byla před Markem Brunelem postavena úloha vyrobit 100 tisíc bloků na plachty pro potřeby rostoucího námořního flotily Velké Británie. Plachtový blok je typ zařízení, které se používá pro uchycení lan k plachtám. Až do začátku 19. století byly tyto bloky vyráběny ručně, ale Brunel dokázal automatizovat výrobu a začít vyrábět standardizované bloky pomocí strojů. Automatizace tohoto procesu vedla k tomu, že všechny bloky byly prakticky identické, mohly být snadno vyměněny v případě poruchy a mohly být vyráběny ve velkém množství.
A teď si představte, že by Brunel musel tuto práci vykonat pro 20 různých modelů lodí (verzí Kubernetes) a pro pět různých planet se zcela odlišnými mořskými proudy a větry (cloudoví poskytovatelé). Navíc bylo nutné, aby všechny lodě (OpenShift clustry), bez ohledu na planety, po nichž se pluje, se chovaly stejně z pohledu kapitánů (operátorů spravujících provoz klastrů). Pokračujíce s námořními analogiemi, kapitánům lodí vůbec nezáleží na tom, jaké bloky na plachty (CRI-O) se používají na jejich lodích – pro ně je nejdůležitější, že tyto bloky jsou silné a spolehlivé.
Před OpenShift 4, jako cloudovou platformou, se nachází velmi podobný obchodní úkol. Nové uzly by měly být vytvářeny v okamžiku vytvoření clusteru, v případě selhání jednoho z uzlů, nebo při škálování clusteru. Při vytváření a inicializaci nového uzlu by měly být odpovídajícím způsobem nakonfigurovány i kritické komponenty hostitele, včetně CRI-O. Tak jako v každé jiné výrobě je potřeba na začátku dodat „suroviny“. V případě lodí vystupují suroviny jako kov a dřevo. Nicméně, při vytváření hostitele pro nasazení kontejnerů v clusteru OpenShift 4 je třeba mít na vstupu konfigurační soubory a poskytované API servery. Poté OpenShift zajistí potřebnou úroveň automatizace po celou dobu životního cyklu a nabídne nezbytnou produktovou podporu pro koncové uživatele, čímž splácí investice do platformy.
OpenShift 4 byla navržena tak, aby umožnila pohodlnou aktualizaci systému po celou dobu životního cyklu platformy (pro verze 4.X) pro všechny hlavní poskytovatele cloudového výpočtu, virtualizačních platforem a dokonce bare metal systémů. Pro to musí být uzly vytvářeny na základě zaměnitelných prvků. Když cluster potřebuje novou verzi Kubernetes, získává také odpovídající verzi CRI-O na CoreOS. Vzhledem k tomu, že verze CRI-O je přímo vázána na Kubernetes, značně to zjednodušuje jakékoli manipulace za účelem testování, odstraňování problémů nebo podpory. Tento přístup také snižuje náklady pro koncové uživatele a Red Hat.
To je principiálně nový pohled na clustery Kubernetes, který zakládá základ pro plánování nových velmi užitečných a atraktivních funkcí. CRI-O (projekt otevřeného kontejneru Container Runtime Interface — Open Container Initiative, zkráceně CRI-OCI) se ukázal jako nejvhodnější volba pro hromadné vytváření uzlů, které je nezbytné pro práci s OpenShift. CRI-O nahradí dříve používaný engine Docker a nabídne uživatelům OpenShift – ano, neslyšeli jste špatně – nudný kontejnerový engine, navržený speciálně pro práci s Kubernetes.
Svět otevřených kontejnerů
Svět už dávno směřuje k otevřeným kontejnerům. Ať už v Kubernetes, nebo na nižších úrovních, vede k vzniku ekosystému inovací na každé úrovni.
Všechno začalo vytvořením iniciativy Open Containers Initiative Na této rané fázi byly formulovány specifikace kontejnerového a To umožnilo zajistit, že nástroje mohou používat jednotný standard a jednotný formát pro práci s nimi. Později byly přidány specifikace což uživatelům umožnilo snadno si vyměňovat .
Poté komunita Kubernetes vyvinula jednotný standard připojitelného rozhraní (pluggable interface), nazvaný Díky tomu mohli uživatelé Kubernetes připojit různé enginy pro práci s kontejnery navíc k Dockeru.
Inženýři Red Hat a Google si všimli existující potřeby na trhu po kontejnerovém enginu, který by mohl přijímat požadavky od Kubeletu prostřednictvím protokolu CRI, a představili kontejnery, které byly kompatibilní s výše zmíněnými specifikacemi OCI. Tak Ale počkejte, vždyť jsme říkali, že tento materiál bude věnován CRI-O? Ve skutečnosti ano, právě s vydáním byl projekt přejmenován na CRI-O.
Obr. 1.
Inovace s CRI-O a CoreOS
S uvedením platformy OpenShift 4 došlo ke změně , který se ve defaultní platformě používal, a místo Dockeru přišel CRI-O, který nabídl ekonomické, stabilní, jednoduché a nudné prostředí pro spuštění kontejneru, které se vyvíjí paralelně s Kubernetes. To výrazně usnadňuje údržbu a konfiguraci clusteru. Konfigurace kontejnerového enginu a hostitele, jakož i jejich správa se stává automatizovanou v rámci OpenShift 4.
Počkejte, jak to?
Přesně tak, s příchodem OpenShift 4 už není potřeba se připojovat k jednotlivým hostitelům a instalovat kontejnerový engine, konfigurovat úložiště, nastavovat servery pro vyhledávání nebo konfigurovat síť. Platforma OpenShift 4 byla kompletně přepracována pro použití nejen z pohledu uživatelských aplikací, ale také z hlediska základních operací na úrovni platformy, jako je nasazení obrazů, konfigurace systému nebo instalace aktualizací.
Kubernetes vždy dovoloval uživatelům řídit aplikace definováním požadovaného stavu a používáním , aby bylo zajištěno, že skutečný stav co nejvíce odpovídá určenému stavu. Tento otevírá velké možnosti jak z pohledu vývoje, tak z pohledu operací. Vývojáři mohou definovat požadovaný stav, operátorovi ve formátu YAML nebo JSON, a poté může operátor vytvořit v provozním prostředí potřebný instance aplikace, přičemž pracovní stav tohoto instance bude plně odpovídat určenému.
Používáním operátorů (Operators) v platformě, OpenShift 4 přináší tuto novou paradigmu (využívající koncepci stanoveného a skutečného stavu) do správy RHEL CoreOS a CRI-O. Úkoly konfigurace a správy verzí operačního systému a kontejnerového enginu jsou automatizovány pomocí tzv. . MCO výrazně usnadňuje práci administrátorům clusteru, fakticky automatizuje poslední fáze instalace a také následné operace po instalaci (denní operace). To vše činí OpenShift 4 skutečnou cloudovou platformou. K tomu se dostaneme později.
Spuštění kontejnerů
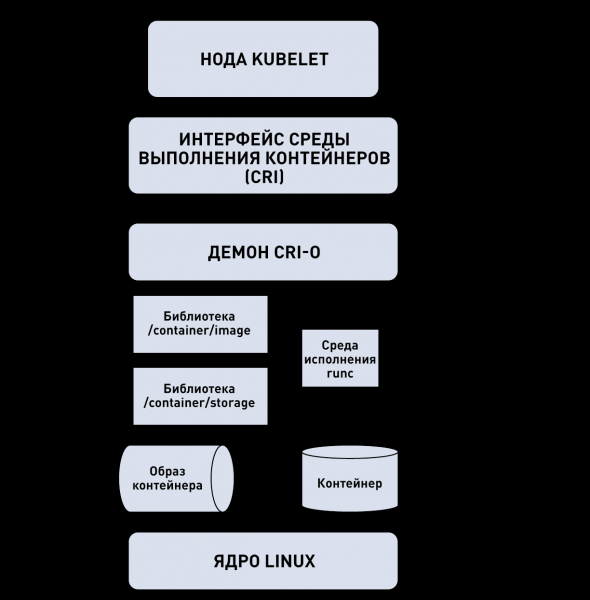
Uživatelé měli možnost využívat engine CRI-O na platformě OpenShift od verze 3.7 ve stavu Tech Preview a od verze 3.9 ve stavu Generally Available (aktuálně podporováno). Dále Red Hat masivně používá v OpenShift Online od verze 3.10. To vše umožnilo týmu pracujícímu na CRI-O získat obrovské zkušenosti s masovým spouštěním kontejnerů na velkých clusterech Kubernetes. Abychom získali základní představu o tom, jak Kubernetes využívá CRI-O, podívejme se na následující ilustraci, která znázorňuje princip fungování architektury.
Obr. 2. Jak fungují kontejnery v clusteru Kubernetes
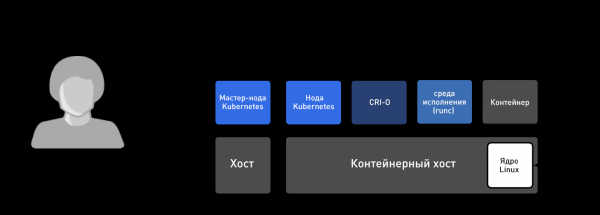
CRI-O usnadňuje tvorbu nových kontejnerových hostitelů synchronizací celé vrstvy při inicializaci nových uzlů a při vydávání nových verzí platformy OpenShift. Revize celé platformy umožňuje provádět transakční aktualizace a rollbacky, a také zabraňuje vzájemným blokacím v závislostech mezi jádrem kontejnerového hostitele, kontejnerovým enginem, uzly (Kubelets) a master uzlem Kubernetes. Při centralizované správě všech komponent platformy, s kontrolou a správou verzí, je vždy možné sledovat jasnou cestu z stavu A do stavu B. To usnadňuje proces aktualizací, zvyšuje bezpečnost, zlepšuje reportování výkonu a pomáhá snížit náklady na aktualizace a instalaci nových verzí.
Demonstrace síly výměnných prvků
Jak již bylo zmíněno, použití Machine Config Operator pro správu hostitele kontejneru a kontejnerového enginu v OpenShift 4 zajišťuje nový úroveň automatizace, která nebyla dříve možná na platformě Kubernetes. Abychom demonstrovali nové možnosti, ukážeme, jak byste mohli provádět změny v souboru crio.conf. Aby nedošlo k záměně v terminologii, snažte se soustředit na výsledky.
Nejprve vytvořme to, čemu říkáme konfigurace běhového prostředí kontejneru – Container Runtime Config. Považujte to za nějaký zdroj Kubernetes, který představuje konfiguraci pro CRI-O. Ve skutečnosti jde o specializovanou verzi toho, čemu se říká MachineConfig, která představuje jakoukoli konfiguraci nasazovanou na stroji RHEL CoreOS v rámci clusteru OpenShift.
Tento vlastní zdroj, nazývaný ContainerRuntimeConfig, byl navržen tak, aby usnadnil administrátorům clusteru konfiguraci CRI-O. Je to dostatečně výkonný nástroj, který lze použít pouze na určených uzlech v závislosti na nastaveních MachineConfigPool. Považujte to za skupinu strojů, které slouží pro stejný účel.
Věnujte pozornost dvěma posledním řádkům, které hodláme změnit v souboru /etc/crio/crio.conf. Tyto dva řádky jsou velmi podobné řádkům v souboru crio.conf, a to:
vi ContainerRuntimeConfig.yaml
Výstup:
apiVersion: machineconfiguration.openshift.io/v1
kind: ContainerRuntimeConfig
metadata:
 name: set-log-and-pid
spec:
 machineConfigPoolSelector:
   matchLabels:
     debug-crio: config-log-and-pid
 containerRuntimeConfig:
   pidsLimit: 2048
   logLevel: debug
Nyní tento soubor odešleme do clusteru Kubernetes a zkontrolujeme, že byl skutečně vytvořen. Všimněte si, že práce probíhá přesně tak, jako u jakéhokoliv jiného zdroje Kubernetes:
oc create -f ContainerRuntimeConfig.yaml
oc get ContainerRuntimeConfig
Výstup:
NAME              AGE
set-log-and-pid   22h
Poté, co jsme vytvořili ContainerRuntimeConfig, je třeba změnit jeden z MachineConfigPools, abychom dali Kubernetu najevo, že chceme tuto konfiguraci aplikovat na určitou skupinu strojů v clusteru. V tomto případě změníme MachineConfigPool pro master uzly:
oc edit MachineConfigPool/master
Výstup (pro přehlednost zachována hlavní podstata):
...
metadata:
 creationTimestamp: 2019-04-10T23:42:28Z
 generation: 1
 labels:
   debug-crio: config-log-and-pid
   operator.machineconfiguration.openshift.io/required-for-upgrade: ""
...
V tuto chvíli MCO začíná vytvářet nový soubor crio.conf pro cluster. Celý konfigurační soubor si můžete prohlédnout pomocí Kubernetes API. Nezapomeňte, že ContainerRuntimeConfig je pouze specializovaná verze MachineConfig, takže můžeme vidět výsledek, když se podíváme na potřebné řádky v MachineConfigs:
oc get MachineConfigs | grep rendered
Výstup:
rendered-master-c923f24f01a0e38c77a05acfd631910b                  4.0.22-201904011459-dirty 2.2.0 16h
rendered-master-f722b027a98ac5b8e0b41d71e992f626                  4.0.22-201904011459-dirty 2.2.0 4m
rendered-worker-9777325797fe7e74c3f2dd11d359bc62                  4.0.22-201904011459-dirty 2.2.0 16h
Všimněte si, že získaný konfigurační soubor pro master uzly má novější verzi než původní konfigurace. Pro zobrazení jej spustíte následující příkaz. Mimochodem, poznamenejme, že to môže byť jeden z nejlepších jednorázových skriptů v historii Kubernetes:
python3 -c "import sys, urllib.parse; print(urllib.parse.unquote(sys.argv[1]))" $(oc get MachineConfig/rendered-master-f722b027a98ac5b8e0b41d71e992f626 -o YAML | grep -B4 crio.conf | grep source | tail -n 1 | cut -d, -f2) | grep pid
Výstup:
pids_limit = 2048
Nyní se ujistíme, že konfigurace byla aplikována na všechny master uzly. Nejprve získáme seznam uzlů v clusteru:
oc get node | grep master

Výstup:

ip-10-0-135-153.us-east-2.compute.internal   Ready master 23h v1.12.4+509916ce1

ip-10-0-154-0.us-east-2.compute.internal     Ready master 23h v1.12.4+509916ce1

ip-10-0-166-79.us-east-2.compute.internal    Ready master 23h v1.12.4+509916ce1
Nyní prozkoumejme nainstalovaný soubor. Uvidíte, že soubor byl aktualizován podle nových hodnot direktiv pid a debug, které jsme uvedli ve zdroji ContainerRuntimeConfig. Samá elegance:
oc debug node/ip-10-0-135-153.us-east-2.compute.internal — cat /host/etc/crio/crio.conf | egrep 'debug||pid’
Výstup:
...pids_limit = 2048
...
log_level = "debug"
...
Veškeré tyto změny v clusteru byly provedeny i bez spuštění SSH. Celá práce byla provedena prostřednictvím dotazů k master uzlu Kubernetes. To znamená, že tyto nové parametry byly nakonfigurovány pouze na master uzlech. Pracovní uzly přitom zůstaly nezměněny, což demonstruje výhody metodologie Kubernetes využívající dané a aktuální stavy v souvislosti s hostiteli kontejnerů a kontejnerovými enginy se zaměnitelnými prvky.
Výše uvedený příklad ukazuje možnost provádět změny v malém clusteru OpenShift Container Platform 4 se třemi pracovními uzly nebo v obrovském produkčním clusteru se 3000 uzly. V obou případech bude objem práce stejný - a velmi malý - stačí nastavit soubor ContainerRuntimeConfig a změnit jednu značku (label) v MachineConfigPool. A to můžete provést s jakoukoli verzí platformy OpenShift Container Platform 4.X použité v Kubernetes během celého jejího životního cyklu.
Technologické společnosti často rostou tak rychle, že nedokážeme vysvětlit, proč vybíráme určité technologie pro základní komponenty. Kontejnerové enginy byly historicky tím komponentem, se kterým uživatelé interagují přímo. Jak popularita kontejnerů logicky začínala s příchodem kontejnerových enginů, uživatelé k nim často projevují zájem. To je další důvod, proč se Red Hat rozhodl pro CRI-O. Kontejnery se vyvíjejí, přičemž dnes je hlavní pozornost věnována orchestraci, a dospěli jsme k závěru, že CRI-O poskytuje nejlepší zkušenost při práci s OpenShift 4.
Zdroj: habr.com
