

Představme si situaci. V místnosti je zamčeno 5 koček a aby mohly vzbudit svého majitele, musí se nejprve dohodnout, protože dveře mohou otevřít pouze společně. Pokud je jedna z koček Schrödingerova kočka a ostatní kočky nevědí o jejím rozhodnutí, vyvstává otázka: „Jak to mohou udělat?“
V tomto článku vám jednoduše vysvětlím teoretické základy světa distribuovaných systémů a principy jejich fungování. Také se povrchně podívám na hlavní myšlenku, která stojí za Paxosem.
Když vývojáři využívají cloudové infrastruktury, různé databáze a pracují ve velkých klastrech uzlů, jsou si jisti, že data budou celistvá, zabezpečená a vždy dostupná. Ale odkud pramení tyto záruky?
V podstatě jsou záruky, které máme, zárukami poskytovatele. Ty jsou popsány v dokumentaci přibližně takto: „Tato služba je dostatečně spolehlivá, má stanovený SLA, nebojte se, vše bude fungovat rozděleně, jak očekáváte.“
Máme tendenci věřit v to nejlepší, neboť nám chytré hlavy z velkých společností zajistily, že vše bude v pořádku. Neptáme se otázky: proč to vlastně může fungovat? Existuje nějaké formální zdůvodnění správnosti fungování takových systémů?
Nedávno jsem byl na a byl jsem touto tematikou velmi inspirován. Přednášky na škole více připomínaly hodiny matematické analýzy než něco spojeného s počítačovými systémy. Ale právě takto byly v minulosti dokázány nejdůležitější algoritmy, které používáme každý den, aniž bychom o tom přemýšleli.
Většina moderních distribuovaných systémů používá konsenzuální algoritmus Paxos a jeho různé modifikace. Nejzajímavější je, že odůvodnění a v podstatě i samotná možnost existence tohoto algoritmu může být dokázána jednoduše pomocí papíru a pera. Na praktické stránce se algoritmus aplikuje ve velkých systémech, které pracují s obrovským počtem uzlů v cloudu.
Lehká ilustrace toho, o čem se bude dále mluvit: úloha dvou generálůPojďme pro zahřátí probrat .
Máme dvě armády – červenou a bílou. Bílé síly sídlí ve obléhaném městě. Červené síly vedené generály A1 a A2 jsou umístěny na obou stranách města. Úkolem červených je zaútočit na bílé město a zvítězit. Nicméně armáda každého červeného generála zvlášť je menší než armáda bílých.
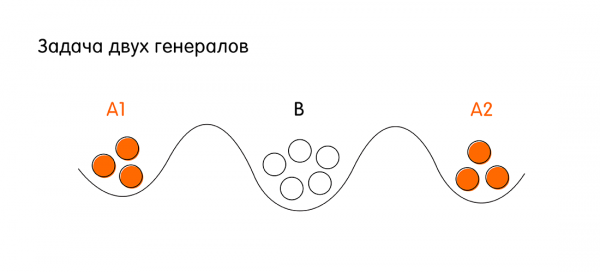
Podmínky vítězství pro červené: oba generálové musí zaútočit současně, aby měli početní výhodu nad bílými. K tomu se musí generálové A1 a A2 dohodnout. Pokud každý zaútočí samostatně, červení prohrají.
Aby se dohodli, mohou generálové A1 a A2 posílat posly jeden k druhému přes území bílého města. Posel může úspěšně dorazit k spojeneckému generálovi nebo může být zajat nepřítelem. Otázka zní: existuje taková sekvence komunikací mezi červenými generály (sekvence posílání poslů od A1 k A2 a naopak od A2 k A1), při které se zaručeně dohodnou na útoku v hodině X. Zde se pod zárukami rozumí, že oba generálové budou mít jednoznačné potvrzení, že jejich spojence (druhého generála) určitě zaútočí ve stanoveném čase X.
Předpokládejme, že A1 posílá posla k A2 s vzkazem: „Zaútočme dnes o půlnoci!“. Generál A1 nemůže zaútočit bez potvrzení od generála A2. Pokud posel od A1 dorazil, generál A2 posílá potvrzení s vzkazem: „Ano, pojďme dnes zničit bílé“. Ale nyní generál A2 neví, zda jeho posel dorazil či nikoliv, nemá žádné záruky, zda bude útok současný. Nyní potřebuje generál A2 znovu potvrzení.
Pokud podrobněji popíšeme jejich komunikaci, zjistí se následující: kolik cyklů výměny zpráv by nebylo, neexistuje způsob, jak zaručeně informovat oba generály o tom, že jejich zprávy byly přijaty (za předpokladu, že jakýkoli z posel může být chycen).
Úkol dvou generálů je skvělou ilustrací velmi jednoduchého distribuovaného systému, kde jsou dva uzly s nespolehlivou komunikací. To znamená, že nemáme 100% záruku toho, že se synchronizují. O podobných problémech jen v širším měřítku dále v článku.
Zavádíme pojem distribuovaných systémů.
Distribuovaný systém je skupina počítačů (dále je budeme nazývat uzly), které mohou vzájemně komunikovat prostřednictvím zpráv. Každý jednotlivý uzel je určitou autonomní entitou. Uzel může samostatně zpracovávat úkoly, ale aby mohl interagovat s jinými uzly, musí posílat a přijímat zprávy.
Jak konkrétně jsou zprávy realizovány a jaké protokoly se používají – to nás v tomto kontextu nezajímá. Důležité je, že uzly distribuovaného systému si mohou vzájemně vyměňovat data posíláním zpráv.
Samotná definice vypadá docela jednoduše, ale musíme brát v úvahu, že distribuovaný systém má řadu atributů, které budou pro nás důležité.
Atributy distribuovaných systémů
- Současnost – schopnost vzniku současných nebo konkurenčních událostí v systému. Dobře, budeme předpokládat, že události, které nastaly na dvou různých uzlech, jsou potenciálně konkurenční, dokud nemáme jasný pořádek jejich vzniku. A obvykle ho nemáme.
- Nedostatek globálních hodin. Nemáme jasný pořádek událostí kvůli absenci globálních hodin. V běžném lidském světě jsme zvyklí na to, že máme hodiny a čas je absolutní. Vše se mění, když jde o distribuované systémy. I u superpřesných atomových hodin dochází k odchylkám a mohou nastat situace, kdy nemůžeme říct, která ze dvou událostí nastala dříve. Proto se na čas také spolehnout nemůžeme.
- Nezávislý selhání uzlů systému. Existuje také další problém: něco se může pokazit jednoduše proto, že naše uzly nejsou věčné. Může selhat pevný disk, virtuální stroj v cloudu se může restartovat, může se přerušit síť a zprávy se ztratí. Navíc mohou nastat situace, kdy uzly fungují, ale přitom pracují proti systému. Poslední třída problémů dostala dokonce zvláštní název: problém . Nejznámějším příkladem distribuovaného systému s takovým problémem je Blockchain. Ale dnes se nebudeme zabývat touto zvláštní třídou problémů. Zajímat nás budou situace, kdy se jednoduše jeden nebo více uzlů může porouchat.
- Modely komunikace (modely výměny zpráv) mezi uzly. Zjistili jsme, že uzly komunikují prostřednictvím výměny zpráv. Existují dva známé modely výměny zpráv: synchronní a asynchronní.
Modely komunikace mezi uzly v distribuovaných systémech
Synchronní model – přesně víme, že existuje konečná známá doba, za kterou zpráva zaručeně dorazí z jednoho uzlu na druhý. Pokud tato doba uplyne a zpráva nepřijde, můžeme s jistotou říci, že uzel selhal. V takovém modelu máme předvídatelnou dobu čekání.
Asynchronní model – v asynchronních modelech předpokládáme, že doba čekání je konečná, ale neexistuje taková doba, po které bychom mohli garantovat, že uzel selhal. Tzn. doba čekání na zprávu z uzlu může být jak dlouhá, jak jen potřeba. Toto je důležité určení, a o tom si promluvíme dále.
Pojem konsensu v distribuovaných systémech
Než formálně definujeme pojem konsensu, podívejme se na příklad situace, kdy ho potřebujeme, a to konkrétně – Replikace stavového stroje.
Máme nějaký distribuovaný log. Rádi bychom, aby byl konzistentní a obsahoval identická data na všech uzlech distribuovaného systému. Když některý z uzlů zjistí novou hodnotu, kterou má zapsat do logu, jeho úkolem je navrhnout tuto hodnotu všem ostatním uzlům, aby se log aktualizoval na všech uzlech a systém přešel do nového konzistentního stavu. Při tom je důležité, aby se uzly dohodly: všechny uzly souhlasily, že navržená nová hodnota je správná, všechny uzly tuto hodnotu přijaly, a pouze v tomto případě mohou všechny zapsat do logu novou hodnotu.
Jinými slovy: žádný z uzlů neprotestoval, že by měl aktuálnější informace a že navrhovaná hodnota je nesprávná. Dohoda mezi uzly a souhlas o jediné správně přijaté hodnotě je konsensus v distribuovaném systému. Dále se budeme bavit o algoritmech, které umožňují distribuovanému systému zaručeně dosahovat konsensu.
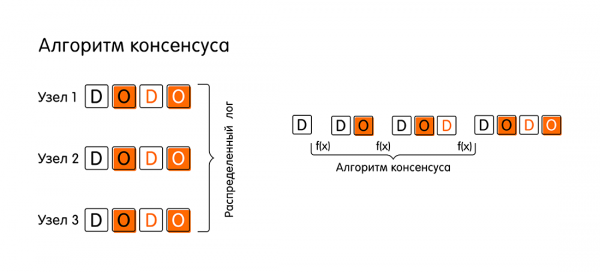
Formálně můžeme definovat algoritmus dosažení konsensu (nebo jednoduše algoritmus konsensu) jako funkci, která přenáší distribuovaný systém ze stavu A do stavu B. Tento stav je přitom akceptován všemi uzly a všechny uzly jej mohou potvrdit. Jak se ukazuje, úkol není tak triviální, jak se na první pohled zdá.
Vlastnosti algoritmu konsensu
Algoritmus konsensu musí mít tři vlastnosti, aby systém mohl pokračovat v existenci a měl nějaký pokrok při přechodu z jednoho stavu do druhého:
- Dohoda – všechny správně fungující uzly musí přijmout stejnou hodnotu (v článcích se tato vlastnost také nazývá vlastnost ochrany). Všechny uzly, které momentálně fungují (nezhroubily se a neztratily spojení s ostatními), by měly dospět k dohodě a přijmout nějakou konečnou společnou hodnotu.
Je důležité chápat, že uzly v námi zvažovaném distribuovaném systému chtějí dosáhnout dohody. O tom mluvíme o systémech, kde může něco selhat (například může selhat nějaký uzel), ale v tomto systému jistě nejsou uzly, které by úmyslně pracovaly proti jiným (úkol byzantských generálů). Díky této vlastnosti zůstává systém konzistentní.
- Integrita – pokud všechny správně fungující uzly nabízejí stejnou hodnotu v, pak každé správně fungující uzel musí tuto hodnotu přijmout v.
- Ukončení – všechny správně fungující uzly nakonec přijmou nějakou hodnotu (vlastnost životnosti), což umožňuje algoritmu mít pokrok v systému. Každý jednotlivý správně fungující uzel by měl dříve či později přijmout konečnou hodnotu a potvrdit to: "Pro mě je tato hodnota pravdivá, souhlasím se všemi v systému."
Příklad fungování algoritmu konsensu
Zatímco vlastnosti algoritmu mohou být méně zřejmé. Proto to ilustrujeme na příkladu, jaké fáze prochází nejjednodušší algoritmus konsensu v systému se synchronním modelem výměny zpráv, kde všechny uzly fungují správně, zprávy se neztrácí a nic se nerozbije (skutečně se tohle stává?).
- Všechno začíná návrhem ruky a srdce (Propose). Předpokládejme, že se k uzlu s názvem „Uzel 1“ připojil klient a zahájil transakci, přičemž uzlu předal novou hodnotu – O. Od této chvíle budeme „Uzel 1“ nazývat proposer. Jako proposer nyní „Uzel 1“ musí informovat celý systém, že má čerstvé údaje, a rozesílá všem ostatním uzlům zprávy: „Podívejte se! Přišla mi hodnota „O“, a chci ji zapsat! Prosím, potvrďte, že také zapíšete „O“ do svého logu.“

- Další fáze – hlasování o navržené hodnotě (Voting). K čemu je to dobré? Může se stát, že ostatním uzlům přišly aktuálnější informace a mají údaje k této same transakci.
Když uzel „Uzel 1“ odešle svůj návrh, ostatní uzly zkontrolují ve svých logách údaje o této události. Pokud nejsou žádné rozporu, uzly vyhlásí: „Ano, nemám žádné jiné údaje k této události. Hodnota „O“ je nejnovější informace, kterou jsme získali.“V opačném případě mohou uzly odpovědět „Uzlu 1“: „Poslouchej! Mám aktuálnější údaje o této transakci. Ne „O“, ale něco lepšího.“
Ve fázi hlasování uzly dospějí k rozhodnutí: buď všichni přijímají jednu hodnotu, nebo někdo z nich hlasuje proti a naznačí, že má aktuálnější údaje.
- Pokud kolo hlasování proběhlo úspěšně a všichni byli „pro“, systém přechází do nové fáze – přijetí hodnoty (Accept). „Uzel 1“ shromáždí všechny odpovědi ostatních uzlů a oznámí: „Všichni souhlasili s hodnotou „O“! Nyní oficiálně prohlašuji, že „O“ je naše nová hodnota, jednotná pro všechny! Zapište si to do své knížky, nezapomeňte. Zapište to do svého logu!“
- Ostatní uzly pošlou potvrzení (Accepted), že si zapsali hodnotu „O“, během této doby nepřišlo nic nového (jakési dvoufázové potvrzení). Po této významné události považujeme, že distribuovaná transakce byla úspěšně dokončena.
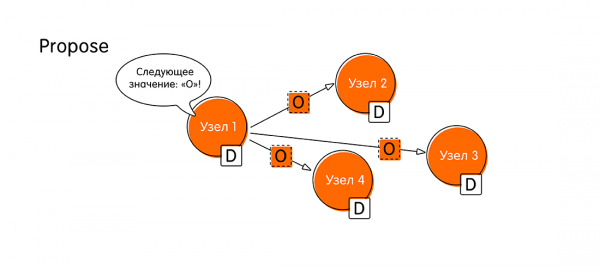
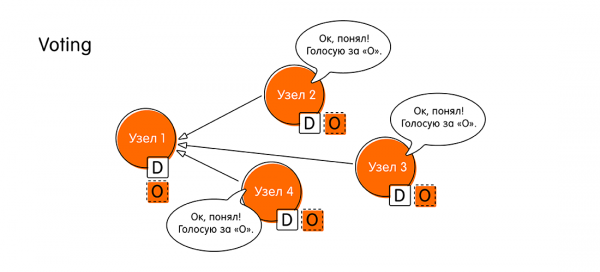
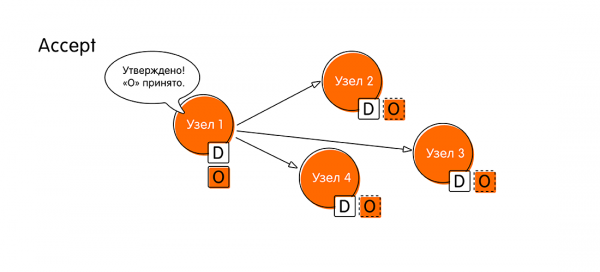
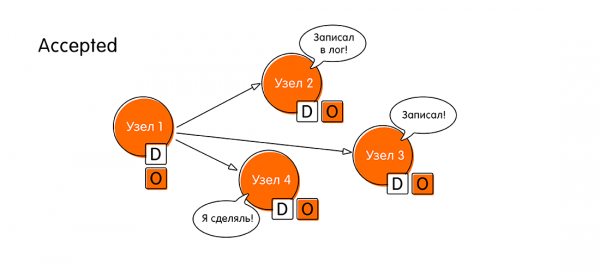
Tudíž konsenzuální algoritmus v jednoduchém případě sestává ze čtyř kroků: propose, hlasování (voting), přijetí (accept), potvrzení přijetí (accepted).
Pokud během nějakého kroku nedokážeme dosáhnout shody, algoritmus se spouští znovu, přičemž se zohledňuje informace, kterou poskytnou uzly, které odmítly potvrdit navrženou hodnotu.
Konsensuální algoritmus v asynchronním systému
Do této doby to bylo hladké, protože jsme hovořili o synchronním modelu výměny zpráv. Ale jak víme, v současném světě jsme všichni zvyklí na asynchronní provedení. Jak však funguje analogický algoritmus v systému s asynchronním modelem výměny zpráv, kde považujeme, že doba čekání na odpověď uzlu může být libovolně dlouhá (mimochodem, výpadek uzlu lze také považovat za příklad situace, kdy uzel může odpovídat libovolně dlouho).
Nyní, když víme, jak v zásadě funguje konsensuální algoritmus, otázka pro ty zvídavé čtenáře, kteří se dostali na toto místo: kolik uzlů v systému z N uzlů s asynchronním modelem zpráv může selhat, aby systém stále mohl dosáhnout konsensu?
Správná odpověď a odůvodnění je za spoilerem.Správná odpověď: 0. Pokud jakýkoli uzel v asynchronním systému selže, systém nemůže dosáhnout konsensu. Toto tvrzení bylo prokázáno v známé teoremě FLP (1985, Fischer, Lynch, Paterson, odkaz na originál na konci článku): „Nemožnost dosažení distribuovaného konsensu při selhání alespoň jednoho uzlu“.
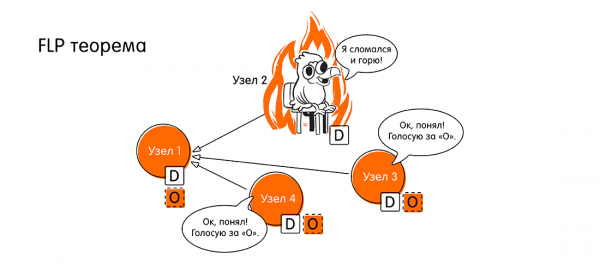
Chlapci, máme tedy problém, zvyklí jsme na to, že vše je asynchronní. A teď toto. Jak dál žít?
Právě jsme mluvili o teorii, o matematice. Co znamená „konsensus nemůže být dosažen“, když to převedeme z matematického jazyka do našeho – inženýrského? Znamená to, že „ne vždy může být dosažen“, tj. existuje případ, kdy konsensus není dosažitelný. A jaký je to případ?
To je přesně porušení vlastnosti liveness, popsané výše. Nemáme obecný souhlas a systém nemůže mít pokrok (nemůže skončit za konečný čas), když nemáme odpověď od všech uzlů. Protože v asynchronním systému nemáme předvídatelnou dobu odpovědi a nemůžeme vědět, zda uzel selhal nebo jen dlouho odpovídá.
Ale v praxi můžeme najít řešení. Nechť náš algoritmus může fungovat dlouho v případě selhání (potenciálně může fungovat nekonečně). Ale v většině situací, kdy většina uzlů správně funguje, budeme mít pokrok v systému.
V praxi se setkáváme s částečně synchronními komunikačními modely. Částečná synchronnost se chápe takto: obecně máme asynchronní model, ale formálně se zavádí určitý pojem „global stabilization time“ jako nějaký časový okamžik.
Tento časový okamžik nemusí nastat neomezeně dlouho, ale jednou musí nastat. Zazvoní virtuální budík a od tohoto okamžiku můžeme předpovědět časovou prodlevu, za kterou zprávy dorazí. Od tohoto momentu se systém z asynchronního stává synchronním. V praxi se skutečně zabýváme právě takovými systémy.
Algoritmus Paxos řeší problémy konsensu.
– je rodina algoritmů, které řeší problém konsensu pro částečně synchronní systémy, za předpokladu, že některé uzly mohou selhávat. Autorem Paxosu je . Ten navrhl formální důkaz existence a správnosti algoritmu v roce 1989.
Ale důkaz se ukázal být zdaleka netriviální. První publikace byla vydána až v roce 1998 (33 stran) a obsahovala popis algoritmu. Jak se ukázalo, byla velmi složitá na pochopení a v roce 2001 bylo publikováno vysvětlení k článku, které zabralo 14 stran. Objem publikací je uveden, aby ukázal, že problém konsensu není vůbec jednoduchý, a za takovými algoritmy stojí obrovská práce těch nejchytřejších lidí.
Zajímavé je, že sám Leslie Lamport ve své přednášce poznamenal, že ve druhém článku-vysvětlení je jedno tvrzení, jedna věta (neupřesnil kterou), která může být interpretována různě. A kvůli tomu velké množství současných implementací Paxosu nefunguje zcela správně.
Podrobná analýza fungování Paxosu by zabral mnoho článků, proto se pokusím velmi stručně předat hlavní myšlenku algoritmu. V odkazech na konci článku najdete materiály pro další prohloubení do tohoto tématu.
Role v Paxosu
V algoritmu Paxos existuje pojem rolí. Podívejme se na tři základní (existují modifikace s dalšími rolemi):
- Proposers (také se mohou používat termíny: lídři nebo koordinátoři)To jsou lidé, kteří se dozvědí o nějakém novém hodnotě od uživatele a přijímají roli lídra. Jejich úkolem je zahájit kolo navrhování nové hodnoty a koordinovat další kroky uzlů. Paxos navíc umožňuje mít v určitých situacích několik lídrů.
- Přijímači (volitelé)To jsou uzly, které hlasují pro přijetí nebo odmítnutí určité hodnoty. Jejich rolí je velmi důležitá, protože právě od nich závisí rozhodnutí: do jakého stavu se systém po dané fázi algoritmu konsensu dostane (nebo nedostane).
- Učící se uzlyTo jsou uzly, které pouze přijímají a zapisují novou přijatou hodnotu, když dojde ke změně ve stavu systému. Nepřijímají rozhodnutí, pouze získávají data a mohou je předat koncovému uživateli.
Jeden uzel může v různých situacích vykonávat více rolí.
Pojem kvóra
Předpokládáme, že máme systém složený z N uzlů. A z nich maximálně F uzlů může selhat. Pokud F uzlů selže, znamená to, že v našem klastru by mělo být alespoň 2F + 1 uzlů přijímačů.
To je potřeba, aby jsme vždy, i v nejhorším případě, měli většinu 'dobrých' správně fungujících uzlů. To znamená, že F + 1 'dobrých' uzlů, které souhlasily, a finální hodnota bude přijata. Jinak může nastat situace, kdy různé místní skupiny přijmou různé hodnoty a nedokážou se mezi sebou dohodnout. Proto potřebujeme absolutní většinu, abychom vyhráli hlasování.
Obecná myšlenka fungování algoritmu konsensu Paxos
Algoritmus Paxos předpokládá dvě velké fáze, které se zase dělí na dva kroky každá:
- Fáze 1a: Příprava. V přípravné fázi lídr (proposer) informuje všechny uzly: „Začínáme nové kolo hlasování. Máme nové kolo. Číslo tohoto kola je n. Nyní začneme hlasovat.“ Zatím jen oznamuje začátek nového cyklu, ale nezveřejňuje novou hodnotu. Úkolem této fáze je iniciovat nové kolo a oznámit všem jeho unikátní číslo. Číslo kola je důležité, musí být větší než všechna předchozí čísla hlasování od všech předchozích lídrů. Právě díky číslu kola ostatní uzly v systému pochopí, jak aktuální jsou data u lídra. Je pravděpodobné, že ostatní uzly již mají výsledky hlasování z mnohem pozdějších kol a jednoduše řeknou lídrovi, že zaspal.
- Fáze 1b: Slib. Když uzly-acceptoré obdržely číslo nového kola hlasování, mohou nastat dvě možnosti:
- Číslo n nového hlasování je větší než číslo jakéhokoli z předchozích hlasování, ve kterém se acceptor účastnil. Pak acceptor pošle lídrovi slib, že se nebude účastnit žádných hlasování s menším číslem než n. Pokud acceptor již hlasoval o nějaké hodnotě (tj. se již ve fázi dva zúčastnil nějaké hodnoty), přiloží k svému slibu akceptovanou hodnotu a číslo hlasování, ve kterém se účastnil.
- Na druhou stranu, pokud acceptor již zná o hlasování s větším číslem, může jednoduchou přípravnou fázi ignorovat a neodpovědět lídrovi.
- Fáze 2a: Akceptuj. Lídrovi je potřeba počkat na odpověď od kvóra (většiny uzlů v systému) a pokud obdržel nezbytný počet odpovědí, má dvě možnosti:
- Někteří z acceptorů poslali hodnoty, o které již hlasovali. V tomto případě lídr zvolí hodnotu z hlasování s maximálním číslem. Nazvěme tuto hodnotu x, a všem uzlům zašle zprávu ve tvaru: „Accept (n, x)“, kde první hodnota je číslo hlasování z jeho vlastního kroku Propose a druhá hodnota je to, kvůli čemu se vlastně sešli, tj. hodnota, o kterou vlastně hlasujeme.
- Pokud žádný z přijímačů neodeslal žádné hodnoty a pouze slíbili, že se zúčastní hlasování v tomto kole, může vedoucí navrhnout, aby hlasovali pro jeho hodnotu, kvůli které se vlastně stal vedoucím. Označme ji jako y. Rozesílá všem uzlům zprávu ve tvaru: „Accept (n, y)“, podobně jako v předchozím výstupu.
- Fáze 2b: PřijatoDále akceptory, při obdržení zprávy „Accept(…)“ od vedoucího, s ním souhlasí (rozesílají všem uzlům potvrzení, že souhlasí s novou hodnotou) pouze v případě, že neslíbil jinému vedoucímu účast v kole hlasování s číslem. n’ > n, jinak ignorují žádost o potvrzení.
Pokud většina uzlů odpoví vedoucímu a všichni potvrdí novou hodnotu, pak se nová hodnota považuje za přijatou. Hurá! Pokud většina není dosažena nebo jsou uzly, které odmítly přijmout novou hodnotu, začíná to celé znovu.
Takto funguje algoritmus Paxos. Každá z těchto fází má mnoho jemností, prakticky jsme se nezabývali různými typy selhání, problémy s více vedoucími a mnoho dalšího, ale cílem tohoto článku je pouze na úrovni zprostředkovat čtenářovi svět distribuovaných výpočtů.
Také je třeba poznamenat, že Paxos není jediný svého druhu, existují i další algoritmy, například , ale to už je téma pro jiný článek.
Odkazy na materiály pro další studium
Úroveň „začátečník“:
- , Preethi Kasireddy, blogový článek na Medium
- , Adi Kancherla, blogový článek na Medium
- , Ittai Abraham, blog
- , Ittai Abraham, blogový článek
Úroveň „Leslie Lamport“:
- , Fischer, Lynch a Paterson, výzkumný dokument, 1985
- , Leslie Lamport, výzkumný dokument, 1998
- , Leslie Lamport, výzkumný dokument, 2001
Zdroj: habr.com
