

Pozn. přek.: Dailymotion — jeden z největších video hostingových služeb na světě a významný uživatel Kubernetes. V tomto článku sdílí systémový architekt David Donchez výsledky vytváření produkční platformy společnosti na bázi K8s, která začínala jako cloudová instalace v GKE a skončila jako hybridní řešení, což vedlo k lepšímu času odezvy a úsporám na infrastrukturních nákladech.
Při rozhodování o přestavbě hlavního API před třemi lety jsme chtěli vyvinout efektivnější způsob nasazování aplikací a usnadnit Za tímto cílem jsme se rozhodli využít platformu pro orchestraci kontejnerů a přirozeně jsme zvolili Kubernetes.
Proč vytvářet vlastní platformu na bázi Kubernetes?
API produkční úrovně v rekordním čase pomocí Google Cloud
Léto 2016
Před třemi lety, hned po koupi Dailymotion společností , se naše inženýrské týmy soustředily na jeden globální cíl: vytvořit zcela nový produkt Dailymotion.
Na základě analýzy kontejnerů, řešení pro orchestraci a našich předchozích zkušeností jsme se ujistili, že Kubernetes je správná volba. Někteří vývojáři už měli povědomí o základních konceptech a věděli, jak ho použít, což bylo obrovskou výhodou pro infrastrukturní transformaci.
Z pohledu infrastruktury byla potřebná výkonná a flexibilní systém pro nasazení nových typů cloud-native aplikací. Na začátku naší cesty jsme se rozhodli zůstat v cloudu, abychom klidně vytvořili co nejspolehlivější lokální platformu. Rozhodli jsme se nasazovat naše aplikace pomocí Google Kubernetes Engine, i když jsme věděli, že dříve či později přejdeme na vlastní datová centra a zavedeme hybridní strategii.
Proč jsme zvolili GKE?
Toto rozhodnutí jsme učinili hlavně z technických důvodů. Kromě toho bylo třeba rychle poskytnout infrastrukturu, která vyhovovala potřebám podnikání společnosti. Měli jsme několik požadavků na nasazení aplikací, jako je geografická rozložitelnost, škálovatelnost a odolnost proti poruchám.
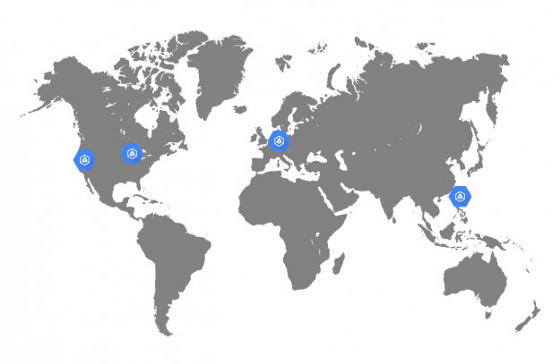
Shluky GKE v Dailymotion
Jelikož je Dailymotion globální video platforma, velmi jsme chtěli zlepšit kvalitu služby snížením doby čekání. (latence)Dříve byl dostupný pouze v Paříži, což nebylo optimální. Chtěli jsme mít možnost nasazovat aplikace nejen v Evropě, ale také v Asii a USA.
Tato citlivost na zpoždění znamenala, že bude nutné vážně pracovat na síťové architektuře platformy. Zatímco většina cloudových služeb vyžadovala vytvoření vlastní sítě v každém regionu a následné jejich propojení přes VPN nebo nějakou řízenou službu, Google Cloud umožnil vytvořit plně směrovatelnou jednotnou síť pokrývající všechny regiony Google. To je velké plus z hlediska provozu a efektivity systému.
Kromě toho si s touto prací skvěle poradí síťové služby a vyrovnávače zátěže od Google Cloud. Umožňují jednoduše používat libovolné veřejné IP adresy z každého regionu, a úžasný protokol BGP se postará o vše ostatní (tj. přesměruje uživatele na nejbližší cluster). Je zřejmé, že v případě selhání bude provoz automaticky přesměrován do jiného regionu bez jakéhokoliv zásahu člověka.
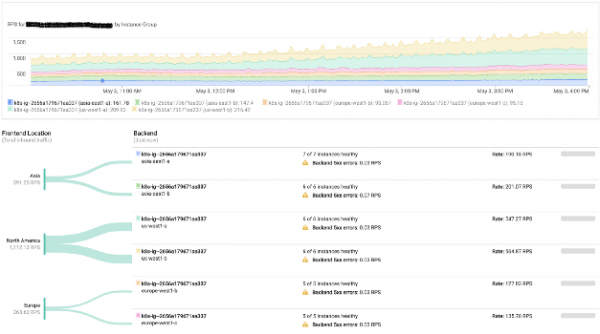
Monitoring vyrovnávání zátěže v Google
Naše platforma také aktivně využívá grafické procesory. Google Cloud umožňuje velmi efektivně je používat přímo v clusterech Kubernetes.
Přes to se infrastrukturní tým převážně soustředil na starý stack nasazený na fyzických serverech. Právě proto použití řízené služby (včetně hlavních komponentů Kubernetes) vyhovovalo našim požadavkům a umožnilo školit týmy pracovat s lokálními clustery.
V důsledku toho jsme mohli začít přijímat produkční provoz na infrastruktuře Google Cloud pouze 6 měsíců po zahájení práce.
Nicméně i přes řadu výhod je práce s cloudovým poskytovatelem spojena s určitými náklady, které mohou narůstat v závislosti na zátěži. Proto jsme pečlivě analyzovali každou používanou řízenou službu, abychom v budoucnu mohli realizovat tyto služby u sebe on-premises. Vskutku implementace lokálních clusterů začala na konci roku 2016 a tehdy byla zahájena hybridní strategie.
Spuštění lokální platformy pro orchestraci kontejnerů Dailymotion
Podzim 2016
V podmínkách, kdy byl celý stack připraven na produkci, a práce na API , bylo čas se soustředit na regionální clustery.
V té době uživatelé měsíčně sledovali více než 3 miliardy videí. Samozřejmě, že naše rozsáhlá Content Delivery Network fungovala už několik let. Chtěli jsme této situace využít a nasadit Kubernetes clustery v existujících datových centrech.
Infrastruktura Dailymotion zahrnovala více než 2,5 tisíce serverů v šesti datových centrech. Všechny jsou konfigurovány pomocí Saltstacku. Začali jsme připravovat všechny potřebné recepty pro vytvoření master a worker uzlů, stejně jako clusteru etcd.
Síťová část
Naše síť je plně směrovatelná. Každý server oznamuje svou IP adresu v síti pomocí Exabgp. Porovnali jsme několik síťových pluginů a jediný, který splnil všechny potřeby (kvůli použitému L3 přístupu), byl . Skvěle zapadl do existující síťové struktury infrastruktury.
Protože jsme chtěli využít všechny existující prvky infrastruktury, bylo nejprve nutné se vypořádat s naším domácím síťovým nástrojem (používaným na všech serverech): využít ho k oznamování rozsahů IP adres v síti s Kubernetes uzly. Umožnili jsme Calico přiřazovat IP adresy podům, ale nepoužili jsme ho a dodnes nepoužíváme pro BGP session na síťovém zařízení. Ve skutečnosti se routingem zabývá Exabgp, který oznamuje podsíti používané Calico. To nám umožňuje dosáhnout jakéhokoli podu z interní sítě (a konkrétně od load balancerů).
Jak spravujeme ingress traffic
Pro přesměrování příchozích požadavků na správnou službu jsme se rozhodli použít Ingress Controller díky jeho integraci s ingress zdroji Kubernetes.
Před třemi lety byl nginx-ingress-controller nejvyspělejším kontrolerem: Nginx byl používán již dlouho a byl známý svou stabilitou a výkonem.
V našem systému jsme se rozhodli umístit kontroléry na vyhrazené 10Gb blade servery. Každý kontrolér byl připojen k endpointu kube-apiserver příslušného clusteru. Na těchto serverech byl také použit Exabgp pro inzerci veřejných nebo soukromých IP adres. Topologie naší sítě umožňuje použít BGP z těchto kontrolérů pro směrování veškerého provozu přímo na pody bez použití služby typu NodePort. Tento přístup pomáhá vyhnout se horizontálnímu provozu mezi uzly a zvyšuje efektivitu.
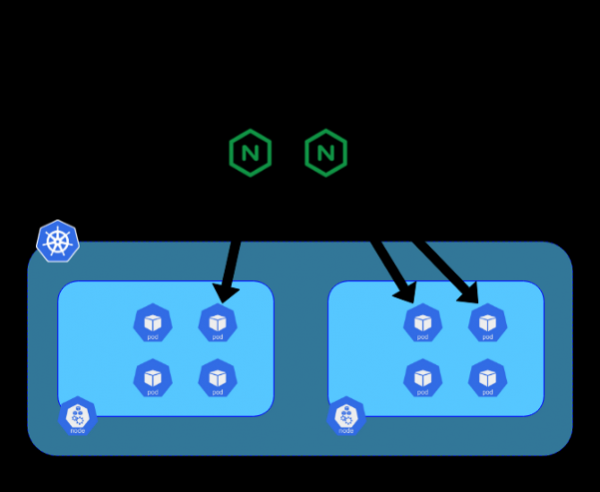
Pohyb provozu z internetu k podům
Nyní, když jsme se seznámili s naší hybridní platformou, můžeme se ponořit do samotného procesu migrace provozu.
Migrace provozu z Google Cloud do infrastruktury Dailymotion
Podzim 2018
Po téměř dvou letech vývoje, testování a nastavení jsme konečně získali plný stack Kubernetes, připravený přijmout část provozu.
Aktuální strategie směrování je poměrně jednoduchá, ale zcela vyhovuje našim potřebám. Kromě veřejných IP (v Google Cloud a Dailymotion) používáme AWS Route 53 k určení politik a přesměrování uživatelů k clusteru dle našeho výběru.
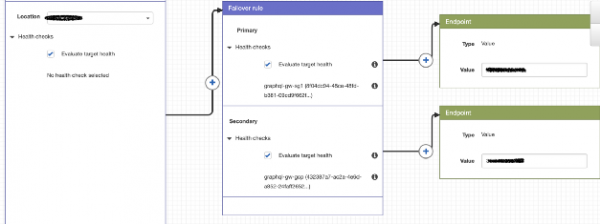
Příklad politiky směrování s použitím Route 53
S Google Cloud je to jednoduché, protože používáme jedinou IP pro všechny clustery, a uživatel je přesměrován k nejbližšímu clusteru GKE. U našich clusterů je technologie jiná, protože jejich IP se liší.
Během migrace jsme usilovali o přesměrování regionálních dotazů na příslušné clustery a zhodnotili jsme výhody tohoto přístupu.
Jelikož jsou naše GKE clustery nakonfigurovány na automatické škálování pomocí Custom Metrics, přidávají/odebírají kapacity podle příchozího provozu.
Ve standardním režimu je veškerý regionální provoz směrován na místní cluster, zatímco GKE slouží jako záloha pro případ problémů (health-checky provádí Route 53).
…
V budoucnu chceme plně automatizovat routingové politiky, abychom získali autonomní hybridní strategii, která neustále zlepšuje dostupnost pro uživatele. Pokud jde o výhody: náklady na cloud se výrazně snížily a dokonce se podařilo zkrátit dobu reakce API. Důvěřujeme získané cloudové platformě a jsme připraveni v případě potřeby na ní směrovat více provozu.
P.S. od překladatele
Možná vás také zaujme další nedávný příspěvek Dailymotion na téma Kubernetes. Ten se věnuje nasazení aplikací pomocí Helm na více Kubernetes clusterech a asi před měsícem.
Přečtěte si také náš blog:
- «».
- «»;
- «»;
- «»;
- «»;
- «»;
- «»;
- «»;
- «»;
- «»;
- «».
Zdroj: habr.com
