

Typická podmínka pro implementaci CI/CD v Kubernetes: aplikace by měla být schopna před úplným zastavením nepřijímat nové klientské požadavky, a co je nejdůležitější — úspěšně dokončit již existující.
Dodržení této podmínky umožňuje dosáhnout nulového výpadku během nasazení. Nicméně, i při použití velmi populárních kombinací (jako NGINX a PHP-FPM) se můžete setkat s komplikacemi, které povedou k nárůstu chyb při každém nasazení…
Teorie. Jak žije pod
Podrobně o životním cyklu podu jsme již publikovali. . V kontextu probíraného tématu nás zajímá následující: ve chvíli, kdy pod přechází do stavu Terminating, přestávají na něj být posílány nové požadavky (pod ze seznamu endpointů pro službu). Tím pádem, abychom předešli výpadku během nasazení, stačí z naší strany vyřešit problém správného zastavení aplikace.
Také je třeba mít na paměti, že doba grace period je ve výchozím nastavení : po uplynutí této doby bude pod ukončen a aplikace musí mít čas zpracovat všechny požadavky do tohoto okamžiku. Poznámka: i když jakýkoli požadavek, který trvá déle než 5-10 sekund, je již problematický a graceful shutdown mu již nepomůže…
Abychom lépe pochopili, co se děje, když pod ukončuje svou činnost, stačí prostudovat následující schéma:
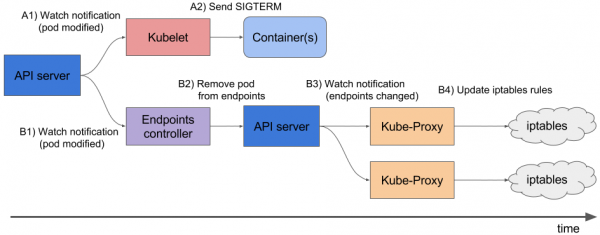
A1, B1 — Získání změn o stavu podu
A2 — Odeslání SIGTERM
B2 — Odstranění podu ze seznamu endpointů
B3 — Získání změn (seznam endpointů se změnil)
B4 — Aktualizace pravidel iptables
Všimněte si: odstranění endpointu podu a odeslání SIGTERM se neděje sekvenčně, ale paralelně. A protože Ingress nezískává aktualizovaný seznam Endpointů okamžitě, budou na pod posílány nové požadavky od klientů, což způsobí 500 chyby během ukončení podu. (podrobnější materiál k této problematice jsme ). Tento problém je třeba řešit následujícími způsoby:
- Odesílat v hlavičkách odpovědi Connection: close (pokud to míří na HTTP aplikaci).
- Pokud není možné provádět změny v kódu, poté v článku je popsáno řešení, které umožní zpracovat požadavky do konce grace period.
Teorie. Jak NGINX a PHP-FPM ukončují své procesy
NGINX
Začněme s NGINX, protože s ním je všechno více méně jasné. Když se ponoříme do teorie, zjistíme, že NGINX má jeden master proces a několik 'workerů' - to jsou podřízené procesy, které zpracovávají klientské požadavky. Je zde užitečná možnost: pomocí příkazu nginx -s ukončit procesy buď v režimu rychlého ukončení, nebo v příjemném ukončení. Je zřejmé, že nás zajímá právě ta druhá možnost.
Dále je to jednoduché: je třeba přidat do příkaz, který zašle signál o příjemném ukončení. To lze provést v Deploymentu, v bloku kontejneru:
       lifecycle:
          preStop:
            exec:
              command:
              - /usr/sbin/nginx
              - -s
              - quit
Nyní při ukončení práce podu v logech kontejneru NGINX uvidíme následující:
2018/01/25 13:58:31 [notice] 1#1: signal 3 (SIGQUIT) received, shutting down
2018/01/25 13:58:31 [notice] 11#11: gracefully shutting down
A to bude znamenat to, co potřebujeme: NGINX čeká na dokončení zpracování požadavků, po kterém ukončí proces. Nicméně, níže bude projednána častá probléma, díky které i při přítomnosti příkazu nginx -s quit se proces ukončí nesprávně.
A tímto jsme s NGINX skončili: aspoň podle logů můžeme pochopit, že vše funguje, jak má.
Jak si stojí věci s PHP-FPM? Jak zpracovává příjemné ukončení? Pojďme to zjistit.
PHP-FPM
V případě PHP-FPM je informací o něco méně. Pokud se zaměříme na k PHP-FPM, tam bude řečeno, že přijímá následující POSIX signály:
-
SIGINT,SIGTERM— rychlé ukončení; -
SIGQUIT— příjemné ukončení (to, co potřebujeme).
Ostatní signály v této úloze nejsou potřebné, proto se jejich rozbor vynechá. Pro správné ukončení procesu bude potřeba napsat následující preStop hook:
        lifecycle:
          preStop:
            exec:
              command:
              - /bin/kill
              - -SIGQUIT
              - "1"
Na první pohled je to vše, co je potřeba pro provedení příjemného ukončení v obou kontejnerech. Nicméně, úkol je složitější, než se zdá. Následují dva příklady, ve kterých příjemné ukončení nefungovalo a způsobilo krátkodobou nedostupnost projektu během nasazení.
Praxe. Možné problémy s příjemným ukončením
NGINX
Především je užitečné pamatovat: kromě vykonání příkazu nginx -s quit Existuje ještě jedna fáze, na kterou stojí za to upozornit. Narazili jsme na problém, kdy NGINX místo signálu SIGQUIT posílal SIGTERM, což způsobilo, že požadavky nebyly správně dokončeny. Podobné případy lze najít například, . Bohužel se nám nepodařilo zjistit konkrétní příčinu tohoto chování: měl jsem podezření na verze NGINX, ale to se nepotvrdilo. Symptomy byly takové, že v logách kontejneru NGINX se objevovaly zprávy „open socket #10 left in connection 5“, po čemž se pod zastavil.
Takový problém můžeme pozorovat například v odpovědích na potřebném Ingressu:
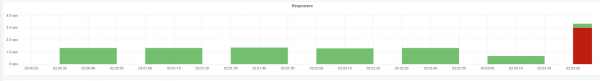
Ukazatele stavových kódů v okamžiku nasazení
V tomto případě dostáváme právě 503 kód chyby od samotného Ingressu: nemůže se připojit k NGINX kontejneru, protože ten už není dostupný. Pokud se podíváte do logů kontejneru s NGINX, v nich najdete následující:
[alert] 13939#0: *154 open socket #3 left in connection 16
[alert] 13939#0: *168 open socket #6 left in connection 13
Po změně stop signálu se kontejner začíná zastavovat správně: to potvrzuje, že se už neobjevuje 503 chyba.
Pokud jste se setkali s podobným problémem, má smysl se podívat, jaký stop signál se používá v kontejneru a jak vypadá preStop hook. Je velmi možné, že problém spočívá právě v tom.
PHP-FPM… a nejen to
Problém s PHP-FPM je popsán triviálně: nečeká na dokončení dětských procesů, terminují je, což způsobuje 502 chyby během nasazení a dalších operací. Na bugs.php.net od roku 2005 existuje několik zpráv o chybách (například, a ), které popisují tento problém. A v logech pravděpodobně nic neuvidíte: PHP-FPM oznámí ukončení svého procesu bez jakýchkoliv chyb nebo externích upozornění.
Je třeba upřesnit, že samotný problém může do určité míry záviset na samotné aplikaci a nemusí se projevovat například v monitorování. Pokud se s ním přesto setkáte, jako první se nabízí jednoduché řešení: přidat preStop hook se sleep(30). To umožní dokončit všechny požadavky, které byly dosud (a nové nepřijímáme, protože pod již je ve stavu Terminating), a po uplynutí 30 sekund se pod sám zastaví signálem SIGTERM.
Dostáváme se k tomu, že lifecycle pro kontejner bude vypadat následovně:
    lifecycle:
      preStop:
        exec:
          command:
          - /bin/sleep
          - "30"
Nicméně, kvůli určení 30sekundového sleep používáme silně zvýšíme dobu nasazení, protože každý pod bude ukončen minimum 30 sekund, což je špatné. Co s tím můžeme udělat?
Obraťme se na část, která odpovídá za bezprostřední vykonávání aplikace. V našem případě je to PHP-FPM, který ve výchozím nastavení nesleduje vykonávání svých child-processů: hlavní proces je ukončen okamžitě. Toto chování lze změnit pomocí direktivy process_control_timeout, která určuje časové limity pro čekání na signály od hlavního procesu ze strany dětských procesů. Pokud nastavíme hodnotu na 20 sekund, pokryje to většinu požadavků prováděných v kontejneru, a po jejich dokončení bude hlavní proces zastaven.
S těmito znalostmi se vraťme k našemu poslednímu problému. Jak bylo zmíněno, Kubernetes není monolitní platforma: interakce mezi různými jejími komponentami vyžaduje určitý čas. To je obzvlášť aktuální, když zvažujeme práci Ingressů a dalších souvisejících komponent, protože kvůli takovému zpoždění lze v okamžiku nasazení snadno narazit na výskyt 500-kových chyb. Například chyba může vzniknout ve fázi odesílání požadavku na upstream, ale samotné „časové zpoždění“ interakce mezi komponentami je docela krátké — méně než sekunda.
Proto, v souhrnu s již zmíněnou direktivou process_control_timeout můžeme použít následující konstrukci pro lifecycle:
lifecycle:
  preStop:
    exec:
      command: ["/bin/bash","-c","/bin/sleep 1; kill -QUIT 1"]
V takovém případě kompenzujeme zpoždění příkazem sleep a nezvyšujeme příliš dobu nasazení: vždyť je znatelný rozdíl mezi 30 sekundy a jednou?.. V podstatě "hlavní práci" na sebe bere právě process_control_timeout, a lifecycle slouží pouze jako „záloha“ v případě zpoždění.
Obecně řečeno, popisované chování a odpovídající workaround se netýkají pouze PHP-FPM. Podobná situace může vzniknout i při použití dalších jazyků/programovacích rámců. Pokud není možné opravit graceful shutdown jinými způsoby — například přepracováním kódu tak, aby aplikace správně zpracovávala signály k ukončení — lze použít popsány způsob. Ačkoli není nejhezčí, funguje.
Praxe. Zátěžové testování pro ověření výkonu podu
Zátěžové testování je jedním ze způsobů, jak ověřit, jak funguje kontejner, protože tento proces simuluje reálné podmínky, kdy na web přicházejí uživatelé. Pro testování uvedených doporučení lze využít : ten skvěle pokrývá všechny naše potřeby. Níže jsou uvedeny tipy a doporučení pro provádění testování s názorným příkladem – díky grafům Grafana a samotnému Yandex.Tanku – z naší zkušenosti.
Nejdůležitější zde je ověřovat změny postupně. Po přidání nového opravy spusťte testování a sledujte, zda se výsledky změnily v porovnání s předchozím spuštěním. Jinak bude obtížné identifikovat neefektivní řešení a v budoucnu lze dokonce způsobit škody (například zvýšit dobu nasazení).
Dalším aspektem je sledovat logy kontejneru během jeho ukončení. Je tam zaznamenáno informace o graceful shutdown? Jsou v logu chyby při přístupu k jiným zdrojům (například k sousednímu kontejneru PHP-FPM)? Chyby samotné aplikace (jak je uvedeno v případě NGINX výše)? Doufám, že úvodní informace z tohoto článku pomohou lépe pochopit, co se s kontejnerem děje během jeho ukončení.
Takže první spuštění testování proběhlo bez lifecycle a bez dalších direktiv pro server aplikací (process_control_timeout v PHP-FPM). Cílem tohoto testu bylo zjistit přibližný počet chyb (a zda vůbec nějaké existují). Také z doplňkových informací je třeba vědět, že průměrná doba nasazení každého podu byla přibližně 5-10 sekund do plné připravenosti. Výsledky jsou následující:
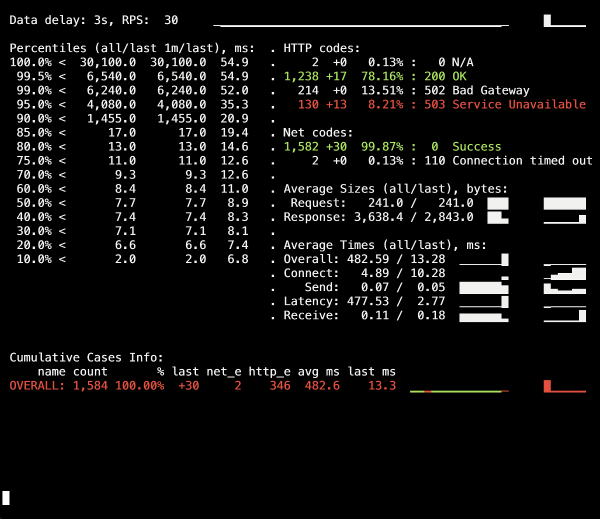
Na informační tabuli Yandex.Tanku je vidět nárůst 502 chyb, který nastal v okamžiku nasazení a trval v průměru do 5 sekund. Předpokládá se, že se přerušily stávající požadavky na starý pod, když byl ukončován. Poté se objevily chyby 503, což bylo výsledkem zastaveného kontejneru NGINX, který také přerušil spojení kvůli backendu (kvůli čemuž se k němu nemohl připojit Ingress).
Podíváme se, jak process_control_timeout v PHP-FPM nám pomůže čekat na dokončení child-procesů, tj. opravit takové chyby. Opětovné nasazení již s použitím této direktivy:
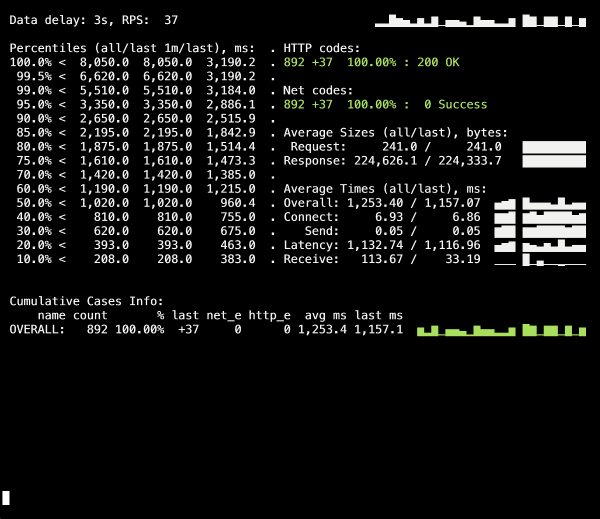
Během nasazení již není žádná chyba 500! Nasazení probíhá úspěšně, graceful shutdown funguje.
Je však třeba si vzpomenout na moment s Ingress kontejnery, malý procento chyb, které můžeme získat kvůli dočasnému zpoždění. Abychom se jim vyhnuli, stačí přidat konstrukci se sleep a opakovat nasazení. Nicméně, v našem konkrétním případě nebyly viditelné žádné změny (chyby opět nejsou).
Závěr
Pro správné dokončení procesu očekáváme od aplikace následující chování:
- Očekávat několik sekund, po kterých přestane přijímat nová spojení.
- Počkat na dokončení všech požadavků a uzavřít všechna keepalive připojení, které požadavky neprovádějí.
- Dokončit svůj proces.
Ale ne všechny aplikace umí takto pracovat. Jedním z řešení problému v realitě Kubernetes je:
- přidání pre-stop hooku, který bude čekat několik sekund;
- zkoumat konfigurační soubor našeho backendu s ohledem na odpovídající parametry.
Příklad s NGINX ukazuje, že i aplikace, která by měla správně reagovat na signály k ukončení, nemusí tak činit, a proto je kritické kontrolovat přítomnost chyb 500 během nasazení aplikace. To také umožňuje nahlížet na problém šířeji a nesoustředit se na jednotlivé pod nebo kontejner, ale sledovat celou infrastrukturu jako celek.
Jako nástroj pro testování lze použít Yandex.Tank v kombinaci s jakýmikoliv monitorovacími systémy (v našem případě pro test jsme brali data z Grafany s backendem ve formě Prometheus). Problémy s graceful shutdown jsou dobře viditelné při vysokém zatížení, které může generovat benchmark, a monitoring pomáhá detailněji analyzovat situaci během nebo po testu.
Pokud jde o zpětnou vazbu k článku: je třeba říci, že problémy a způsoby jejich řešení jsou zde popsány ve vztahu k NGINX Ingress. Pro jiné případy existují jiná řešení, která možná zvažujeme v dalších materiálech cyklu.
P.S.
Další z cyklu K8s tipy a triky:
- «»;
- «»;
- «»;
- «».
Zdroj: habr.com
