

Pozn. přek.: Tento článek, který napsal Galo Navarro, vedoucí softwarový inženýr v evropské společnosti Adevinta, je fascinující a poučné „vyšetřování“ v oblasti správy infrastruktury. Jeho původní název byl v překladu mírně upraven z důvodu, kterou autor vysvětluje na začátku.
Poznámka od autora: Zdá se, že tento příspěvek mnohem větší pozornost, než se očekávalo. Stále dostávám rozzlobené komentáře o tom, že název článku je zavádějící a že někteří čtenáři jsou zklamáni. Chápu důvody, které k tomu vedou, a proto, navzdory riziku, že se zbavím veškeré intriky, chci hned na začátku říct, o čem tento článek je. Při přechodu týmů na Kubernetes pozoruji zajímavou věc: kdykoli nastane problém (například zvýšení latence po migraci), jako první je obviňován Kubernetes, ale nakonec se ukáže, že orchestrátor za to ve skutečnosti nemůže. Tento článek vypráví o jednom z takových případů. Jeho název opakuje výkřik jednoho z našich vývojářů (později se ujistíte, že Kubernetes nemá s tímto případem vůbec nic společného). Nenajdete v něm žádná překvapivá odhalení o Kubernetes, ale můžete očekávat pár dobrých lekcí o složitých systémech.
Před pár týdny se můj tým zabýval migrací jednoho mikroslužby na hlavní platformu zahrnující CI/CD, pracovní prostředí založené na Kubernetes, metriky a další užitečnosti. Přestěhování mělo zkušební charakter: plánovali jsme ho vzít jako základ a během následujících měsíců přenést dalších přibližně 150 služeb. Všechny z nich odpovídají za provoz některých z největších online platforem ve Španělsku (Infojobs, Fotocasa atd.).
Poté, co jsme nasadili aplikaci v Kubernetes a přesměrovali na ni část provozu, nás čekalo znepokojivé překvapení. Latence (latence) požadavků v Kubernetes byla 10krát vyšší než v EC2. Obecně bylo nutné buď hledat řešení tohoto problému, nebo se vzdát migrace mikroslužby (a možná celého projektu).
Proč je latence v Kubernetes tak mnohem vyšší než v EC2?
Abychom našli úzké místo, shromáždili jsme metriky po celé cestě požadavku. Naše architektura je jednoduchá: API brána (Zuul) prozrazuje požadavky instance mikroslužby buď v EC2 nebo v Kubernetes. V Kubernetes používáme NGINX Ingress Controller, zatímco back-endy představují obyčejné objekty typu s JVM aplikací na platformě Spring.
                                  EC2
                            +---------------+
                            |  +---------+  |
                            |  |         |  |
                       +-------> BACKEND |  |
                       |    |  |         |  |
                       |    |  +---------+  |
                       |    +---------------+
             +------+  |
Veřejný      |      |  |
      -------> ZUUL +--+
provoz       |      |  |              Kubernetes
             +------+  |    +-----------------------------+
                       |    |  +-------+      +---------+ |
                       |    |  |       |  xx  |         | |
                       +-------> NGINX +------> BACKEND | |
                            |  |       |  xx  |         | |
                            |  +-------+      +---------+ |
                            +-----------------------------+
Zdálo se, že problém souvisí se zpožděním na počáteční fázi práce na backendu (označil jsem problémovou oblast v grafu jako „xx“). V EC2 odpověď aplikace trvala přibližně 20 ms. V Kubernetes zpoždění vzrostlo na 100—200 ms.
Rychle jsme vyloučili pravděpodobné podezřelé spojené se změnou prostředí běhu. Verze JVM zůstala stejná. Problémy s kontejnerizací také nebyly na vině: aplikace už úspěšně fungovala v kontejnerech v EC2. Zátěž? I při 1 požadavku za sekundu jsme pozorovali vysoká zpoždění. Pauzy na údržbu paměti bylo také možné přehlédnout.
Jeden z našich administrátorů Kubernetes se ptal, zda má aplikace externí závislosti, protože v minulosti požadavky na DNS způsobovaly podobné problémy.
Hypotéza 1: Řešení názvů DNS
Při každém požadavku se naše aplikace obrací na instanci AWS Elasticsearch v doméně jako je elastic.spain.adevinta.com. Uvnitř kontejnerů máme , takže můžeme zkontrolovat, jestli vyhledávání domény trvá dlouho.
DNS požadavky z kontejneru:
[root@be-851c76f696-alf8z \/]# while true; do dig "elastic.spain.adevinta.com" | grep time; sleep 2; done
;; Query time: 22 msec
;; Query time: 22 msec
;; Query time: 29 msec
;; Query time: 21 msec
;; Query time: 28 msec
;; Query time: 43 msec
;; Query time: 39 msec
Podobné požadavky z jedné z instancí EC2, kde aplikace funguje:
bash-4.4# while true; do dig "elastic.spain.adevinta.com" | grep time; sleep 2; done
;; Query time: 77 msec
;; Query time: 0 msec
;; Query time: 0 msec
;; Query time: 0 msec
;; Query time: 0 msec
Vzhledem k tomu, že vyhledávání trvá přibližně 30 ms, bylo jasné, že řešení DNS při volání Elasticsearch skutečně přispívá k nárůstu zpoždění.
To bylo však podivné z dvou důvodů:
- Máme již spoustu aplikací v Kubernetes, které komunikují se zdroji AWS, ale netrpí dlouhými latencemi. Jakýkoli důvod se vztahuje konkrétně k tomuto případu.
- Víme, že JVM provádí in-memory cachování DNS. V našich obrazech je hodnota TTL uvedena v
$JAVA_HOME/jre/lib/security/java.securitya nastavena na 10 sekund:networkaddress.cache.ttl = 10. Jinými slovy, JVM by měla cachovat všechny DNS dotazy po dobu 10 sekund.
Abychom potvrdili první hypotézu, rozhodli jsme se na chvíli vzdát DNS dotazů a podívat se, zda problém zmizí. Nejprve jsme se rozhodli přeconfigurovat aplikaci, aby se připojila k Elasticsearch přímo přes IP adresu, a ne prostřednictvím doménového jména. To by vyžadovalo úpravu kódu a nové nasazení, takže jsme prostě přiřadili doménu k její IP adrese v /etc/hosts:
34.55.5.111 elastic.spain.adevinta.comNyní kontejner dostal IP téměř okamžitě. To vedlo k určitému zlepšení, ale pouze jsme se mírně přiblížili očekávané úrovni latence. I když trvalo dlouho, než se DNS vyřešil, skutečný důvod nám stále unikal.
Diagnostika pomocí sítě
Rozhodli jsme se analyzovat provoz z kontejneru pomocí tcpdump, abychom zjistili, co se přesně děje v síti:
[root@be-851c76f696-alf8z \/]# tcpdump -leni any -w capture.pcap Poté jsme poslali několik dotazů a stáhli jejich záznam (kubectl cp my-service:\/capture.pcap capture.pcap) pro další analýzu v .
V DNS dotazech nebylo nic podezřelého (kromě jedné drobnosti, o které později povím). Ale byly určité podivnosti v tom, jak náš servis zpracovával každý dotaz. Níže je snímek obrazovky záznamu, který ukazuje přijetí dotazu před začátkem odpovědi:
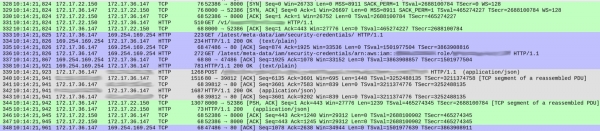
Čísla paketů jsou uvedena v prvním sloupci. Pro jasnost jsem barevně označil různé TCP toky.
Zelený tok, který začíná 328. paketu, ukazuje, jak klient (172.17.22.150) navázal TCP spojení s kontejnerem (172.17.36.147). Po počátečním handshake (328-330) přinesl paket 331 HTTP GET \/v1\.. — příchozí požadavek na náš servis. Celý proces trval 1 ms.
Šedý tok (od paketu 339) ukazuje, že náš servis poslal HTTP požadavek instance Elasticsearch (TCP handshake chybí, protože se používá již existující spojení). To trvalo 18 ms.
Zatím je vše v pořádku a časy přibližně odpovídají očekávaným latencím (20-30 ms při měřeních z klienta).
Modrá sekce však zabírá 86 ms. Co se v ní děje? S balíkem 333 naše služba poslala HTTP GET požadavek na /latest/meta-data/iam/security-credentials, a hned po něm, na tomtéž TCP spojení, další GET požadavek na /latest/meta-data/iam/security-credentials/arn:...
Zjistili jsme, že se to opakuje s každým požadavkem v celé trase. Rozlišení DNS je skutečně o něco pomalejší v našich kontejnerech (vysvětlení tohoto jevu je velmi zajímavé, ale nechám si ho na zvláštní článek). Ukázalo se, že příčinou velkých zpoždění jsou volání na službu AWS Instance Metadata při každém požadavku.
Hypotéza 2: zbytečné volání na AWS
Oba endpointy patří . Náš mikroslužba používá tuto službu při práci s Elasticsearch. Obě volání jsou součástí základního procesu autorizace. Endpoint, na který se volá při prvním požadavku, vrací IAM roli spojenou s instancí.
/ # curl http://169.254.169.254/latest/meta-data/iam/security-credentials/
arn:aws:iam::<account_id>:role/some_role
Druhý požadavek se obrací na druhý endpoint pro dočasná oprávnění pro tuto instanci:
/ # curl http://169.254.169.254/latest/meta-data/iam/security-credentials/arn:aws:iam::<account_id>:role/some_role`
{
    "Code" : "Success",
    "LastUpdated" : "2012-04-26T16:39:16Z",
    "Type" : "AWS-HMAC",
    "AccessKeyId" : "ASIAIOSFODNN7EXAMPLE",
    "SecretAccessKey" : "wJalrXUtnFEMI/K7MDENG/bPxRfiCYEXAMPLEKEY",
    "Token" : "token",
    "Expiration" : "2017-05-17T15:09:54Z"
}
Klient může tyto oprávnění využívat po krátkou dobu a pravidelně musí získávat nové certifikáty (do jejich Expiration). Model je jednoduchý: AWS často rotuje dočasné klíče z bezpečnostních důvodů, ale klienti je mohou cachovat na několik minut, čímž kompenzují pokles výkonu spojený s získáváním nových certifikátů.
AWS Java SDK by mělo zajišťovat organizaci tohoto procesu, ale z nějakého důvodu se tak neděje.
Při hledání problémů na GitHubu jsme narazili na problém . Pomohl nám určit směr, kterým bychom se měli dále "kopat".
AWS SDK aktualizuje certifikáty při splnění jedné z následujících podmínek:
- Platnost jejich vypršení (
Expiration) spadá doEXPIRATION_THRESHOLD, pevně nastaveného v kódu na 15 minut. - Od posledního pokusu o aktualizaci certifikátů uplynulo více času, než
REFRESH_THRESHOLD, což je "hardcoded" na 60 minut.
Abychom viděli skutečný termín vypršení získávaných certifikátů, provedli jsme výše uvedené cURL příkazy z kontejneru a z instance EC2. Doba platnosti certifikátu získaného z kontejneru byla mnohem kratší: přesně 15 minut.
Nyní je všechno jasné: pro první žádost náš služba získávala dočasné certifikáty. Protože jejich platnost nepřesahovala 15 minut, při dalších žádostech se AWS SDK rozhodlo je obnovit. A to se dělo s každou žádostí.
Proč se doba platnosti certifikátů zkrátila?
Služba AWS Instance Metadata je určena pro práci s instancemi EC2, nikoli s Kubernetes. Na druhou stranu jsme nechtěli měnit rozhraní aplikací. K tomu jsme využili — nástroj, který pomocí agentů na každém uzlu Kubernetes umožňuje uživatelům (inženýrům, kteří nasazují aplikace do clusteru) přiřadit IAM role kontejnerům v podech, jako by byly instancemi EC2. KIAM zachycuje volání ke službě AWS Instance Metadata a zpracovává je ze svého cache, přičemž je nejprve získává od AWS. Z pohledu aplikace se nic nemění.
KIAM dodává krátkodobé certifikáty podech. To je rozumné, pokud vezmeme v úvahu, že průměrná doba existence pode je kratší než u instance EC2. Ve výchozím nastavení je doba platnosti certifikátů .
Výsledkem je, že pokud překryjeme obě výchozí hodnoty, vzniká problém. Každý certifikát poskytnutý aplikaci vyprší po 15 minutách. Přičemž AWS Java SDK násilně obnovuje jakýkoli certifikát, u kterého zbývá do konce platnosti méně než 15 minut.
V důsledku toho se dočasný certifikát násilně obnovuje s každou žádostí, což vede k několika voláním API AWS a způsobuje značné zvýšení latence. V AWS Java SDK jsme objevili , ve kterém je zmíněn podobný problém.
Řešení se ukázalo jako jednoduché. Jednoduše jsme přenastavili KIAM, aby žádal o certifikáty s delší platností. Jakmile k tomu došlo, žádosti začaly probíhat bez účasti služby AWS Metadata a latence se snížila dokonce na nižší úroveň než v EC2.
Závěry
Na základě našich zkušeností s migracemi lze říci, že jedním z nejčastějších zdrojů problémů nejsou chyby v Kubernetes nebo jiných prvcích platformy. Také to není spojeno s žádnými zásadními nedostatky v mikroslužbách, které přenášíme. Problémy často vznikají prostě proto, že kombinujeme různé prvky.
Mícháme složité systémy, které nikdy předtím neinteragovaly, a očekáváme, že společně vytvoří jednotný, větší systém. Bohužel, čím více prvků, tím větší prostor pro chyby a tím vyšší entropie.
V našem případě vysoká latence nebyla výsledkem chyb nebo špatných rozhodnutí v Kubernetes, KIAM, AWS Java SDK nebo našem mikroslužbě. Stala se výsledkem kombinace dvou nezávislých parametrů, které byly nastaveny jako výchozí: jednoho v KIAM a druhého v AWS Java SDK. Samostatně oba parametry dávají smysl: jak aktivní politika obnovování certifikátů v AWS Java SDK, tak krátká doba platnosti certifikátů v KIAM. Ale pokud je spojíme, výsledky se stanou nepředvídatelnými. Dvě nezávislá a logická rozhodnutí nemusí mít smysl při kombinaci.
P.S. od překladatele
Více informací o architektuře nástroje KIAM pro integraci AWS IAM s Kubernetes naleznete u jeho tvůrců.
A v našem blogu si také přečtěte:
- «»;
- «»;
- «»;
- «».
Zdroj: habr.com
