

Jmenuji se Viktor Jagoofarov a pracuji na rozvoji Kubernetes platformy ve společnosti DomClick jako technický vedoucí vývoje v týmu Ops (provoz). Rád bych vyprávěl o struktuře našich Dev <-> Ops procesů, o zvláštnostech provozu jednoho z největších k8s clusterů v Rusku a také o DevOps/SRE praktikách, které náš tým používá.
Tým Ops
V týmu Ops momentálně pracuje 15 lidí. Tři z nich mají na starosti kancelář, dva pracují v jiném časovém pásmu a jsou dostupní, včetně noci. Tím pádem je vždy někdo z Ops u monitoru a připraven reagovat na incident jakékoliv složitosti. Nemáme noční služby, což chrání naši psychiku a dává všem možnost dostatečně vyspat a trávit volný čas nejen před počítačem.
Všichni máme různé kompetence: síťaři, DBA, specialisté na ELK stack, Kubernetes administrátoři/vývojáři, odborníci na monitoring, virtualizaci, hardware atd. Spojuje nás to, že každý může v určité míře nahradit kohokoliv z nás: například zavést nové nody do k8s clusteru, aktualizovat PostgreSQL, napsat CI/CD pipeline + Ansible, automatizovat něco v Pythonu/Bash/Go, připojit hardware do datového centra. Silné kompetence v určité oblasti nebrání změnit smě方向 a začít se rozvíjet v jiné oblasti. Například jsem do společnosti nastoupil jako specialista na PostgreSQL, ale nyní je mojí hlavní zodpovědností správa Kubernetes clusterů. V týmu je jakýkoliv růst vítán a cítíme silnou podporu jeden od druhého.
Mimochodem, hledáme nové lidi. Požadavky na uchazeče jsou poměrně standardní. Osobně je pro mě důležité, aby se člověk hodil do kolektivu, byl nekonfliktní, přitom však dokázal hájit svůj názor, chtěl se rozvíjet a nebál se zkoušet něco nového, navrhoval své nápady. Dále jsou nezbytné dovednosti programování ve skriptovacích jazycích, znalosti základů Linuxu a angličtiny. Angličtina je potřeba jen proto, aby si mohl člověk v případě problému rychle vyhledat řešení za 10 sekund, nikoli za 10 minut. Se specialisty s hlubokými znalostmi Linuxu je nyní velmi obtížné: směšné, ale dva z tří uchazečů nedokážou odpovědět na otázku „Co je to Load Average? Z čeho se skládá?“ a otázku „Jak zpracovat core dump ze C programu“ považují za něco, co patří do světa superlidí… nebo dinosaurů. S tím se musíme smířit, protože obvykle mají lidé výrazně rozvinuté jiné kompetence, a „Linux“ je naučíme. Odpověď na otázku „proč to všechno potřebuje DevOps inženýr v moderním světě cloudů“ si necháme stranou, ale zjednodušeně řečeno: je to všechno potřeba.
Tým Nástroje
Významnou roli v automatizaci hraje tým Nástroje. Jejich hlavním úkolem je vytváření uživatelsky přívětivých grafických a CLI nástrojů pro vývojáře. Například náš interně vyvinutý nástroj Confer umožňuje doslova několika kliknutími myši nasadit aplikaci do Kubernetes, nastavit ji zdroje, klíče z vault atd. Dříve jsme používali Jenkins + Helm 2, ale museli jsme vyvinout vlastní nástroj, abychom vyloučili kopírování a vnesli jednotnost do životního cyklu softwaru.
Tým Ops nenapíše pipeline za vývojáře, ale může poskytnout konzultace ohledně jakýchkoli otázek o jejich psaní (někteří stále používají Helm 3).
DevOps
Pokud jde o DevOps, vidíme ho takto:
Týmy Dev píší kód a nasazují jej přes Confer do dev -> qa/stage -> prod. Odpovědnost za to, aby kód nebrzdil a nevytvářel chyby, leží na týmech Dev a Ops. Během dne by na incident se svým aplikací měl primárně reagovat dozorčí z týmu Ops, a během večera a noci by měl dozorčí administrátor (Ops) vzbudit dozorčího vývojáře, pokud si je jist, že problém není v infrastruktuře. Všechny metriky a alarmy v monitoringu se objevují automaticky nebo poloautomaticky.
Oblast odpovědnosti Ops začíná okamžikem nasazení aplikace do produkce, ale odpovědnost Dev tím nekončí — děláme to stejné a jsme na jedné lodi.
Vývojáři konzultují správce, pokud potřebují pomoc s psaním administrativního mikroslužby (například Go backend + HTML5), a správci konzultují vývojáře ohledně jakýchkoliv infrastrukturních otázek nebo otázek souvisejících s k8s.
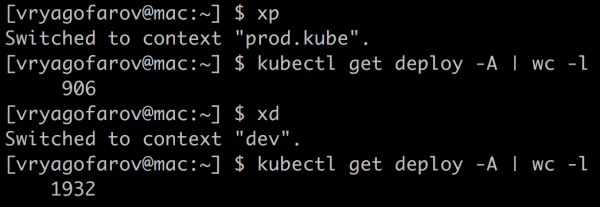
Mimochodem, vůbec nemáme monolit, pouze mikroslužby. Jejich počet se zatím pohybuje mezi 900 a 1000 v produkčním k8s clusteru, pokud měříme podle počtu nasazení. Počet podů kolísá mezi 1700 a 2000. V produkčním clusteru je nyní kolem 2000 podů.
Přesná čísla nemohu uvést, protože sledujeme nepotřebné mikroslužby a odstraňujeme je v poloautomatickém režimu. Sledování nepotřebných entit v k8s nám pomáhá , což skvěle šetří zdroje a peníze.
Správa zdrojů
Monitoring
Stěžejním kamenem provozování velkého clusteru se stává správně nastavený a informativní monitoring. Zatím jsme nenašli univerzální řešení, které by pokrylo 100 % všech "přání" ohledně monitorování, proto periodicky vytváříme různá vlastní řešení v tomto prostředí.
- Zabbix. Starý dobrý monitoring, který je určen především k sledování celkového stavu infrastruktury. Říká nám, když node umírá kvůli využití CPU, paměti, disků, sítě a tak dále. Nic nadpřirozeného, ale máme také samostatný DaemonSet agentů, s nimiž například monitorujeme stav DNS v clusteru: hledáme zpomalující pody coredns, kontrolujeme dostupnost externích hostitelů. Mohlo by se zdát, proč se tímto zabývat, ale při velkých objemech provozu je tento komponent vážným bodem selhání. Už dříve jsem , jak jsem bojoval s výkonem DNS v clusteru.
- Prometheus Operator. Sada různých exporterů poskytuje velký přehled o všech komponentách clusteru. Dále to vizualizujeme na velkých dashboards v Grafana a pro upozornění používáme alertmanager.
Dalším užitečným nástrojem pro nás byl Napsali jsme ho poté, co jsme se několikrát setkali se situací, kdy jeden tým překrývá své cesty Ingress druhého týmu, což způsobuje chyby 50x. Nyní před nasazením na produkci vývojáři kontrolují, že se nikoho nedotknou, a pro můj tým je to dobrý nástroj pro základní diagnostiku problémů s Ingress. Je zajímavé, že byl původně napsán pro administrátory a vypadal docela "neohrabaně", ale poté, co si nástroj oblíbily vývojářské týmy, se výrazně proměnil a přestal vypadat jako "administrátor udělal webovou stránku pro administrátory". Brzy se tohoto nástroje vzdáme a podobné situace budou validovány ještě před nasazením pipeline.
Zdroje týmů v "Kube"
Než se pustíme do příkladů, stojí za to vysvětlit, jak u nás funguje přidělování zdrojů pro mikroslužby.
Abychom pochopili, jaké týmy a v jakých množstvích používají své zdroje (procesor, paměť, místní SSD), přidělujeme každému týmu jeho vlastní namespace v "Kube" a omezujeme jeho maximální možnosti podle procesoru, paměti a disku, přičemž předem projednáme potřeby týmů. Z toho důvodu jeden tým obvykle nezablokuje celý cluster pro nasazení tím, že by si přidělil tisíce jader a terabajty paměti. Přístupy do namespace se vydávají přes AD (používáme RBAC). Namespace a jejich limity se přidávají prostřednictvím pull requestu do GIT repozitáře, a poté se pomocí Ansible pipeline vše automaticky nasadí.
Příklad přidělení zdrojů na tým:
namespaces:

  chat-team:
    pods: 23
    limits:
      cpu: 11
      memory: 20Gi
    requests:
      cpu: 11
      memory: 20Gi
Requesty a limity
V "Kube" Request je množství garantovaných rezervovaných zdrojů pro pod (jeden nebo více Docker kontejnerů) v clusteru. Limit je negarantovaný maximum. Často lze vidět na grafech, jak nějaký tým si vystavil příliš mnoho requestů pro všechny své aplikace a nemůže nasadit aplikaci do "Kube", protože všechny requesty v jejich namespace už byly "vyčerpány".
Správný způsob, jak se z této situace dostat: sledovat skutečnou spotřebu zdrojů a srovnávat ji s požadovaným množstvím (Request).
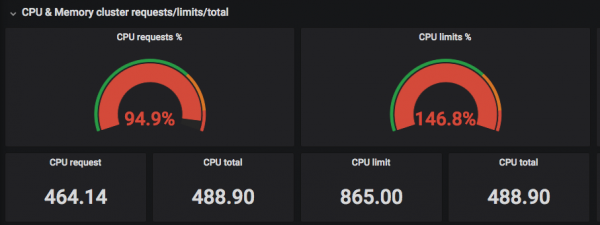
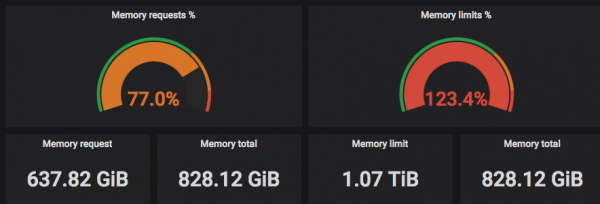
Na snímkách obrazovky výše je vidět, že "požadované" (Requested) CPU se přizpůsobují skutečnému počtu vláken, zatímco Limity mohou překračovat skutečný počet vláken procesorů =)
Nyní podrobně prozkoumáme nějaký namespace (vybral jsem namespace kube-system — systémový namespace pro komponenty samotného „Kuba“) a podíváme se na poměr skutečně využitého procesorového času a paměti k požadovanému:
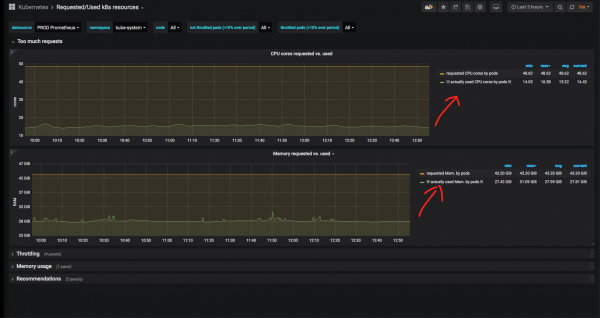
Je zřejmé, že pro systémové služby je vyhrazeno mnohem více paměti a CPU, než kolik se skutečně používá. V případě kube-system to má opodstatnění: docházelo k situacím, kdy nginx ingress controller nebo nodelocaldns během špičky dosahovaly maximálního CPU a zabíraly velmi mnoho RAM, proto je zde taková rezerva oprávněná. Kromě toho se nemůžeme spolehnout na grafy za poslední 3 hodiny: je dobré vidět historické metriky za delší časové období.
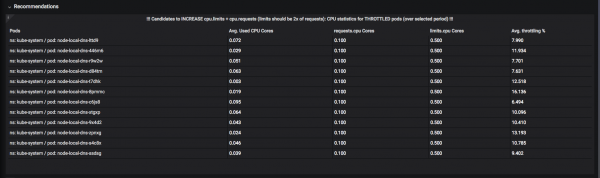
Byl vyvinut systém „doporučení“. Například zde lze vidět, jaké zdroje by bylo lepší zvýšit „limity“ (horní povolená úroveň), aby nedocházelo k „trotlinu“ (throttling): momentu, kdy se již využilo CPU nebo paměť během přiděleného časového úseku a čeká na „rozmrazení“:
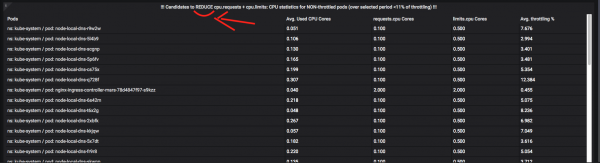
A tady jsou pody, které by měly umírnit své chutě:
O trotlinu + monitorování zdrojů lze napsat nejen jeden článek, proto se ptejte na otázky v komentářích. Ve zkratce mohu říci, že úkol automatizace podobných metrik je velmi obtížný a vyžaduje mnoho času a akrobatiky s „okenními“ funkcemi a „CTE“ Prometheus / VictoriaMetrics (tyto termíny jsou vzaty do uvozovek, protože v PromQL téměř neexistuje nic podobného a musí se vytvářet strašidelné dotazy na několik obrazovek textu a zabývat se jejich optimalizací).
Výsledkem je, že vývojáři mají nástroje pro monitorování svých namespaces v „Kubě“, a jsou schopni sami rozhodnout, kde a kdy lze některým aplikacím „seříznout“ zdroje, a kterým podům lze na celou noc přidělit celé CPU.
Metodologie
Ve firmě, jak je nyní módní, se držíme DevOps- a SRE-praktik. Když má firma 1000 mikroslužeb, přibližně 350 vývojářů a 15 administrátorů pro celou infrastrukturu, je potřeba „být módní“: za všemi těmito „buzzwordy“ se skrývá naléhavá potřeba automatizace všeho a administrátoři nesmí být zúženým hrdlem v procesech.
Jako Ops poskytujeme různé metriky a dashboardy pro vývojáře, související s rychlostí odpovědí služeb a jejich chybami.
Používáme metodologie jako: , a , kombinováním dohromady. Snažíme se minimalizovat počet dashboardů tak, aby z jednoho pohledu bylo jasné, který servis právě degraduje (například kódy odpovědí za sekundu, čas odpovědi v 99. percentilu) a tak dále. Jakmile jsou potřebné nějaké nové metriky pro společné dashboardy, okamžitě je navrhneme a přidáme.
Nepřipravoval jsem grafy už měsíc. Asi to je dobré znamení: to znamená, že většina "přání" už byla realizována. Občas jsem za týden kreslil alespoň jednou za den nějaký nový graf.
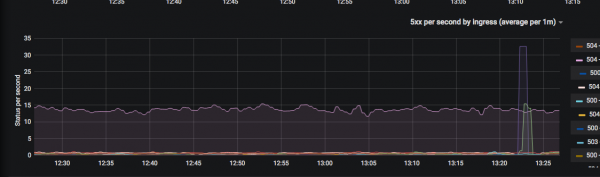
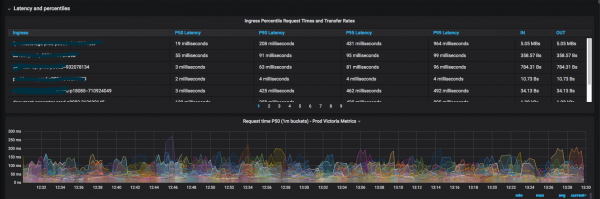
Výsledný výstup je cenný tím, že teď vývojáři celkem zřídka chodí k administrátorům s otázkami "kde se podívat na nějakou metriku".
Zavedení Service Mesh nám už klepe na dveře a mělo by všem hodně usnadnit život, kolegové z Tools jsou už blízko zavedení abstraktního „Istio zdravého člověka“: životní cyklus každého HTTP(s) požadavku bude viditelný v monitorování a vždy bude možné pochopit „v jaké fázi se to všechno rozbilo“ během meziservisní (a nejen) interakce. Přihlaste se k odběru novinek hubu společnosti DomClick. =)
Podpora infrastruktury Kubernetes
Historicky jsme používali upravenou verzi Kubespray — Ansible role pro nasazení, rozšiřování a aktualizaci Kubernetes. V určitém okamžiku byla z hlavní větve odstraněna podpora non-kubeadm instalací, a proces přechodu na kubeadm nebyl navržen. Nakonec společnost Southbridge vytvořila svůj fork (s podporou kubeadm a rychlým opravou kritických problémů).
Proces aktualizace všech clusterů k8s vypadá takto:
- Bereme Kubespray od Southbridge, porovnáme naši větev, sloučíme.
- Vydáváme aktualizaci do Stress- „Kuba“.
- Vydáváme aktualizaci po jedné nódě (v Ansible to je „serial: 1“) do Dev- „Kuba“.
- Aktualizujeme Prod v sobotu večer po jedné nódě.
V budoucnu máme plány nahradit Kubespray něčím rychlejším a přejít na kubeadm.
Celkem máme tři „Kuby“: Stress, Dev a Prod. Plánujeme spustit další (hot standby) Prod-„Kubu“ ve druhém datovém centru. Stress a Dev žijí ve „virtuálech“ (oVirt pro Stress a VMWare cloud pro Dev). Prod- „Kuba“ běží na „holém železe“ (bare metal): jedná se o stejné nody s 32 CPU vlákny, 64-128 GB paměti a 300 GB SSD RAID 10 — celkem jich je 50. Tři „tenké“ nody jsou vyhrazeny pro „master“ Prod- „Kuby“: 16 GB paměti, 12 CPU vláken.
Pro produkci preferujeme používat „holé železo“ a vyhýbáme se zbytečným vrstvením jako je OpenStack: nepotřebujeme „hlukové sousedy“ a CPU steal time. A složitost správy se zvyšuje přibližně dvakrát v případě in-house OpenStack.
Pro CI/CD „Kubernetes“ a další infrastrukturní komponenty používáme samostatný GIT server, Helm 3 (přechod z Helm 2 byl docela bolestivý, ale jsme velmi rádi za tuto možnost, atomic), Jenkins, Ansible a Docker. Milujeme feature branch a nasazení do různých prostředí z jednoho repozitáře.
Závěr
Takto, v obecných rysech, v společnosti DomClick vypadá proces DevOps z pohledu provozního technika. Článek se ukázal být méně technický, než jsem očekával: sledujte novinky DomClick na Habré, budou tam více „hardcore“ články o Kubernetes a nejen o něm.
Zdroj: habr.com
