

Rok 2019 a my stále nemáme standardní řešení pro agregaci logů v Kubernetes. V tomto článku bychom rádi sdíleli naše hledání, potíže, se kterými jsme se setkali, a jejich řešení na základě příkladů z praxe.
Než začnu, rád bych poznamenal, že různí klienti chápou sběr logů velmi různě:
- někdo chce vidět security a audit logy;
- někdo – centralizované logování celé infrastruktury;
- a někomu stačí sbírat pouze logy aplikace, vyloučivši například vyrovnávače zatížení.
O tom, jak jsme realizovali různé „přání“ a s jakými obtížemi jsme se setkali, se dočtete níže.
Teorie: o nástrojích pro logy
Pozadí o komponentách systému logování
Logování prošlo dlouhou cestu, v jejímž důsledku byly vyvinuty metodologie sběru a analýzy logů, které dnes používáme. Již v 50. letech 20. století se ve Fortranu objevila analogie standardních vstupně-výstupních proudů, které pomáhaly programátorům při ladění jejich programů. To byly první počítačové logy, které usnadnily život programátorům té doby. Dnes v nich vidíme první komponent systému logování – zdroj nebo „výrobce“ (producer) logů.
Informatika nezůstala stát na místě: vznikly počítačové sítě, první klastry… Začaly fungovat složité systémy skládající se z několika počítačů. Nyní byli systémoví administrátoři nuceni sbírat logy z několika strojů, a v některých případech mohli do sběru zahrnout i zprávy jádra operačního systému pro případ vyšetřování systémového selhání. Pro popis systémů centralizovaného sběru logů byl na počátku 2000. let vydán , který standardizoval remote_syslog. Tak se objevil další důležitý komponent: sběratel logů a jejich úložiště.
S rostoucím objemem logů a rozšířením webových technologií vznikl problém, jak logy pohodlně prezentovat uživatelům. Na místo jednoduchých konzolových nástrojů (awk/sed/grep) přišly pokročilejší prohlížeče logů – třetí komponent.
Vzhledem k nárůstu objemu logů se ukázalo i něco jiného: logy jsou potřebné, ale ne všechny. Různé logy také vyžadují různou úroveň uchovávání: některé lze ztratit za den, zatímco jiné je třeba uchovávat 5 let. Do systému logování byl tedy přidán komponent filtraci a směrování datových toků — nazvěme ho filtr.
Úložiště také udělalo významný skok: ze běžných souborů přešlo na relační databáze a poté na dokumentově orientovaná úložiště (například Elasticsearch). Tak se separovalo úložiště od sběrače.
Nakonec se samotné pojetí logu rozšířilo na jakýsi abstraktní tok událostí, které chceme ukládat pro historii. Přesněji řečeno — pro případ, kdy bude potřeba provést vyšetřování nebo vytvořit analytickou zprávu…
Výsledkem je, že za relativně krátkou dobu se sběr logů vyvinul v důležitou podsystém, který lze právem nazvat jedním z pododdělení v Big Data.
Pokud kdysi běžné printy mohly být dostatečné pro "systém logování", dnes je situace výrazně jiná.
Kubernetes a logy
Když do infrastruktury přišel Kubernetes, existující problém sběru logů se ho také dotkl. V jistém smyslu se stal ještě bolestnějším: správa infrastrukturní platformy byla nejen zjednodušena, ale zároveň i zkomplikována. Mnohé staré služby začaly migrovat na mikroslužbové tratě. V kontextu logů to vyjádřilo rostoucí počet zdrojů logů, jejich specifický životní cyklus a potřebu sledovat vzájemné vztahy všech komponent systému prostřednictvím logů…
Předbíhám, mohu konstatovat, že nyní bohužel neexistuje standardizovaná varianta logování pro Kubernetes, která by se výrazně odlišila od všech ostatních. Nejpopulárnější v komunitě schémata se zjednodušují na následující:
- někdo nasazuje stack EFK (Elasticsearch, Fluentd, Kibana);
- někdo se pokouší o nedávno vydanou nebo používá ;
- nás (a možná nejen nás?..) mnohdy uspokojuje vlastní vývoj — …
Obvykle používáme takové kombinace v K8s clusterech (pro self-hosted řešení):
- ;
- .
Nicméně se nebudu zastavovat u pokynů k jejich instalaci a konfiguraci. Místo toho se zaměřím na jejich nedostatky a obecnější závěry ohledně situace s logy celkově.
Praktika s logy v K8s
„Každodenní logy“, kolik vás je?..
Centralizované shromažďování logů z dostatečně velké infrastruktury vyžaduje značné zdroje, které budou použity na shromažďování, ukládání a zpracování logů. Během provozu různých projektů jsme se setkali s různými požadavky a problémy, které z nich vyplývají.
Vyzkoušíme ClickHouse
Podívejme se na centralizované úložiště v projektu s aplikací, která generuje logy poměrně aktivně: více než 5000 řádků za sekundu. Zahájíme práci s jejím logem, shromažďující je v ClickHouse.
Jakmile bude vyžadován maximální realtime, čtyřjádrový server s ClickHouse už bude přetížen diskovým subsystémem:
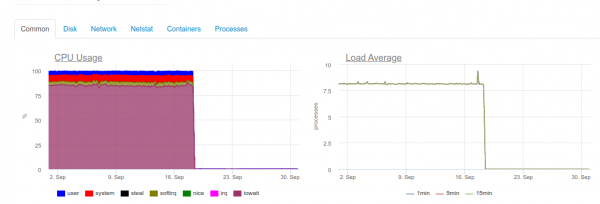
Tento typ zátěže souvisí s tím, že se snažíme co nejrychleji zapisovat do ClickHouse. A na to databáze reaguje zvýšeným zatížením disku, což může způsobit následující chyby:
DB::Exception: Příliš mnoho částí (300). Sloučení zpracovává výrazně pomaleji než vkládání
Věc se má tak, že v ClickHouse (u nich jsou uložena data logů) mají své obtíže při operacích zápisu. Vkládaná data generují dočasnou partii, která se pak sloučí s hlavní tabulkou. V důsledku toho je zápis velmi náročný na disk, a také se na něj vztahuje omezení, o kterém jsme výše obdrželi upozornění: za 1 sekundu se může sloučit nejvýše 300 subpartií (fakticky to odpovídá 300 insertů za sekundu).
Abychom se vyhnuli takovému chování, co největšími bloky a ne častěji než jednou za 2 sekundy. Nicméně zápis velkými bloky předpokládá, že musíme méně často zapisovat do ClickHouse. To následně může vést k přetečení vyrovnávací paměti a ztrátě logů. Řešením je zvýšit vyrovnávací paměť Fluentd, ale tím se zvýší i spotřeba paměti.
Poznámka: Další problémová stránka našeho řešení s ClickHouse byla spojena s tím, že partitioning v našem případě (loghouse) byl realizován přes externí tabulky, které jsou spojeny Tohoto dochází k tomu, že při výběru velkých časových intervalů je zapotřebí nadměrná operační paměť, protože metatabulka prochází všechny partition — i ty, které zjevně neobsahují potřebná data. Nicméně, v současnosti lze tento přístup s jistotou prohlásit za zastaralý pro aktuální verze ClickHouse (c ).
Výsledkem je, že pro sběr logů v reálném čase v ClickHouse nestačí prostředky každého projektu (přesněji, jejich rozdělení nebude rozumné). Kromě toho bude nutné použít akumulátor, k němuž se ještě vrátíme. Popsaný případ je skutečný. A v tu chvíli jsme nemohli nabídnout spolehlivé a stabilní řešení, které by vyhovovalo zákazníkovi a umožnilo by sbírat logy s minimálním zpožděním…
A co Elasticsearch?
Je známo, že Elasticsearch zvládá velké zátěže. Zkusíme ho v tomtéž projektu. Teď zátěž vypadá následovně:
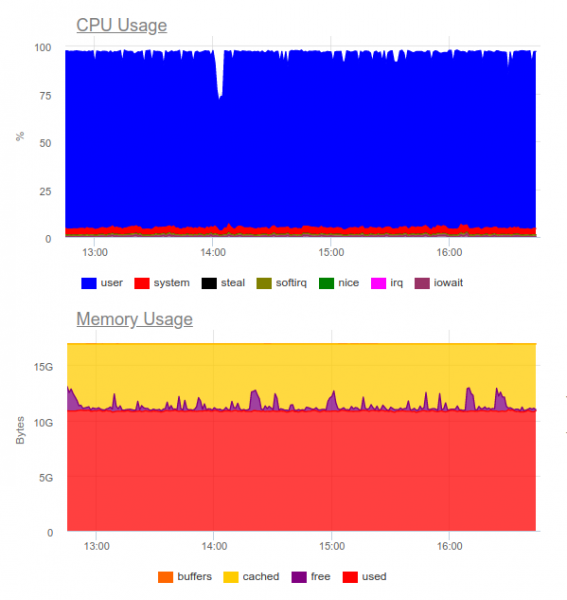
Elasticsearch dokázal zpracovat tok dat, avšak zápis takových objemů do něj silně zatěžuje CPU. To se řeší organizací clustera. Technicky to není problém, nicméně se ukáže, že jen pro fungování systému sběru logů již využíváme kolem 8 jader a máme v systému navíc vysoce zatíženou komponentu…
Výsledek: tato varianta může být oprávněná, ale pouze v případě, že je projekt velký a jeho vedení je ochotno utratit značné zdroje na systém centralizovaného logování.
Pak vyvstává logická otázka:
Jaké logy jsou skutečně potřebné?
 Zkusíme změnit samotný přístup: logy by měly být zároveň informativní a nepokrývat každou událost v systému.
Představme si, že máme úspěšný internetový obchod. Jaké logy jsou důležité? Shromáždit maximální informace, například z platební brány — to je skvělý nápad. Ale od služby pro ořezávání obrázků v katalogu produktů nám kritické nejsou všechny logy: stačí pouze chyby a rozšířený monitoring (například na procento 500 - chyby, které generuje tato komponenta).
A jsme u toho, že centralizované logování není vždy oprávněné.Velmi často chce klient shromáždit všechny logy na jednom místě, přičemž ve skutečnosti z celého logu je potřebných pouze přibližně 5 % zpráv, které jsou kritické pro podnikání:
- Někdy stačí nastavit třeba pouze velikost logu kontejneru a chybového sběratele (například Sentry).
- Pro vyšetřování incidentů často postačuje upozornění na chybu a vlastně velký lokální log.
- Měli jsme projekty, které se úplně obešly výhradně s funkčními testy a systémy sběru chyb. Vývojář nepotřeboval logy jako takové – vše viděl podle tras chyb.
Ilustrace ze života
Dobrou ukázkou může být jiný příběh. Dostal se k nám požadavek od týmu bezpečnostních pracovníků jednoho z klientů, který již používal komerční řešení, jež bylo vyvinuto dlouho před zavedením Kubernetes.
Bylo třeba "svařit" systém centralizovaného sběru logů s firemním senzorem pro detekci problémů – QRadar. Tento systém umí přijímat logy přes protokol syslog, stahovat je z FTP. Integrace s pluginem remote_syslog pro fluentd se však hned tak nepodařila. (jak se ukázalo, ). Problémy s nastavením QRadar byly na straně týmu bezpečnostních pracovníků klienta.
V důsledku toho se část logů, které byly kritické pro podnikání, stanovila na FTP QRadar, a druhá část byla přímo přesměrována přes remote syslog z uzlů. K tomu jsme dokonce napsali – možná pomůže někomu vyřešit podobný úkol… Díky vyvinuté schémě klient získal a analyzoval kritické logy (pomocí svých oblíbených nástrojů), a zároveň jsme mohli snížit náklady na systém logování, přičemž jsme uchovávali pouze poslední měsíc.
Další příklad je poměrně výmluvný v tom, jak to dělat neměli. Jeden z našich klientů na zpracování každou události přicházející od uživatele vytvořil vícerozměrný neustrukturovaný výstup informací do logu. Jak snadno tušíte, takové logy bylo extrémně nepohodlné jak číst, tak uchovávat.
Kritéria pro logy
Takové příklady nás vedou k závěru, že kromě výběru systému sběru logů je třeba navrhnout i samotné logy! Jaké jsou zde požadavky?
- Logy musí být v strojově čitelném formátu (například JSON).
- Logy by měly být kompaktní a s možností měnit úroveň logování, aby bylo možné ladit případné problémy. Přitom by se v produkčních prostředích měly spouštět systémy s úrovní logování jako Varování nebo Chyba.
- Protokoly by měly být normalizovány, což znamená, že ve struktuře protokolu by všechny řetězce měly mít stejný typ pole.
Nestrukturované protokoly mohou způsobit problémy s nahráváním logů do úložiště a úplným zastavením jejich zpracování. Jako příklad uvádíme chybu 400, se kterou se mnozí jistě setkali v logech fluentd:
2019-10-29 13:10:43 +0000 [warn]: dump an error event: error_class=Fluent::Plugin::ElasticsearchErrorHandler::ElasticsearchError error="400 - Odmítnuto Elasticsearch"
Chyba znamená, že do indexu posíláte pole, jehož typ není stabilní, s připravenou mapou. Nejjednodušší příklad je pole v logu nginx s proměnnou $upstream_status. Může obsahovat jak číslo, tak řetězec. Například:
{ "ip": "1.2.3.4", "http_user": "-", "request_id": "17ee8a579e833b5ab9843a0aca10b941", "time": "29\/Oct\/2019:16:18:57 +0300", "method": "GET", "uri": "\/staffs\/265.png", "protocol": "HTTP\/1.1", "status": "200", "body_size": "906", "referrer": "https:\/\/example.com\/staff", "user_agent": "Mozilla\/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit\/537.36 (KHTML, like Gecko) Chrome\/78.0.3904.70 Safari\/537.36", "request_time": "0.001", "cache_status": "-", "upstream_response_time": "0.001, 0.007", "upstream_addr": "127.0.0.1:9000", "upstream_status": "200", "upstream_response_length": "906", "location": "staff"}
 { "ip": "1.2.3.4", "http_user": "-", "request_id": "47fe42807f2a7d8d5467511d7d553a1b", "time": "29\/Oct\/2019:16:18:57 +0300", "method": "GET", "uri": "\/staff", "protocol": "HTTP\/1.1", "status": "200", "body_size": "2984", "referrer": "-", "user_agent": "Mozilla\/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit\/537.36 (KHTML, like Gecko) Chrome\/78.0.3904.70 Safari\/537.36", "request_time": "0.010", "cache_status": "-", "upstream_response_time": "0.001, 0.007", "upstream_addr": "10.100.0.10:9000, 10.100.0.11:9000", "upstream_status": "404, 200", "upstream_response_length": "0, 2984", "location": "staff"}
V logách je vidět, že server 10.100.0.10 odpověděl chybou 404 a dotaz byl odeslán na jiné úložiště obsahu. V důsledku toho se hodnota v logách změnila na:
"upstream_response_time": "0.001, 0.007"
Tato situace je tak častá, že si zasloužila dokonce samostatné .
A co spolehlivost?
Jsou případy, kdy jsou potřeba všechny protokoly bez výjimky. A s tím mají typové schémy sběru logů pro K8s, uvedené/vyhodnocované výše, problémy.
Například fluentd nemůže shromáždit protokoly z krátkodobých kontejnerů. V jednom z našich projektů kontejner s migrací databází žil méně než 4 sekundy, a poté byl odstraněn podle příslušné anotace:
"helm.sh/hook-delete-policy": hook-succeeded
Kvůli tomu se log migrace nedostal do úložiště. V tomto případě může pomoci politika before-hook-creation.
Další příklad – rotace logů Dockeru. Představte si aplikaci, která aktivně zapisuje do logů. V normálních podmínkách stihneme zpracovat všechny logy, ale jakmile se objeví problém – například, jak bylo uvedeno výše s nesprávným formátem – zpracování se zastaví a Docker rotuje soubor. Výsledek – mohou být ztraceny kritické logy pro byznys.
Právě proto je důležité oddělovat toky logů, a to tím, že se nejcennější logy odesílají přímo do aplikace, aby byla zajištěna jejich integrita. Kromě toho nebude na škodu vytvoření jakéhosi „akumulátoru“ logů, který dokáže přežít krátkodobou nedostupnost úložiště při zachování kritických zpráv.
Nakonec nelze zapomenout, že jakoukoli subsystému je důležité kvalitně monitorovat. Jinak se snadno dostanete do situace, kdy je fluentd v stavu CrashLoopBackOff a nic neodesílá, což může znamenat ztrátu důležitých informací.
Závěry
V tomto článku se nezaměřujeme na řešení SaaS jako je Datadog. Mnoho z problémů zde popsaných již vyřešily komerční společnosti specializující se na sběr logů, ale ne všichni mohou používat SaaS z různých důvodů. (hlavní jsou náklady a dodržování 152-FZ).
Centralizovaný sběr logů se na první pohled jeví jako jednoduchý úkol, ale rozhodně tomu tak není. Je důležité si pamatovat, že:
- Podrobně logovat je třeba pouze kritické komponenty, zatímco pro ostatní systémy je možné nastavit monitoring a sběr chyb.
- Logy v produkci by měly být co nejmenší, aby nedocházelo k zbytečnému zatížení.
- Logy by měly být strojově čitelné, normalizované, mít přísný formát.
- Opravu kritické logy je dobré posílat zvláštním tokem, který by měl být oddělen od hlavního.
- Je dobré promyslet akumulátor logů, který může ochránit před výkyvy ve vysokém zatížení a zajistit rovnoměrnější zátěž na úložiště.
Tato jednoduchá pravidla, pokud by se uplatnila všude, by umožnila fungování i výše popsaných schémat — i přes to, že jim chybí důležité komponenty (akumulátor). Pokud se však těchto principů nedodržuje, úkol snadno povede vás a infrastrukturu k dalšímu vysoce zatíženému (a zároveň málo efektivnímu) komponentu systému.
P.S.
Přečtěte si také náš blog:
- «»;
- «»;
- «».
Zdroj: habr.com
