

Podíváme se na základy logování v Dockeru a Kubernetes a poté si představíme dva nástroje, které lze s klidem používat v produkci: Grafana Loki a EFK stack (Elasticsearch + Fluent Bit + Kibana).
Materiál článku — shrnutí z . Pokud máte zájem a navíc výrobní potřebu, můžete absolvovat kompletní školení — přihlaste se na kurz o .
Logování v Dockeru
Na úrovni Kubernetes jsou aplikace spuštěny v podech, ale na měsíční úrovni obvykle fungují v Dockeru. Proto je třeba nastavit logování tak, aby se shromáždily logy z kontejnerů. Kontejnery spouští Docker — takže je třeba zjistit, jak je logování nastaveno na úrovni Dockeru.
Doufám, že každý čtenář ví: logy aplikace by měly být psány na stdout/stderr, a ne dovnitř kontejneru. Logy agreguje Docker Daemon a ten pracuje přesně s těmi logy, které jsou odesílány na stdout/stderr. Kromě toho psaní logů dovnitř kontejneru přináší problémy: kontejner se nafukuje díky rostoucím logům (protože v kontejneru pravděpodobně není žádný Logrotate) a Docker Daemon o těchto logách ani neví.
Docker má několik logovacích ovladačů nebo pluginů pro shromažďování logů kontejnerů. V bezplatné verzi Docker Community Edition (CE) je méně logovacích ovladačů než v komerční Docker Enterprise Edition (EE).
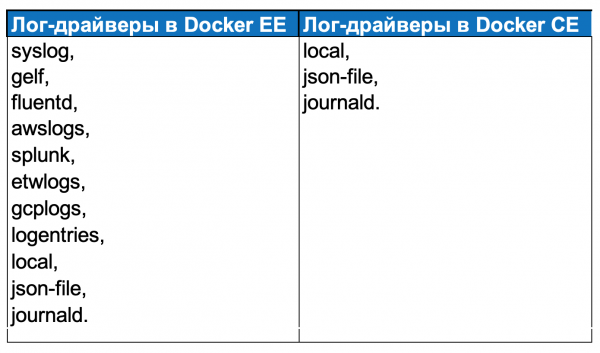
Docker EE jsem nikdy v praxi nepoužil: ve Southbridge se snažíme držet otevřených zdrojových řešení a našim klientům většina dodatečných funkcí Docker EE není potřebná.
Logovací ovladače v Docker CE:
local — záznam logů do interních souborů Docker Daemon;
json-file — vytváření json-logu v každém kontejneru;
journald — odesílání logů do journald.
Nastavení logování v Dockeru se nachází v souboru daemon.json.
V poli „log-driver“ je uveden plugin a v poli „log-opts“ — jeho nastavení. V příkladu výše byl uveden plugin „json-file“, limit velikosti logu — „max-size“: „10m“; limit počtu souborů (nastavení rotace) — „max-file“: „3“; a také hodnoty, které budou připojeny k logům.
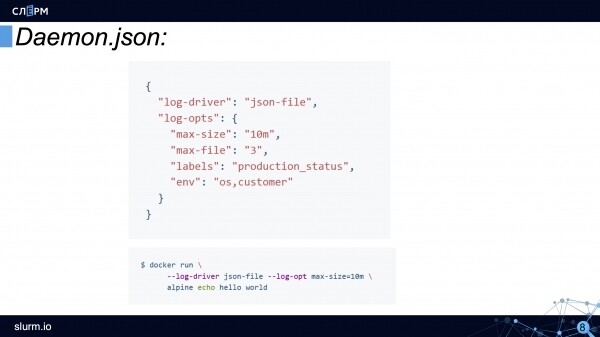
Některá nastavení logovacího ovladače lze definovat pomocí příkazové utility. To je výhodné, pokud je potřeba spustit konkrétní kontejner s jiným logovacím ovladačem.
Takto vypadá schéma logování v Dockeru:
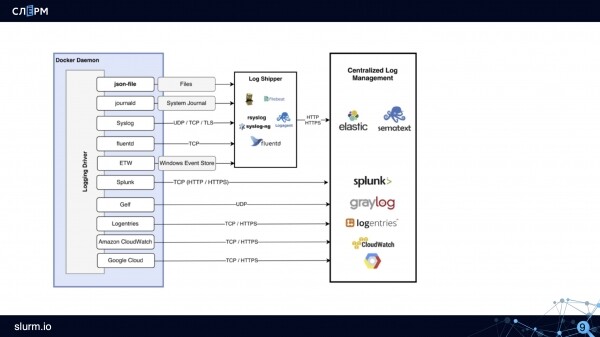
Jak schéma funguje: log-drivre, například json-file, vytváří soubory. Shromažďovače logů (Rsyslog, Fluentd, Logagent a další) tyto soubory shromažďují a odesílají na ukládání do Elastic, Sematext nebo jiných úložišť.
Vlastnosti logování v Kubernetes
Zjednodušeně schéma logování v Kubernetes vypadá takto: je zde pod, uvnitř je spuštěný kontejner, kontejner posílá logy do stdout/stderr. Poté Docker vytváří soubor a zapisuje logy, které následně může roztáčet.
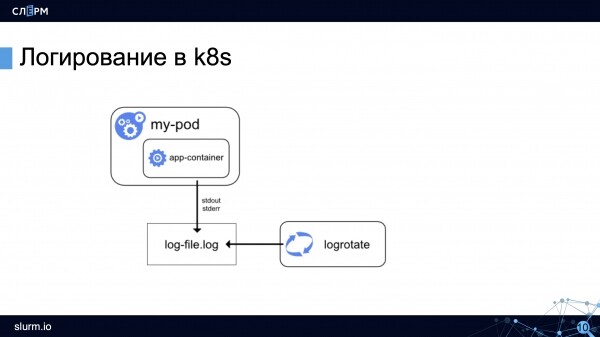
Pojďme se podívat na vlastnosti logování v Kubernetes.
Udržovat logy mezi nasazeními. To je povinný požadavek pro správné nastavení logování. Pokud se logy neuchovávají mezi nasazeními, při vydání nové verze aplikace budou logy té předchozí přepsány, restart kontejneru také může být spojeno se ztrátou logů. Kubernetes má klíč —previous, který umožňuje zobrazit logy aplikace před posledním restartem Pod, ale ne hlouběji.
Agregovat logy ze všech instancí. Pokud jsou mikroslužby hostovány v cloudech, za kontrolu systému je zodpovědný cloudový poskytovatel. Pokud jsou mikroslužby na vlastním hardwaru, kromě logů z kontejnerů je třeba shromažďovat i logy systému.
Dříve nebyly k dispozici pohodlné nástroje pro shromažďování logů jak ze systému, tak z mikroslužeb. Obvykle jeden nástroj shromažďoval systémové logy (například Rsyslog), druhý — logy z Dockeru (například journal-bit s nastavením log-drivre Docker na journald). Zkoušeli jsme používat journal-bit — shromažďovat logy i z kontejnerů (v log-drivre Docker uvést, že je potřeba zapisovat logy do journald), a i ze systému (v CentOS 7 již existuje systemd a journald). Řešení je funkční, ale ne ideální. Pokud je logů hodně, journal-bit začíná lagovat, zprávy se ztrácejí.
Experimenty pokračovaly — a našel se jiný způsob. V CentOS 7 se hlavní systémové logy (messages, audit, secure) duplikují do var-log ve formě souborů. V Dockeru také lze nastavit ukládání logů do souborů json. Odpovídajícím způsobem lze tyto soubory z CentOS 7 a Dockeru shromažďovat dohromady.
S postupem času se stalo populárním řešení ELK Stack. To je kombinace několika nástrojů: Elasticsearch, Logstash a Kibana.
Elasticsearch ukládá logy z kontejnerů, Logstash shromažďuje logy z instancí, Kibana umožňuje zpracovávat získané logy a vytvářet podle nich grafy. Nějakou dobu byl ELK Stack aktivně používán, ale podle mého názoru jeho doba končí. Později vysvětlím proč.
Přidávat metadataPody, aplikace a kontejnery mohou být spuštěny kdekoli. Navíc může mít jedna aplikace několik instancí. Logy jsou zaznamenány ve stejném formátu, ale musíme pochopit, která replika je to, který Pod to píše a v jakém namespace se nachází. Proto je nutné logům přidávat metadata.
ParselogůJe zajímavé, že náklady na podporu systému logování a monitorování mohou překročit výdaje na hlavní aplikaci. Když se vám generují desítky a stovky tisíc logů za sekundu, to se zdá být logické, ale přesto je třeba znát hranici. Jedním ze způsobů, jak tuto hranu najít, je parsování logů.
Obvykle není nutné shromažďovat a uchovávat všechny logy, měli bychom ukládat pouze část — například logy se stavem „warning“ nebo „error“. Pokud jde o logy nginx nebo ingress kontrolérů, lze ukládat jen ty, jejichž stav se liší od 200. Ale to není univerzální rada: pokud nějakým způsobem budujete analytiku podle logů Nginx, pak je samozřejmě stojí za to shromažďovat.
Nedoporučuje se bezmyšlenkovitě filtrovat logy, protože může být nedostatek odfiltrovaných dat pro normální analytiku. Na druhou stranu, možná bychom měli provádět analýzu nikoli na úrovni logování, ale na úrovni sběru metrik. Pak nebude nutné uchovávat stovky tisíc řádků s kódem 200. Jedním z přístupů je získat informace o provozu a chybách z metrik ingress kontrolérů.
Obecně byste se měli dobře zamyslet nad tím, co chcete uchovávat a jak dlouho, protože jinak může vzniknout situace, kdy systém logování bude odebírat více zdrojů, než hlavní projekt.
Zatím neexistuje standardní řešení pro logování. Na rozdíl od monitorování, kde je jedno nejrozšířenější řešení Prometheus, v logování neexistuje standard.
V rámci této přednášky se podíváme na dva nástroje: jeden populární a druhý – stále získávající na oblibě. Kromě nich existují i další, ale v tomto článku se jimi nebudeme zabývat.
S ohledem na všechny výše uvedené vlastnosti lze nyní logování v Kubernetes představit na následující schématu:
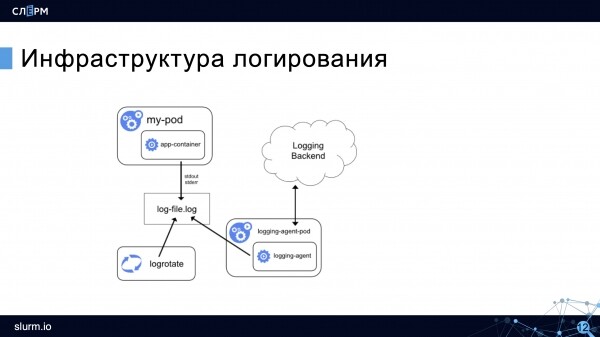
Zůstává log kontejneru, rotace, ale zjevně se objevuje agent-zbírače, který shromažďuje logy a odesílá je na úložiště (na schématu — do Logging Backend). Agent běží na každém uzlu a obvykle je spuštěn v Kubernetes.
Nyní se podíváme na nástroje pro logování.
Grafana Loki
se objevil nedávno, ale již si získal značnou popularitu. Jeho výhody: snadná instalace, nízká spotřeba zdrojů, nevyžaduje instalaci Elasticsearch, protože ukládá data v TSDB (databáze časových řad). V předchozím článku jsem psal, že takovou databázi používá Prometheus, a to je jedno z mnoha podobností obou produktů. Vývojáři dokonce tvrdí, že Loki je "Prometheus pro svět logování."
Malé odbočení k TSDB pro ty, kteří nečetli : TSDB skvěle zvládá úlohu uchovávání velkého množství dat, časových řad, ale není určena pro dlouhodobé uložení. Pokud z nějakého důvodu potřebujete uchovávat logy déle než dva týdny, je lepší nastavit jejich přenos do jiné databáze.
Další výhodou Loki je, že pro vizualizaci dat se používá Grafana. Velmi pohodlné: v Grafaně sledujeme data pro monitorování a tam také, připojením Loki, sledujeme logy. Podle logů lze vytvářet grafy.
Architektura Loki vypadá přibližně takto:
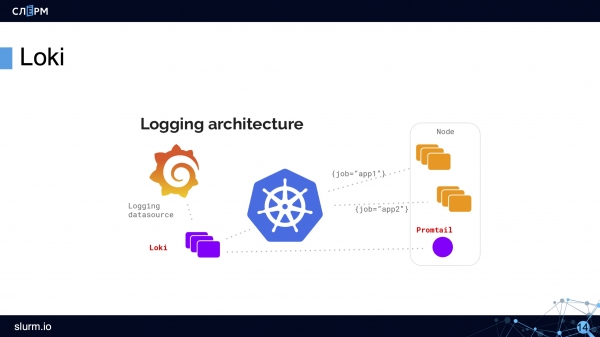
Pomocí DaemonSet se na všech serverech v clusteru nasazuje agent — Promtail nebo Fluent Bit. Agent sbírá logy. Loki je shromažďuje a uchovává ve své TSDB. K logům jsou hned přidány metadata, což je pohodlné: lze filtrovat podle Pods, namespaces, názvů kontejnerů a dokonce i štítků.
Loki funguje v známém rozhraní Grafana. Loki má dokonce svůj vlastní dotazovací jazyk, nazývá se LogQL — podle názvu a syntaxe připomíná PromQL v Prometheus. V rozhraní Loki jsou nápovědy s dotazy, takže není nutné je znát zpaměti.
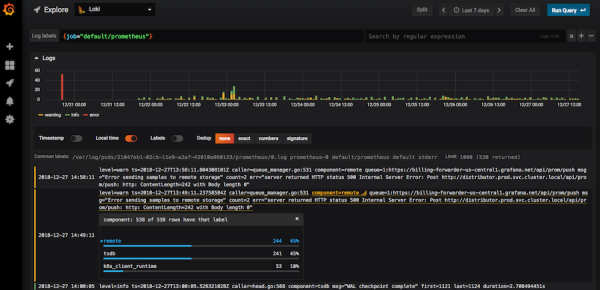
Loki v rozhraní Grafana
Pomocí filtrů můžete v Loki vyhledávat kódy ("400", "404" a jakékoli jiné); zobrazit logy z celé nody; filtrovat všechny logy, kde je slovo "error". Pokud kliknete na log, otevře se karta se všemi informacemi o události.
V Loki je dostatek nástrojů, které umožňují získat potřebné logy, ačkoliv upřímně řečeno, technicky jich mohlo být i více. Nyní se Loki aktivně vyvíjí a získává popularitu.
Elastic + Fluent Bit + Kibana (EFK Stack)
EFK stack je klasickým a zároveň velmi populárním nástrojem pro logování.
Na začátku článku bylo zmíněno ELK (Elasticsearch + Logstash + Kibana), ale tento stack zastaral kvůli ne příliš výkonnému a zároveň vysoce náročnému Logstashi. Místo něj se začal používat lehčí a výkonnější Fluentd, a po nějaké době mu přišel na pomoc — ještě lehčí a ještě výkonnější sběrač logů.
Pokud věříme vývojářům, Fluent Bit je více než 100krát výkonnější než Fluentd: "tam, kde Fluentd spotřebovává 20 MB RAM, Fluent Bit bude spotřebovávat 150 kB" — přímý citát z dokumentace. Díky tomu se Fluent Bit začal používat častěji.
Fluent Bit má méně funkcí než Fluentd, ale pokrývá základní potřeby, takže většinou používáme Fluent Bit.
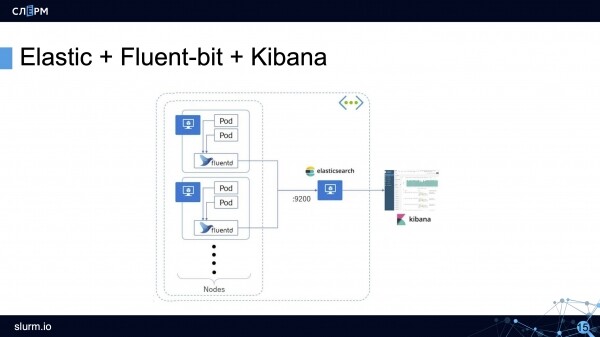
Schéma fungování stacku EFK: agent sbírá logy ze všech podů (obvykle to je DaemonSet spuštěný na všech serverech clusteru) a posílá je do úložiště (Elasticsearch, PostgreSQL nebo Kafka). Kibana se připojuje k úložišti a získává odtud všechny potřebné informace.
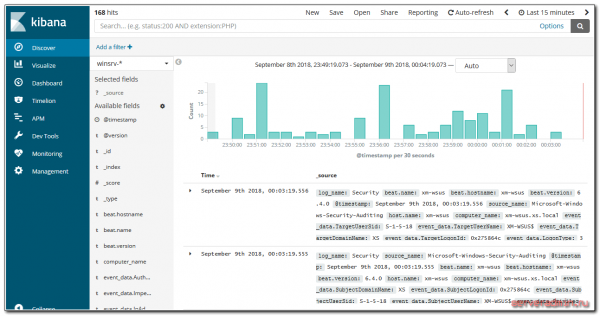
prezentuje informace v přehledném webovém rozhraní. Jsou tam grafy, filtry a mnohé další.
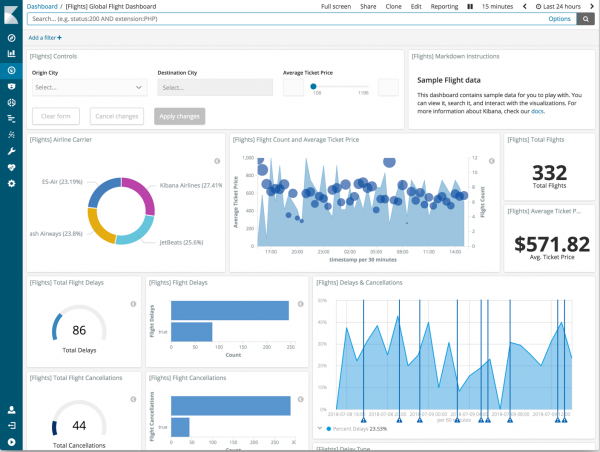
Z logů je možné vytvářet celé dashboardy.
Možnosti Fluent Bit
Jelikož o Fluent Bit se obvykle slyší méně než o Logstashi, podívejme se na něj trochu podrobněji. Fluent Bit můžeme logicky rozdělit na 6 modulů, na některé moduly je možné připojit pluginy, které rozšiřují možnosti Fluent Bit.
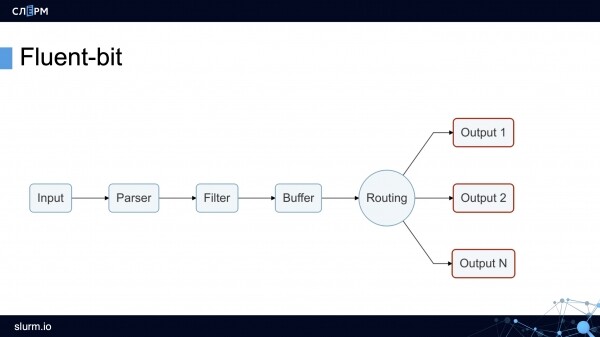
Modul Input sbírá logy z souborů, služeb systemd a dokonce i z tcp-socket (stačí zadat endpoint a Fluent Bit začne tam chodit). Těchto možností je dostatek k tomu, aby sbíral logy jak ze systému, tak z kontejnerů.
V produkci nejčastěji používáme pluginy (můžete ho nasměrovat na složku s logy) a (můžete mu říct, z jakých služeb sbírat logy).
Modul Parser přetváří logy do jednotného formátu. Ve výchozím nastavení logy Nginx jsou řetězcem. S pomocí pluginu lze tento řetězec přetvořit na JSON: nastavit pole a jejich hodnoty. S JSON se mnohem lépe pracuje než s textovými logy, protože nabízí flexibilnější možnosti třídění.
Modul Filter. Na této úrovni se odfiltrují nepotřebné logy. Například do úložiště se posílají pouze logy se stavem "warning" nebo s určitými štítky. Vyselektované logy se dostávají do vyrovnávací paměti.
Modul Buffer. Fluent Bit má dva typy vyrovnávacích pamětí: paměťovou a diskovou. Vyrovnávací paměť je dočasné úložiště logů, které je potřebné v případě chyb nebo selhání. Všichni chtějí šetřit na RAM, a proto se obvykle volí disková vyrovnávací paměť. Je však třeba mít na paměti, že před uložením na disk se logy stejně ukládají do paměti.
Modul Routing/Output obsahuje pravidla a adresy pro odesílání logů. Jak již bylo zmíněno, logy lze odesílat do Elasticsearch, PostgreSQL nebo například do Kafky.
Zajímavé je, že z Fluent Bit lze logy odesílat do Fluentd. Jelikož je první lehčí a méně funkční, lze přes něj sbírat logy a odesílat je do Fluentd, kde je možné je pomocí dalších pluginů dále zpracovávat a odesílat do úložišť.
Pokud plánujete používat Elasticsearch…
Na závěr dva tipy pro ty, kteří plánují používat Elasticsearch jako úložiště logů v produkčním prostředí.
- Nastavte upozornění pomocí . Tento program vyčleňuje z celkového toku logů důležité zprávy a vytváří na jejich základě upozornění do e-mailu nebo jiného kanálu. Bohužel, nedávno se objevila .
- Rotujte logy pomocí aplikace nebo voláním API Elasticsearch. Elastic v současnosti dělá významné kroky k řízení životního cyklu indexů bez použití externích nástrojů. Obecně není smysl uchovávat logy dlouho: málokterý log bude potřebný po dvou týdnech — pokud je opravdu kritický, za dva týdny bude určitě vyřešen. V krajním případě lze staré logy archivovat a odesílat někam na dlouhodobé uchování. Slyšel jsem o zvláštních logách, které je dle zákona třeba uchovávat až 5 let. Osobně jsem se s nimi nesetkal, ale takové informace bych neprovázel s běžnými logy a možná bych je dokonce uchovával odděleně.
Pokračování příště…
Autor: Marcel Ibrajev, certifikovaný administrátor Kubernetes, praktikující inženýr ve společnosti , řečník a tvůrce kurzů .
Zdroj: habr.com
