

TL;DR
- Aby se dosáhlo vysoké sledovatelnosti kontejnerů a mikroslužeb, samotné logy a primární metriky nestačí.
- Aby aplikace rychle zotavila a zvýšila svou odolnost, měly by uplatňovat Princip vysoké sledovatelnosti (HOP, High Observability Principle).
- Na úrovni aplikace je pro HOP potřeba: správné logování, pečlivé monitorování, kontroly dostupnosti a trasování výkonu/přechodů.
- Jako součást HOP použijte kontroly readinessProbe a livenessProbe Kubernetes.
Co je to Šablona kontroly dostupnosti?
Když navrhujete kriticky důležitou a vysoce dostupnou aplikaci, je velmi důležité zamyslet se nad aspektem, jako je odolnost. Aplikace se považuje za odolnou, pokud se rychle zotaví po selhání. Typická cloudová aplikace používá architekturu mikroslužeb – kdy každý komponent je umístěn v samostatném kontejneru. A abyste se ujistili, že aplikace na k8s je vysoce dostupná, je třeba při návrhu klastru dodržovat určité šablony. Mezi nimi je Šablona kontroly dostupnosti. Ta určuje, jak aplikace informuje k8s o své dostupnosti. Není to pouze informace o tom, zda pod funguje, ale také o tom, jak přijímá a odpovídá na požadavky. Čím více Kubernetes ví o dostupnosti podu, tím chytřejší rozhodnutí přijímá o směrování provozu a vyvažování zátěže. Tímto způsobem by Princip vysoké sledovatelnosti měl aplikaci včas odpovídat na požadavky.
Princip vysoké sledovatelnosti (HOP)
Princip vysoké sledovatelnosti je jedním z . V mikroslužbové architektuře není pro služby důležité, jak je jejich požadavek zpracován (a to je správně), ale jak získat odpovědi od přijímajících služeb. Například pro autentizaci uživatele jeden kontejner posílá jinému požadavek HTTP, očekávající odpověď v určitém formátu – a to je vše. Požadavek může zpracovat PythonJS a odpovědět – Python Flask. Kontajnery jsou pro sebe jako černé skříňky se skrytým obsahem. Nicméně princip NORA vyžaduje, aby každá služba odhalovala několik koncových bodů API, které ukazují, jak je funkční, stejně jako stav její připravenosti a odolnosti proti výpadkům. Tyto ukazatele vyžaduje Kubernetes, aby promýšlel další kroky v směrování a vyvažování zátěže.
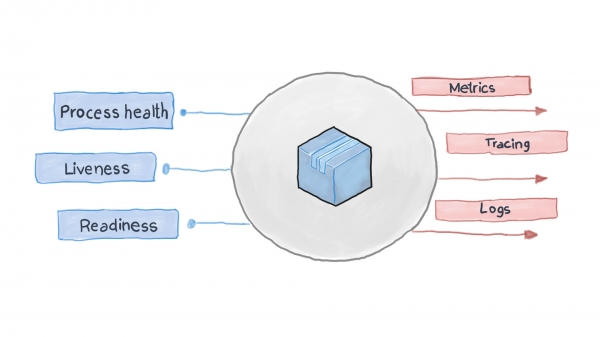
Správně navržená cloudová aplikace loguje své klíčové události pomocí standardních vstupních a výstupních proudů STDERR a STDOUT. Následně funguje pomocná služba, například Filebeat, Logstash nebo Fluentd, která doručuje logy do centralizovaného monitorovacího systému (například Prometheus) a systému sběru logů (skupina softwaru ELK). Na schématu níže je znázorněno, jak cloudová aplikace funguje v souladu se Šablonou kontroly dostupnosti a Principem vysoké observability.
Jak aplikovat Šablonu kontroly dostupnosti v Kubernetes?
Kubernetes z krabice monitoruje stav podů pomocí jednoho z kontrolérů (, , , a další). Jakmile zjistí, že pod z nějakého důvodu selhal, kontrolér se pokouší ho restartovat nebo přehodit na jiný uzel. Pod může však oznámit, že je spuštěn a funguje, ale ve skutečnosti nepracuje. Uveďme příklad: vaše aplikace používá jako webový server Apache, nainstalovali jste komponentu na několik podů v clusteru. Vzhledem k špatně nastavené knihovně – všechny požadavky na aplikaci odpovídají kódem 500 (vnitřní chyba serveru). Při kontrole dodávky kontrola stavu podů vykazuje úspěšný výsledek, zatímco klienti mají jiný názor. Tento nežádoucí stav popíšeme následujícím způsobem:
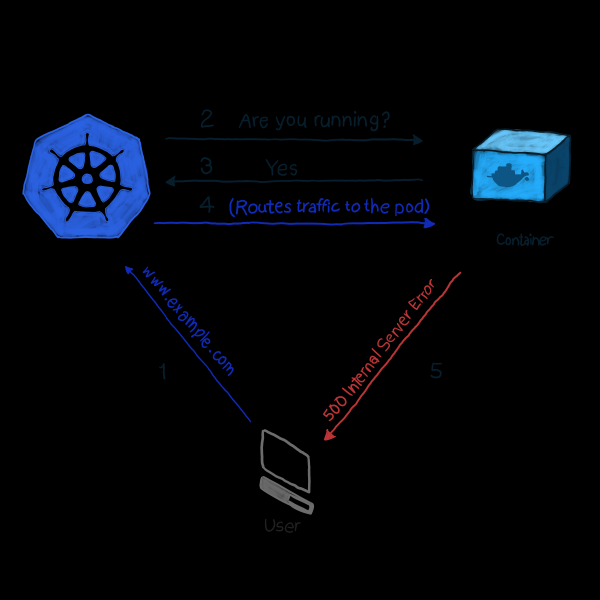
V našem příkladu Kubernetes vykonává kontrolu dostupnosti. V tomto typu kontroly kubelet neustále kontroluje stav procesu v kontejneru. Jakmile zjistí, že proces se zastavil, restartuje ho. Pokud je chyba odstraněna jednoduchým restartem aplikace a program je navržen tak, aby se při jakékoli chybě vypnul, pak k dodržení NORMY a Šablony kontroly dostupnosti stačí ověřit dostupnost procesu. Je škoda, že ne všechny chyby lze odstranit restartováním. Na tento případ k8s nabízí 2 hlubší způsoby odhalování problémů s prací podu: a .
LivenessProbe
Během livenessProbe kubelet provádí 3 typy kontrol: zjišťuje, zda pod běží, a zda je připraven přijímat a adekvátně reagovat na požadavky:
- Nastavit HTTP dotaz na pod. Odpověď by měla obsahovat HTTP kód odpovědi v rozmezí od 200 do 399. Takže kódy 5xx a 4xx signalizují, že u podu jsou problémy, i když proces běží.
- Pro kontrolu podů s ne-HTTP službami (například poštovní server Postfix) je třeba navázat TCP spojení.
- Provádění libovolného příkazu pro pod (interně). Ověření je považováno za úspěšné, pokud se návratový kód příkazu rovná 0.
Příklad toho, jak to funguje. Definice následujícího podu obsahuje NodeJS aplikaci, která na HTTP dotazy vrací chybu 500. Abychom se ujistili, že se kontejner restartuje, když dostane tuto chybu, používáme parametr livenessProbe:
apiVersion: v1
kind: Pod
metadata:
 name: node500
spec:
 containers:
   - image: magalix/node500
     name: node500
     ports:
       - containerPort: 3000
         protocol: TCP
     livenessProbe:
       httpGet:
         path: /
         port: 3000
       initialDelaySeconds: 5
To se nijak neliší od jakékoli jiné definice podu, ale přidáváme objekt .spec.containers.livenessProbe. Parametr httpGet přijímá cestu, na kterou posílá HTTP GET dotaz (v našem příkladu to je /, ale v produkčních scénářích může být i něco jako /api/v1/status). Dále livenessProbe přijímá parametr initialDelaySeconds, který pokynuje operacím kontroly čekat daný počet sekund. Zpoždění je nutné, protože kontejner potřebuje čas na spuštění, a při restartu bude nějakou dobu nedostupný.
Abychom tuto konfiguraci použili v klastru, použijte:
kubectl apply -f pod.yamlPo několika sekundách můžete zkontrolovat obsah podu pomocí následujícího příkazu:
kubectl describe pods node500Na konci výstupu najděte .
Jak vidíte, livenessProbe inicioval HTTP GET požadavek, kontejner vrátil chybu 500 (na co byl naprogramován), kubelet ho restartoval.
Pokud vás zajímá, jak bylo naprogramováno NideJS aplikace, zde jsou soubory app.js a Dockerfile, které byly použity:
app.js
var http = require('http');

var server = http.createServer(function(req, res) {
    res.writeHead(500, { "Content-type": "text/plain" });
    res.end("Narazili jsme na chybu\n");
});

server.listen(3000, function() {
    console.log('Server běží na 3000')
})
Dockerfile
FROM node
COPY app.js /
EXPOSE 3000
ENTRYPOINT [ "node","/app.js" ]
Je důležité si uvědomit toto: livenessProbe restartuje kontejner pouze při selhání. Pokud restart nevyřeší problém, který brání fungování kontejneru, kubelet nebude moci učinit žádné kroky k opravě závady.
readinessProbe
readinessProbe funguje podobně jako livenessProbes (GET požadavky, TCP spojení a provádění příkazů), s výjimkou opatření na odstranění závad. Kontejner, který je považován za selhávající, není restartován, ale je izolován od příchozího provozu. Představte si, že jeden z kontejnerů provádí mnoho výpočtů nebo je vystaven těžké zátěži, což zvyšuje dobu odezvy na požadavky. V případě livenessProbe dojde k prověrce dostupnosti odpovědi (na základě parametru timeoutSeconds), po čemž kubelet restartuje kontejner. Po restartu kontejner začne vykonávat náročné úkoly a je znovu restartován. To může být kritické pro aplikace, které vyžadují rychlou odezvu. Například auto na cestě čeká na odpověď ze serveru, odpověď se zpožďuje – a auto havaruje.
Pojďme napsat definici readinessProbe, která nastaví dobu odezvy na GET požadavek na maximálně dvě sekundy, zatímco aplikace bude na GET požadavek odpovídat za 5 sekund. Soubor pod.yaml by měl vypadat takto:
apiVersion: v1
kind: Pod
metadata:
 name: nodedelayed
spec:
 containers:
   - image: afakharany/node_delayed
     name: nodedelayed
     ports:
       - containerPort: 3000
         protocol: TCP
     readinessProbe:
       httpGet:
         path: /
         port: 3000
       timeoutSeconds: 2
Nasadíme pod pomocí kubectl:
kubectl apply -f pod.yamlPočkáme pár sekund a pak se podíváme, jak proběhla readinessProbe:
kubectl describe pods nodedelayedNa konci výstupu můžete vidět, že část událostí je podobná .
Jak vidíte, kubectl nezrestartoval pod, když doba kontroly překročila 2 sekundy. Místo toho požadavek zrušil. Příchozí spojení jsou směrována na jiné, funkční pod.
Všimněte si, že nyní, když byla z podu odstraněna nadbytečná zátěž, kubectl opět směruje požadavky na něj: odpovědi na GET požadavky se již nezdržují.
Pro srovnání: níže je uveden upravený soubor app.js:
var http = require('http');

var server = http.createServer(function(req, res) {
   const sleep = (milliseconds) => {
       return new Promise(resolve => setTimeout(resolve, milliseconds))
   }
   sleep(5000).then(() => {
       res.writeHead(200, { "Content-type": "text/plain" });
       res.end("Hellon");
   })
});

server.listen(3000, function() {
   console.log('Server běží na 3000')
})
TL;DR
Před vznikem cloudových aplikací byly hlavními nástroji pro monitoring a kontrolu stavu aplikací logy. Nicméně neexistovaly prostředky pro provádění opatření k odstranění problémů. Logy jsou i dnes užitečné, je třeba je shromažďovat a zasílat do systému shromažďování logů pro analýzu incidentů a rozhodování. [to vše bylo možné dělat i bez cloudových aplikací pomocí monit, například, ale s k8s je to mnohem jednodušší 🙂 – pozn. red. ]
Dnes je však třeba opravy provádět téměř v reálném čase, takže aplikace už nemusí být černé boxy. Ne, měly by ukazovat koncové body, které umožňují monitorovacím systémům požadovat a shromažďovat cenná data o stavu procesů, aby v případě potřeby mohly okamžitě reagovat. To se nazývá návrhový vzor pro kontrolu stavu, který následuje princip vysoké pozorovatelnosti (SLO).
Kubernetes standardně nabízí 2 typy kontrol stavu: readinessProbe a livenessProbe. Oba používají stejné typy kontrol (HTTP GET požadavky, TCP spojení a provádění příkazů). Rozdíly spočívají v tom, jaká rozhodnutí se přijímají v reakci na problémy v podech. livenessProbe restartuje kontejner v naději, že chyba se už neopakuje, zatímco readinessProbe izoluje pod od příchozího provozu – dokud není problém odstraněn.
Správný návrh aplikace by měl zahrnovat oba typy kontrol a sbírat dostatek dat, zvlášť když nastane mimořádná situace. Měl by také ukazovat potřebné API koncové body, které předávají monitorovacímu systému (např. Prometheus) důležité metriky stavu operability.
Zdroj: habr.com
