

Pokud jste jako většina lidí, pravděpodobně používáte zdroje fungující mimo svůj klastr. Možná používáte API Taleo k odesílání textových zpráv nebo analyzujete obrázky pomocí API Google Cloud Vision.
Pokud používáte stejný endpoint — bod příjmu požadavků na straně serveru ve všech svých prostředích a neplánujete přesunout své servery do Kubernetes, je zcela normální mít endpoint služby přímo ve svém kódu. Existuje však mnoho dalších scénářů. V této sérii „Kubernetes Best Practices“ se dozvíte, jak využívat vestavěné mechanismy Kubernetes pro objevování služeb jak uvnitř, tak vně klastru.
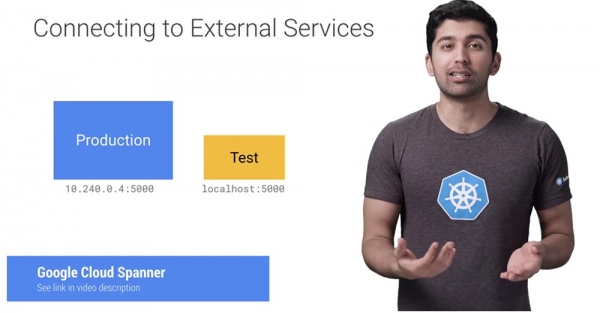
Jako příklad široce rozšířené externí služby lze uvést databázi, která funguje mimo klastr Kubernetes. Na rozdíl od cloudových databází, jako jsou Google Cloud Data Store nebo Google Cloud Spanner, které používají jeden endpoint pro všechny typy přístupu, většina databází má samostatné endpointy pro různé situace.
Nejlepší praxí při používání tradičních databází, jako jsou MySQL a MongoDB, obvykle je, že se připojujete k různým komponentám pro různé prostředí. Můžete mít silnější stroj pro produkční data a menší stroj pro testovací prostředí. Každý z nich bude mít svou vlastní IP adresu nebo doménové jméno, ale určitě nebudete chtít měnit svůj kód při přechodu z jednoho prostředí do druhého. Proto namísto tvrdého kódování těchto adres můžete využít vestavěné služby Kubernetes pro objevování externích služeb založené na DNS, stejně jako pro nativní služby Kubernetes.
Předpokládejme, že spouštíte databázi MongoDB na Google Compute Engine. Zůstanete v tomto hybridním světě, dokud ji nebudete moci přesunout do klastru.
Naštěstí můžete použít statické služby Kubernetes, abyste si alespoň trochu ulehčili život. V tomto příkladu jsem vytvořil server MongoDB pomocí Google Cloud Launcher. Protože je vytvořen ve stejné síti (nebo VPC klastru Kubernetes), je k němu přístup přes vysoce výkonnou interní IP adresu.
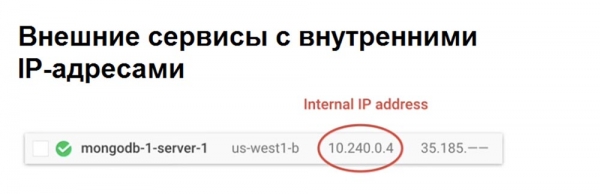
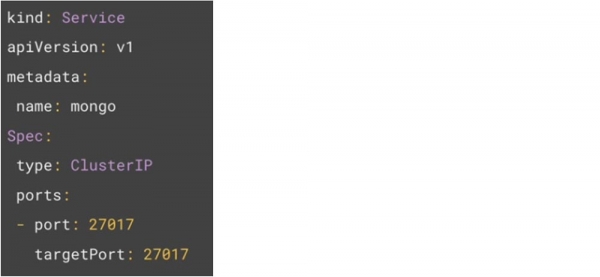
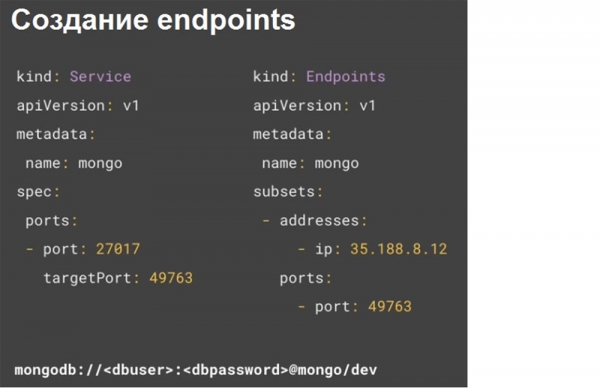
V Google Cloud je toto výchozí nastavení, takže nic nemusíte upravovat. Nyní, když je zde IP adresa, prvním krokem je vytvoření služby. Můžete si všimnout, že pro tuto službu neexistují žádné podové selektory. To znamená, že jsme vytvořili službu, která nebude vědět, kam odesílat provoz. To umožní manuálně vytvořit objekt endpoint, který bude přijímat provoz z této služby.
Následující příklad kódu ukazuje, že koncové body určují IP adresu pro databázi, používající stejné jméno mongo, jako služba.
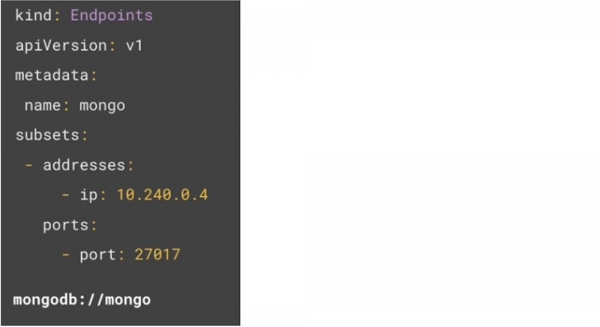
Kubernetes použije všechny IP adresy, aby našel koncové body, jako by to byly běžné podové aplikace Kubernetes, takže nyní můžete přistupovat k databázi pomocí jednoduchého připojovacího řetězce k výše zmíněnému jménu mongodb://mongo. Není vůbec potřeba používat IP adresy ve vašem kódu.
Pokud se v budoucnu IP adresy změní, můžete jednoduše aktualizovat koncové body pomocí nové IP adresy, a vaše aplikace nebude potřeba měnit žádným dalším způsobem.
Pokud používáte databázi hostovanou na externím hostu, pravděpodobně vám vlastníci hostingu poskytli pro připojení jednotný identifikátor prostředku URI. Pokud vám byla poskytnuta IP adresa, můžete jednoduše využít předchozí metodu. Tento příklad ukazuje, že mám dvě databáze MongoDB hostované na hostiteli mLab.
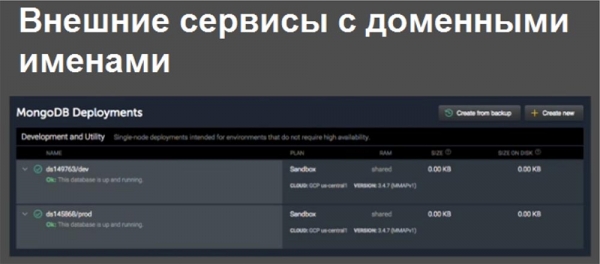
Jedna z nich je databáze pro vývojáře a druhá je produkční databáze. Připojovací řetězce pro tyto databáze vypadají následovně — mLab vám poskytuje dynamické URI a dynamický port. Jak vidíte, jsou odlišné.
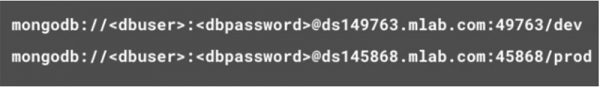
Abychom se od toho abstrahovali, použijeme Kubernetes a připojíme se k databázi pro vývojáře. Můžete vytvořit externí jméno Kubernetes služby, což vám poskytne statickou službu, která přesměruje provoz na externí službu.
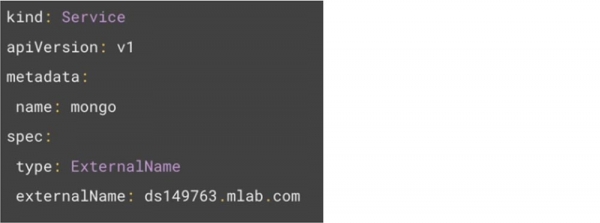
Tato služba provede jednoduché CNAME přesměrování na úrovni jádra, což má minimální vliv na výkonnost. Díky tomu můžete použít jednodušší připojovací řetězec.

Ale protože externí název používá přesměrování CNAME, nemůže provést přesměrování portů. Toto řešení je tedy použitelné pouze pro statické porty a nemůže být použito s dynamickými porty. Bezplatná úroveň mLab Free Tier však standardně poskytuje uživateli dynamické číslo portu, které nemůžete změnit. To znamená, že pro dev a prod potřebujete různé příkazové řádky pro připojení. Špatné je, že k tomu bude potřeba tvrdě zakódovat číslo portu. Jak tedy dosáhnout funkčního přesměrování portů?
Prvním krokem je získání IP adresy z URI. Pokud spustíte příkaz nslookup, hostname nebo pingujete URI, můžete získat IP adresu databáze. Pokud služba vrátí více IP adres, všechny tyto adresy lze použít v koncových bodech objektu.
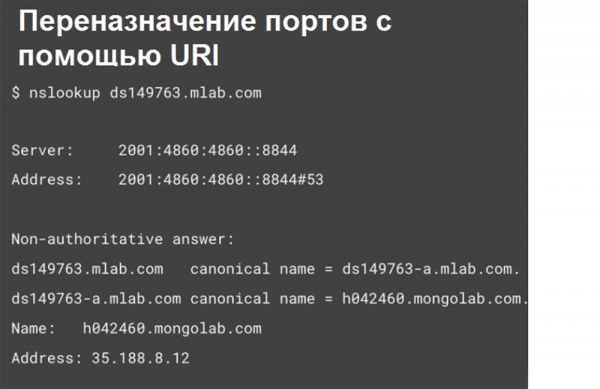
Je třeba mít na paměti, že IP adresy URI se mohou měnit bez předchozího upozornění, a proto je jejich použití v produci poměrně riskantní. Pomocí takové IP adresy se můžete připojit k vzdálené databázi, aniž byste museli uvádět port. Služba Kubernetes tedy velmi transparentně provádí přesměrování portů.
Mapping, neboli mapování externích zdrojů na interní, vám dává možnost flexibilně používat tyto služby uvnitř clustera v budoucnu při minimalizaci námahy při refaktoringu. Usnadňuje to také správu a poskytuje pochopení toho, jaké externí služby vaše společnost využívá.
Pokračování bude brzy…
Malá reklama 🙂
Děkujeme, že s námi zůstáváte. Líbí se vám naše články? Chcete vidět více zajímavých materiálů? Podpořte nás objednávkou nebo doporučením známým, , unikátní alternativa entry-level serverů, kterou jsme pro vás vymysleli: (k dispozici varianty s RAID1 a RAID10, až 24 jader a až 40GB DDR4).
Dell R730xd je dvakrát levnější v datovém centru Equinix Tier IV v Amsterdamu? Jen u nás v Nizozemsku! Dell R420 — 2x E5-2430 2.2GHz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — od 99 $! Čtěte o tom
Zdroj: habr.com
