

Ahoj, Habr! Zveme datové inženýry a specialisty na strojové učení na bezplatnou ukázkovou lekci . A také publikujeme článek od Lucy Monno – vedoucí finanční analýzy ve CDP SpA.
Jednou z nejvíce užitečných a nejjednodušších metod strojového učení je Ensemble Learning. Ensemble Learning je metoda, která leží v základech XGBoost, Baggingu, Random Forestu a mnoha dalších algoritmů.
Na Towards Data Science je spousta skvělých článků, ale vybral jsem si dvě historie ( a ), které se mi nejvíce líbily. Tak proč psát další článek o EL? Protože vám chci ukázat, jak to funguje na jednoduchém příkladu, který mi dal pochopit, že tady není žádná magie.
Když jsem poprvé viděl EL v akci (při práci s několika velmi jednoduchými regresními modely), nemohl jsem uvěřit vlastním očím, a dodnes si vzpomínám na profesora, který mě tento method učil.
Měl jsem dva různé modely (dva slabé učící algoritmy) s hodnotami out-of-sample R² 0,90 a 0,93. Před tím, než jsem se podíval na výsledek, jsem si myslel, že dostanu R² někde mezi dvěma původními hodnotami. Jinými slovy, myslel jsem si, že EL mohu použít k tomu, aby model nefungoval hůř než nejhorší, ale ani ne tak dobře, jak by mohl fungovat nejlepší model.
K mému největšímu překvapení, výsledky jednoduchého průměrování předpovědí daly R² 0,95.
Nejdříve jsem začal hledat chybu, ale pak jsem si pomyslel, že se tu může skrývat nějaká magie!
Co je to Ensemble Learning
S pomocí EL můžeme spojit předpovědi dvou a více modelů k získání spolehlivějšího a výkonnějšího modelu. Existuje mnoho metodologií pro práci s ensemble modely. Zde se dotknu dvou nejužitečnějších, abych dal obecnou představu.
Pomocí regrese lze průměrovat výsledky existujících modelů.
Pomocí klasifikace mohou nechat modely vybrat štítky. Štítek, který byl vybrán nejčastěji – ten bude zvolen novým modelem.
Proč EL funguje lépe
Hlavní důvod, proč EL funguje lépe, spočívá v tom, že každá predikce má chybu (což víme z teorie pravděpodobnosti), kombinace dvou predikcí může pomoci snížit chybu a tím pádem zlepšit výkon (RMSE, R² atd.).
Na následujícím grafu je vidět, jak dva slabé algoritmy pracují s datovým souborem. První algoritmus má větší sklon, než je potřeba, zatímco druhý má téměř nulový (možná kvůli nadměrné regularizaci). Ale ensemble ukazuje mnohem lepší výsledek.
Pokud se podíváte na hodnotu R², první a druhý tréninkový algoritmus budou mít hodnoty -0,01¹, 0,22, zatímco ensemble bude mít hodnotu 0,73.
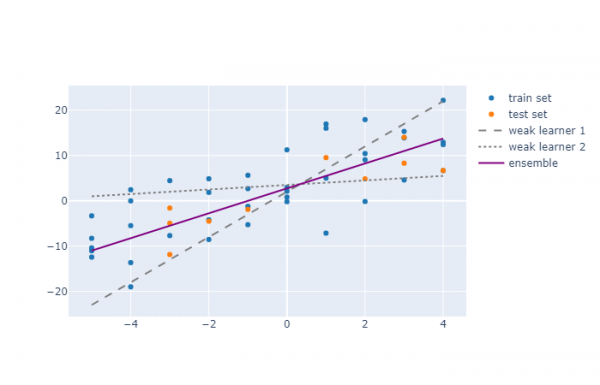
Existuje mnoho důvodů, proč algoritmus může být špatným modelem, i na takovém základním příkladu, jako je tento: možná jste se rozhodli použít regularizaci, abyste se vyhnuli přeškolení, nebo jste se rozhodli nezahrnout některé anomálie, nebo jste možná použili polynomickou regresi a vybrali špatný stupeň (například použili polynom druhého stupně, zatímco na testovacích datech je zřejmá asymetrie, pro kterou by lépe vyhovoval třetí stupeň).
Když EL funguje lépe
Podívejme se na dva tréninkové algoritmy, které pracují se stejnými daty.
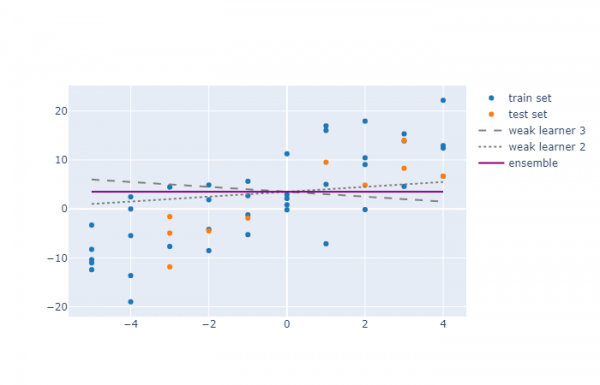
Ukazuje se, že kombinace dvou modelů nezlepšila výkon výrazně. Původně měly dva tréninkové algoritmy hodnoty R² -0,37 a 0,22, zatímco ensemble měl -0,04. To znamená, že model EL získal průměrný výkon.
Mezi těmito dvěma příklady však existuje velký rozdíl: v prvním příkladu byly chyby modelů negativně korelované, zatímco ve druhém pozitivně (koeficienty tří modelů nebyly hodnoceny, ale byly autorovi vybrány jako příklad).
Proto může být Ensemble Learning použit ke zlepšení vyváženosti zaujatosti/rozptýlení v jakýchkoli případech, ale když jsou chyby modelů pozitivně nekorelované, použití EL může vést ke zvýšení výkonu..
Homogenní a heterogenní modely
Ensemble Learning (EL) se často používá na homogenních modelech (jako v tomto příkladu nebo v rámci náhodného lesa), ale ve skutečnosti můžete kombinovat různé modely (lineární regrese + neuronová síť + XGBoost) s různými sadami vysvětlujících proměnných. To pravděpodobně povede k nekorelovaným chybám a zvýšení výkonnosti.
Srovnání s diverzifikací portfolia
EL funguje analogicky k diverzifikaci v teorii portfolia, ale je to pro nás tím lepší.
Při diverzifikaci se snažíte snížit rozptyl vašich ukazatelů investováním do nekorelovaných akcií. Dobře diversifikované portfolio akcií by mělo dosahovat lepších výsledků než nejhorší jednotlivá akcie, ale nikdy ne lepších než nejlepší.
Cituji Warrena Buffetta:
„Diverzifikace je ochrana před neznalostí, pro toho, kdo neví, co dělá, nemá [diverzifikace] moc smysl.“
V strojovém učení EL pomáhá snížit rozptyl vašeho modelu, což může vést k vytvoření modelu s celkovou výkonností lepší než nejlepší původní model.
Shrnujeme
Kombinace několika modelů do jednoho je relativně jednoduchá metoda, která může pomoci vyřešit problém bias-variance a zvýšit výkonnost.
Pokud máte dvě nebo více modelů, které dobře fungují, nevybírejte mezi nimi: použijte je všechny (ale s opatrností)!
Zajímá vás rozvoj v tomto směru? Přihlaste se na bezplatnou demo lekci a zúčastněte se — Machine Learning Engineer ve Mail.ru Group.
Zdroj: habr.com
