

Klasifikace dat na základě obsahu je otevřený úkol. Tradiční systémy prevence ztráty dat (DLP) tuto situaci řeší pomocí snímání otisků příslušných dat a monitorování koncových bodů za účelem jejich zachycení. Vzhledem k velkému množství neustále se měnících datových zdrojů na Facebooku není tento přístup nejen škálovatelný, ale ani efektivní pro určení toho, kde se data nacházejí. Tento článek se zaměřuje na systém s end-to-end, který je navržen pro detekci citlivých sémantických typů na Facebooku v měřítku a automatickou zajištění ukládání dat a kontroly přístupu.
Popsaný přístup je náš první end-to-end systém ochrany soukromí, který se snaží vyřešit tento problém zahrnutím datových signálů, strojového učení a tradičních metod snímání otisků k zobrazení a klasifikaci všech dat na Facebooku. Popsaný systém je nasazen v produkčním prostředí, dosahuje průměrného skóre F2 0,9+ napříč různými třídami soukromí při zpracování velkého množství datových zdrojů ve desítkách úložišť. Představujeme překlad publikace Facebooku na ArXiv o škálovatelné klasifikaci dat pro zajištění bezpečnosti a soukromí založené na strojovém učení.
Úvod
Dnes organizace shromažďují a ukládají velké objemy dat v různých formátech a na různých místech [1], přičemž data jsou konzumována na mnoha místech, někdy zkopírována nebo dočasně uložena několikrát, což vede k tomu, že cenné a důvěrné obchodní informace jsou rozptýleny po mnoha firemních datových skladech. Když se od organizace vyžaduje splnění určitých právních nebo regulačních požadavků, například dodržování předpisů během občanského soudního řízení, vzniká potřeba shromáždění dat o umístění požadovaných informací. Když v nařízení o ochraně soukromí stojí, že organizace musí zamaskovat všechna čísla sociálního zabezpečení (SSN) při předávání osobních informací neautorizovaným subjektům, prvním přirozeným krokem je vyhledání všech SSN ve všech datových skladech organizace. V takových okolnostech se klasifikace dat stává zásadní [1]. Klasifikační systém umožní organizacím automaticky zajistit dodržování ochrany soukromí a bezpečnostních politik, jako je zavedení politiky správy přístupu a uchovávání dat. Facebook představuje systém, který jsme vyvinuli v Facebooku, jenž využívá řadu datových signálů, škálovatelné systémové architektury a strojového učení pro detekci citlivých významových typů dat.
Detekce a klasifikace dat znamená jejich hledání a označování tak, aby bylo možné při potřebě rychle a efektivně extrahovat odpovídající informace. Současný proces má spíše manuální charakter a spočívá ve studiu příslušných zákonů nebo předpisů, určení, jaké typy informací by měly být považovány za citlivé a jaké jsou různé úrovně citlivosti, a poté v odpovídajícím vybudování tříd a klasifikační politiky [1]. Po systémech ochrany před ztrátou dat (DLP) se snímají otisky dat a sledují se koncové body downstream pro získání otisků. Při práci s úložištěm s velkým množstvím aktiv a petabajty dat takový přístup jednoduše není škálovatelný.
Naším cílem je vybudovat systém klasifikace dat, který se škáluje jak pro stabilní, tak pro nestabilní uživatelská data, bez jakýchkoliv dalších omezení na typ nebo formát dat. Je to odvážný cíl a samozřejmě s sebou nese potíže. Jakýkoliv záznam dat může mít délku v řádu tisíců znaků.
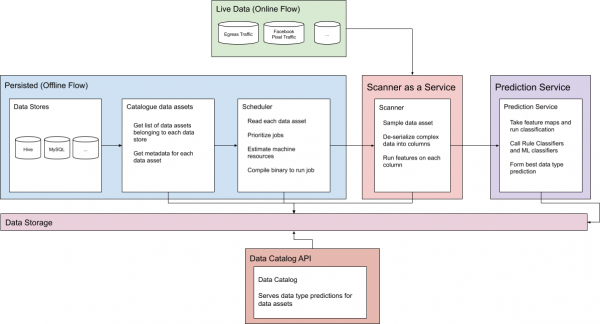
Obrázek 1. Proudění online a offline předpovědí
Proto musíme efektivně reprezentovat tuto klasifikaci pomocí obecné sady znaků, které mohou být následně sloučeny a snadno přesunuty. Tyto znaky by měly nejen zajišťovat přesnou klasifikaci, ale také poskytovat flexibilitu a rozšiřitelnost pro snadné přidávání a objevování nových typů dat v budoucnu. Za druhé, musíme řešit velké samostatné tabulky. Stabilní data mohou být uložena v tabulkách o velikosti mnoha petabajtů. To může vést k poklesu rychlosti skenování. Za třetí, musíme dodržovat přísnou klasifikaci SLA pro nestabilní data. To vyžaduje, aby byl systém vysoce efektivní, rychlý a přesný. Nakonec musíme zajistit klasifikaci dat s nízkou latencí pro nestabilní data, abychom mohli klasifikaci provádět v reálném čase, stejně jako pro případy použití na internetu.
Tento článek popisuje, jak jsme čelili výše uvedeným problémům, a představuje rychlý a škálovatelný systém klasifikace, který klasifikuje prvky dat všech typů, formátů a zdrojů na základě společné sady znaků. Rozšířili jsme systémovou architekturu a vytvořili speciální model strojového učení pro rychlou klasifikaci offline a online dat. Tento článek je uspořádán následujícím způsobem: v sekci 2 je představen obecný design systému. V sekci 3 se diskuse zaměřuje na části systému strojového učení. V sekcích 4 a 5 se hovoří o související práci a naznačuje budoucí směrování.
Architektura
Abychom se vypořádali s problémy stabilních a online dat na škále Facebooku, má klasifikační systém dva samostatné proudy, o kterých se podrobněji zmíníme.
Stabilní data
Původně musí systém zjistit o mnoha informačních aktivech na Facebooku. Pro každý datový sklad se shromažďují určité základní informace, jako je datové centrum, které obsahuje tato data, systém s těmito daty a aktiva umístěná ve konkrétním datovém skladu. To vytváří katalog metadat, který umožňuje systému efektivně extrahovat data bez přetížení klientů a zdrojů, které používají jiní inženýři.
Tento katalog metadat poskytuje spolehlivý zdroj pro všechna skenovaná aktiva a umožňuje sledovat stav různých aktiv. S pomocí těchto informací se stanovuje priorita plánování na základě shromážděných dat a interních informací ze systému, jako je čas posledního úspěšného skenování aktiva a čas jeho vytvoření, stejně jako předchozí požadavky na paměť a procesor pro toto aktivum, pokud bylo skenováno dříve. Poté se pro každý datový zdroj (jakmile jsou zdroje k dispozici) aktivuje úloha pro skutečné skenování zdroje.
Každá úloha je zkompilovaný binární soubor, který provádí Bernoulliho vzorkování podle posledních dat dostupných pro každé aktivum. Aktivum je rozděleno na jednotlivé sloupce, kde je výsledek klasifikace každého sloupce zpracován nezávisle. Kromě toho systém skenuje jakákoliv saturace dat uvnitř sloupců. JSON, pole, zakódované struktury, URL adresy, serializovaná data base 64 a mnohé další - to vše je skenováno. To může významně zvýšit dobu trvání skenování, protože jedna tabulka může obsahovat tisíce vnořených sloupců ve velkém binárním objektu. json.
Pro každý řádek, který je vybrán v aktivu dat, systém klasifikace extrahuje plovoucí a textové objekty z obsahu a přiřazuje každý objekt zpět ke sloupci, ze kterého byl vzat. Výsledkem fáze extrakce objektů je mapa všech objektů pro každý nalezený sloupec v aktivu dat.
Jaké jsou účely atributů?
Pojem znaků je klíčovým momentem. Místo znaků float a text můžeme předávat nezkreslené vzorky řetězců, které jsou přímo extrahovány z každého zdroje dat. Kromě toho se modely strojového učení mohou učit přímo na každém vzorku, nikoli na stovkách výpočtů znaků, které se snaží vzorek přiblížit. Existuje k tomu několik důvodů:
- Ochrana soukromí především: nejdůležitější je, že pojem znaků nám umožňuje uchovávat v paměti pouze ty vzorky, které extrahujeme. To zajišťuje, že uchováváme vzorky pouze pro jediný účel a nikdy je naše vlastní úsilí neprotokoluje. To je zvláště důležité pro nestálá data, protože služba musí udržovat určité zařazení před tím, než poskytne předpověď.
- Paměť: některé vzorky mohou mít délku tisíců znaků. Ukládání takových dat a jejich přenos částmi systému bez nutnosti spotřebovává mnoho dalších bajtů. Dva faktory se mohou s časem spojit, vzhledem k tomu, že existuje mnoho zdrojů dat s tisíci sloupci.
- Agregace znaků: pomocí znaků se prostřednictvím jejich souboru jasně reprezentují výsledky každého skenování, což systému umožňuje spojit výsledky předchozích skenování stejného zdroje dat pohodlným způsobem. To může být užitečné pro agregaci výsledků skenování jednoho zdroje dat v několika bězích.
Pak jsou znaky odeslány do služby prognózování, kde používáme klasifikaci na základě pravidel a strojové učení k předpovědi štítků dat každého sloupce. Služba se opírá jak o pravidlové klasifikátory, tak o strojové učení a vybírá nejlepší prognózu, kterou dostane z každého předpovědního objektu.
Pravidlové klasifikátory jsou ručně nastavené heuristiky, používají výpočty a koeficienty k normalizaci objektu v rozmezí od 0 do 100. Jakmile je takový počáteční bod vygenerován pro každý typ dat a název sloupce s těmito daty, který nespadá do žádných "blokovacích seznamů", pravidlový klasifikátor vybere nejvyšší normalizovanou hodnotu mezi všemi typy dat.
Vzhledem ke složitosti klasifikace používání výhradně ruční heuristiky vede k nízké přesnosti klasifikace, zejména pro nestrukturovaná data. Z tohoto důvodu jsme vyvinuli systém strojového učení pro práci s klasifikací nestrukturovaných dat, jako je uživatelský obsah a adresa. Strojové učení nám umožnilo začít se odklánět od ruční heuristiky a aplikovat další datové signály (například názvy sloupců, původ dat), což významně zvyšuje přesnost detekce. Do naší architektury strojového učení se podíváme podrobněji později.
Služba predikce uchovává výsledky pro každý sloupec spolu s metadaty týkajícími se času a stavu skenování. Jakýkoli spotřebitel a podřízené procesy, které na těchto datech závisí, je mohou číst z denně publikovaného datového souboru. Tento soubor agreguje výsledky všech těchto úloh skenování, nebo API pro real-time katalog dat. Publikované predikce jsou základem automatického uplatňování politiky ochrany soukromí a bezpečnosti.
Nakonec, poté co služba predikce zaznamená všechna data a všechny predikce jsou uloženy, naše API katalogu dat může vracet všechny predikce typů dat pro zdroj v reálném čase. Každý den systém publikuje datový soubor obsahující všechny nejnovější predikce pro každý aktiv.
Nestabilní data
I když byl výše popsaný proces navržen pro uložená aktiva, nestabilní provoz se také považuje za součást dat organizace a může být důležitý. Z tohoto důvodu systém poskytuje online API pro generování predikcí klasifikace v reálném čase pro jakýkoli nestabilní provoz. Systém predikce v reálném čase je široce používán při klasifikaci odchozího a příchozího provozu v modelech strojového učení a datech inzerentů.
Zde API přijímá dva hlavní argumenty: klíč skupiny a neopracovaná data, která mají být předpovězena. Služba provádí stejné extrakce objektů, jak bylo popsáno výše, a sdružuje objekty dohromady podle stejného klíče. Tyto znaky jsou také uloženy v cache pro obnovu po selhání. Každému klíči skupiny služba zajišťuje, že před voláním předpovědní služby viděla dostatek vzorků podle procesu popsaného výše.
Optimalizace
Pro skenování některých úložišť používáme knihovny a metody optimalizace čtení z horkého úložiště [2] a zajišťujeme, že nedochází k žádným selháním ze strany ostatních uživatelů přistupujících ke stejnému úložišti.
Pro extrémně velké tabulky (50+ petabajtů), navzdory všem optimalizacím a efektivitě paměti, systém pracuje na skenování a výpočtu všeho, než dojde paměť. Nakonec se skenování zcela provádí v paměti a není uchováváno během skenování. Pokud velké tabulky obsahují tisíce sloupců s neorganizovanými shluky dat, úkol může selhat kvůli nedostatku paměťových zdrojů při provádění předpovědí pro celou tabulku. To povede k poklesu pokrytí. Abychom se s tím vypořádali, optimalizovali jsme systém, aby využíval rychlost skenování jako prostředníka pro to, jak dobře si systém vede při současném zatížení. Rychlost používáme jako prognostický mechanismus, abychom viděli problémy s pamětí a při preventivním výpočtu mapy objektů. Přitom používáme méně dat, než obvykle.
Signály dat
Systém klasifikace je dobrý tak, jak dobré jsou signály od dat. Zde prozkoumáme všechny signály používané systémem klasifikace.
- Na základě obsahu: samozřejmě, první a nejdůležitější signál — to je obsah. Probíhá Bernoulliho výběr pro každé aktivum dat, které skenujeme a extrahujeme rysy podle obsahu dat. Mnoho rysů pochází z obsahu. Může existovat libovolné množství plovoucích objektů, které představují výpočty, kolikrát byl určitý typ vzorku pozorován. Například můžeme mít rys počtu e-mailů, které byly v rámci výběru viděny, nebo informace o tom, kolik emotikonů bylo v rámci výběru zaznamenáno. Tyto výpočty rysů lze normalizovat a agregovat podle různých skenování.
- Původ dat: důležitý signál, který může pomoci, když se obsah změnil z rodičovské tabulky. Běžným příkladem jsou hashované údaje. Když jsou data v dceřiné tabulce hashována, často pocházejí z rodičovské tabulky, kde zůstávají v otevřené podobě. Údaje o původu pomáhají klasifikovat určité typy dat, když jsou špatně čitelná nebo převedena z tabulky výše po toku.
- Anotace: další signál vysoké kvality, který pomáhá při identifikaci nestrukturovaných dat. Vlastně mohou anotace a údaje o původu spolupracovat na šíření atributů mezi různými datovými aktivy. Anotace pomáhají identifikovat zdroj nestrukturovaných dat, zatímco údaje o původu mohou pomoci sledovat tok těchto dat v celém úložišti.
- Vkládání dat je metoda, při které jsou záměrně zaváděny speciální, nečitelné znaky do známých zdrojů se známými typy dat. Pak, kdykoli skenujeme obsah se stejnou nečitelnou sekvencí znaků, můžeme usoudit, že obsah pochází z tohoto známého typu dat. Je to další kvalitní signál dat, podobně jako anotace. S výjimkou toho, že detekce na základě obsahu pomáhá odhalit vložená data.
Měření metrik
Důležitou složkou je přísná metodologie měření metrik. Základními metrikami iterace zlepšení klasifikace jsou přesnost a odvolání každé nálepky, přičemž hodnocení F2 je nejdůležitější.
Pro výpočet těchto ukazatelů je potřebná nezávislá metodologie označování datových aktiv, která není závislá na samotném systému, ale může být použita pro přímé srovnání s ním. Níže popíšeme, jak shromažďujeme základní pravdu z Facebooku a používáme ji k trénování našeho klasifikačního systému.
Shromažďování spolehlivých dat
Shromažďujeme spolehlivá data z každého zdroje uvedeného níže do jeho vlastní tabulky. Každá tabulka odpovídá za agregaci posledních pozorovaných hodnot z tohoto konkrétního zdroje. Každý zdroj má kontrolu kvality dat, aby se zajistilo, že pozorované hodnoty pro každý zdroj jsou vysoce kvalitní a obsahují poslední štítky typů dat.
- Konfigurace platformy pro shromažďování dat: určité sloupce v tabulkách úlu jsou vyplněny daty, která se vztahují k určitému typu. Použití a šíření těchto dat slouží jako spolehlivý zdroj spolehlivých dat.
- Ručně označování: vývojáři, kteří podporují systém, stejně jako externí označovatelé jsou školeni k označování sloupců. To obvykle dobře funguje pro všechny typy dat ve skladu a může být hlavním zdrojem spolehlivosti pro některá nestrukturovaná data, jako jsou data z zpráv nebo uživatelský obsah.
- Sloupce z rodičovských tabulek mohou být označovány nebo anotovány jako obsahující určitá data a můžeme tyto údaje sledovat v podřízených tabulkách.
- Výběr toků provádění: toky provádění ve Facebooku přenášejí data určitého typu. Použitím našeho skeneru jako servisní architektury můžeme vybírat toky, které mají známé typy dat, a posílat je přes systém. Systém slibuje, že tyto údaje neuchovává.
- Tabulky výběru: velké tabulky úlu, které jsou známy tím, že obsahují celé tělo dat, mohou být také používány jako tréninková data a přenášeny přes skener jako služba. To je skvělé pro tabulky s celým rozsahem typů dat, takže výběr sloupce náhodně je ekvivalentní výběru celého množství tohoto typu dat.
- Syntetická data: můžeme dokonce použít knihovny, které generují data za běhu. To dobře funguje pro jednoduché, veřejně přístupné typy dat, jako je adresa nebo GPS.
- Správci dat: programy ochrany soukromí obvykle využívají správce dat k ručnímu přiřazení politik k částem dat. To slouží jako vysoce přesný zdroj pravdivosti.
Spojujeme každý hlavní zdroj spolehlivých dat do jednoho souboru se všemi těmito daty. Největší problém s pravdivostí spočívá v tom, zajistit, aby byla reprezentativní pro datovou základnu. Jinak se klasifikační stroje mohou přeučit. V boji proti tomu se všechny výše uvedené zdroje používají k zajištění vyváženosti při trénování modelů nebo výpočtu metrik. Dále lidé označovači rovnoměrně vybírají různé sloupce v datové základně a odpovídajícím způsobem označují data, aby sběr spolehlivých hodnot zůstal nestranný.
Kontinuální integrace
Abychom zajistili rychlou iteraci a zlepšení, je důležité vždy měřit výkonnost systému v reálném čase. Můžeme měřit každé zlepšení klasifikace v porovnání se systémem dnes, takže takticky můžeme zaměřit data na další zlepšení. Zde prozkoumáme, jak systém uzavírá cyklus zpětné vazby zajištěný spolehlivými daty.
Když se systém plánování setká s aktivem, které má označení od spolehlivého zdroje, plánujeme dvě úlohy. První využívá naše výrobní skenery a tím pádem naše výrobní kapacity. Druhá úloha využívá skener poslední verze s nejnovějšími prvky. Každá úloha zapisuje svůj výstup do vlastní tabulky, označující verze spolu s výsledky klasifikace.
Tak porovnáváme výsledky klasifikace kandidáta na vydání a produkčního modelu v reálném čase.
Zatímco soubory dat porovnávají vlastnosti RC a PROD, zaznamenává se mnoho variant klasifikačního motoru ML služby predikce. Nejnovější vytvořený model strojového učení, aktuální model v produkci a jakékoli experimentální modely. Stejný přístup nám umožňuje „rozřezat“ různé verze modelu (agnostické k našim klasifikačním pravidlům) a porovnávat metriky v reálném čase. Tak snadno lze určit, kdy je experiment s ML připraven k nasazení do produkce.
Každou noc se RC-vlastnosti, vypočtené pro tento den, odesílají do tréninkového pipeline ML, kde se model trénuje na posledních RC-vlastnostech a hodnotí svou výkonnost v porovnání s důvěryhodným souborem dat.
Každé ráno model dokončuje trénink a automaticky se publikuje jako experimentální. Automaticky se zařazuje do seznamu experimentálních.
Některé výsledky
Označuje se více než 100 různých typů dat s vysokou přesností. Dobře strukturované typy, jako jsou e-maily a telefonní čísla, jsou klasifikovány s F2 skóre vyšším než 0,95. Volné typy dat, jako je uživatelský obsah a jména, také fungují velmi dobře, s F2 skóre nad 0,85.
Denně se klasifikuje velké množství jednotlivých sloupců stabilních a nestabilních dat ve všech úložištích. Denně se skenuje více než 500 terabajtů ve více než 10 datových skladech. Pokrytí většiny z těchto úložišť přesahuje 98%.
S časem se klasifikace stala velmi efektivní, protože úkoly klasifikace v uloženém autonomním toku trvají v průměru 35 sekund od skenování aktiva po výpočet predikcí pro každý sloupec.
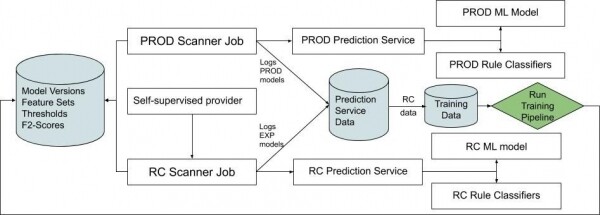
Obr. 2. Diagram popisující nekonečný tok integrace, abychom pochopili, jak se RC-objekty generují a odesílají do modelu.
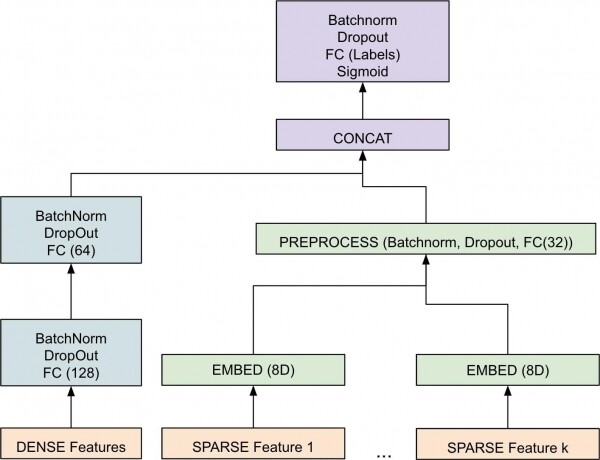
Obrázek 3. Vysokole velký diagram komponenty strojového učení.
Komponenta systému strojového učení
V předchozí části jsme se podrobně podívali na architekturu celého systému, zdůrazňující měřítko, optimalizaci a datové toky v autonomním a online režimu. V této části se podíváme na službu predikce a popíšeme systém strojového učení, který zajišťuje fungování služby predikce.
S více než 100 typy dat a některým strukturovaným obsahem, jako jsou data zpráv a uživatelský obsah, vede používání výhradně ruční heuristiky k podparametrické přesnosti klasifikace, zejména u nestrukturovaných dat. Z tohoto důvodu jsme také vyvinuli systém strojového učení pro práci s problémy nestrukturovaných dat. Použití strojového učení umožňuje začít se odchylovat od ruční heuristiky a pracovat s rysy a dalšími signály dat (například názvy sloupců, původ dat) pro zlepšení přesnosti.
Implementovaný model studuje vektorové reprezentace [3] nad hustými a řídkými objekty odděleně. Poté se kombinují, aby vytvořily vektor, který prochází sérií etap hromadné normalizace [4] a nelinearity pro získání konečného výsledku. Konečný výsledek je reálné číslo v rozmezí [0-1] pro každou značku, které ukazuje pravděpodobnost, že příklad patří danému typu citlivosti. Použití PyTorch pro model nám umožnilo postupovat rychleji, což dalo možnost vývojářům mimo tým rychle provádět a testovat změny.
Při návrhu architektury bylo důležité modelovat řídké (např. textové) a husté (např. číselné) objekty odděleně kvůli jejich vnitřním rozdílům. Pro konečnou architekturu bylo také důležité provést rozptyl parametrů, aby se našla optimální hodnota rychlosti učení, velikosti dávky a dalších hyperparametrů. Výběr optimalizátoru byl také důležitým hyperparametrem. Zjistili jsme, že populární optimalizátor Adamčasto vede k přeškolení, zatímco model s SGD stabilnější. Byly zde další aspekty, které jsme museli začlenit přímo do modelu. Například statická pravidla, která zaručovala, že model poskytuje determinovanou predikci, když má rys určitou hodnotu. Tato statická pravidla definovali naši klienti. Zjistili jsme, že začlenění těchto pravidel přímo do modelu vedlo k vytvoření více soběstačné a spolehlivé architektury, na rozdíl od realizace postprocessingu pro zpracování těchto speciálních hraničních případů. Také si všímejte, že během trénování jsou tato pravidla vypnuta, aby neovlivňovala tréninkový proces gradientního sestupu.
Problémy
Jedním z problémů byl sběr vysoce kvalitních spolehlivých dat. Model potřebuje spolehlivost pro každou třídu, aby se mohl učit asociace mezi objekty a štítky. V předchozí části jsme diskutovali o metodách sběru dat jak pro měření systému, tak pro učení modelů. Analýza ukázala, že takové třídy dat, jako jsou čísla kreditních karet a bankovních účtů, nejsou v našem úložišti příliš rozšířené. To ztěžuje sběr velkých objemů spolehlivých dat pro trénink modelů. Abychom tento problém vyřešili, vyvinuli jsme procesy pro získávání syntetických spolehlivých dat pro tyto třídy. Generujeme taková data pro citlivé typy, včetně SSN, čísla kreditních karet a IBAN-čísla, pro která model nemohl dříve predikovat. Tento přístup umožňuje zpracovávat citlivé typy dat bez rizika souvisejícího s utajováním skutečných citlivých dat.
Kromě problémů se spolehlivými daty existují otevřené architektonické problémy, na kterých pracujeme, jako jsou izolace změn a předčasné zastavení. Izolace změn je důležitá, aby při provádění různých změn v různých částech sítě mělo vliv omezený dosah na konkrétní třídy a nemělo široký dopad na celkovou výkonnost predikce. Zlepšení kritérií předčasného zastavení je rovněž zásadní pro to, abychom mohli ukončit tréninkový proces v stabilním bodě pro všechny třídy, a nikoli v bodě, kde se jedna třída přeučuje, zatímco jiná ne.
Význam znaku
Když je do modelu zaveden nový znak, chceme znát jeho celkový dopad na model. Také chceme zajistit, aby byly predikce interpretovatelné člověkem, abychom přesně pochopili, jaké znaky jsou používány pro každý typ dat. K tomu jsme vyvinuli a zavedli po třídách význam znaků pro model PyTorch. Všimněte si, že se to liší od celkového významu znaku, který je běžně podporován, protože nám to neříká, jaké znaky jsou důležité pro určitou třídu. Měříme důležitost objektu tím, že počítáme nárůst chyby predikce po permutaci objektu. Znak je „důležitý“, když permutace hodnot zvyšuje chybu modelu, protože v tomto případě se model spoléhal na znak při predikci. Znak je „nedůležitý“, když promíchání jeho hodnot ponechává chybu modelu nezměněnou, protože v tomto případě model ignoroval [5].
Význam znaku pro každou třídu umožňuje učinit model interpretovatelným, abychom mohli vidět, na co se model zaměřuje při predikování štítku. Například, když analyzujeme ADDR, zaručujeme, že s adresou spojený znak, jako je AddressLinesCount, zabírá vysoké místo v tabulce významu znaků pro každou třídu, aby naše lidská intuice dobře souhlasila s tím, co se model naučil.
Hodnocení
Je důležité stanovit jednotnou metriku úspěchu. Vybrali jsme F2 — vyvážení mezi citlivostí a přesností (míra citlivosti je mírně vyšší). Citlivost je důležitější pro použití související s ochranou soukromí než přesnost, protože pro tým je zásadní nezmeškat žádná citlivá data (při zajištění rozumné přesnosti). Skutečná data hodnocení výkonnosti F2 našeho modelu překračují tento článek. Nicméně, při pečlivém ladění můžeme dosáhnout vysokého (0,9+) skóre F2 pro nejdůležitější citlivé třídy.
Související práce
Existuje mnoho algoritmů pro automatickou klasifikaci nestrukturovaných dokumentů, které využívají různých metod, jako jsou shoda vzorů, vyhledávání podobnosti dokumentů a různé metody strojového učení (bayesovské, rozhodovací stromy, k-nearest neighbor a další) [6]. Jakákoliv z nich může být použita jako součást klasifikace. Problém však leží v škálovatelnosti. Přístup ke klasifikaci v tomto článku je zaměřen na flexibilitu a výkon. To nám umožňuje podporovat nové třídy v budoucnu a udržovat nízkou latenci.
Existuje také řada prací zaměřených na zachycení otisků z dat. Například autoři v [7] popsali řešení, které se soustředí na problém zachycování úniků citlivých dat. Hlavním předpokladem je možnost otisku z dat, aby bylo možné jej porovnat s množinou známých citlivých dat. Autoři v [8] popisují podobný problém úniku soukromí, ale jejich řešení je založeno na konkrétní architektuře Android a klasifikuje se pouze tehdy, když akce uživatele vedly k odeslání osobních informací, nebo pokud došlo k úniku uživatelských dat v základní aplikaci. Situace je zde poněkud odlišná, protože uživatelská data mohou být také silně nestrukturovaná. Proto potřebujeme složitější techniku než jen zachycení otisků.
Nakonec, abychom se vypořádali s nedostatkem dat pro některé typy citlivých dat, jsme zavedli syntetická data. Existuje velké množství literatury o augmentaci dat, například autoři v [9] zkoumali roli injekce šumu během trénování a pozorovali pozitivní výsledky ve řízeném učení. Náš přístup k ochraně soukromí se liší, protože zavedení zašuměných dat může být kontraproduktivní, a místo toho se zaměřujeme na vysoce kvalitní syntetická data.
Závěr
V tomto článku jsme představili systém, který dokáže klasifikovat fragment dat. To nám umožňuje vytvářet systémy zajišťující dodržování politiky ochrany soukromí a bezpečnosti. Ukázali jsme, že škálovatelná infrastruktura, kontinuální integrace, strojové učení a kvalitní data o důvěryhodnosti dat hrají klíčovou roli v úspěchu mnoha našich iniciativ v oblasti ochrany soukromí.
Existuje mnoho směrů budoucí práce. Může zahrnovat zajištění podpory neschema- tizovaných dat (souborů), klasifikaci nejen typu dat, ale také úrovně citlivosti, jakož i využití samokontrolního učení přímo během trénování pomocí generování přesných syntetických příkladů. Ty nakonec pomohou modelu snížit ztráty na maximální míru. Budoucí práce se může také zaměřit na pracovní tok vyšetřování, kde jdeme nad rámec detekce a poskytujeme analýzu příčin různých porušení ochrany soukromí. To pomůže v případech, jako je analýza citlivosti (tj. zda je citlivost ochrany soukromí typu dat vysoká (např. IP uživatele) nebo nízká (např. interní IP Facebooku)).
Bibliografie
- David Ben-David, Tamar Domany a Abigail Tarem. Klasifikace podnikových dat pomocí technologií sémantického webu. V Peteru F. Ï Patel-Schneiderovi, Yue Panovi, Pascalu Hitzlerovi, Peteru Mikovi, Lei Zhangovi, Jeffu Z. Panovi, Ianovi Horrocksovi a Birte Glimm, editoři, Sémantický web – ISWC 2010, strany 66–81, Berlín, Heidelberg, 2010. Springer Berlin Heidelberg.
- Subramanian Muralidhar, Wyatt Lloyd, Sabyasachi Roy, Cory Hill, Ernest Lin, Weiwen Liu, Satadru Pan, Shiva Shankar, Viswanath Sivakumar, Linpeng Tang a Sanjeev Kumar. f4: Facebookův systém teplého BLOB úložiště. V 11. sympozii USENIX o návrhu a implementaci operačních systémů (OSDI 14), strany 383–398, Broomfield, CO, říjen 2014. USENIX Association.
- Tomas Mikolov, Ilya Sutskever, Kai Chen, Greg S Corrado a Jeff Dean. Distribuované reprezentace slov a frází a jejich kompozicionalita. V C. J. C. Burgesovi, L. Bottouovi, M. Wellingovi, Z. Ghahramanim a K. Q. Weinbergerovi, editoři, Pokroky v zpracování informací neuronovými systémy 26, strany 3111–3119. Curran Associates, Inc., 2013.
- Sergey Ioffe a Christian Szegedy. Normalizace dávky: Zrychlení trénování hlubokých sítí snížením interní variability. V Francisu Bachovi a Davidu Bleimu, editoři, Sborník 32. mezinárodního sympozia o strojovém učení, svazek 37 sborníku Sborníku výzkumu strojového učení, strany 448–456, Lille, Francie, 07–09 července 2015. PMLR.
- Leo Breiman. Náhodné lesy. Mach. Učení., 45(1):5–32, říjen 2001.
- Thair Nu Phyu. Přehled technik klasifikace v těžbě dat.
- X. Shu, D. Yao a E. Bertino. Ochrana soukromí při detekci citlivého odhalení dat. IEEE Transactions on Information Forensics and Security, 10(5):1092–1103, 2015.
- Zhemin Yang, Min Yang, Yuan Zhang, Guofei Gu, Peng Ning a Xiaoyang Wang. Appintent: Analyzování citlivého přenosu dat v Androidu pro detekci úniku soukromí. strany 1043–1054, 11 2013.
- Qizhe Xie, Zihang Dai, Eduard H. Hovy, Minh-Thang Luong a Quoc V. Le. Neřízené zvyšování dat.
Zjistěte podrobnosti, jak získat žádanou profesi od nuly nebo zvýšit své znalosti a mzdu prostřednictvím online kurzů SkillFactory:
- (12 měsíců)
- (12 týdnů)
- (20 týdnů)
- (20 týdnů)
Další kurzy
- (9 měsíců)
- (8 měsíců)
- (9 měsíců)
- (12 měsíců)
- (18 měsíců)
- (12 měsíců)
- (9 měsíců)
- (7 měsíců)
Zdroj: habr.com
