

Dobrý den.
Rozhodl jsem se podělit o svůj objev — výsledek úvah, pokusů a omylů.
Ve skutečnosti: to není žádný objev, samozřejmě — to vše by mělo být dávno známo těm, kdo se zabývají aplikovanou analýzou dat a optimalizací různých systémů, nemusí to být nutně právě DBMS.
A ano, lidé to vědí, píší zajímavé články o svých výzkumech, (UPD.: v komentářích jsem byl upozorněn na velmi zajímavý projekt: )
Na druhou stranu: na první pohled nevidím široké zmínky nebo rozšíření tohoto přístupu na internetu mezi IT specialisty a DBA.
A nyní k věci.
Předpokládejme, že máme úkol: nastavit nějaký servisní systém pro provádění určité práce.
O této práci je známo: jaká je, v čem se měří kvalita této práce a jaký je kritérium pro měření této kvality.
Také předpokládejme, že je více či méně jasné, jak přesně se práce provádí (nebo s) tímto servisním systémem.
"Více či méně" znamená, že existuje možnost připravit (nebo někde získat) nějaký nástroj, utilitu nebo službu, kterou lze syntetizovat a předložit systému testovací zátěž, která je dostatečně adekvátní tomu, co bude v produkci, za dostatečně adekvátních podmínek pro práci v produkci.
A také je známo, jaké regulační parametry tohoto servisního systému máme k dispozici pro jeho ladění z hlediska jeho produktivity.
A v čem je problém — neexistuje dostatečné a úplné porozumění tomuto servisnímu systému, které by umožnilo odborně nastavit tento systém na budoucí zátěž na dané platformě a dosáhnout požadované produktivity systému.
No, tak to obvykle chodí.
Co se s tím dá dělat.
První, co mě napadá: podívat se do dokumentace k tomuto systému. Pochopit — jaké jsou povolené rozsahy pro hodnoty regulačních parametrů. A například metodou koordinovaného spouštění hledat hodnoty pro parametry systému v testech.
T.j. zadat systému nějakou konfiguraci ve formě konkrétní sady hodnot jeho nastavovacích parametrů.
Dodávat mu testovací zátěž pomocí této nástroje-utility, load-generátoru.
A sledování velikosti — odpovědi, nebo metriky kvality práce systému.
Druhou myšlenkou může být závěr, že — to přece trvá velmi dlouho.
Tedy: pokud je mnoho nastavitelných parametrů, pokud jsou rozsahy jejich hodnot velké, a pokud každý jednotlivý zátěžový test trvá dlouhou dobu, pak: ano, to všechno může zabrat nepřijatelně mnoho času.
No a zde je něco, co lze pochopit a vzpomenout si.
Můžeme zjistit, že v sadě hodnot nastavitelných parametrů servisního systému existuje vektor, jako posloupnost nějakých hodnot.
Každému takovému vektoru, při zachování ostatních konstant (pokud se tento vektor netýká konkrétní situace), odpovídá celkem přesně definovaná hodnota metriky — ukazatele kvality práce systému pod testovací zátěží.
Tedy.
Oz označíme vektor konfigurace systému jako  , kde
 ; kde
 — počet parametrů konfigurace systému, kolik jich je, těch parametrů.
A hodnota metriky, odpovídající tomuto  označíme jako
 , tedy nám vychází funkce:

A tedy: všechno se okamžitě redukuje na, v mém případě: téměř zapomenuté z doby studentských lavic, algoritmy hledání extrému funkce.
Dobře, ale zde vzniká organizačně-aplikovaný dotaz: jaký konkrétní algoritmus použít.
- V tom smyslu — aby bylo co nejméně potřeba sám kódovat.
- A aby to fungovalo, tedy aby to našlo extrém (pokud existuje), alespoň — rychleji než metody koordinátového spádu.
První moment naznačuje, že je třeba se podívat na nějaké prostředí, ve kterém jsou takové algoritmy — již implementovány a existují v nějaké podobě, připravené k použití v kódu.
No, znám python a cran-r
Druhý moment naznačuje, že je třeba si přečíst o samotných algoritmech, jaké existují, jaké mají požadavky, zvláštnosti v práci.
A co dávají, mohou mít užitečné vedlejší efekty-výsledky, ať už přímo od samotného algoritmu.
Nebo je lze získat z výsledků práce algoritmu.
Tady hodně závisí na vstupních podmínkách.
Například pokud, z nějakých důvodů, potřebujeme získat výsledek rychleji, pak bychom se měli podívat na algoritmy gradientního spádu a vybrat nějaký z nich.
Nebo pokud není tolik důležitý čas, můžeme například využít metody stochastické optimalizace, například genetický algoritmus.
Navrhuji zvážit práci takového přístupu k volbě konfigurace systému s využitím genetického algoritmu v následující, tak říkajíc, laboratorní práci.
Výchozí:
- Předpokládejme, že máme jako servisní systém:
oracle xe 18c - Nechť obsluhuje transakční aktivitu a cílem je dosáhnout co nejvyšší propustnosti SODB, podle transakcí za sekundu.
- Transakce se liší podle svého charakteru práce s daty a kontextu práce.
Domluvíme se, že jde o transakce, které nezpracovávají velké množství tabulkových dat.
V tom smyslu, že nevytvářejí undo data více než redo a nezpracovávají velké procento řádků ve velkých tabulkách.
Jedná se o transakce, které mění jeden řádek v více méně velké tabulce s malým počtem indexů nad touto tabulkou.
V takovém uspořádání bude produktivita SODB při zpracování transakcí, s ohledem na to, určena kvalitou zpracování redo dat.
Omezení — pokud hovoříme přesně o nastavení SODB.
Protože v obecném případě mohou být například transakční zámky mezi SQL relacemi způsobené návrhem uživatelské práce s tabulkovými daty a/nebo tabulkovým modelem.
Tyto faktory samozřejmě negativně ovlivní metriky TPS a budou to exogenní faktory vzhledem k SODB: takto jsme navrhli tabulkový model a práci s daty, že dochází k zámkům.
Proto, abychom zajistili čistotu experimentu, vyloučíme tento faktor, níže upřesním jak.
- Předpokládejme pro jistotu, že 100 % zadaných SQL příkazů do SODB jsou DML příkazy.
Předpokládejme, že charakteristiky uživatelské práce se SODB jsou stejné v testech.
A to: počet SQL relací, tabulková data, jak s nimi pracují SQL relace. - SODB pracuje v
FORCE LOGGING,ARCHIVELOGmodech. Režim flashback databáze je na úrovni SODB vypnut. - Redo logy jsou umístěny v samostatném souborovém systému na samostatném 'disku';
Celá ostatní část fyzické komponenty databáze je v jiném, samostatném FS na samostatném 'disku':
Podrobněji o zařízení fyzické komponenty laboratorní databáze
SQL> select status||' '||name from v$controlfile;
 /db/u14/oradata/XE/control01.ctl
SQL> select GROUP#||' '||MEMBER from v$logfile;
1 /db/u02/oradata/XE/redo01_01.log
2 /db/u02/oradata/XE/redo02_01.log
SQL> select FILE_ID||' '||TABLESPACE_NAME||' '||round(BYTES/1024/1024,2)||' '||FILE_NAME as col from dba_data_files;
4 UNDOTBS1 2208 /db/u14/oradata/XE/undotbs1_01.dbf
2 SLOB 128 /db/u14/oradata/XE/slob01.dbf
7 USERS 5 /db/u14/oradata/XE/users01.dbf
1 SYSTEM 860 /db/u14/oradata/XE/system01.dbf
3 SYSAUX 550 /db/u14/oradata/XE/sysaux01.dbf
5 MONITOR 128 /db/u14/oradata/XE/monitor.dbf
SQL> !cat /proc/mounts | egrep "/db/u[0-2]"
/dev/vda1 /db/u14 ext4 rw,noatime,nodiratime,data=ordered 0 0
/dev/mapper/vgsys-ora_redo /db/u02 xfs rw,noatime,nodiratime,attr2,nobarrier,inode64,logbsize=256k,noquota 0 0
Původně jsem chtěl pro tuto zátěžovou situaci použít transakční databázový systém.
Má tuto skvělou vlastnost, cituji autora:
V srdci SLOB je „metoda SLOB“. Metoda SLOB má za cíl testovat platformy
bez konfliktu aplikace. Nelze dosáhnout maximálního výkonu hardwaru
použitím aplikačního kódu, který je například omezen zámkováním aplikace nebo dokonce
sdílením bloků databáze Oracle. To je pravda – existují náklady na sdílení dat
v datech bloku! Ale SLOB – ve svém výchozím nasazení – je vůči takovému konfliktu imunní.
Toto prohlášení: odpovídá, a to je pravda.
Pohodlně reguluje stupeň paralelismu SQL relací, to je klíčové. -t spuštění utility runit.sh v rámci SLOB
Reguluje se procento DML instrukcí, které každá SQL relace posílá do DB, parametr UPDATE_PCT
Samostatně a velmi pohodlně: SLOB sama, před a po zátěžových relacích – připravuje Statspak nebo AWR snímky (co je nastaveno k přípravě).
Nicméně se ukázalo, že SLOB nepodporuje práci SQL relací s dobou trvání méně než 30 sekund.
Proto jsem ze začátku naprogramoval svůj, pracovní variantu zátěžového generátoru, a ta pak tak zůstala v provozu.
Upřesním, co zátěžový generátor dělá, pro jasnost.
V podstatě zátěžový generátor vypadá takto:
Kód pracovníka
function dotx()
{
local v_period="$2"
[ -z "v_period" ] && v_period="0"
source "/home/oracle/testingredotracе/config.conf"

$ORACLE_HOME/bin/sqlplus -S system/${v_system_pwd} << __EOF__
whenever sqlerror exit failure
set verify off
set echo off
set feedback off

define wnum="$1"
define period="$v_period"
set appinfo worker_&&wnum

declare
 v_upto number;
 v_key  number;
 v_tots number;
 v_cts  number;
begin
 select max(col1) into v_upto from system.testtab_&&wnum;
 SELECT (( SYSDATE - DATE '1970-01-01' ) * 86400 ) into v_cts FROM DUAL;
 v_tots := &&period + v_cts;
 while v_cts <= v_tots
 loop
  v_key:=abs(mod(dbms_random.random,v_upto));
  if v_key=0 then
   v_key:=1;
  end if;
  update system.testtab_&&wnum t
  set t.object_name=translate(dbms_random.string('a', 120), 'abcXYZ', '158249')
  where t.col1=v_key
  ;
  commit;
  SELECT (( SYSDATE - DATE '1970-01-01' ) * 86400 ) into v_cts FROM DUAL;
 end loop;
end;
/

exit
__EOF__
}
export -f dotx
Pracovníci se spouštějí následujícím způsobem:
Spuštění pracovníků
echo "spouštím test, trvání: ${TEST_DURATION}" >> "$v_logfile"
for((i=1;i> "$v_logfile"
 dotx "$i" "${TEST_DURATION}" &
done
echo "čekám..." >> "$v_logfile"
wait
Tabulky pro pracovníky se připravují takto:
Vytváření tabulek
function createtable() {
source "/home/oracle/testingredotracе/config.conf"
$ORACLE_HOME/bin/sqlplus -S system/${v_system_pwd} << __EOF__
whenever sqlerror continue
set verify off
set echo off
set feedback off

define wnum="$1"
define ts_name="slob"

begin
 execute immediate 'drop table system.testtab_&&wnum';
exception when others then null;
end;
/

create table system.testtab_&&wnum tablespace &&ts_name as
select rownum as col1, t.*
from sys.dba_objects t
where rownum> "$v_logfile"
To znamená, že pro každého pracovníka (prakticky: samostatná SQL sesse v databázi) se vytváří samostatná tabulka, se kterou pracuje pracovník.
Tím se dosahuje absence transakčních blokací mezi SQL sezeními pracovníků.
Každý pracovník: dělá to samé se svou tabulkou, všechny tabulky jsou stejné.
Všichni pracovníci vykonávají práci po stejnou dobu.
A to dost dlouho na to, aby se například určitě odehrával, a to nejen jednou, přepínání logu.
A tedy vznikaly s tím spojené náklady a efekty.
V mém případě jsem nastavil dobu trvání práce pracovníků na 8 minut.
Úryvek ze zprávy statspak, popisující práci databáze pod zátěží.
Databáze    ID DB    Instance     Číslo instance  Čas spuštění   Verze     RAC
~~~~~~~~ ----------- ------------ -------- --------------- ----------- ---
          2929910313 XE                  1 07-Sep-20 23:12 18.0.0.0.0  NE

Název hostitele             Platforma                CPU Jádra Sockets   Paměť (G)
~~~~ ---------------- ---------------------- ----- ----- ------- ------------
     billing.izhevsk1 Linux x86 64-bit           2     2       1         15.6

Snapshot       ID snímku     Čas snímku      Relace Curs/Sess Komentář
~~~~~~~~    ---------- ------------------ -------- --------- ------------------
Začátek snímku:       1630 07-Sep-20 23:12:27       55        .7
  Konec snímku:       1631 07-Sep-20 23:20:29       62        .6
   Doba uplynula:       8.03 (min) Průměrná aktivní relace:       8.4
   Čas DB:      67.31 (min)      CPU DB:      15.01 (min)

Velikosti mezipaměti            Začátek        Konec
~~~~~~~~~~~       ---------- ----------
    Mezipaměť bufferu:     1,392M              Standardní velikost bloku:         8K
     Sdílený pool:       288M                  Log buffer:   103,424K

Profil zátěže              Za sekundu    Na transakci    Na exec    Na volání
~~~~~~~~~~~~      ------------------  ----------------- ----------- -----------
      Čas DB (s):                8.4                0.0        0.00        0.20
       CPU DB (s):                1.9                0.0        0.00        0.04
       Velikost redo:        7,685,765.6              978.4
   Logické čtení:           60,447.0                7.7
   Změny bloku:           47,167.3                6.0
  Fyzická čtení:                8.3                0.0
 Fyzická zápisy:              253.4                0.0
      Uživatelské volání:               42.6                0.0
          Parsování:               23.2                0.0
     Tvrdé parsování:                1.2                0.0
W/A MB zpracováno:                1.0                0.0
          Přihlášení:                0.5                0.0
        Vykonání:           15,756.5                2.0
       Rollbacks:                0.0                0.0
    Transakce:            7,855.1
Vracíme se k zadání laboratorní práce.
Budeme, za jinak stejných podmínek, variabilně měnit hodnoty následujících parametrů laboratorní databáze:
- Velikost skupin žurnálů databáze. Rozsah hodnot: [32, 1024] MB;
- Počet skupin žurnálů databáze. Rozsah hodnot: [2, 32];
log_archive_max_processesrozsah hodnot: [1, 8];commit_loggingpovoleno dva hodnoty:batch|immediate;commit_waitpovoleno dva hodnoty:wait|nowait;log_bufferrozsah hodnot: [2, 128] MB.log_checkpoint_timeoutrozsah hodnot: [60, 1200] sekunddb_writer_processesrozsah hodnot: [1, 4]undo_retentionrozsah hodnot: [30; 300] sekundtransactions_per_rollback_segmentrozsah hodnot: [1, 8]disk_asynch_iopovoleno dva hodnoty:true|false;filesystemio_optionspovoleny následující hodnoty:none|setall|directIO|asynch;db_block_checkingpovoleny následující hodnoty:OFF|LOW|MEDIUM|FULL;db_block_checksumpovoleny následující hodnoty:OFF|TYPICAL|FULL;
Člověk se zkušeností v podpoře databází oracle určitě nyní může říci — co a jaké hodnoty je třeba nastavit z uvedených parametrů a jejich povolených hodnot, aby se dosáhlo vyšší produktivity databáze pro danou práci s daty, která je zde definována aplikačním kódem, výše.
Ale.
Smyslem laboratorní práce je ukázat, že optimalizační algoritmus, sám o sobě a relativně rychle, nám to objasní.
Zůstává nám jen podívat se do dokumentace na nastavovaném systému, přesně tak, jak je potřeba, abychom zjistili, které parametry a v jakých rozsazích měnit.
A také: napsat kód, kterým bude realizována práce s nastavovaným systémem vybraného optimalizačního algoritmu.
Tedy nyní o kódu.
Jak jsem již zmínil, cran-r, tzn.: všechny manipulace s nastavovaným systémem jsou orchestrány ve formě R-skriptu.
Vlastně úkol, analýza, výběr podle hodnoty metriky, stavových vektorů systému: to je balíček GA ()
Balíček, v tomto případě, příliš nevyhovuje, protože očekává zadání vektorů (chromozomů, pokud jde o terminologii balíčku) ve formě zlomkových čísel.
A můj vektor, skládající se z hodnot nastavovacích parametrů: to je 14 hodnot — celé čísla a řetězcové hodnoty.
Problém se samozřejmě snadno obchází přiřazením řetězcovým hodnotám – nějakých konkrétních čísel.
Tedy nakonec, hlavní část R-skriptu vypadá takto:
Výzva GA::ga
cat( "", file=v_logfile, sep="n", append=F)

pSize = 10
elitism_value=1
pmutation_coef=0.8
pcrossover_coef=0.1
iterations=50

gam=GA::ga(type="real-valued", fitness=evaluate,
lower=c(32,2, 1,1,1,2,60,1,30,1,0,0, 0,0), upper=c(1024,32, 8,10,10,128,800,4,300,8,10,40, 40,30),
popSize=pSize,
pcrossover = pcrossover_coef,
pmutation = pmutation_coef,
maxiter=iterations,
run=4,
keepBest=T)
cat( "GA-session is done" , file=v_logfile, sep="n", append=T)
gam@solution
Zde, za pomocí lower a upper atributů podprogramu ga se definuje v podstatě oblast vyhledávacího prostoru, uvnitř které bude prováděno hledání takového vektoru (nebo vektorů), pro které bude dosaženo maximální hodnoty fitness funkce.
Podprogram ga provádí hledání maximizováním fitness funkce.
Takže, v tomto případě, je potřeba, aby fitness funkce, chápajíc vektor jako sadu hodnot pro určité parametry DBMS, získala metriky od DBMS.
Tzn.: kolik, při daném nastavení DBMS a dané zátěži na DBMS, DBMS zpracovává transakcí za sekundu.
Tedy, pokud to rozšíříme, je potřeba, aby uvnitř fitness funkce probíhala taková složitá operace:
- Zpracování vstupního vektoru čísel — jeho přeměna na hodnoty pro parametry DBMS.
- Pokus o vytvoření stanoveného počtu redo-skupin, stanovené velikosti. Přičemž pokus: může být neúspěšný.
Existující skupiny žurnálů v databázovém systému, v určitém počtu a velikosti, by měly být pro čistotu experimentu odstraněny. - V případě úspěchu předchozího bodu: zadání hodnot konfiguračních parametrů (opět může dojít k chybě).
- V případě úspěchu předchozího bodu: zastavení databázového systému, znovu spuštění databázového systému, aby nově zadané hodnoty parametrů vstoupily v platnost. (opět může dojít k chybě).
- V případě úspěchu předchozího bodu: provést zátěžový test a získat metriky od databázového systému.
- Vrátit databázový systém do výchozího stavu, tj. odstranit dodatečné skupiny žurnálů a vrátit do provozu původní konfiguraci databázového systému.
Kód fitness funkce
evaluate=function(p_par) {
v_module="evaluate"
v_metric=0
opn=NULL
opn$rg_size=round(p_par[1],digit=0)
opn$rg_count=round(p_par[2],digit=0)
opn$log_archive_max_processes=round(p_par[3],digit=0)
opn$commit_logging="BATCH"
if ( round(p_par[4],digit=0) > 5 ) {
 opn$commit_logging="IMMEDIATE"
}
opn$commit_logging=paste("'", opn$commit_logging, "'",sep="")

opn$commit_wait="WAIT"
if ( round(p_par[5],digit=0) > 5 ) {
 opn$commit_wait="NOWAIT"
}
opn$commit_wait=paste("'", opn$commit_wait, "'",sep="")

opn$log_buffer=paste(round(p_par[6],digit=0),"m",sep="")
opn$log_checkpoint_timeout=round(p_par[7],digit=0)
opn$db_writer_processes=round(p_par[8],digit=0)
opn$undo_retention=round(p_par[9],digit=0)
opn$transactions_per_rollback_segment=round(p_par[10],digit=0)
opn$disk_asynch_io="true"
if ( round(p_par[11],digit=0) > 5 ) {
 opn$disk_asynch_io="false"
}

opn$filesystemio_options="none"
if ( round(p_par[12],digit=0) > 10 && round(p_par[12],digit=0)  20 && round(p_par[12],digit=0)  30 ) {
 opn$filesystemio_options="asynch"
}

opn$db_block_checking="OFF"
if ( round(p_par[13],digit=0) > 10 && round(p_par[13],digit=0)  20 && round(p_par[13],digit=0)  30 ) {
 opn$db_block_checking="FULL"
}

opn$db_block_checksum="OFF"
if ( round(p_par[14],digit=0) > 10 && round(p_par[14],digit=0)  20 ) {
 opn$db_block_checksum="FULL"
}

v_vector=paste(round(p_par[1],digit=0),round(p_par[2],digit=0),round(p_par[3],digit=0),round(p_par[4],digit=0),round(p_par[5],digit=0),round(p_par[6],digit=0),round(p_par[7],digit=0),round(p_par[8],digit=0),round(p_par[9],digit=0),round(p_par[10],digit=0),round(p_par[11],digit=0),round(p_par[12],digit=0),round(p_par[13],digit=0),round(p_par[14],digit=0),sep=";")
cat( paste(v_module," try to evaluate vector: ", v_vector,sep="") , file=v_logfile, sep="n", append=T)

rc=make_additional_rgroups(opn)
if ( rc!=0 ) {
 cat( paste(v_module,"make_additional_rgroups failed",sep="") , file=v_logfile, sep="n", append=T)
 return (0)
}

v_rc=0
rc=set_db_parameter("log_archive_max_processes", opn$log_archive_max_processes)
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("commit_logging", opn$commit_logging )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("commit_wait", opn$commit_wait )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("log_buffer", opn$log_buffer )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("log_checkpoint_timeout", opn$log_checkpoint_timeout )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_writer_processes", opn$db_writer_processes )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("undo_retention", opn$undo_retention )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("transactions_per_rollback_segment", opn$transactions_per_rollback_segment )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("disk_asynch_io", opn$disk_asynch_io )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("filesystemio_options", opn$filesystemio_options )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_block_checking", opn$db_block_checking )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_block_checksum", opn$db_block_checksum )
if ( rc != 0 ) {  v_rc=1 }

if ( rc!=0 ) {
 cat( paste(v_module," can not startup db with that vector of settings",sep="") , file=v_logfile, sep="n", append=T)
 rc=stop_db("immediate")
 rc=create_spfile()
 rc=start_db("")
 rc=remove_additional_rgroups(opn)
 return (0)
}

rc=stop_db("immediate")
rc=start_db("")
if ( rc!=0 ) {
 cat( paste(v_module," can not startup db with that vector of settings",sep="") , file=v_logfile, sep="n", append=T)
 rc=stop_db("abort")
 rc=create_spfile()
 rc=start_db("")
 rc=remove_additional_rgroups(opn)
 return (0)
}

rc=run_test()
v_metric=getmetric()

rc=stop_db("immediate")
rc=create_spfile()
rc=start_db("")
rc=remove_additional_rgroups(opn)

cat( paste("result: ",v_metric," ",v_vector,sep="") , file=v_logfile, sep="n", append=T)
return (v_metric)
}
Tedy, celá práce: probíhá ve fitness funkci.
ga-podprogram, provádí zpracování vektorů, nebo přesněji řečeno — chromozomů.
Ve které, nám nejvíce záleží na: selekci chromozomů s takovými geny, při kterých fitness funkce vykazuje vysoké hodnoty.
To je vlastně proces hledání optimální sady chromozomů vektorově v N-dimenzionálním vyhledávacím prostoru.
Velmi srozumitelné, podrobné , s příklady R kódu, fungování genetického algoritmu.
Zvlášť bych chtěl upozornit na dva technické momenty.
Pomocné volání, z funkce evaluate, například zastavení-spuštění, nastavení hodnoty parametru DB, se provádí na základě cran-r funkce system2
S jejíž pomocí: se volá už nějaký bash skript, nebo příkaz.
Například:
set_db_parameter
set_db_parameter=function(p1, p2) {
v_module="set_db_parameter"
v_cmd="/home/oracle/testingredotracе/set_db_parameter.sh"
v_args=paste(p1," ",p2,sep="")

x=system2(v_cmd, args=v_args, stdout=T, stderr=T, wait=T)
if ( length(attributes(x)) > 0 ) {
 cat(paste(v_module," failed with: ",attributes(x)$status," ",v_cmd," ",v_args,sep=""), file=v_logfile, sep="n", append=T)
 return (attributes(x)$status)
}
else {
 cat(paste(v_module," ok: ",v_cmd," ",v_args,sep=""), file=v_logfile, sep="n", append=T)
 return (0)
}
}
Druhý moment — řádek, evaluate funkce, se zachováním konkrétní hodnoty metriky a jejím přidruženým nastavením vektoru, do log souboru:
cat( paste("result: ",v_metric," ",v_vector,sep="") , file=v_logfile, sep="n", append=T)To je důležité, protože, z tohoto datového pole, bude možné získat další informace o tom, který z komponent nastavení vektoru více či méně ovlivňuje hodnotu metriky.
Tedy: bude možné provést analýzu importance atributů.
Takže, co se může stát.
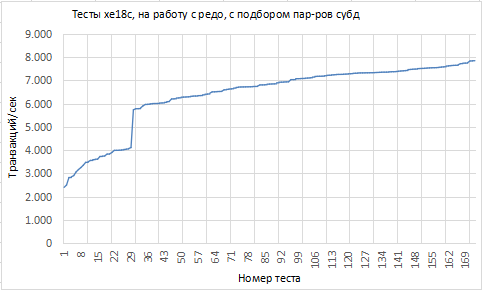
Ve formě grafu, pokud se testy seřadí podle vzestupu metriky, situace je následující:
Některá data odpovídající extrémním hodnotám metriky:
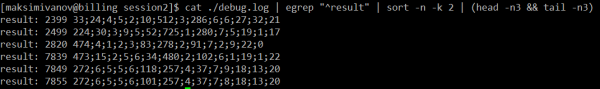
Tady, na screenshotu s výsledky, upřesním: hodnoty nastavení vektoru — jsou vyjádřeny v pojmech kódu fitness funkce, ne v pojmech seznamu čísel parametrů/rozsahů hodnot parametrů, které jsem formuloval výše v textu.
No, je to hodně, nebo málo, ~8tis tps: otázka je to samostatná.
V rámci laboratorní práce — není podstatné toto číslo, důležitá je dynamika, jak se tato hodnota mění.
Dynamika je tady dobrá.
Je zřejmé, že, minimálně jeden faktor, významně ovlivňující hodnotu metriky, genetický algoritmus, procházející vektory-chromozomy: zakryl.
Soudě podle dostatečně živé dynamiky hodnot křivky – existuje ještě minimálně jeden faktor, který, ačkoli je výrazně menší, má vliv.
Tady potřebujeme attribute-importance analýzu, abychom pochopili, které atributy (no, v tomto případě – komponenty nastavení vektoru) a jak silně ovlivňují hodnotu metriky.
A z těchto informací: pochopit – jaké faktory byly ovlivněny změnami významných atributů.
Provést attribute-importance je možné různými způsoby.
Pro tyto účely se mi líbí algoritmus randomForest stejnojmenného R balíčku ()
randomForest, jak rozumím jeho fungování vůbec a jeho přístupu k hodnocení důležitosti atributů zvlášť, vytváří jakýsi model závislosti proměnné-odpovědi na atributech.
V našem případě je proměnná odpovědi – metrika získaná ze SGBD při zatěžovacích testech: tps;
A atributy jsou – komponenty nastavení vektoru.
Tak tedy randomForest hodnotí důležitost každého atributu modelu dvěma čísly: %IncMSE – jak přítomnost/absence daného atributu v modelu mění kvalitu modelu MSE (Mean Squared Error);
A IncNodePurity – je číslo, které ukazuje, jak kvalitně, podle hodnot tohoto atributu, lze rozdělit datový soubor s pozorováními tak, aby v jedné části byly data s nějakou jednou hodnotou vysvětlované metriky a v druhé s jinou hodnotou metriky.
No, tedy: jak moc je to klasifikující atribut (nejjasnější, rusko-jazykové vysvětlení k random forestu jsem viděl ).
Pracující-kulturní R kód pro zpracování datového souboru s výsledky zatěžovacích testů:
x=NULL
v_data_file=paste('tmp/data1.dat',sep="")
x=read.table(v_data_file, header = TRUE, sep = ";", dec=",", quote = ""'", stringsAsFactors=FALSE)
colnames(x)=c('metric','rgsize','rgcount','lamp','cmtl','cmtw','lgbffr','lct','dbwrp','undo_retention','tprs','disk_async_io','filesystemio_options','db_block_checking','db_block_checksum')

idxTrain=sample(nrow(x),as.integer(nrow(x)*0.7))
idxNotTrain=which(! 1:nrow(x) %in% idxTrain)
TrainDS=x[idxTrain,]
ValidateDS=x[idxNotTrain,]

library(randomForest)
#mtry=as.integer(sqrt(dim(x)[2]-1))
rf=randomForest(metric ~ ., data=TrainDS, ntree=40, mtry=3, replace=T, nodesize=2, importance=T, do.trace=10, localImp=F)
ValidateDS$predicted=predict(rf, newdata=ValidateDS[,colnames(ValidateDS)!="metric"], type="response")
sum((ValidateDS$metric-ValidateDS$predicted)^2)
rf$importance
Můžete si přímo ručně vybrat hyperparametry algoritmu a, orientujíc se na kvalitu modelu, zvolit model, který přesněji provádí predikce na validačním datovém souboru.
Můžete napsat nějakou funkci pro tuto práci (mimochodem – opět na nějakém optimalizačním algoritmu).
Můžete využít R balíček caret, o nic nejde.
Nakonec, v tomto případě dostáváme takový výsledek pro hodnocení důležitosti atributů:
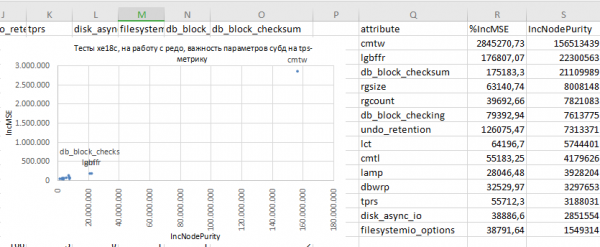
Takže, můžeme přistoupit k globálním úvahám:
- Jde o to, že nejdůležitějším parametrem se v těchto podmínkách testování ukázal být
commit_wait
Technicky určuje režim provádění io-operace zápisu redo-dat z logu databáze do aktuální žurnální skupiny: synchronní nebo asynchronní.
Hodnotanowaitpři kterém dochází prakticky k vertikálnímu a násobenému nárůstu hodnoty metriky tps: to je zapnutí asynch módu io v redo skupinách.
Samostatná otázka — je nebo není nutné to dělat v produkční databázi. Tady se omezím pouze na konstataci: to je významný faktor. - Logicky, velikost log-bufferu databáze se ukazuje jako významný faktor.
Čím menší je velikost log-bufferu, tím menší je jeho bufferingová schopnost, tím častěji dochází k jeho přetečení a/nebo nemožnosti uvolnit v něm volné místo pro novou dávku redo-dat.
A to znamená: zpoždění spojená s alokací prostoru v log-bufferu a/nebo s vyhazováním redo-dat z něj do redo skupin.
Tato zpoždění by samozřejmě měla ovlivňovat a ovlivňují propustnost databáze pro transakce. - Parameter
db_block_checksum: no, také, v zásadě je to jasné — zpracování transakcí vede k vytváření dirty bloků v buffer cache databáze.
Které, při zapnuté kontrole checksumů datových bloků, musí databáze zpracovávat — vypočítávat tyto checksumy z těla datového bloku a porovnávat je s tím, co je napsáno v hlavičce datového bloku: souhlasí/nepřesně.
Taková práce, opět, nemůže neprotahovat zpracování dat, a odpovídající parametr a mechanismus, který tento parametr určuje, se ukazují jako významné.
Proto dodavatel v dokumentaci k tomuto parametru nabízí různé hodnoty a zdůrazňuje, že — ano, dopad bude, ale můžete si vybrat různé hodnoty, včetně "vypnuto", a různý dopad.
No a globální závěr.
Přístup se, v zásadě, ukazuje jako docela funkční.
Přesně tak umožňuje, v raných fázích zátěžového testování určité servisní systémy, pro volbu její (systému) optimální konfigurace pod zátěží, aniž by se příliš zabýval specifiky nastavení systému pod zátěž.
Ale nezapomínejme — alespoň na úrovni porozumění: "regulačních knoflíků" a přípustných rozsahů otáčení těchto knoflíků by systém měl znát.
Dále může přístup relativně rychle nalézt optimální konfiguraci systému.
A na základě testování je možné získat informace o povaze souvislosti metriky kvality práce systému a hodnot nastavitelných parametrů systému.
To by samozřejmě mělo přispět k tomu, aby se objevilo právě to hluboké porozumění systému, jeho fungování, alespoň — pod daným zatížením.
Prakticky to znamená: vyměnit náklady na porozumění konfigurovatelnému systému za náklady na přípravu takového testování práce systému.
Zvlášť bych chtěl zdůraznit: v tomto přístupu je kriticky důležitý stupeň adekvátnosti testování systému k podmínkám jeho provozu, jaké bude mít v produkčním nasazení.
Děkuji za vaši pozornost, čas.
Zdroj: habr.com
