

Nasazení nové verze projektu do produkce vyžaduje pečlivé dodržování rovnováhy mezi rychlostí nasazení a spolehlivostí řešení. Ve společnosti Slack si cení rychlých iterací, krátkých cyklů zpětné vazby a rychlé reakce na dotazy uživatelů. Kromě toho má firma stovky programátorů, kteří se snaží dosáhnout maximální produktivity.
Autoři materiálu, jehož překlad dnes publikujeme, říkají, že společnost, která se snaží dodržovat podobné hodnoty a zároveň roste, by měla neustále zlepšovat svůj systém nasazení projektů. Firma by měla investovat úsilí do transparentnosti a spolehlivosti pracovních procesů, aby tyto procesy vyhovovaly velikosti projektu. Tato část se zaměřuje na pracovní procesy, které se vyvinuly ve Slacku, a na některá řešení, která vedla k použití stávajícího systému nasazení projektů.
Jak procesy nasazení projektů fungují dnes
Každý PR (pull request) ve Slacku musí bezpodmínečně projít revizí kódu a úspěšně absolvovat všechny testy. Teprve poté, co jsou tyto podmínky splněny, může programátor sloučit svůj kód s větví master projektu. Nasazení takového kódu se však provádí pouze v pracovní době podle severoamerického času. To znamená, že jsme, díky tomu, že naši zaměstnanci jsou na svých místech, zcela připraveni řešit případné nečekané problémy.
Každý den provádíme asi 12 plánovaných nasazení. V průběhu každého nasazení programátor pověřený řízením nasazení odpovídá za uvedení nové verze do produkce. Je to vícestupňový proces, který zajišťuje plynulé uvedení verze do provozu. Díky tomuto přístupu můžeme odhalit chyby dříve, než postihnou všechny naše uživatele. Pokud se chyb ukáže příliš mnoho, může být nasazení verze vráceno. Pokud je však nějaký konkrétní problém odhalen po vydání, lze snadno vydat opravu.
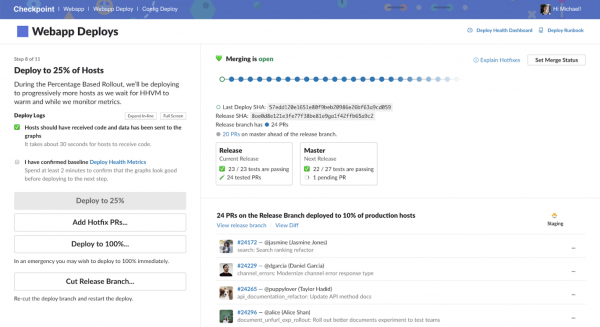
Rozhraní systému Checkpoint, které se používá ve Slacku pro nasazení projektů
Proces nasazení nové verze do produkce lze představit jako čtyřkrokový.
▍1. Vytvoření verzovacího větve
Každý releas začíná novou větví, vycházející z naší historie Git. To nám umožňuje přiřadit releasu značky a poskytuje místo, kam můžeme provádět rychlé opravy chyb nalezených při přípravě releasu na uvedení do produkce.
▍2. Nasazení do stádia
Dalším krokem procesu je nasazení verze na stagingové servery a spuštění automatických testů na celkovou funkčnost projektu (smoke test). Stagingové prostředí je produkční prostředí, do kterého nezasahuje externí provoz. V tomto prostředí provádíme další ruční testování. To nám poskytuje dodatečnou jistotu, že upravený projekt funguje správně. Pouhé automatizované testy nestačí k dosažení podobné jistoty.
▍3. Nasazení do dogfood a canary prostředí
Nasazení do produkce začíná v dogfood prostředí, což je soubor hostitelů, které slouží našim interním pracovním prostorům Slack. Jakožto velmi aktivní uživatelé Slacku nám takový přístup pomohl odhalit mnoho chyb v raných fázích nasazení. Po ověření, že základní funkčnost systému není narušena, pak probíhá nasazení verze do canary prostředí. To představuje systémy, na které směřuje přibližně 2% produkčního provozu.
▍4. Postupný přechod do produkce
Pokud monitoring nového releasu vykazuje stabilní hodnoty a po nasazení projektu v canary prostředí nedostaneme žádné stížnosti, pokračujeme v postupném přechodu produkčních serverů na nový releas. Proces nasazení je rozdělen do následujících fází: 10%, 25%, 50%, 75% a 100%. Díky tomu můžeme pomalu předávat produkční provoz novému releasu systému. Přitom máme čas na prozkoumání situace v případě odhalení jakýchkoli anomálií.
▍Co dělat, když během nasazení něco nevyjde?
Změna kódu vždy představuje riziko. Ale my se s tím vyrovnáváme díky dobře připraveným „šéfům nasazení“, kteří řídí proces vydání nového releasu do produkce, sledují monitorovací ukazatele a koordinují práci programátorů, kteří vydávají kód.
Pokud se něco opravdu pokazí, snažíme se problém odhalit co nejdříve. Prozkoumáme problém, najdeme PR, které způsobuje chyby, vrátíme ho zpět, pečlivě analyzujeme a vytvoříme novou sestavu. Pravda, někdy se problém ukáže jako nepovšimnutý až do vydání projektu do produkce. V takové situaci je nejdůležitější obnovit fungování služby. Proto se před zahájením řešení problému okamžitě vracíme k předchozí pracovní sestavě.
Stavební bloky nasazovacího systému
Podíváme se na technologie, které tvoří základ našeho systému nasazení projektů.
▍Rychlá nasazení
Výše popsaný pracovní postup se může zpětně jevit jako zcela zřejmý. Ale náš nasazovací systém se takovým stal daleko ne hned.
Když byla společnost mnohem menší, celé naše aplikace mohla běžet na 10 instancích Amazon EC2. Nasazení projektu v takové situaci znamenalo použít rsync pro rychlou synchronizaci všech serverů. Dříve odděloval nový kód od produkce pouze jeden krok, představovaný mezilehlým prostředím. Sestavy byly vytvářeny a ověřovány v takovém prostředí a poté šly přímo do produkce. Porozumět takovému systému bylo velmi snadné, umožňoval jakémukoli programátorovi kdykoli nasadit napsaný kód.
Ale s rostoucím počtem našich klientů rostly také rozměry infrastruktury potřebné k zajištění provozu projektu. Brzy, s ohledem na neustálý růst systému, přestala naše model nasazení, založený na zasílání nového kódu na servery, plnit svůj účel. Přesněji řečeno, přidání každého nového serveru znamenalo zvýšení času potřebného k provedení nasazení. Dokonce i strategie založené na paralelním aplikování rsync mají svá určitá omezení.
Nakonec jsme vyřešili tento problém přechodem na zcela paralelní systém nasazení, uspořádaný jinak než starý systém. Konkrétně nyní každý server samostatně stahoval novou sestavu, přičemž se dozvěděl, že je třeba to udělat, sledováním změny klíče Consul. Servery stahovaly kód paralelně. To nám umožnilo udržovat vysokou rychlost nasazení i v prostředí neustálého růstu systému.
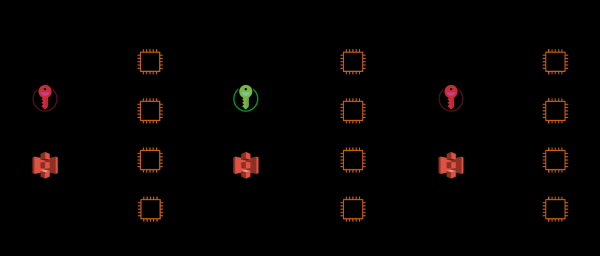
1. Produkční servery sledují klíč Consul. 2. Klíč se mění, což oznámí serverům, že je třeba začít stahovat nový kód. 3. Servery stahují tarball soubory s kódem aplikace.
▍Atomární nasazení
Dalším řešením, které nám pomohlo přejít na víceúrovňový systém nasazení, bylo atomární nasazení.
Před používáním atomárních nasazení mohlo každé nasazení vést k velkému množství chybových zpráv. Důvodem bylo, že proces kopírování nových souborů na produkční servery nebyl atomární. To vedlo k existenci krátkého časového úseku, kdy byl kód, v němž byly volány nové funkce, dostupný před tím, než byly tyto funkce skutečně zpřístupněny. Když byl takový kód volán, vedlo to k vracení interních chyb. To se projevovalo neúspěšnými API požadavky a „rozbitými“ webovými stránkami.
Tým, který se touto problematikou zabýval, ji vyřešil zavedením pojmů "horké" (hot) a "studené" (cold) adresáře. Kód v "horkém" adresáři odpovídá za zpracování produkčního provozu. A v "studených" adresářích je kód během provozu systému pouze připravován k použití. Při nasazení se nový kód kopíruje do nepoužívaného "studeného" adresáře. Poté, když na serveru nebudou aktivní procesy, dojde k okamžitému přepnutí adresářů.
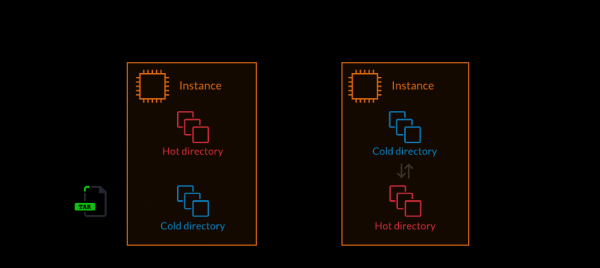
1. Rozbalení kódu aplikace do "studeného" adresáře. 2. Přepnutí systému na "studený" adresář, který se stává "horkým" (atomární operace).
Závěry: přesun důrazu na spolehlivost.
V roce 2018 projekt dospěl do takových rozměrů, kdy velmi rychlé nasazení začalo ohrožovat stabilitu produktu. Měli jsme poměrně pokročilý nasazovací systém, do kterého jsme investovali hodně sil a času. Potřebovali jsme pouze přestavět a vylepšit procesy organizace nasazení. Stali jsme se dostatečně velkou společností, jejíž vývojové produkty byly na celém světě používány pro zajištění neomezené komunikace a pro řešení důležitých úkolů. Proto se naše pozornost zaměřila na spolehlivost.
Museli jsme učinit proces nasazení nových verzí Slack bezpečnějším. Tato potřeba nás vedla k vylepšení našeho nasazovacího systému. Vlastně jsme již dříve diskutovali o tomto vylepšeném systému. V hlubinách systému nadále využíváme technologie rychlého a atomového nasazení. Změnilo se to, jak přesně probíhá nasazení. Náš nový systém je navržen pro postupné provádění nasazení nového kódu na různých úrovních, v různých prostředích. Nyní používáme pokročilejší pomocné nástroje a systémové monitorovací prostředky než dříve. To nám umožňuje odhalovat a opravovat chyby dlouho předtím, než dostanou šanci dostat se k koncovému uživateli.
Ale nehodláme se zastavit na dosaženém. Neustále vylepšujeme tento systém, používáme pokročilejší pomocné nástroje a prostředky automatizace práce.
Vážení čtenáři! Jak je uspořádán proces nasazení nových verzí projektů tam, kde pracujete vy?
Zdroj: habr.com
