

Upřímně řečeno, Ivan se často smál marným snahám svých kolegů z monitorovacího oddělení. Vynakládali obrovské úsilí na realizaci metrik, které si objednalo vedení společnosti. Byli tak zaneprázdnění, že už nechtěli nic dělat.
A vedení mělo pořád málo – neustále si objednávalo nové a nové metriky, velmi brzy přestávalo používat to, co bylo vyhotoveno dříve.
V poslední době se všichni bavili pouze o LeadTime – čase dodání obchodních funkcí. Metrika ukázala šílené číslo – 200 dní na dodání jednoho úkolu. Jak všichni vzdychali, naříkali a vzpínali ruce k nebi!
Po nějaké době hluk postupně utichl a od vedení přišel příkaz na vytvoření další metriky.
Ivanovi bylo zcela jasné, že i nová metrika tiše zemře v temném koutě.
Opravdu, přemýšlel Ivan, znalost čísla nikomu o ničem neříká. 200 dní nebo 2 dny – není v tom žádný rozdíl, protože podle čísla nelze zjistit příčinu a pochopit, jestli je to dobré nebo špatné.
To je typická past metrik: zdá se, že nová metrika odhalí podstatu bytí a vysvětlí nějaké tajné tajemství. Všichni v to doufají, ale přitom se nic neděje. Protože tajemství není třeba hledat v metrikách!
Pro Ivana to byla už překonaná etapa. Chápal, že pro měření, a všechny tajemství je třeba hledat v , t.j. v tom, co tuto metriku formuje.
Pro internetový obchod bude objektem vlivu jeho zákazníci, kteří přinášejí peníze, a pro DevOps – týmy, které vytvářejí a nasazují distribuce pomocí trubky.
Jednou, usazený v hale v pohodlném křesle, se Ivan rozhodl pořádně promyslet, jak by chtěl vidět metriky DevOps s ohledem na to, že objektem vlivu jsou týmy.
Cíl metrik DevOps
Je jasné, že všichni chtějí zkrátit dobu dodání. 200 dní – to přece není přijatelné.
Ale jak, to je ta otázka?
Ve firmě pracují stovky týmů a každý den prochází přes DevOps potrubí tisíce distribucí. Skutečná doba dodání bude mít podobu rozdělení. Každý tým bude mít svůj čas a své vlastní zvláštnosti. Jak v tomhle chaotickém mixu najít něco?
Odpověď se vynutila sama od sebe – je potřeba najít problematické týmy a zjistit, co se u nich děje a proč to trvá tak dlouho, a od "dobrých" týmů se naučit, jak všechno dělat rychle. K tomu je potřeba změřit čas, který týmy stráví na každém z DevOps stánků:
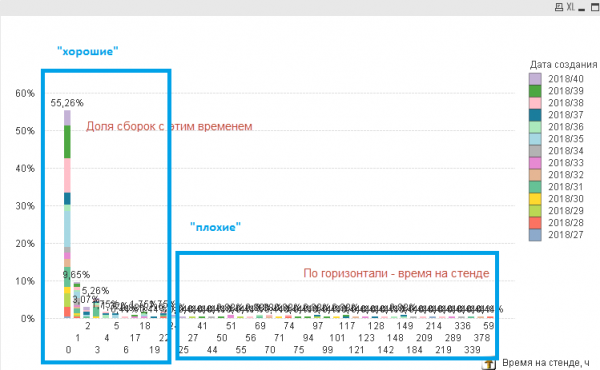
"Cílem systému bude výběr týmů na základě času stráveného na stáncích, tedy výsledkem by měl být seznam týmů s vybraným časem, a ne číslo.
Pokud zjistíme, kolik času bylo celkově stráveno na stánku a kolik času bylo stráveno na prostoje mezi stánky, budeme moci najít týmy, zavolat jim a podrobněji se zabývat příčinami a odstranit je," – pomyslel si Ivan.
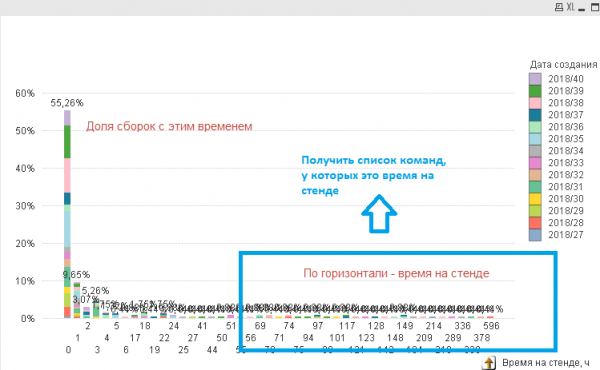
Jak spočítat čas dodání pro DevOps
Pro výpočet bylo potřeba proniknout do procesu DevOps a jeho podstaty.
Ve společnosti se používá omezené množství systémů a informace lze získat pouze z nich a nikde jinde.
Všechny úkoly ve společnosti byly registrovány v Jira. Když byl úkol převzat do práce, vytvořil se pro něj branch a po realizaci byl proveden commit do BitBucketu a Pull Request. Při přijetí PR (Pull Request) se automaticky vytvořil distributiv a uložil do úložiště Nexus.

Dále byl distributiv nasazován na několika stáncích pomocí Jenkins pro ověření správnosti aplikace, automatické a manuální testování:
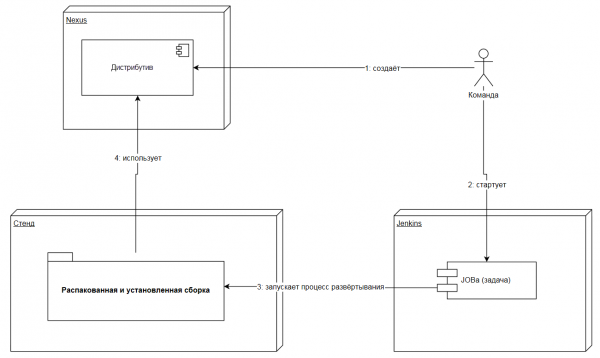
Ivan popsal, z jakých systémů lze vzít jaké informace pro výpočet času na stáncích:
- Z Nexus – Čas vytvoření distributivu a název složky, ve které byl kód týmu.
- Z Jenkins – Čas začátku, délka a výsledek zpracování každého jobu, název stánku (v parametrech jobu), stage (kroky jobu), odkaz na distributiv v Nexus.
- Jira a BitBucket se Ivan rozhodl do pipeline nezahrnovat, protože se více týkaly fáze vývoje, a ne nasazení hotového distributivu na stánky.
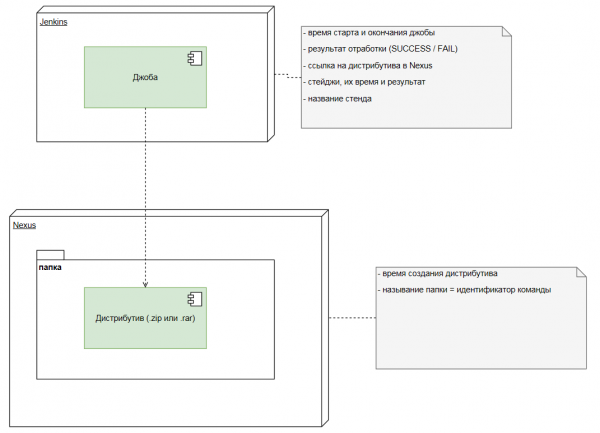
Na základě dostupných informací byla vykreslena následující schéma:
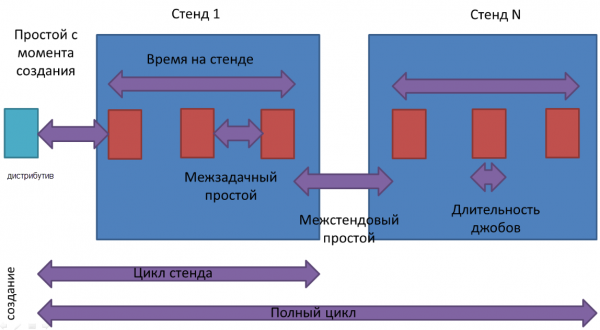
S vědomím toho, kolik času se tráví vytvářením distributivů a kolik času se utrácí na každý z nich, lze snadno spočítat celkové náklady na projití celé pipeline DevOps (celý cyklus).
Zde jsou DevOps metriky, které Ivan nakonec získal:
- Počet vytvořených distributivů
- Podíl distributivů, které "vstoupily" na stánek a "prošly" stánkem
- Čas strávený na stánku (cyklus stánku)
- Úplný cyklus (celkový čas na všech stáncích)
- Délka úloh
- Prostoje mezi stánky
- Prostoje mezi spuštění úloh na jednom stánku
Na jedné straně metriky velmi dobře charakterizovaly DevOps pipeline z hlediska času, na druhé straně byly považovány za velmi jednoduché.
Spokojený s dobře odvedenou prací Ivan připravil prezentaci a šel ji představit vedení.
Zpátky odcházel zamračený a s pokleslýma rukama.
— To je fiasko, kámo — usmál se ironický kolega...
Pokračování čtěte v článku „».
Zdroj: habr.com
