

Ahoj, Habr! Představuji vám autorský překlad článku .
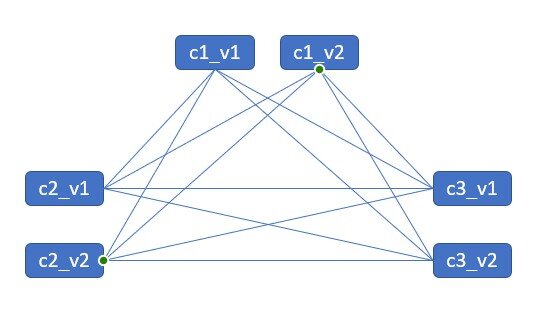
V době, kdy se IT svět postupně přechází na mikroslužby a nástroje jako Kubernetes, se stále více vyplouvá na povrch pouze jedna probléma. Tento problém je verzí mikroslužeb. IT komunita však věří, že současná situace je výrazně lepší než minulá generace technologií. Nicméně, správa verzí mikroslužeb je velmi složitý problém. Jedním z důkazů toho mohou být články jako .
Pokud zatím nerozumíte problému, dovolte mi vysvětlit. Představte si, že váš produkt se skládá z 10 mikroslužeb. Nyní si představte, že pro každou z těchto mikroslužeb vychází 1 nová verze. Pouze 1 verze – doufám, že se všichni shodneme, že to je velmi triviální a nevýznamný fakt. Nyní se však podívejme znovu na náš produkt. Pouze se s jednou novou verzí každé komponenty máme nyní 2^10 – nebo 1024 permutací, jak lze náš produkt sestavit.
Pokud stále zůstává nedorozumění, dovolte mi rozložit matematiku. Takže máme 10 mikroslužeb, z nichž každá dostává jedno aktualizaci. To znamená, že máme 2 možné verze pro každou mikroslužbu (buď starou, nebo novou). Nyní, pro každý z komponentů produktu můžeme použít jakoukoli z těchto dvou verzí. Matematicky je to totéž, jako bychom měli 10místné binární číslo. Například, dejme tomu, že 1 je nová verze a 0 je stará verze – pak jedna možná permutace může být označena jako 1001000000 – kde první a čtvrtý komponent jsou aktualizovány, zatímco všechny ostatní ne. Z matematiky víme, že 10místné binární číslo může mít 2^10 nebo 1024 hodnot. To znamená, že jsme potvrdili rozsah čísla, se kterým se vypořádáváme.
Pokračujeme v úvahách dále — co se stane, pokud budeme mít 100 mikroslužeb a každá z nich bude mít 10 možných verzí? Celá situace se stává velmi nepříjemnou — nyní máme 10^100 permutací — což je obrovské číslo. Přesto bych tuto situaci označil právě tak, protože se nyní schováváme za slovy jako „kubernetes“ a čelíme problému tak, jak je.
Proč mě tato problém tak fascinuje? Zčásti proto, že když jsem dříve pracoval ve světě NLP a AI, hodně jsme diskutovali o problému kombinatorní exploze asi před 5-6 lety. Jen místo verzí jsme měli jednotlivá slova a místo produktů jsme měli věty a odstavce. A i když problémy s NLP a AI zůstávají do značné míry nevyřešeny, je třeba přiznat, že za posledních pár let byl učiněn významný pokrok. (podle mě, pokrok by mohl být větší,okdyby lidé v oboru věnovali trochu méně pozornosti strojovému učení a o něco více jiným technikám — ale to už je mimo téma).
Vrátím se do světa DevOps a mikroslužeb. Před námi leží obrovský problém, skrývající se jako slon v Kunstkammeru — protože co často slyším — „prostě si vezmi kubernetes a helm, a všechno bude v pořádku!“ Ale ne, nic nebude v pořádku, pokud všechno necháme tak, jak je. Navíc analytické řešení tohoto problému se zdá být nepraktické kvůli jeho složitosti. Podobně jako u NLP, měli bychom nejprve přistoupit k tomuto problému zúžením vyhledávací oblasti — v tomto případě vyloučením zastaralých permutací.
Jedna z věcí, která může pomoci — psal jsem minulý rok Také je důležité poznamenat, že dobře navržený proces CI/CD velmi pomáhá při snižování variací. Nicméně, současná situace s CI/CD není dostatečně dobrá pro řešení problému permutací bez dalšího nástroje pro sledování a evidenci komponentů.
Co potřebujeme — je systém experimentů ve fázi integrace, kde bychom mohli určit faktor rizika pro každou komponentu, a také mít automatizovaný proces aktualizace různých komponent a testování bez zásahu operátora — abychom viděli, co funguje, a co ne.
Takový systém experimentů by mohl vypadat následovně:
- Vývojáři píší testy (to je kritická etapa – protože jinak nemáme žádný hodnotící kritérium – to je jakéhosi označování dat v strojovém učení).
- Každá komponenta (projekt) dostává svůj vlastní CI systém – tento proces je dnes dobře propracován, a otázka vytvoření CI systému pro jednotnou komponentu je většinou vyřešena.
- „Chytrý integrační systém“ shromažďuje výsledky různých CI systémů a spojuje projekty-komponenty do finálního produktu, spouští testování a nakonec vypočítává nejkratší cestu k dosažení potřebné funkčnosti produktu na základě existujících komponentů a faktorů rizika. Pokud aktualizaci není možné provést, tento systém upozorní vývojáře na existující komponenty a na které z nich dochází k chybě. Ještě jednou zdůrazňuji, že testovací systém zde má kritický význam – jelikož integrační systém používá testy jako hodnotící kritérium.
- CD systém, který pak získává data z „Chytrého integračního systému“ a provádí přímo aktualizaci. Tato fáze uzavírá cyklus.
Závěrem, pro mě jedna z největších problémů nyní je absenci takového „Chytrého integračního systému“, který by spojoval různé komponenty do produktu a tím umožnil sledovat, jakým způsobem je produkt celkově složen. Zajímaly by mě myšlenky komunity na toto téma (spojler – nyní pracuji na projektu , který by se mohl stát takovým chytrým integračním systémem).
Jedna poslední věc, kterou chci zmínit, – pro mě monolit není přijatelný pro jakýkoliv projekt alespoň střední velikosti. S velkým skepticismem nahlížím na pokusy urychlit čas realizace a kvalitu vývoje tím, že se vracíme k monolitu. Za prvé, monolit má podobný problém správy komponentů – mezi různými knihovnami, ze kterých se skládá, přičemž to není tak nápadné a projevuje se především ve času, který vývojáři stráví. Důsledkem problému monolitu je faktická nemožnost provádět změny v kódu – a extrémně pomalá rychlost vývoje.
Mikroslužby zlepšují situaci, avšak poté se mikroslužbová architektura potýká s problémem kombinatorní exploze ve fázi integrace. Ano, v podstatě jsme posunuli stejný problém — z fáze vývoje na fázi integrace. Nicméně, podle mého názoru, přístup mikroslužeb přece jen vede k lepším výsledkům a týmy dosahují výsledků rychleji (pravděpodobně především díky zmenšení velikosti vývojové jednotky — nebo batch size). Avšak přechod od monolitu k mikroslužbám zatím nepřinesl dostatečné zlepšení procesu — kombinatorní exploze verzí mikroslužeb je obrovský problém a máme velký potenciál situaci zlepšit, jakmile ji začneme řešit.
Zdroj: habr.com
