

19. září v Moskvě první tematické setkání HUG (Highload++ User Group), které bylo věnováno mikroservisům. Na něm byla prezentována přednáška „Provoz mikroservisů: velikost má význam, i když máte Kubernetes“, ve které jsme sdíleli rozsáhlé zkušenosti společnosti „Flant“ v oblasti provozu projektů s mikroservisní architekturou. Především bude užitečná všem vývojářům, kteří uvažují o využití tohoto přístupu ve svém současném nebo budoucím projektu.
Představujeme (50 minut, daleko informativnější než článek), stejně jako hlavní shrnutí v textové podobě.
NB: Video a prezentace jsou také dostupné na konci této publikace.
Úvod
Obvykle má dobrý příběh začátek, hlavní děj a vyvrcholení. Tato přednáška spíše připomíná začátek, a to tragický. Důležité je také poznamenat, že v ní je představen pohled na mikroservisy z pohledu provozování.
Začnu tímto grafem, jehož autorem je (v roce 2015) Martin Fowler:
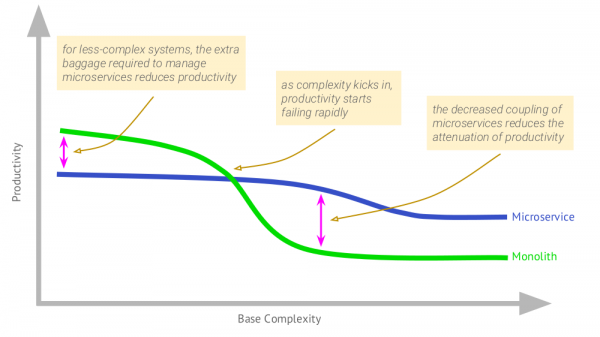
Na něm je vidět, jak v případě monolitní aplikace, která dosáhla určité velikosti, začíná klesat produktivita práce. Mikroservisy se vyznačují tím, že počáteční produktivita je s nimi nižší, ale s rostoucí složitostí klesání efektivity není tak nápadné.
Doplním tento graf pro případ použití Kubernetes:
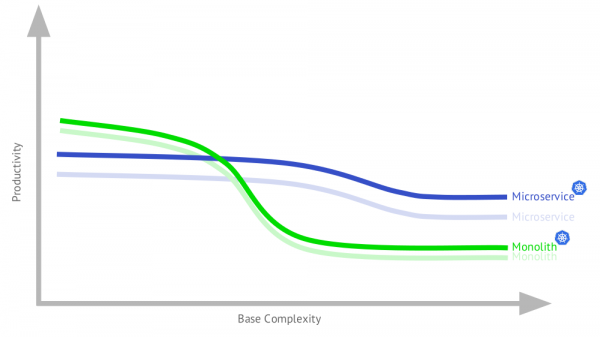
Proč se aplikaci s mikroservisy daří lépe? Protože taková architektura klade vážné požadavky na architekturu, které jsou skvěle pokryty možnostmi Kubernetes. Na druhou stranu, část této funkčnosti bude užitečná i pro monolit, zvláště z důvodu, že typický monolit dneška není zcela monolit (podrobnosti budou dále v přednášce).
Jak je vidět, konečný graf (když jak monolitní, tak mikroservisní aplikace jsou v infrastruktuře s Kubernetes) se od původního příliš neliší. Dále se bude hovořit o aplikacích využívajících Kubernetes.
Užitečná a škodlivá mikroservisnost
A zde je hlavní myšlenka:
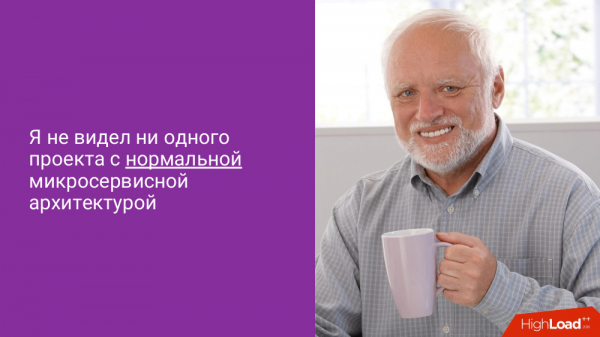
Co je to normální mikroservisní architektura? Měla by vám přinášet skutečný prospěch tím, že zvyšuje efektivitu práce. Pokud se vrátíme k grafu, tak to je ona:
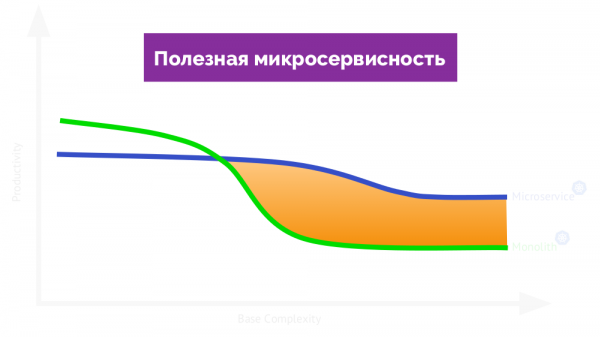
Pokud ji nazvete užitečný, na druhé straně grafu bude škodlivá mikroservisnost (brání práci):
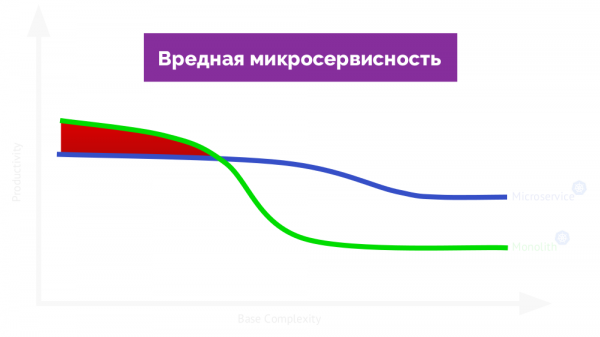
Vrátíme se k „hlavní myšlence“: má smysl vůbec důvěřovat mým zkušenostem? Od začátku tohoto roku jsem se podíval na 85 projektů. Ne všechny byly mikroslužby (takovou architekturou disponovalo přibližně od jedné třetiny do poloviny z nich), ale to je stále velké číslo. Nám (společnosti „Flant“) jako outsourcingové firmě se daří vidět široké spektrum aplikací, které jsou vyvíjeny jak v malých firmách (s 5 vývojáři), tak i ve velkých (~500 vývojářů). Další výhodou je, že vidíme, jak tyto aplikace žijí a vyvíjejí se po mnoho let.
Proč mikroslužby?
Na otázku o přínosu mikroslužeb existuje u již zmíněného Martina Fowlera:
- jasné hranice modularity;
- nezávislé nasazení;
- svoboda výběru technologií.
Mnoho jsem mluvil s architekty a vývojáři softwaru a ptal jsem se, proč potřebují mikroslužby. A sestavil jsem si svůj seznam jejich očekávání. Tady je, co se mi podařilo zjistit:
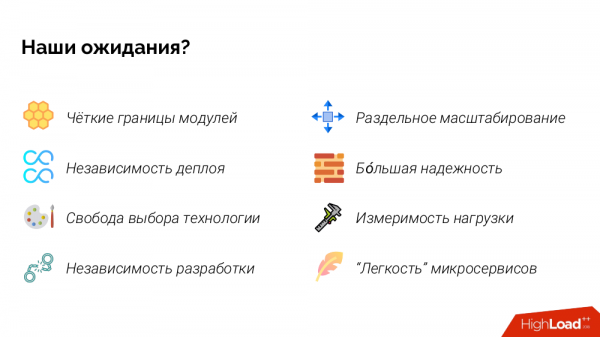
Pokud bych některé z bodů popsal „pocitově“, pak:
- jasné hranice modulů: tady máme děsivý monolit, a nyní vše bude pečlivě rozloženo do Git repozitářů, ve kterých je všechno „na svém místě“, nemíchá se teplé s měkkým;
- nezávislost nasazení: můžeme nasazovat služby nezávisle, abychom urychlili vývoj (současně publikovat nové funkce);
- nezávislost vývoje: tento mikroslužbu můžeme předat jedné týmu/vývojáři, zatímco jiný dostane jinou, díky čemuž můžeme rychleji vyvíjet;
- bovyšší spolehlivost: pokud dojde k částečné degradaci (poklesne jedna mikroslužba z 20), přestane fungovat pouze jedno tlačítko, zatímco systém jako celek bude pokračovat v činnosti.
Typická (škodlivá) architektura mikroslužeb
Abych vysvětlil, proč není realita taková, jakou očekáváme, představím sborný obraz architektury mikroslužeb založený na zkušenostech z mnoha různých projektů.
Příkladem bude abstraktní internetový obchod, který chce soupeřit s Amazonem nebo alespoň OZON. Jeho mikroslužbová architektura vypadá takto:
Z různých důvodů jsou tyto mikroslužby napsány na různých platformách:

Protože každá mikroslužba musí mít autonomii, mnohé z nich potřebují svoji vlastní databázi a cache. Konečná architektura vypadá takto:
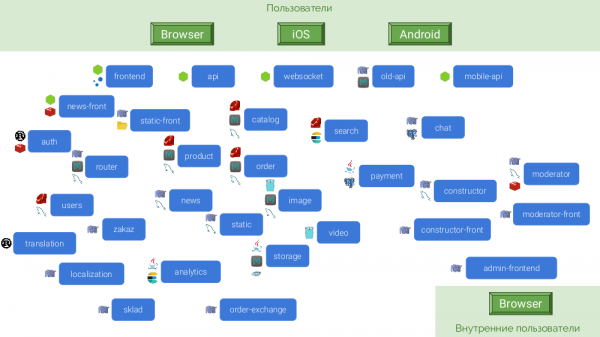
Jaké jsou její důsledky?
Fowler má v tomto ohledu o "útratě" za používání mikroslužeb:
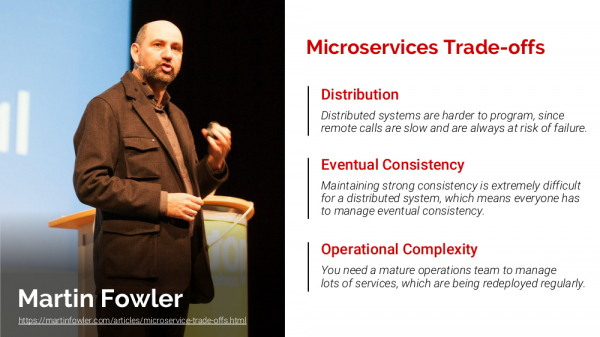
A podíváme se, zda naše očekávání byla naplněna.
Jasné hranice modulů…
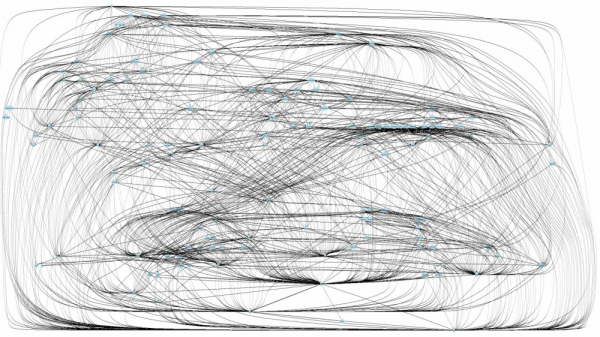
Ale kolik mikroslužeb potřebujeme opravit, abychom nasadili změnu? Můžeme se vůbec vyznat v tom, jak to všechno funguje, bez distribuovaného trasovacího nástroje (vždyť každý požadavek zpracovává polovina mikroslužeb)?
Existuje vzor „", a zde dokonce vznikl distribuovaný lump prohnilosti. Toto je příklad ilustrace toho, jak probíhají požadavky:
Nezávislost nasazení…
Technicky je dosaženo: můžeme nasadit každou mikroslužbu zvlášť. Ale v praxi je třeba mít na paměti, že vždy se nasazuje mnoho mikroslužeb, přičemž musíme zohlednit pořadí jejich nasazení. Oprávněně bychom měli testovat v odděleném okruhu, zda nasazujeme verzi ve správném pořadí.
Svoboda výběru technologie…
Ta existuje. Jen je třeba mít na paměti, že často svoboda hraničí s bezuzdností. Je velmi důležité nevybírat technologie jen proto, abychom si s nimi „hráli“.
Nezávislost vývoje…
Jak vytvořit testovací okruh pro celou aplikaci (z takového množství komponentů)? A navíc je třeba ho udržovat aktuální. Vše to vede k tomu, že skutečný počet testovacích okruhů, které můžeme vůbec udržovat, se ukáže jako minimální.
A co vše to rozběhnout lokálně?.. Ukazuje se, že často vývojář dělá svou práci nezávisle, ale „naslepo“, protože musí čekat, až se uvolní okruh pro testování.
Oddělené škálování…
Ano, ale je omezeno na oblast používaných DBMS. V uvedeném příkladu architektury nebude u Cassandra problém, ale problém budou mít MySQL a PostgreSQL.
Bovětší spolehlivost…
Nehledě na to, že zavinění jednoho mikroslužby často narušuje správnou funkci celého systému, existuje ještě jeden nový problém: udělat každý mikroslužbu odolnou vůči chybám je velmi složité. Protože v mikroslužbách jsou používány různé technologie (memcache, Redis atd.), pro každou je třeba vše promyslet a realizovat, což je pochopitelně možné, ale vyžaduje obrovské zdroje.
Měřitelnost zátěže…
S tím je opravdu vše v pořádku.
„Lehkost“ mikroservisů…
Nejenže se nám objevily obrovské síťové režijní náklady (jak se zvyšují DNS dotazy atd.), ale také kvůli množství poddotazů jsme začali replikovat data (uchovávat cache), což vedlo k významnému objemu úložišť.
A tady je výsledek v souladu s našimi očekáváními:
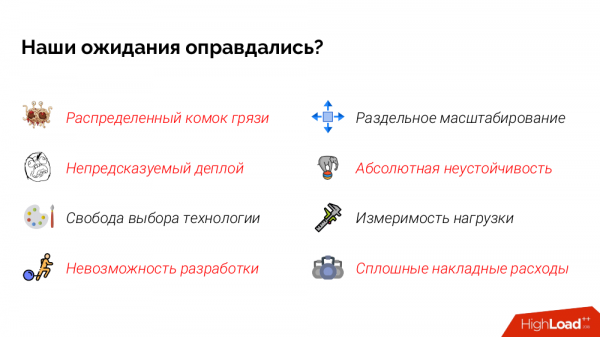
Ale to ještě není vše!
Protože:
- Pravděpodobně budeme potřebovat zpravodajskou sběrnici.
- Jak udělat konzistentní zálohu v požadovaném časovém okamžiku? Jediná skutečná možnost je zastavit provoz pro tuto činnost. Ale jak to udělat na production?
- Pokud jde o podporu několika regionů, organizace robustnosti v každém z nich je velmi pracný úkol.
- Objevuje se problém centralizovaných změn. Například, pokud potřebujeme aktualizovat verzi PHP, bude nutné provést commit v každém repozitáři (a těch je desítky).
- Růst provozní složitosti se zdá být exponenciální.
Co s tím udělat?
Začněte s monolitickou aplikací. Zkušenost Fowlera o tom, že prakticky všechny úspěšné mikroservisní aplikace začínaly jako monolit, který se stal příliš velkým a poté byl rozložen. Zároveň téměř všechny systémy, které byly postaveny jako mikroservisy od začátku, dříve nebo později čelily vážným problémům.
Další cenná myšlenka — aby projekt s mikroservisní architekturou byl úspěšný, musíte velmi dobře znát jak předmět, tak, jak dělat mikroservisy. A nejlepší způsob, jak se naučit předmět, je udělat monolit.
Ale co dělat, pokud jsme už v takové situaci?
První krok k vyřešení jakéhokoli problému — souhlasit s ním a pochopit, že to je problém, že už nechceme trpět.
Pokud v případě přerostlého monolitu (kdy jsme vyčerpali možnosti nakupovat pro něj prostředky) jej rozřezáváme, pak v tomto případě nastává opačný scénář: když nadměrná mikroservisnost už nepomáhá, ale naopak překáží — odstřihněte přebytečné a zhušťujte!
Například pro výše uvedený sběrným obrazem…
Zbavte se nejvíce pochybné mikroservisy:
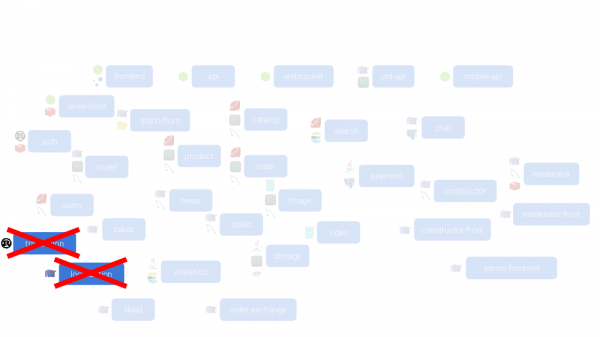
Spojte všechny mikroservisy odpovídající za generování frontend.
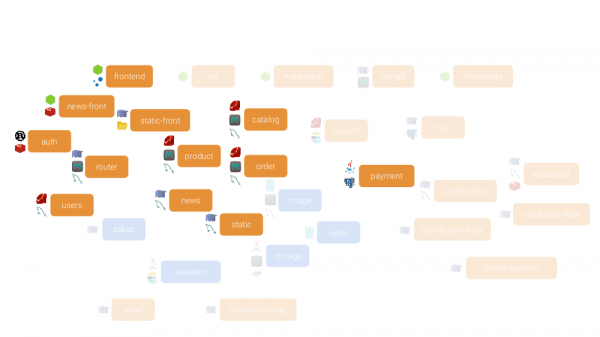
… do jednoho mikroservisu, napsaného v jednom (moderním a normálním, jak si myslíte) jazyce/frameworku:
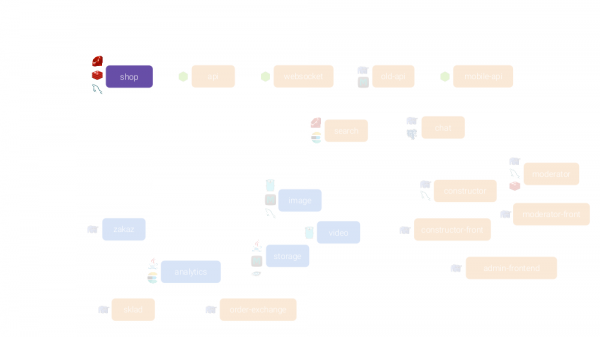
Bude mít jedno ORM (jednu databázi) a ze začátku pár aplikací:
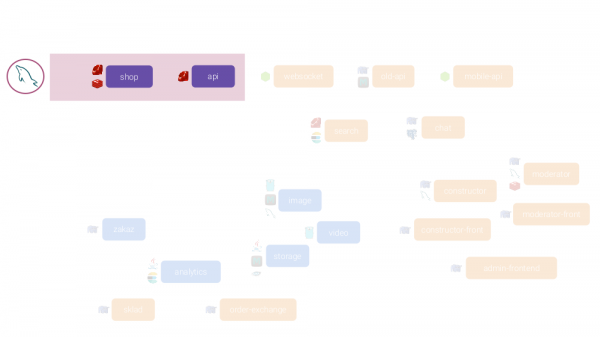
… ale obecně sem můžeme přesunout mnohem více a dosáhnout takových výsledků:
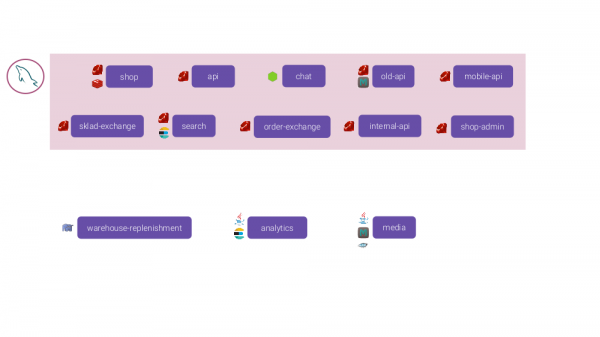
V Kubernetes to všechno spouštíme jako samostatné instance, což znamená, že stále můžeme měřit zátěž a škálovat je jednotlivě.
Shrnuto
Podívejte se na situaci z širší perspektivy. Velmi často všechny tyto problémy s mikroservisy vznikají, protože někdo vzal svůj úkol, ale chtěl „hrát si na mikroservisy“.
V termínu „mikroservisy“ je část „mikro“ nadbytečná.. Jsou „mikro“ jen proto, že jsou menší než ohromný monolit. Ale neměli bychom je považovat za něco malého.
A pro závěrečnou myšlenku se vraťme k původnímu grafu:
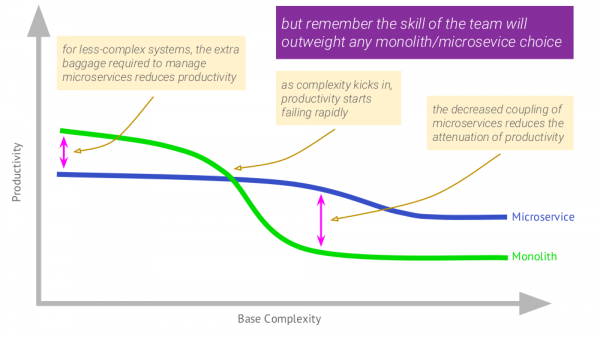
Poznámka k němu (vpravo nahoře) se zúží na to, že dovednosti týmu, který realizuje váš projekt, jsou vždy primární, — právě ony hrají klíčovou roli při vašem rozhodování mezi mikroservisy a monolitem. Pokud týmu chybí dovednosti, ale začne dělat mikroservisy, příběh určitě skončí fatálně.
Video a slajdy
Video z prezentace (~50 minut; bohužel nepřenáší četné emoce návštěvníků, které do značné míry určovaly atmosféru přednášky, ale jak to je):
Prezentace zprávy:
P.S.
Další přednášky na našem blogu:
- «» (Dmitrij Stoljarov; 28. května 2018 na RootConf);
- «» (Dmitrij Stoljarov; 7. listopadu 2017 na HighLoad++);
- «» (Dmitrij Stoljarov; 6. června 2017 na RootConf);
- «» (Dmitrij Stolyarov; 8. listopadu 2016 na HighLoad++);
- «» (Dmitrij Stolyarov; 31. května 2016 na RootConf).
Možná vás také zaujmou následující publikace:
- «»;
- «»;
- «».
Zdroj: habr.com
