

V roce 2018 se v profesionálních kruzích a na tematických konferencích věnovaných AI objevilo pojem MLOps, který se rychle usadil v oboru a nyní se rozvíjí jako samostatný směr. Do budoucna by se MLOps mohl stát jedním z nejžádanějších oblastí v IT. Co to vlastně je a k čemu slouží, zjistíme níže.
Co je MLOps
MLOps (sjednocení technologií a procesů strojového učení a přístupů k implementaci vyvinutých modelů do podnikových procesů) — to je nový způsob spolupráce mezi zástupci podniků, vědci, matematiky, specialisty na strojové učení a IT inženýry při vytváření systémů umělé inteligence.
Jinými slovy, to je způsob, jak proměnit metody a technologie strojového učení na užitečný nástroj pro řešení podnikových úloh.
Je třeba chápat, že řetězec produktivizace začíná dávno před vývojem modelu. Jeho prvním krokem je definování podnikového úkolu, hypotézy o hodnotě, kterou lze z dat získat, a podnikatelského záměru k jejímu použití.
Samo o sobě pojetí MLOps vzniklo jako analogie konceptu DevOps aplikovaného na modely a technologie strojového učení. DevOps — to je přístup k vývoji softwaru, který umožňuje zvýšit rychlost zavádění jednotlivých změn při zachování flexibility a spolehlivosti pomocí řady přístupů, mezi kterými jsou nepřetržitý vývoj, rozdělení funkcí na řadu nezávislých mikroslužeb, automatizované testování a deployment jednotlivých změn, globální monitoring funkčnosti, systém okamžité reakce na zjištěné poruchy a další.
DevOps definoval životní cyklus softwaru a ve společenství odborníků vznikla myšlenka použít stejnou metodiku aplikovanou na velká data. DataOps — pokus o přizpůsobení a rozšíření metodiky s ohledem na zvláštnosti ukládání, přenosu a zpracování velkých objemů dat na různých a vzájemně propojených platformách.
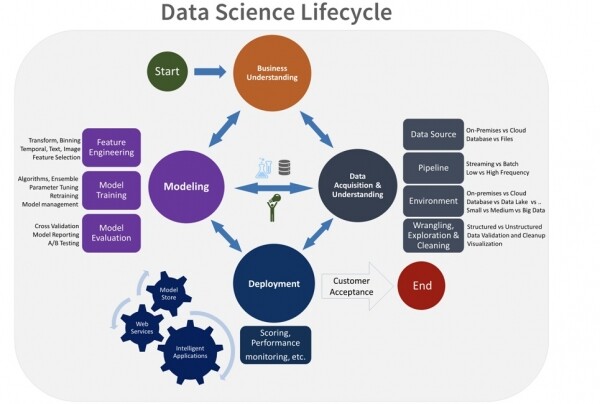
S příchodem určité kritické masy modelů strojového učení implementovaných do obchodních procesů podniků bylo pozorováno silné podobnosti mezi životním cyklem matematických modelů strojového učení a životním cyklem softwaru. Rozdíl spočívá pouze v tom, že algoritmy modelů jsou vytvářeny za pomoci nástrojů a metod strojového učení. Tak vznikla přirozená myšlenka aplikovat a přizpůsobit již známé přístupy k vývoji softwaru pro modely strojového učení. V životním cyklu modelů strojového učení lze proto vyčlenit následující klíčové etapy:
- definice podnikatelské myšlenky;
- vytrénování modelu;
- testování a nasazení modelu do obchodního procesu;
- prevádzkování modelu.
Když se v průběhu provozu objeví potřeba změnit nebo přeškolit model na nových datech, cyklus se spouští znovu — model se vylepšuje, testuje a nasazuje se nová verze.
Odbočka. Proč přeškolit, a ne přetrénovat? Termín "přetrénování modelu" má dvojí výklad: mezi specialisty znamená defekt modelu, když model dobře predikuje, vlastně opakuje predikovaný parametr na tréninkové sadě, ale na externí sadě dat pracuje mnohem hůře. Přirozeně je takový model vadný, protože tento defekt neumožňuje jeho aplikaci.
V tomto životním cyklu se jeví jako logické využití DevOps nástrojů: automatizované testování, nasazení a monitorování, zpracování výpočtů modelů ve formě jednotlivých mikro služeb. Existuje však také řada zvláštností, které brání přímému použití těchto nástrojů bez další ML vazby.
Jak přimět modely pracovat a přinášet zisk
Jako příklad, na kterém demonstrujeme použití přístupu MLOps, vezmeme si klasický úkol automatizace chatu pro podporu bankovního (nebo jiného) produktu. Obvykle proces podpory prostřednictvím chatu vypadá následovně: klient zadává do chatu zprávu s dotazem a dostává odpověď od specialisty v rámci předem definovaného stromu dialogů. Úkol automatizace takového chatu se obvykle řeší pomocí experty definovaných sad pravidel, které jsou velmi pracné na vývoj a údržbu. Efektivita takové automatizace, v závislosti na úrovni složitosti úkolu, může dosáhnout 20–30%. Přirozeně se objevuje myšlenka, že výhodnější je zavedení modulu umělé inteligence — modelu vyvinutého pomocí strojového učení, který:
- je schopen zpracovat bez účasti operátora větší počet dotazů (v závislosti na tématu, v některých případech může efektivita dosáhnout 70–80%);
- lépe se přizpůsobuje nestandardním formulacím v dialogu — umí určit záměr, skutečné přání uživatele podle nejasně formulovaného dotazu;
- dokáže rozpoznat, kdy je odpověď modelu adekvátní a kdy jsou pochybnosti o "uvědomění" této odpovědi a je potřeba položit dodatečnou upřesňující otázku nebo přepnout na operátora;
- může být automatizovaně dosvědčena (místo skupiny vývojářů, kteří neustále přizpůsobují a upravují scénáře odpovědí, model dosvědčuje specialista na Data Science, který využívá příslušné knihovny strojového učení).
Jak dostat takový pokročilý model do chodu?
Stejně jako při řešení jakéhokoli jiného úkolu, než začneme vyvíjet takový modul, je nezbytné určit obchodní proces a formálně popsat konkrétní úkol, který budeme řešit pomocí metody strojového učení. V tomto bodě začíná proces operacionalizace, označovaný zkratkou Ops.
Dalším krokem je, že specialisté datové vědy ve spolupráci s datovými inženýry zkontrolují dostupnost a dostatečnost dat a obchodní hypotézu ohledně životaschopnosti obchodní myšlenky, vyvinou prototyp modelu a ověří jeho skutečnou účinnost. Teprve po potvrzení ze strany podnikání může začít přechod od vývoje modelu k jeho integraci do systémů, které vykonávají konkrétní obchodní proces. Důkladné plánování implementace, hluboké porozumění v každé fázi, jak bude model používán a jaký ekonomický efekt přinese, je klíčovým momentem v procesech implementace přístupů MLOps do technologického prostředí společnosti.
S rozvojem technologií AI se dramaticky zvyšuje množství a rozmanitost úloh, které mohou být řešeny pomocí strojového učení. Každý takový obchodní proces znamená úsporu pro společnost prostřednictvím automatizace práce zaměstnanců ve frontových pozicích (call centrum, kontrola a třídění dokumentů atd.), rozšíření zákaznické základny přidáním nových atraktivních a pohodlných funkcí, úsporu prostředků díky optimálnímu využití a přeorganizaci zdrojů a mnoho dalšího. V konečném důsledku je každý proces zaměřen na vytváření hodnoty a jako důsledek by měl přinášet určitý ekonomický efekt. Zde je velmi důležité jasně formulovat obchodní myšlenku a vypočítat očekávaný zisk z implementace modelu v celkové struktuře vytváření hodnoty společnosti. Stává se, že implementace modelu se neosvědčí a čas, který specialisté na strojové učení věnují, vyjde mnohem dráže než pracovní místo operátora, který tuto úlohu vykonává. Proto je třeba se snažit odhalit takové případy v ranných fázích tvorby systémů AI.
Z toho tedy vyplývá, že model začíná přinášet zisk teprve tehdy, když byla v procesu MLOps správně formulována obchodní úloha, nastaveny priority a v raných fázích vývoje byl formulován proces implementace modelu do systému.
Nový proces – nové výzvy
Komplexní odpověď na zásadní otázku podnikání ohledně toho, jak jsou modely strojového učení aplikovatelné na řešení úkolů, a obecná otázka důvěry v AI — to je jeden z klíčových výzev v procesu rozvoje a implementace přístupů MLOps. Zpočátku podniky skepticky vnímají zavádění strojového učení do procesů — je obtížné spoléhat se na modely na místech, kde dříve obvykle pracovali lidé. Pro podniky se programy jeví jako „černá skříňka“, jejíž relevantnost odpovědí musí být ještě prokázána. Kromě toho existují v bankovní činnosti, v podnikání telekomunikačních operátorů a jinde přísné požadavky státních regulátorů. Všechny systémy a algoritmy, které jsou implementovány v bankovních procesech, podléhají auditu. Abychom tuto úlohu vyřešili a prokázali podnikům a regulátorům oprávněnost a správnost odpovědí umělé inteligence, spolu s modelem jsou implementovány monitoringové nástroje. Dále existuje postup nezávislé validace, který je povinný pro regulované modely a který odpovídá požadavkům centrální banky. Nezávislá expertní skupina provádí audit výsledků získaných modelem s ohledem na vstupní data.
Druhá výzva — hodnocení a zohlednění modelových rizik při zavádění modelu strojového učení. I když ani člověk nemůže stoprocentně jistě odpovědět na otázku, zda bylo to konkrétní šaty bílé nebo modré, má umělá inteligence také právo na chybu. Je také třeba vzít v úvahu, že s časem se data mohou měnit a modely se musí dále školit, aby vydávaly dostatečně přesný výsledek. Aby podnikové procesy neutrpěly, je nutné řídit modelová rizika a sledovat práci modelu, pravidelně jej dále školit na nových datech.
Ale po první fázi nedůvěry začíná přicházet opačný efekt. Čím více modelů je úspěšně implementováno do procesů, tím větší má podnik chuť využívat umělou inteligenci — objevují se nové úkoly, které lze vyřešit metodami strojového učení. Každý úkol spouští celý proces, který vyžaduje různé kompetence:
- datoví inženýři připravují a zpracovávají data;
- datoví vědci aplikují nástroje strojového učení a vyvíjejí model;
- IT zavádějí model do systému;
- ML inženýr určuje, jak správně integrovat tento model do procesu, jaké IT nástroje použít v závislosti na požadavcích na režim aplikace modelu s ohledem na tok požadavků, dobu odezvy atd.
- ML architekt navrhuje, jak fyzicky realizovat softwarový produkt v průmyslovém systému.
Celý cyklus vyžaduje velké množství vysoce kvalifikovaných specialistů. V určitém bodě vývoje a stupně pronikání ML modelů do obchodních procesů se ukazuje, že lineární škálování počtu specialistů úměrně růstu počtu úloh se stává drahým a neefektivním. Proto vyvstává otázka automatizace procesu MLOps - definice několika standardních tříd úloh strojového učení, vývoj typových pipeline pro zpracování dat a dotrenování modelů. V ideálním případě pro řešení takových úloh potřebujeme profesionály, kteří ovládají kompetence na pomezí Big Data, Data Science, DevOps a IT. Proto je největším problémem v oboru Data Science a největší výzvou při organizaci procesů MLOps nedostatek takových kompetencí na stávajícím trhu pracovních sil. Specialisté splňující takové požadavky jsou v současnosti na trhu práce ojedinělí a mají cenu zlata.
K otázce kompetencí
V teorii lze všechny úlohy MLOps řešit klasickými nástroji DevOps a neuchylovat se k specializovanému rozšíření rolové modelu. Jak jsme již uvedli výše, data scientist musí být nejen matematikem a specialistou na analýzu dat, ale i guru celého pipeline – na jeho bedrech leží vývoj architektury, programování modelů v několika jazycích v závislosti na architektuře, příprava datové vitríny a nasazení samotné aplikace. Nicméně vytváření technologického rámce, realizovaného v kondenzačním procesu MLOps, zabírá až 80% pracovních zdrojů, což znamená, že kvalifikovaný matematik, kterým je kvalitní Data Scientist, bude pouze 20% času věnovat své specializaci. Proto se oddělení rolí specialistů, kteří realizují proces zavádění modelů strojového učení, stává životně důležitým.
Jak podrobně by měly být role rozděleny, závisí na velikosti podniku. Je jiná situace, když ve startupu pracuje jeden odborník, který je sám sobě inženýrem, architektem a DevOps specialistou. Naproti tomu, v rámci velkého podniku jsou všechny procesy vývoje modelů soustředěny na několik vysoce kvalifikovaných odborníků na Data Science, zatímco programátor či odborník na databáze — o něco běžnější a levnější kompetence na trhu práce — si může vzít na starost většinu rutinních úkolů.
Od toho, kde leží hranice při výběru specialistů pro zajištění procesu MLOps a jak je organizován proces operacionalizace vyvíjených modelů, přímo závisí rychlost a kvalita vyvinutých modelů, produktivita týmu a mikroklima v něm.
Co už nyní udělala naše tým
Nedávno jsme začali budovat strukturu kompetencí a procesy MLOps. Přesto už nyní jsou naše projekty pro správu životního cyklu modelů a aplikaci modelů jako služby ve fázi testování MVP.
Také jsme určili optimální strukturu kompetencí a organizační strukturu interakce mezi všemi účastníky procesu pro velký podnik. Byly organizovány týmy Agile, které řeší úkoly pro celý spektrum obchodních zákazníků, a byl zajištěn proces interakce s projektovými týmy pro vytváření platforem a infrastruktury, která je základem budované MLOps struktury.
Otázky pro budoucnost
MLOps je rozvíjející se oblast, která trpí nedostatkem kompetencí a v budoucnu bude nabírat na obrátkách. V tuto chvíli je nejlepší vycházet z poznatků a praktik DevOps. Hlavním cílem MLOps je efektivnější využití ML modelů pro řešení obchodních úkolů. Při tom však vyvstává řada otázek:
- Jak zkrátit čas potřebný k uvedení modelů do produkce?
- Jak snížit byrokratické tření mezi týmy různých kompetencí a zvýšit zaměření na spolupráci?
- Jak sledovat modely, spravovat verze a organizovat efektivní monitoring?
- Jak vytvořit skutečně cyklický životní cyklus pro moderní ML model?
- Jak standardizovat proces strojového učení?
Odpovědi na tyto otázky do značné míry určí, jak rychle MLOps naplní svůj potenciál.
Zdroj: habr.com
