

Úvod
Nějakou dobu zpět jsem dostal úkol vyvinout vysoce dostupný klastr pro , fungující ve více datových centrech, propojených optickými vlákny v rámci jednoho města, a schopný odolat výpadku (například výpadku napájení) jednoho datového centra. Jako software, který zajišťuje vysokou dostupnost, jsem zvolil , protože je to oficiální řešení od RedHat pro vytváření vysoce dostupných klastrů. Je výhodné, že RedHat zajišťuje jeho podporu, a že toto řešení je univerzální (modulární). S jeho pomocí je možné zajistit vysokou dostupnost nejen pro PostgreSQL, ale i pro další služby, buď pomocí standardních modulů, nebo jejich vytvořením na míru.
K tomu se objevila rozumná otázka: jak moc bude vysoce dostupný klastr skutečně odolný? Abych to prozkoumal, vytvořil jsem testovací stanici, která simuluje různé výpadky na uzlech klastru, čeká na obnovení funkčnosti, obnovuje selhávající uzel a pokračuje v testování v cyklu. Tento projekt byl původně nazván hapgsql, ale časem mě omrzelo jméno, které má jen jednu samohlásku. Proto jsem začal nazývat vysoce dostupné databáze (a float IP, které na ně ukazují) krogan (postava z počítačové hry, jejíž všechny důležité orgány jsou replikovány), a uzly, klastry a samotný projekt — tuchanka (planeta, kde žijí krogani).
Nyní vedení povolilo . README bude brzy přeloženo do angličtiny (protože se očekává, že hlavními uživateli budou vývojáři Pacemaker a PostgreSQL), a starou ruskou verzi README jsem se rozhodl zpracovat (částečně) ve formě tohoto článku.
Klastury se implementují na virtuálních strojích . Celkem bude nasazeno 12 virtuálních strojů (celkem 36GiB), které tvoří 4 vysoce dostupné klastry (různé varianty). První dva klastry se skládají ze dvou serverů PostgreSQL, které jsou umístěny v různých datových centrech, a jednoho společného serveru witness s quorum device (umístěného na levném virtuálním stroji ve třetím datovém centru), který řeší neurčitost 50%/50%, dává svůj hlas jedné ze stran. Třetí klastr je ve třech datových centrech: jeden master, dva slave, bez quorum device. Čtvrtý klastr se skládá ze čtyř serverů PostgreSQL, po dvou v datacentru: jeden master a ostatní repliky, a také používá witness s quorum device. Čtvrtý zvládne selhání dvou serverů nebo jednoho datacentra. Toto řešení může být v případě potřeby škálováno na větší počet replik.
Služba přesného času také je přeconfugurován pro odolnost, ale používá metodu takzvaného ntpd (orphan mode). Hlavní server witness plní roli centrálního NTP serveru, který rozdává svůj čas všem klastrům a tím synchronizuje všechny servery mezi sebou. Pokud witness se porouchá nebo bude izolován, jeden z serverů klastru začne distribuovat svůj čas (uvnitř klastru). Pomocný cachingový HTTP proxy také je nasazen na witness, pomocí něhož mají ostatní virtuální stroje přístup k Yum repozitářům. Ve skutečnosti budou takové služby, jako přesný čas a proxy, pravděpodobně umístěny na vyhrazených serverech, zatímco v testovacím prostředí jsou umístěny na witness pouze pro úsporu počtu virtuálních strojů a místa.
Verze
v0. Funguje s CentOS 7 a PostgreSQL 11 na VirtualBox 6.1.
Struktura klastrů
Všechny klastry jsou určeny pro umístění v několika datacentrech, spojeny do jedné ploché sítě a měly by odolávat selhání nebo síťové izolaci jednoho datacentra. Proto nemožné je nutné použít pro ochranu před split-brain standardní technologii Pacemaker, která se nazývá STONITH (Shoot The Other Node In The Head) nebo fencing. Její podstata: pokud uzly v klastru začnou mít podezření, že s nějakým uzlem je něco v nepořádku, neodpovídá nebo se chová nesprávně, vynutí si jeho odpojení pomocí "vnějších" zařízení, jako například řídicí karta IPMI nebo UPS. Ale to bude fungovat pouze v případech, kdy při jednostranném selhání serveru IPMI nebo UPS nadále fungují. Zde je plánována ochrana proti mnohem katastrofálnějšímu selhání, kdy selže (například se odpojí od proudu) celé datacentrum. A při takovém selhání všechna stonith-zařízení (IPMI, UPS atd.) také nebudou fungovat.
Místo toho je základem systému myšlenka kvóra. Všechny uzly mají hlas a pracovat mohou pouze ty, které vidí více než polovinu všech uzlů. Toto množství "polovina + 1" se nazývá kvórum. Pokud kvórum není dosaženo, uzel rozhodne, že se nachází v síťové izolaci a musí odpojit své zdroje, tj. to je taková ochrana před split-brain. Pokud software, který za takové chování odpovídá, nefunguje, měl by se spustit watchdog, například na bázi IPMI.
Pokud je počet uzlů sudý (klastr ve dvou datových centrech), může nastat takzvaná neurčitost 50%/50% (padesát na padesát), kdy síťová izolace dělí klastr přesně na polovinu. Proto se pro sudý počet uzlů přidává quorum device — nenáročný démon, který může být spuštěn na nejlevnějším virtuálním stroji ve třetím datovém centru. Dává svůj hlas jednomu ze segmentů (který vidí), a tím rozřeší neurčitost 50%/50%. Server, na kterém bude spuštěn quorum device, jsem nazval witness (terminologie z repmgr, líbí se mi).
Zdroje mohou přecházet z místa na místo, například z nefunkčních serverů na funkční, nebo na příkaz administrátorů. Aby klienti věděli, kde se nacházejí potřebné zdroje (kam se připojit?), používají se plovoucí IP (float IP). To jsou IP, které Pacemaker může přesouvat mezi uzly (všechno se nachází v ploché síti). Každá z nich symbolizuje zdroj (službu) a bude se nacházet tam, kam je třeba se připojit, abyste získali přístup k této službě (v našem případě k DB).
Tuchanka1 (schéma s těsněním)
Struktura
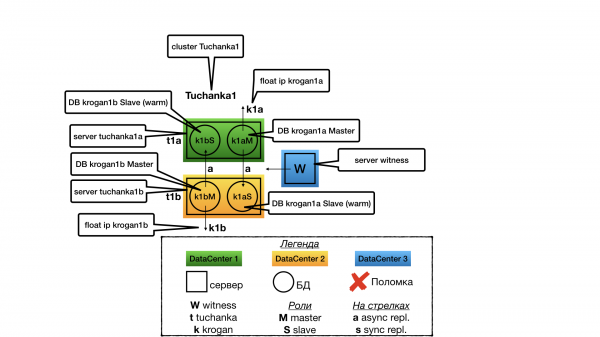
Myšlenka byla v tom, že máme mnoho malých databází s nízkou zátěží, pro které není výhodné udržovat vyhrazený slave server v režimu hot standby pro read only transakce (není třeba takového plýtvání zdroji).
V každém datovém centru je jeden server. Na každém serveru jsou dvě instance PostgreSQL (v terminologii PostgreSQL se nazývají klastr, ale abych předešel záměně, budu je nazývat instancemi (podobně jako u dalších DB), a klastr označím pouze pro klastry Pacemaker). Jedna instance funguje v režimu master a pouze ona poskytuje služby (pouze na ní směřuje float IP). Druhá instance funguje jako slave pro druhé datové centrum a služby poskytne pouze tehdy, pokud její master selže. Protože většinu času poskytuje služby (provádí dotazy) pouze jedna z obou instancí (master), jsou všechny zdroje serveru optimalizovány na master (vyčleňuje se paměť pro cache shared_buffers atd.), ale tak, aby i na druhou instanci zbývalo dostatek zdrojů (i pro suboptimální funkci přes cache souborového systému) pro případ selhání jednoho z datových center. Slave neposkytuje služby (neprovádí read only dotazy) při normálním chodu klastru, aby nedocházelo k boji o zdroje s masterem na téže mašině.
V případě dvou uzlů je dostupnost možná pouze při asynchronní replikaci, protože při synchronní selhání slava dojde k zastavení mastera.
Selhání witness
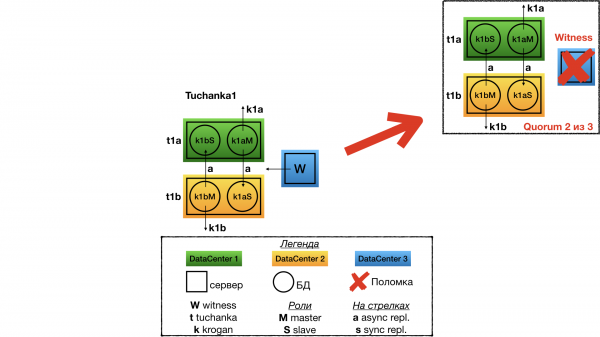
Selhání witness (quorum device) se budu zabývat pouze u klastru Tuchanka1, u všech ostatních bude stejný příběh. Při selhání witness ve struktuře klastru se nic nezmění, všechno bude fungovat tak, jak fungovalo. Ale kvorum se stane 2 z 3, a proto jakékoliv další selhání se stane fatální pro klastr. Budeme muset urgentně opravit.
Selhání Tuchanka1
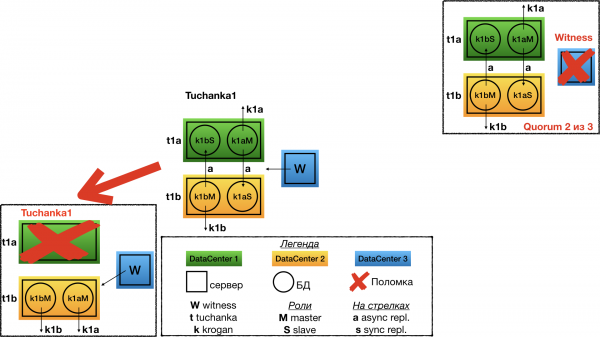
Selhání jednoho z datových center pro Tuchanka1. V tomto případě witness dodává svůj hlas druhému uzlu ve druhém datovém centru. Tam se bývalý slave mění na mastera, takže na jednom serveru pracují oba masterové a na ně směřují oba jejich float IP.
Tuchanka2 (klasická)
Struktura
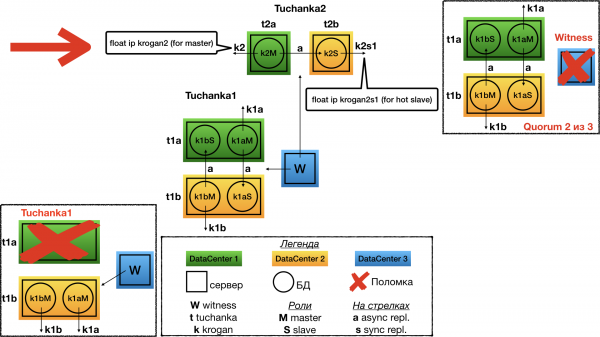
Klasické schéma ze dvou uzlů. Na jednom běží master, na druhém slave. Oba mohou provádět dotazy (slave pouze read only), proto na obou směřují float IP: krogan2 — na mastera, krogan2s1 — na slava. Dostupnost bude jak u mastera, tak u slava.
V případě dvou uzlů je dostupnost možná pouze při asynchronní replikaci, protože při synchronní selhání slava dojde k zastavení mastera.
Selhání Tuchanka2
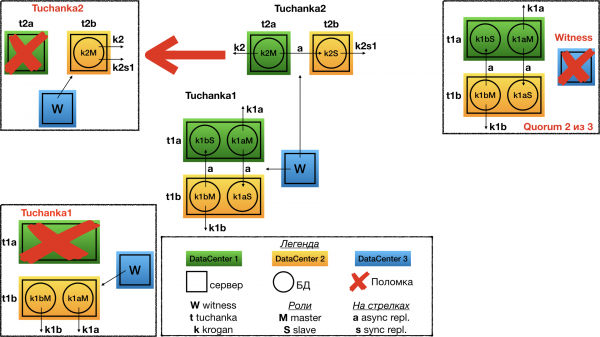
Při selhání jednoho z datových center witness hlasuje pro druhý. Na jediném funkčním datovém centru bude spuštěn master a na něj budou ukazovat oba float IP: master a slave. Samozřejmě, instance musí být nakonfigurována tak, aby měla dostatek zdrojů (limitů připojení atd.) pro současné zpracování všech připojení a požadavků jak od master, tak od slave float IP. To znamená, že při normálním fungování by měla mít dostatečnou rezervu limitů.
Tuchanka4 (mnoho otroků)
Struktura
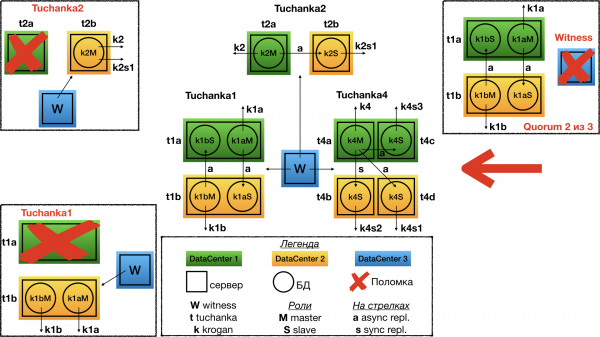
Už jiný extrém. Existují DB, na které směřuje velmi mnoho read-only dotazů (typický případ vysoce zatížené stránky). Tuchanka4 — to je situace, kdy může být tři nebo více otroků pro zpracování takových dotazů, ale přesto ne příliš mnoho. Při velmi velkém počtu otroků bude třeba vymyslet hierarchický systém replikace. V minimálním případě (na obrázku) se v každém ze dvou datových center nachází dva servery, na každém z nich s jednou instancí PostgreSQL.
Další zvláštností tohoto schématu je, že zde již můžeme zorganizovat jednu synchronní replikaci. Je nastavena tak, aby replikovala, pokud možno, do jiného datového centra a ne na replikaci ve stejném datovém centru, kde je i master. Na master a na každý slave ukazuje float IP. Oprávněně, mezi otroky bude třeba provádět vyvažování dotazů nějakým sql proxy, například, na straně klienta. Různému typu klientů může být potřeba různý typ sql proxy, a pouze vývojáři klientů vědí, kdo jaký potřebuje. Tato funkčnost může být realizována jak externím démonem, tak knihovnou klienta (connection pool), atd. Vše toto přesahuje rámec tématu dostupného databázového clustera (dostupnost SQL proxy bude možné realizovat nezávisle, spolu s dostupností klienta).
Selhání Tuchanka4
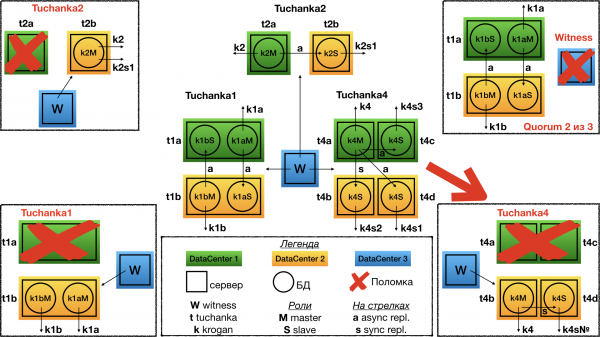
Při selhání jednoho datového centra (tj. dvou serverů) svědek hlasuje pro druhý. V důsledku toho ve druhém datovém centru pracují dva servery: na jednom běží master, a na něj ukazuje master float IP (pro příjem read-write dotazů); a na druhém serveru běží slave se synchronní replikací, a na něj ukazuje jeden z otrockých float IP (pro read-only dotazy).
První, co je třeba poznamenat: pracovní otrocký float IP nebude pro všechny, ale pouze pro jeden. A pro správnou funkci s ním bude třeba, aby sql proxy přesměroval všechny požadavky na jedinou zbývající float IP; a pokud sql proxy ne, je možné uvést všechny float IP slave oddělené čárkou v URL pro připojení. V takovém případě bude libpq připojení provedeno k prvnímu pracovním IP, jak je to nastaveno v systému automatického testování. Možná, že v jiných knihovnách, jako je JDBC, to tak fungovat nebude a bude potřebné sql proxy. Je to tak uděláno, protože pro slave float IP je nastavena prohibice na současné zvýšení na jednom serveru, aby se rovnoměrně rozložily na slave servery, pokud jich pracuje několik.
Druhé: i v případě selhání datacentra bude zachována synchronní replikace. A i když dojde ke sekundárnímu selhání, tedy když v zbývajícím datacentru selže jeden ze dvou serverů, cluster sice přestane poskytovat služby, ale i tak si uchová informace o všech potvrzených transakcích, na které poskytl potvrzení o commitu (nebude docházet ke ztrátě informací při sekundárním selhání).
Tuchanka3 (3 datacentra)
Struktura
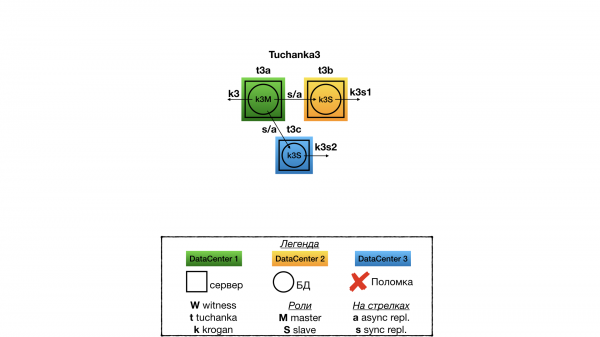
To je cluster pro situaci, kdy jsou tři plně fungující datacentra, v každém z nichž je plně funkční databázový server. V tomto případě quorum device není potřeba. V jednom datacentru pracuje master, v dvou dalších — slaves. Replikace je synchronní, typu ANY (slave1, slave2), tedy klientovi přijde potvrzení commitu, když jakýkoli ze slave prvních odpoví, že přijal commit. Na zdroje ukazuje jeden float IP pro mastera a dva pro slaves. Na rozdíl od Tuchanka4 jsou všechny tři float IP odolné vůči výpadkům. Pro vyvažování read-only SQL dotazů lze použít sql proxy (s individuální odolností vůči výpadkům), nebo první polovině klientů přidělit jeden slave float IP a druhé polovině — druhý.
Selhání Tuchanka3
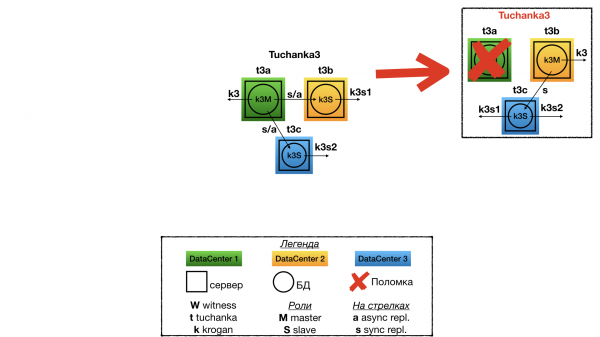
Při selhání jednoho datacentra zůstanou dvě. V jednom je master a float IP od mastera, ve druhém — slave a oba slave float IP (na instance musí být dvojnásobek zdrojů, aby přijal všechna připojení z obou slave float IP). Mezi masterem a slaven probíhá synchronní replikace. Také cluster uchová informace o potvrzených a schválených transakcích (nebude docházet ke ztrátě informací) v případě zničení dvou datacenter (pokud nebyla zničena současně).
Podrobný popis souborové struktury a nasazení jsem se rozhodl nezahrnout. Kdo se chce zabývat detaily, může si to přečíst v README. Uvádím pouze popis automatického testování.
Systém automatického testování
Pro ověření odolnosti klastrů s simulací různých poruch byl vytvořen systém automatického testování. Spouští se skriptem test/failure. Skript může přijímat jako parametry čísla klastrů, které chcete testovat. Například tento příkaz:
test/failure 2 3bude testovat pouze druhý a třetí klastr. Pokud parametry nejsou uvedeny, budou testovány všechny klastry. Všechny klastry se testují paralelně a výsledek se zobrazuje na panelu tmux. Tmux používá vyhrazený tmux server, takže skript lze spustit z běžného tmux, což vytvoří vnořený tmux. Doporučuji používat terminál v širokém okně a s malým písmem. Před zahájením testování se všechny virtuální stroje vrátí na snímek na okamžik dokončení skriptu. setup.
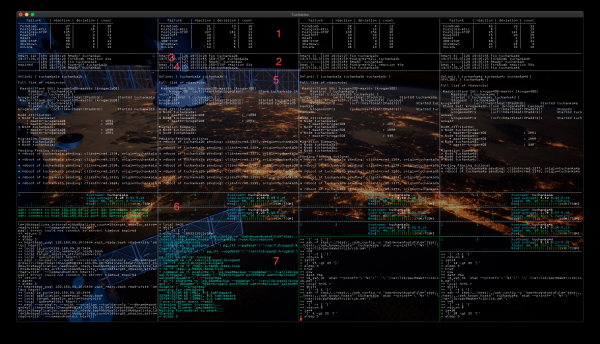
Terminál je rozdělen na sloupce podle počtu testovaných klastrů, defaultně (na screenshotu) jich je čtyřicet. Obsah sloupců popíšu na příkladu Tuchanka2. Panely na screenshotu jsou očíslovány:
- Zde se zobrazuje statistika testů. Sloupce:
- failure — název testu (funkce ve skriptu), který simuluje poruchu.
- reaction — průměrná doba v sekundách, za kterou klastr obnovil svou funkčnost. Měřeno od začátku běhu skriptu, který simuluje poruchu, až do okamžiku, kdy klastr obnovuje svou funkčnost a je schopen pokračovat v poskytování služeb. Pokud je čas velmi krátký, například šest sekund (to se stává u klastrů s několika otroky (Tuchanka3 a Tuchanka4)), znamená to, že porucha byla na asynchronním otroku a nijak neovlivnila funkčnost, nebyly žádné přepínání stavu klastru.
- deviation — ukazuje rozptyl (přesnost) hodnoty reaction metodou „standardní odchylka“.
- count — kolikrát byl tento test proveden.
- Krátký deník umožňuje posoudit, čemu se klastr v aktuálním okamžiku věnuje. Zobrazuje číslo iterace (testu), časovou značku a název operace. Příliš dlouhé provádění (> 5 minut) naznačuje nějaký problém.
- heart (srdce) — aktuální čas. Pro vizuální hodnocení funkčnosti mistři do jeho tabulky se neustále zapisuje aktuální čas s použitím float IP mistra. V případě úspěchu se výsledek zobrazuje v této panelu.
- beat (pulz) — „aktuální čas“, který byl dříve zaznamenán skriptem heart do mistra, nyní se čte z otrok přes jeho float IP. Umožňuje vizuálně hodnotit funkčnost otroka a replikace. V Tuchanka1 nejsou otroci s float IP (žádní otroci neposkytující služby), ale jsou tam dvě instance (DB), proto zde nebude zobrazováno beat, a heart druhé instance.
- Monitorování stavu clusteru pomocí utilitky
pcs mon. Zobrazuje strukturu, rozložení zdrojů mezi uzly a další užitečné informace. - Zde se zobrazuje systémové monitorování z každé virtuálky clusteru. Takových panelů může být více — kolik virtuálek je v clusteru. Dva grafy Zátěž CPU (ve virtuálkách jsou dva procesory), název virtuálky, Zátěž systému (pojmenováno jako Load Average, protože je průměrováno za 5, 10 a 15 minut), data dle procesů a rozložení paměti.
- Sledování skriptu provádějícího testování. V případě závady — náhlého přerušení činnosti nebo nekonečné čekací smyčky — zde bude možné vidět příčinu takového chování.
Testování probíhá ve dvou fázích. Nejprve skript prochází všemi variantami testů, náhodně vybírá virtuálku, na kterou se tento test aplikuje. Poté se provádí nekonečná smyčka testování, virtuálky a závada jsou každýkrát vybírány náhodně. Náhlé ukončení testovacího skriptu (dolní panel) nebo nekonečná smyčka čekání na cokoliv (> 5 minut doba trvání jedné operace, to je vidět v trasování) říká, že nějaký z testů na tomto clusteru selhal.
Každý test se skládá z následujících operací:
- Spuštění funkce, která simuluje závadu.
- Připraven? — čeká na obnovení funkčnosti clusteru (když se poskytují všechny služby).
- Zobrazuje se doba čekání na obnovení clusteru (reaction).
- Opravit — cluster se "oprava". Po čem by měl vrátit se do plně funkčního stavu a připravenosti na další závadu.
Zde je seznam testů s popisem, co dělají:
- ForkBomb: vytváří "Out of memory" pomocí fork-bomby.
- OutOfSpace: zaplní disk. Test je spíše symbolický, vzhledem k minimálnímu zatížení, které vzniká během testování. Při zaplnění disku obvykle nedochází k selhání PostgreSQL.
- Postgres-KILL: zabije PostgreSQL příkazem
killall -KILL postgres. - Postgres-STOP: pozastaví PostgreSQL příkazem
killall -STOP postgres. - PowerOff: „vypíná“ virtuální stroj příkazem
VBoxManage controlvm "virtuální_stroj" poweroff. - Reset: restartuje virtuální stroj příkazem
VBoxManage controlvm "virtuální_stroj" reset. - SBD-STOP: pozastaví démon SBD příkazem
killall -STOP sbd. - ShutDown: pošle na virtuální stroj příkaz přes SSH
systemctl poweroff, systém správně ukončuje provoz. - UnLink: síťová izolace, příkaz
VBoxManage controlvm "virtuální_stroj" setlinkstate1 off.
Ukončení testování buď pomocí standardního příkazu tmux "kill-window" Ctrl-b &, nebo pomocí příkazu "detach-client" Ctrl-b d: přičemž testování končí, tmux se uzavírá, virtuální stroje se vypínají.
Problémy zjištěné během testování
V současné době démon watchdog sbd provádí zastavení sledovaných démonů, ale ne jejich zamrznutí. A následkem toho nedochází k správné reakci na poruchy, které vedou k zamrznutí pouze Corosync a Pacemaker, ale aniž by došlo k pozastavení sbd. Pro ověření Corosync již existuje , přijatý do větve master. Slíbili (v PR#83), že pro Pacemaker bude něco podobného, doufám, že k RedHat 8 to udělají. Ale takové „poruchy“ jsou hypotetické, snadno se imitují uměle pomocí například
killall -STOP corosync, ale nikdy se nevyskytují ve skutečném životě.V Pacemaker verzi pro CentOS 7 je špatně nastaven sync_timeout u quorum device, v důsledku čehož , na který měl přejít master. Opravil se zvýšením sync_timeout u quorum device během nasazení (ve skriptu
setup/setup1). Tato oprava nebyla akceptována vývojáři Pacemaker, místo toho slíbili přepracovat infrastrukturu tak, aby byl tento časový limit automaticky vypočítáván.Pokud je při konfiguraci databáze uvedeno, že v
LC_MESSAGES(textové zprávy) může být použit Unicode, například,ru_RU.UTF-8, pak při spuštění Postgres v prostředí, kde locale není UTF-8, dejme tomu, v prázdném prostředí (zde pacemaker+pgsqlms(paf) spouští Postgres), pak Vývojáři PostgreSQL se nikdy nedohodli, co s tímto dělat. Řeší se to, je potřeba nastavitLC_MESSAGES=cs_CZ.UTF-8při konfiguraci (vytváření) instance databáze.Pokud je nastaven wal_receiver_timeout (výchozí hodnotu má 60s), pak při testu PostgreSQL-STOP na primární instanci v clusterech tuchanka3 a tuchanka4 . Replikace je synchronní, takže se zastavuje nejen pracovní instance, ale i nový primární server. Obchází se to nastavením wal_receiver_timeout=0 při konfiguraci PostgreSQL.
Zřídka se objevilo zamrznutí replikace PostgreSQL při testu ForkBomb (přeplnění paměti). . S tímto jsem se setkal pouze v clusterech tuchanka3 a tuchanka4, kde kvůli synchronní replikaci primární server zamrzl. Problém se sám vyřešil po nějaké době (asi za dvě hodiny). Je potřeba dalšího zkoumání, aby se to opravilo. Podle symptomů to vypadá jako předchozí chyba, kterou způsobuje jiná příčina, ale se stejnými následky.
Obrázek krogan byl převzat z se souhlasem autora:
Zdroj: habr.com
