

Na vytvoření monitorovacího systému jsme začali přemýšlet už při zakládání produktových týmů. Bylo jasné, že naše činnost – provoz – se do těchto týmů nijak nedostává. Proč tomu tak je?
Jde o to, že všechny naše týmy jsou postaveny kolem jednotlivých informačních systémů, mikroslužeb a front-endů, a proto celkový zdravotní stav celého systému týmy nevidí. Například nemusí vědět, jak nějaká malá část v pozadí ovlivňuje front-end. Jejich zájem je omezen na systémy, s kterými je jejich systém integrován. Pokud není tým a jeho služba A téměř spojena se službou B, pak je tato služba pro tým téměř neviditelná.
Naše tým však pracuje se systémy, které jsou mezi sebou silně integrovány: mezi nimi je spousta vazeb, je to velká infrastruktura. A na všech těchto systémech (kterých máme, mimochodem, obrovské množství) závisí fungování internetového obchodu.
A tak to vypadá, že naše oddělení nepatří k žádnému týmu, ale je trochu stranou. V této situaci je naším úkolem chápat komplexně, jak informační systémy fungují, jaké mají funkce, integrace, software, sítě, hardware a jak to vše spolu souvisí.
Platforma, na které fungují naše internetové obchody, vypadá takto:
- front
- middle-office
- back-office
Ať chceme nebo ne, není možné, aby všechny systémy fungovaly hladce a bezchybně. Opět jde o počet systémů a integrací – při takovém množství, jaké máme, jsou nějaké incidenty nevyhnutelné, a to i při kvalitním testování. A to jak uvnitř jednotlivého systému, tak z hlediska jejich integrace. Je třeba sledovat stav celé platformy komplexně a ne pouze nějaké její části.
Ideálně by mělo být sledování zdravotního stavu celé platformy automatizováno. A došli jsme k monitorování jako nezbytné součásti tohoto procesu. Původně bylo postaveno pouze pro front-end, přičemž jednotlivé monitorovací systémy pro vrstvy měly a mají síťoví inženýři, správci softwaru a hardware. Tito lidé sledovali monitorování pouze na své úrovni, komplexní porozumění však nikdo neměl.
Například, pokud dojde k pádu virtuálního stroje, v mnoha případech o tom ví pouze administrátor, který je zodpovědný za hardware a virtuální stroj. Front-end tým v takových případech viděl pouze fakt pádu aplikace, ale neměl žádné údaje o pádu virtuálního stroje. Administrátor však může vědět, kdo je zákazník, a přibližně si představit, co právě na tomto virtuálním stroji běží, za předpokladu, že se jedná o nějaký velký projekt. O malých projektech pravděpodobně neví. V každém případě se administrátor musí obrátit na vlastníka, aby se zeptal, co na tomto stroji bylo, co je třeba obnovit a co změnit. A pokud se něco opravdu vážného pokazilo, začala by se běhat dokola - protože nikdo neviděl systém jako celek.
Nakonec tyto roztříštěné příběhy ovlivňují celý front-end, uživatele a naši hlavní obchodní funkci - internetový prodej. Protože se nezapojujeme do týmů, ale zabýváme se provozem všech e-commerce aplikací v rámci internetového obchodu, vzali jsme si na starost vytvoření komplexního monitorovacího systému pro e-commerce platformu.
Struktura systému a technologie
Začali jsme tím, že jsme definovali několik úrovní monitorování pro naše systémy, ve kterých budeme potřebovat sbírat metriky. A to vše bylo nutné spojit, což jsme udělali v prvním kroku. V současné době na tomto kroku vylepšujeme co nejkvalitnější sběr metrik ve všech našich úrovních, abychom mohli vybudovat korelaci a pochopit, jak na sebe systémy navzájem působí.
Nedostatek komplexního monitorování v počátečních fázích spuštění aplikací (protože jsme začali jeho budování, když většina systémů byla v provozu) vedl k tomu, že nám vznikl značný technický dluh ve nastavování monitorování celé platformy. Zaměřit se na nastavení monitorování jedné informační systému a podrobně jej zpracovávat jsme si nemohli dovolit, protože ostatní systémy by nějakou dobu zůstaly bez monitorování. Pro vyřešení této situace jsme definovali seznam nejpotřebnějších metrik pro hodnocení stavu informačního systému podle vrstev a začali jej zavádět.
Proto jsme se rozhodli pojmout slona po částech.
Náš systém se skládá z:
- hardware;
- operačního systému;
- software;
- UI prvky v aplikaci pro monitoring;
- obchodní metriky;
- integrační aplikace;
- informační bezpečnosti;
- sítě;
- balanceru provozu.
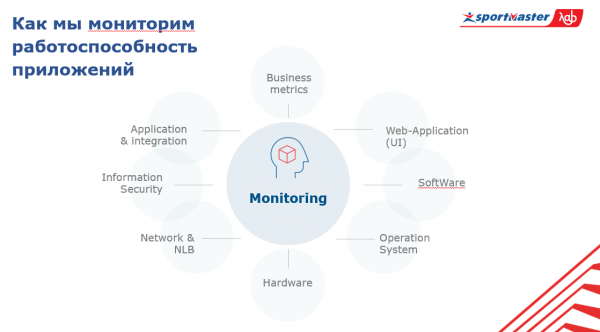
V centru tohoto systému je samotný monitoring. Abychom mohli obecně pochopit stav celého systému, musíme vědět, co se děje s aplikacemi na všech těchto vrstvách a v rámci celého množství aplikací.
Takže, o stacku.
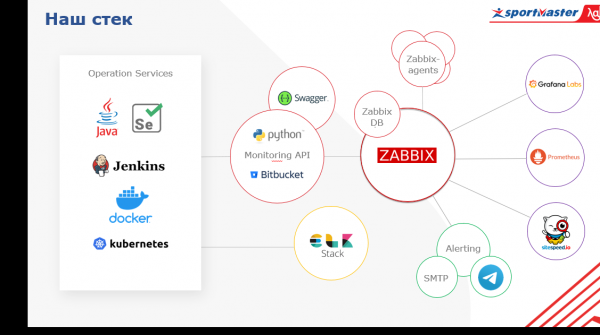
Používáme software s otevřeným zdrojovým kódem. V centru máme Zabbix, který používáme především jako systém alertingu. Je známo, že je ideální pro monitoring infrastruktury. Co to zahrnuje? Přesně ty nízkoúrovňové metriky, které má každá společnost, jež vlastní své datové centrum (a Sportmaster má vlastní datová centra) — teplota serveru, stav paměti, RAIDu, metriky síťových zařízení.
Integrujeme Zabbix s messengerem Telegram a Microsoft Teams, které jsou aktivně používány v týmech. Zabbix pokrývá vrstvu skutečné sítě, hardwaru a částečně softwaru, ale to není všelékem. Tyto údaje obohacujeme z některých dalších služeb. Například, co se týče úrovně hardwaru, přímo se připojujeme k našemu systému virtualizace přes API a získáváme data.
Co ještě. Kromě Zabbixu používáme Prometheus, který umožňuje monitorovat metriky v aplikaci dynamického prostředí. Jinými slovy, můžeme získávat metriky aplikace přes HTTP endpoint a nemuset se obávat, jaké metriky do ní nahrávat a jaké ne. Na základě těchto dat můžeme provádět analytické dotazy.
Zdroje dat pro ostatní vrstvy, například obchodní metriky, dělíme na tři složky.
Za prvé, externí obchodní systémy, Google Analytics, sbíráme metriky z logů. Z nich získáváme údaje o aktivních uživatelích, konverzích a všech dalších aspektech spojených s podnikáním. Za druhé, to je systém UI monitoringu. O něm bychom se měli podrobněji zmínit.
Jednou jsme začínali s manuálním testováním a to se přerodilo v automatizované testy funkcionality a integrací. Z toho jsme vytvořili monitoring, ponechali pouze základní funkcionalitu a zaměřili se na značky, které jsou co nejstabilnější a v průběhu času se často nemění.
Nová struktura týmů předpokládá, že veškeré činnosti související s aplikacemi se centralizují na produktové týmy, proto jsme přestali provádět čisté testování. Místo toho jsme z testů vytvořili UI monitorování, napsané v Javě, Selenium a Jenkins (používá se jako systém pro spuštění a generaci zpráv).
Měli jsme mnoho testů, ale nakonec jsme se rozhodli zaměřit na hlavní silnici, nadřazenou metriku. A pokud budeme mít mnoho specifických testů, bude obtížné udržovat data aktuální. Každá následující verze zásadně rozbije celý systém a my se budeme jen zabývat jeho opravou. Proto jsme se zaměřili na zcela základní věci, které se zřídka mění, a monitorujeme jen ty.
Nakonec, za třetí, zdrojem dat je centralizovaný systém logování. Pro logy používáme Elastic Stack a poté můžeme tato data přetáhnout do našeho monitorovacího systému pro obchodní metriky. Kromě toho funguje náš vlastní služba Monitoring API, napsaná v Pythonu, která se dotazuje jakýchkoli služeb přes API a stahuje z nich data do Zabbixu.
Další nezbytnou součástí monitorování je vizualizace. U nás je stavěna na základě Grafana. Mezi ostatními vizualizačními systémy se vyznačuje tím, že na dashboardu lze vizualizovat metriky z různých zdrojů dat. Můžeme shromáždit nadřazené metriky internetového obchodu, například počet objednávek provedených za poslední hodinu, z DB, metriky výkonnosti OS, na kterém běží tento internetový obchod, ze Zabbixu, a metriky instance této aplikace — z Prometheus. A to vše bude na jednom dashboardu. Přehledně a dostupně.
Rád bych zmínil bezpečnost — nyní vylepšujeme systém, který posléze integrujeme s globálním monitorovacím systémem. Podle mého názoru jsou hlavní problémy, kterým čelí e-commerce v oblasti informační bezpečnosti, spojeny s boty, parsery a brute force útoky. Na to je třeba dávat pozor, protože to může kriticky ovlivnit jak fungování našich aplikací, tak reputaci z pohledu podnikání. A s vybraným technickým zázemím tyto úkoly úspěšně pokrýváme.
Ještě důležitý bod — úroveň aplikací sbírá Prometheus. Ten je u nás také integrován se Zabbixem. A máme také sitespeed, službu, která nám umožňuje sledovat parametry jako rychlost načítání našich stránek, úzká místa, vykreslování stránky, načítání skriptů a další, také je integrována přes API. Takže metriky u nás sbírá Zabbix, a podle toho také zasíláme upozornění. Všechny upozornění zatím odcházejí na hlavní způsoby odesílání (zatím je to e-mail a telegram, nedávno jsme také připojili MS Teams). V plánu je vylepšit sledování na takovou úroveň, aby inteligentní boti fungovali jako služba a poskytovali informace o monitorování všem zájemcům z produktových týmů.
Pro nás jsou důležité metriky nejen jednotlivých informačních systémů, ale také celkové metriky celé infrastruktury, kterou aplikace používají: clustery fyzických serverů, na kterých běží virtuální stroje, load balancery, Network Load Balancer-y, sama síť, využití komunikačních kanálů. Navíc metriky dle našich vlastních datových center (máme jich několik a infrastruktura je poměrně značných rozměrů).
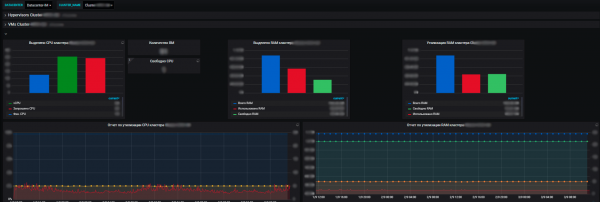
Výhody našeho monitorovacího systému spočívají v tom, že s jeho pomocí vidíme stav funkčnosti všech systémů, můžeme hodnotit jejich vzájemný vliv a dopad na společné zdroje. A v konečném důsledku nám to umožňuje plánování zdrojů, což také spadá do naší odpovědnosti. Spravujeme serverové zdroje — pool v rámci e-commerce, zavádíme a vyřazujeme z provozu nové zařízení, dokupujeme nové, provádíme audit využití zdrojů a další. Každý rok týmy plánují nové projekty, rozvíjejí své systémy a pro nás je důležité zajistit jim zdroje.
A s pomocí metrik vidíme tendenci spotřeby zdrojů našimi informačními systémy. A na jejich základě můžeme něco plánovat. Na úrovni virtualizace sbíráme data a vidíme informace o dostupném množství zdrojů podle jednotlivých datových center. A uvnitř datového centra vidíme jak využití, tak skutečné rozdělení a spotřebu zdrojů. A to jak se standalone servery, tak s virtuálními stroji a clustery fyzických serverů, na kterých všechny tyto virtuální stroje spolehlivě běží.
Vyhlídky
Nyní máme jádro systému v celé jeho šíři hotové, ale zůstává dostatek aspektů, na kterých je ještě třeba pracovat. Minimálně to zahrnuje vrstvu informační bezpečnosti, ale také je důležité dostat se k síti, rozvinout monitorování a vyřešit otázku korelace. Máme mnoho vrstev a systémů, na každé vrstvě je ještě řada metrik. Vzniká tak matrjoška v matici matrjošek.
Naším úkolem je nakonec vytvořit správné upozornění. Například, pokud dojde k problému s hardwarovou částí, opět s virtuálním strojem, u něhož bylo důležité aplikace, a služba nebyla nijak rezervována. Zjistíme, že virtuální stroj selhal. Následně budou upozorňovat obchodní metriky: uživatelé někam zmizeli, nejsou žádné konverze, uživatelské rozhraní není k dispozici, software a služby také selhaly.
Při takovém scénáři dostaneme spam z upozornění, což už neodpovídá formátu správného monitorovacího systému. Objevuje se otázka korelace. Ideálně by náš monitorovací systém měl říct: „Páni, vaše fyzická mašina selhala a společně s ní tato aplikace a tyto metriky“, pomocí jednoho upozornění místo toho, aby nás intenzivně zasypával stovkami upozornění. Měl by informovat o hlavním — o příčině, která přispívá k rychlému odstranění problému díky její lokalizaci.
Náš systém upozornění a zpracování upozornění je postaven kolem nepřetržitého linky hot-line. Všechna upozornění, která považujeme za nezbytná a zahrnují se do kontrolního seznamu, se předávají tam. Každé upozornění musí mít nezbytně popis: co se stalo, co to vlastně znamená, na co má vliv. A také odkaz na dashboard a instrukce, co by se mělo v tomto případě dělat.
To je vše, co se týče požadavků na budování upozornění. Poté se situace může vyvíjet ve dvou směrech — buď problém existuje a je třeba jej vyřešit, nebo došlo k chybě v monitorovacím systému. Ale v každém případě je třeba jít a zjistit příčinu.
Průměrně nám v současnosti za den přichází asi sto upozornění, a to i s ohledem na to, že korelace upozornění ještě není řádně nastavena. A pokud je třeba provést technické práce a něco jsme nuceni vypnout, jejich počet se násobí.
Kromě monitorování systémů, které používáme, a shromažďování metrik, jež považujeme za důležité, nám náš monitorovací systém umožňuje shromažďovat údaje pro produktové týmy. Tyto týmy mohou ovlivňovat složení metrik v rámci informačních systémů, které u nás monitorujeme.
Náš kolega může přijít a požádat o přidání nějaké metriky, která se ukáže být užitečná jak pro nás, tak pro tým. Nebo může být týmu k dispozici nedostatečné množství základních metrik, které máme, a potřebují sledovat něco specifického. V Grafaně vytváříme prostor pro každý tým a udělujeme administrátorská práva. Také, pokud tým potřebuje dashboardy a sami to nemohou/neví, jak to udělat, pomáháme jim.
Protože nejsme součástí procesu vytváření hodnot týmu, jejich vydání a plánování, postupně se dostáváme k tomu, že jsou všechna vydání systémů bezproblémová a mohou se uvolňovat denně, aniž bychom se museli na ně s námi dohodnout. A je pro nás důležité sledovat tato vydání, protože potenciálně mohou ovlivnit fungování aplikace a něco rozbít, což je kritické. Pro správu vydání používáme Bamboo, odkud přes API získáváme data a můžeme vidět, která vydání v jakých informačních systémech proběhla a jejich stav. A co je nejdůležitější – v jakém čase. Ukazatele o vydáních klademe na hlavní kritické metriky, což vizuálně ukazuje, když se objeví problémy.
Tímto způsobem můžeme vidět korelaci mezi novými vydáními a vznikajícími problémy. Hlavní myšlenkou je chápat, jak systém funguje na všech vrstvách, rychle lokalizovat problém a také jej rychle opravit. Často totiž nejvíce času zabere ne řešení problému, ale hledání příčiny.
A v tomto směru se v budoucnu chceme zaměřit na proaktivitu. Ideálně bychom chtěli být informováni o blížící se problému předem, nikoli zpětně, abychom se mohli zabývat jeho prevencí, nikoli řešením. Někdy dochází k falešným poplachům systému monitorování, a to jak v důsledku lidské chyby, tak kvůli změnám v aplikaci. A my na tom pracujeme, ladíme to a snažíme se před jakýmikoli manipulacemi se systémem monitorování upozornit uživatele, kteří ho používají spolu s námi, nebo tyto aktivity provádět v technickém okně.
Takže systém byl spuštěn a úspěšně funguje od začátku jara… a ukazuje docela reálný profit. Samozřejmě, že to není jeho finální verze, budeme implementovat ještě řadu užitečných funkcí. Ale právě teď, při tak velkém množství integrací a aplikací, se bez automatizace monitorování opravdu neobejdeme.
Pokud také monitorujete velké projekty se značným počtem integrací — napište do komentářů, jakou stříbrnou kulku jste pro to našli.
Zdroj: habr.com
