

Dnes na našem projektu kromě monolitického kódu funguje desítky mikroslužeb. Každá z nich vyžaduje monitorování. Dělat to v takovém objemu je pro DevOps inženýry problematické. Vyvinuli jsme monitorovací systém, který funguje jako služba pro vývojáře. Ti mohou samostatně zapisovat metriky do monitorovacího systému, využívat je, vytvářet na jejich základě dashboardy a připojovat k nim upozornění, která se aktivují při dosažení prahových hodnot. Od DevOps inženýrů je potřeba pouze infrastruktura a dokumentace.
Tento příspěvek je přepisem mého vystoupení z naší na RIT++. Mnozí nás žádali o textové verze přednášek z této akce. Pokud jste byli na konferenci nebo sledovali video, nenajdete zde nic nového. A všichni ostatní — vítejte pod článkem. Představím, jak jsme dospěli k takovému systému, jak funguje a jak plánujeme jeho aktualizace.
Minulost: schémata a plány
Jak jsme dospěli k stávajícímu monitorovacímu systému? Abychom na tuto otázku odpověděli, musíme se vrátit do roku 2015. Takto to vypadalo tehdy:
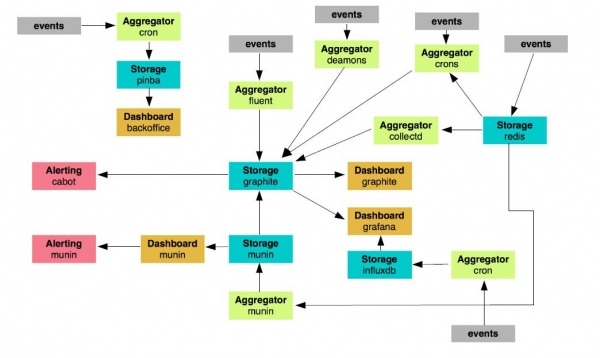
Měli jsme přibližně 24 uzlů, které zajišťovaly monitorování. Existovalo zde celá řada různých cronů, skriptů, démonů, kteří něco kdesi nějakým způsobem monitorovali, posílali zprávy, vykonávali funkce. Mysleli jsme si, že čím dál, tím méně takový systém bude životaschopný. Jeho rozvoj nemělo smysl: byl příliš rozměrný.
Rozhodli jsme se vybrat ty prvky monitorování, které si necháme a budeme rozvíjet, a ty, od kterých se vzdáme. Bylo jich 19. Zůstaly pouze grafity, agregátory a Grafana jako dashboard. Ale jak bude vypadat nový systém? Takto:
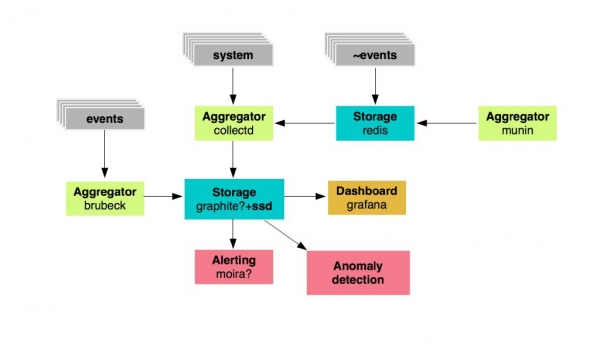
Máme úložiště metrik: jsou to grafity, které budou založené na rychlých SSD discích, a určité agregátory pro metriky. Dále — Grafana pro zobrazení dashboardů a Moira jako alerting. Také jsme chtěli vyvinout systém pro vyhledávání anomálií.
Standard: Monitorování 2.0
Takto vypadaly plány v roce 2015. Ale museli jsme připravovat nejen infrastrukturu a samotnou službu, ale i dokumentaci k ní. Pro sebe jsme vyvinuli firemní standard, který jsme nazvali monitorování 2.0. Jaké požadavky jsme měli na systém?
- stálá dostupnost;
- interval uchování metrik = 10 sekund;
- strukturované ukládání metrik a dashboardů;
- SLA > 99,99%
- sběr eventových metrik pomocí UDP (!).
Potřebovali jsme UDP, protože máme velký objem provozu a událostí, které generují metriky. Pokud bychom je všechny zapisovali do Graphite najednou, úložiště by se zhroutilo. Také jsme zvolili prefixy prvního stupně pro všechny metriky.
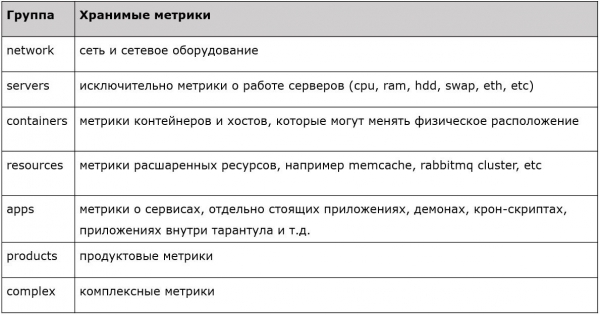
Každý z prefixů má nějakou vlastnost. Existují metriky pro servery, sítě, kontejnery, zdroje, aplikace a tak dále. Byla implementována jasná, přísná, typovaná filtrace, kde přijímáme metriky prvního stupně, a ostatní jednoduše zahazujeme. Takto jsme plánovali tento systém v roce 2015. A co teď?
Současnost: schéma interakce monitorovacích komponentů
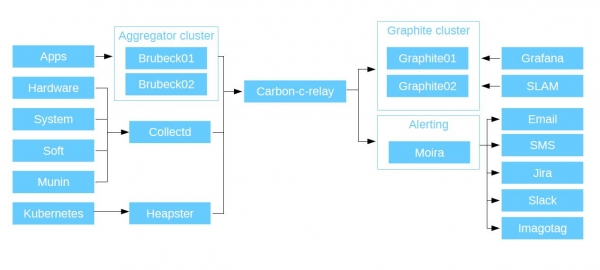
Nejprve monitorujeme aplikace: náš PHP kód, aplikace a mikroservisy — zkrátka vše, co naši vývojáři píší. Všechny aplikace zasílají metriky přes UDP do agregátoru Brubeck (statsd přepsaný do C). Ukázal se jako nejrychlejší na základě syntetických testů. A on již posílá agregované metriky do Graphite přes TCP.
Má typ metrik, jako jsou časovače. To je velmi pohodlná věc. Například pro každé spojení uživatele se službou posíláte do Brubeck metriky s dobou odezvy. Přišlo milion odpovědí a agregátor vydal pouze 10 metrik. Máte počet přijatých lidí, maximální, minimální a průměrnou dobu odezvy, medián a 4 percentily. Potom jsou data předávána do Graphite a vidíme je všechny živě.
Také máme agregaci pro metriky podle hardwaru, softwaru, systémových metrik a našeho starého monitorovacího systému Munin (ten u nás fungoval až do roku 2015). Všechny tyto údaje shromažďujeme prostřednictvím C démona CollectD (ten má zabudovaný celou řadu různých pluginů, umí dotazovat všechny zdroje hostitelského systému, na kterém je nainstalován, stačí v konfiguraci uvést, kam psát data) a zapisujeme je skrze něj do Graphite. Také podporuje pluginy Python a shell skripty, takže si můžete psát vlastní vlastní řešení: CollectD bude shromažďovat tato data z místního nebo vzdáleného hostitele (předpokládejme, že je zde Curl) a posílat je do Graphite.
Dále všechny metriky, které jsme sesbírali, posíláme do Carbon-c-relay. Toto řešení je Carbon Relay od Graphite, upravené v C. Je to router, který sbírá všechny metriky, které posíláme z našich agregátorů, a směruje je na uzly. Také během směrování kontroluje platnost metrik. Ty musí jednak odpovídat schématu s prefixy, které jsem ukázal dříve, a jednak být platné pro Graphite. Jinak jsou odmítnuty.
Potom Carbon-c-relay posílá metriky do clusteru Graphite. Používáme Carbon-cache, přepsané v Go, jako hlavní úložiště metrik. Go-carbon, díky své vícité threadovosti, výrazně převyšuje výkon Carbon-cache. Přijímá data a zapisuje je na disky pomocí balíčku whisper (standardní, napsaný v pythonu). Pro čtení dat z našich úložišť používáme Graphite API. To funguje mnohem rychleji než standardní Graphite WEB. Co se s daty děje dál?
Jdou do Grafany. Jako hlavní zdroj dat používáme naše grafitové clustery, navíc máme Grafanu jako webové rozhraní pro zobrazení metrik a sestavení dashboardů. Pro každý svůj servis vyvíjejí vývojáři vlastní dashboard. Dále na nich sestavují grafy, na kterých jsou zobrazeny metriky, které zapisují ze svých aplikací. Kromě Grafany máme také SLAM. To je pythoní démon, který počítá SLA na základě dat z grafitu. Jak už jsem řekl, máme několik desítek mikroslužeb, z nichž každá má své vlastní požadavky. S pomocí SLAM se díváme do dokumentace a porovnáváme ji s tím, co máme v Graphite, a hodnotíme, jak požadavky odpovídají dostupnosti našich služeb.
Pokračujeme dále: alerting. Ten je organizován pomocí silného systému — Moira. Je nezávislá, protože pod kapotou má svůj vlastní Graphite. Byla vyvinuta kluky z SKB „Kontur“, napsaná v pythonu a Go, a je kompletně open-source. Moira přijímá stejný tok dat, který jde do grafitů. Pokud z nějakého důvodu vaše úložiště selže, váš alerting bude fungovat.
Moira jsme nasadili do Kubernetes, jako hlavní databázi používá cluster Redis serverů. Výsledkem je bezporuchový systém. Porovnává tok metrik se seznamem spouštěčů: pokud není zmínka, metrika se vyhazuje. Takto je schopna zpracovat gigabajty metrik za minutu.
Dále jsme k tomu připojili firemní LDAP, pomocí kterého si každý uživatel firemního systému může vytvářet notifikace pro existující (nebo nově vytvořené) spouštěče. Jelikož Moira obsahuje Graphite, podporuje všechny jeho funkce. Proto nejprve vezmete řádek a zkopírujete ho do Grafany. Podíváte se, jak se data zobrazují na grafech. Poté vezmete tento stejný řádek a zkopírujete ho do Moira. Přidáte mu limity a na výstupu získáte alerting. K tomu všemu nepotřebujete žádné specifické znalosti. Moira je schopna upozorňovat pomocí SMS, emailu, v Jira, Slacku… Také podporuje spouštění vlastních skriptů. Když nastane spouštěč a je přihlášena k vlastním skriptům nebo binárkám, spustí je a předá této binárce JSON na stdin. Vaše aplikace ho musí parsovat. Co s tím JSONem uděláte — to už záleží na vás. Chcete — pošlete to do Telegramu, chcete — otevřete úkoly v Jira, dělejte si, co chcete.
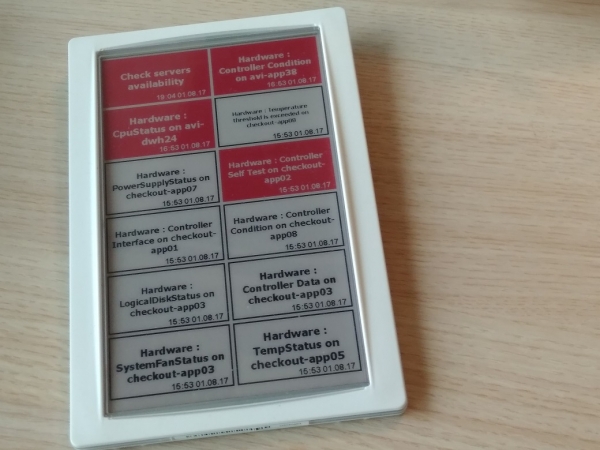
Pro alerting používáme také naši vlastní aplikaci — Imagotag. Přizpůsobili jsme panel, který se obvykle používá pro elektronické cenovky v obchodech, našim potřebám. Vytáhli jsme na něj spouštěče z Moira. Je tam uvedeno, v jakém stavu jsou a kdy k tomu došlo. Někteří z vývoje se vzdali notifikací ve Slacku a emailu ve prospěch tohoto panelu.
A protože jsme progresivní firma, monitorujeme v tomto systému také Kubernetes. Začlenili jsme ho do systému pomocí Heapsteru, který jsme nainstalovali do clusteru, shromažďuje data a posílá je do Graphite. Výsledný diagram vypadá takto:
Složky monitorování
Toto je seznam odkazů na ty komponenty, které jsme použili pro tento úkol. Všechny jsou open-source.
Graphite:
- go-carbon:
- whisper:
- graphite-api:
Carbon-c-relay:
Brubeck:
Collectd:
Moira:
Grafana:
Heapster:
Statistika
A tady je několik čísel o tom, jak systém funguje u nás.
Aggregator (brubeck)
Počet metrik: ~ 300 000 / sec
Interval odesílání metrik do Graphite: 30 sec
Využití serverových zdrojů: ~ 6% CPU (jde o plnohodnotné servery); ~ 1Gb RAM; ~ 3 Mbps LAN
Graphite (go-carbon)
Počet metrik: ~ 1 600 000 / min
Interval aktualizace metrik: 30 sec
Schéma ukládání metrik: 30sec 35d, 5min 90d, 10min 365d (dává přehled o tom, co se s službou děje v dlouhém časovém horizontu)
Využití serverových zdrojů: ~ 10% CPU; ~ 20Gb RAM; ~ 30 Mbps LAN
Flexibilita
V Avitu si velmi ceníme flexibility našeho monitorovacího servisu. Proč se vlastně takový vynikl? Za prvé, jeho součásti jsou vzájemně zaměnitelné: jak samotné komponenty, tak jejich verze. Za druhé — údržba. Vzhledem k tomu, že celý projekt je postaven na open-source software, můžete sami upravovat kód, provádět změny a implementovat funkce, které nejsou dostupné zkrabice. Používají se dost rozšířené technologie, převážně Go a Python, takže je to poměrně jednoduché.
Zde je příklad skutečně vzniklého problému. Metrika v Graphite je soubor. Má název. Název souboru = název metriky. A existuje cesta k němu. Název souboru v Linuxu je omezen na 255 znaků. A máme (jako "interní zákazníci") kluky z databázového oddělení. Říkají nám: "Chceme monitorovat naše SQL dotazy. A ty — nejsou 255 znaků, ale 8 MB každý. Chceme je zobrazit v Grafaně, vidět parametry pro tento dotaz, a ještě lépe, chceme vidět top takových dotazů. Bylo by skvělé, kdyby se to zobrazovalo v reálném čase. A úplně úžasné by bylo, kdybychom to mohli dostat do alertingu."
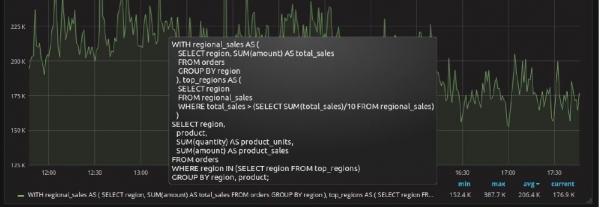
Příklad SQL dotazu je uveden jako příklad z
Zprovoznili jsme server Redis a naše Collectd pluginy, které komunikují s Postgres a získávají všechny data, které pak posíláme jako metriky do Graphite. Ale přitom měníme název metriky na hash. Tento hash zároveň posíláme do Redis jako klíč a celý SQL dotaz jako hodnotu. Musíme nyní nastavit, aby Grafana mohla komunikovat s Redis a tyto informace čerpat. Otevřeme Graphite API, protože to je hlavní rozhraní pro interakci všech komponent sledování s Graphite, a zapíšeme tam novou funkci, která se nazývá aliasByHash() — od Grafany získáme název metriky, a použijeme ho v dotazu na Redis jako klíč, v odpovědi získáme hodnotu klíče, kterým je náš "SQL dotaz". Tímto způsobem jsme v Grafaně zobrazili SQL dotaz, který bylo teoreticky nemožné tam zobrazit, společně se statistikou k němu (calls, rows, total_time, …).
Závěry
Dostupnost. Naše služba sledování je k dispozici 24/7 z jakékoli aplikace a jakéhokoli kódu. Pokud máte přístup k úložištím, můžete zasílat do služby data. Jazyk není důležitý, řešení nejsou důležitá. Potřebujete pouze vědět, jak otevřít socket, vložit do něj metriku a socket zavřít.
Spolehlivost. Všechny komponenty jsou odolné vůči chybám a zvládají naše zátěže bez problémů.
Nízký vstupní práh. Aby bylo možné tuto systém používat, nemusíte studovat programovací jazyky a dotazy v Grafaně. Stačí otevřít vaši aplikaci, vložit do ní socket, který bude zasílat metriky do Graphite, zavřít ho, otevřít Grafanu, vytvořit tam dashboardy a sledovat chování vašich metrik a získávat upozornění prostřednictvím Moira.
Samostatnost. Vše toto můžete dělat sami, bez pomoci DevOps inženýrů. A to je úplně zbytečné, protože můžete sledovat svůj projekt přímo nyní, nikoho nemusíte prosit — ani na začátku práce, ani na změny.
K čemu směřujeme?
Vše níže uvedené — není jen abstraktní myšlenka, ale záměr, ke kterému byly učiněny alespoň první kroky.
- Detektor anomálií. Chceme vytvořit službu, která bude probíhat do našich Graphite úložišť a kontrolovat každou metriku podle různých algoritmů. Již máme algoritmy, které chceme procházet, máme data a umíme s nimi pracovat.
- Metadata. Máme mnoho služeb, které se časem mění, stejně jako lidé, kteří s nimi pracují. Neustále vést dokumentaci ručně není možnost. Proto nyní integrujeme metadata do našich mikroslužeb. Je tam uvedeno, kdo je vyvinul, jazyky, se kterými pracuje, požadavky na SLA, kam a komu posílat notifikace. Při nasazení služby se všechny údaje samostatně vytvářejí. Nakonec dostanete dva odkazy - jeden na spouštěče, druhý na dashboardy v Grafaně.
- Monitoring do každého domu. Domníváme se, že by náš systém měli používat všichni vývojáři. V takovém případě vždy víte, kde je váš provoz, co se s ním děje, kde klesá, kde má slabá místa. Pokud například přijde něco, co přetíží vaši službu, zjistíte to ne během telefonátu od manažera, ale díky alertu, a můžete okamžitě otevřít čerstvé logy a podívat se, co se stalo.
- Vysoký výkon. Náš projekt neustále roste a dnes zpracováváme přibližně 2 000 000 hodnot metrik za minutu. Před rokem byl tento údaj 500 000. A růst pokračuje, což znamená, že za nějakou dobu začne Graphite (whisper) výrazně zatěžovat diskový subsystém. Jak už jsem řekl, tento monitorovací systém je dost univerzální díky vzájemné zaměnitelnosti komponent. Někdo speciálně pro Graphite udržuje a neustále rozšiřuje svou infrastrukturu, ale rozhodli jsme se jít jinou cestou: použít jako úložiště našich metrik. Tento přechod je téměř dokončen a brzy vám podrobněji povím, jak to bylo uděláno: jaké byly obtíže a jak byly překonány, jak probíhal proces migrace, popíšu zvolené komponenty pro obvaz a jejich konfigurace.
Děkuji za pozornost! Zeptejte se na své otázky k tématu, pokusím se odpovědět zde nebo v následujících příspěvcích. Možná má někdo zkušenosti s výstavbou podobného monitorovacího systému nebo přechodu na Clickhouse v podobné situaci - podělte se o ně v komentářích.
Zdroj: habr.com
