

Probereme koncept monitorování Kubernetes, seznámíme se s nástrojem Prometheus a probereme alerting.
Téma monitorování je obsáhlé, v jednom článku ho nelze podrobně analyzovat. Cílem tohoto textu je poskytnout přehled ohledně nástrojů, konceptů a přístupů.
Materiál článku — shrnutí z . Pokud chcete projít kompletním školením — přihlaste se na kurz o .
Co se monitoruje v Kubernetes clusteru
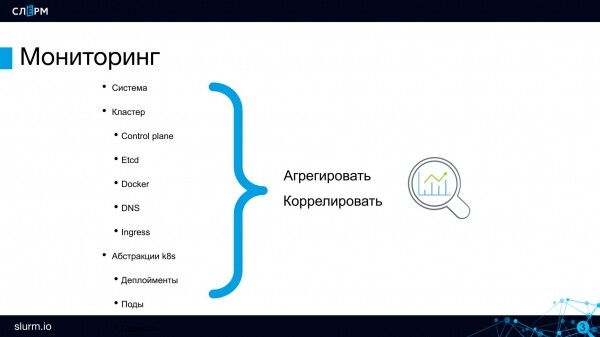
Fyzické servery. Pokud je cluster Kubernetes nasazen na vlastních serverech, je třeba sledovat jejich zdraví. S touto úlohou si poradí Zabbix; pokud s ním pracujete, nemusíte se jej vzdávat, konflikty nenastanou. O stavu našich serverů se stará právě Zabbix.
Přejděme k monitorování na úrovni clusteru.
Komponenty Control Plane: API, Scheduler a další. Minimálně je třeba sledovat, aby bylo více než 0 API serverů nebo etcd. Etcd dokáže poskytovat spoustu metrik: o discích, na kterých běží, o zdraví svého own clusteru etcd a další.
Docker existuje již dlouho a jeho problémy jsou všem dobře známy: množství kontejnerů vyvolává zamrzání a další problémy. Proto je dobré kontrolovat také samotný Docker, alespoň co se dostupnosti týče.
DNS. Pokud v clusteru selže DNS, celé službě Discovery selže také. Přestane fungovat komunikace mezi pody. Ve své praxi jsem s takovými problémy nesetkal, nicméně to neznamená, že stav DNS je třeba ignorovat. Zpoždění ve vyhledávání a další metriky lze sledovat na CoreDNS.
Ingress. Je třeba sledovat dostupnost ingressů (včetně Ingress Controlleru) jako vstupních bodů do projektu.
Hlavní komponenty clusteru jsme probrali — nyní sestoupíme níže na úroveň abstrakcí.
Mohlo by se zdát, že aplikace běží v podech, takže je třeba je monitorovat, ale ve skutečnosti tomu tak není. Pody jsou efemérní: dnes běží na jednom serveru, zítra na druhém; dnes jich je 10, zítra 2. Proto nikdo nesleduje pouhé pody. V rámci mikroservisní architektury je důležitější monitorovat dostupnost aplikace jako celku. Zvláště je důležité kontrolovat dostupnost endpointů služby: funguje vůbec něco? Pokud je aplikace dostupná, co se za ní děje, kolik replik je právě nyní — to jsou otázky druhého řádu. Není nutné sledovat jednotlivé instance.
Na poslední úrovni je třeba kontrolovat činnost samotné aplikace a sledovat obchodní metriky: počet objednávek, chování uživatelů a další.
Prometheus
Nejlepší systém pro monitorování clusteru je . Neznám žádný nástroj, který by se mohl s Prometheus srovnávat kvalitou a uživatelskou přívětivostí. Je ideální pro flexibilní infrastrukturu, takže když se říká "monitorování Kubernetes", obvykle se myslí právě Prometheus.
Existuje několik možností, jak začít pracovat s Prometheus: pomocí Helm můžete nainstalovat běžný Prometheus nebo Prometheus Operator.
- Běžný Prometheus. S ním je vše v pořádku, ale je třeba nastavit ConfigMap – v podstatě psát textové konfigurační soubory, jak jsme to dělali dříve, před mikroslužbovou architekturou.
- Prometheus Operator je poněkud rozvětvenější, o něco složitější co do vnitřní logiky, ale práce s ním je jednodušší: existují zde oddělené objekty, abstrakce se přidávají do clusteru, takže se s nimi mnohem lépe manipuluje a nastavuje.
Abychom se seznámili s produktem, doporučuji nejprve nainstalovat běžný Prometheus. Bude nutné vše nastavit přes konfiguraci, ale to vám prospěje: pochopíte, co k čemu patří a jak se nastavuje. V Prometheus Operator se hned dostanete na vyšší úroveň abstrakce, i když pokud budete chtít, můžete se také ponořit do hloubky.
Prometheus je dobře integrován s Kubernetes: může se připojit k API Server a interagovat s ním.
Prometheus je populární, proto je podporován velkým množstvím aplikací a programovacích jazyků. Podpora je potřebná, protože Prometheus má svůj vlastní formát metrik, a pro jeho přenos je nutná buď knihovna uvnitř aplikace, nebo hotový exportér. A takových exportérů je docela hodně. Například je zde PostgreSQL Exporter: bere data z PostgreSQL a převádí je do formátu Prometheus, aby s nimi Prometheus mohl pracovat.
Architektura Prometheus
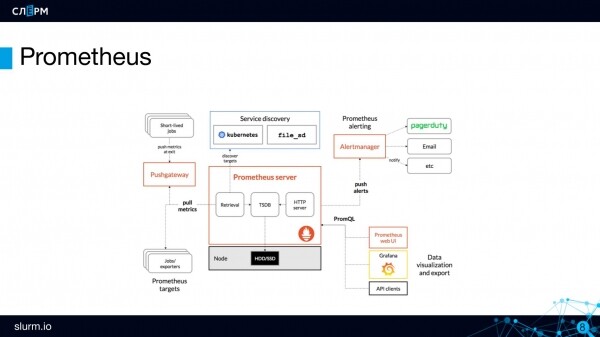
Prometheus Server – to je serverová část, mozek Prometheus. Zde jsou uchovávány a zpracovávány metriky.
Metriky uchovává time series database (TSDB). TSDB není samostatná databáze, ale balíček v jazyce Go, který je vestavěný v Prometheus. Zjednodušeně řečeno, vše je v jednom binárním souboru.
Nehodnote data v TSDB dlouho
Infrastruktura Prometheusu není vhodná pro dlouhodobé uchovávání metrik. Výchozí doba uchování je 15 dní. Tuto hranici lze překročit, ale je třeba mít na paměti, že čím více dat budete uchovávat v TSDB a čím déle to budete dělat, tím více zdrojů bude spotřebovávat. Uchovávání historických dat v Prometheusu se považuje za špatnou praxi.
Pokud máte obrovský provoz a počet metrik se počítá na stovky tisíc za sekundu, je lepší omezit jejich uchovávání podle objemu disku nebo podle času. Obvykle se v TSDB uchovávají "horká data", metriky doslova za několik hodin. Pro delší uchovávání se používají externí úložiště v databázích, které jsou pro to opravdu vhodné, například InfluxDB, ClickHouse a další. O ClickHouse jsem viděl více pozitivních recenzí.
Prometheus Server funguje na modelu pull: sám vybírá metriky z těch endpointů, které jsme mu zadali. Řekli jsme: "choď na API Server", a on tam chodí každých n-krát sekund a sbírá metriky.
Pro objekty s krátkou dobou životnosti (job nebo cron job), které se mohou objevit mezi obdobími skenování, existuje komponenta Pushgateway. Do ní se posílají metriky od krátkodobých objektů: job byl spuštěn, provedl akci, poslal metriky do Pushgateway a skončil. Po nějaké době Prometheus ve svém rytmu přichází a vybere tyto metriky z Pushgateway.
Pro nastavení upozornění v Prometheusu existuje samostatná komponenta — Alertmanager. A pravidla pro alerting — alerting rules. Například je třeba vytvořit alert, když jsou API servery 0. Když se událost aktivuje, alert se předává do alert manageru pro další odeslání. V alert manageru jsou dost flexibilní nastavení routování: jednu skupinu alertů lze posílat do telegramového chatu adminů, jinou do chatu vývojářů, třetí do chatu infrastruktury. Oznámení mohou přicházet do Slacku, Telegramu, na email a do dalších kanálů.
A na závěr vám povím o killer feature Prometheusu — Objevování. Při práci s Prometheusem není nutné uvádět konkrétní adresy objektů pro monitorování, stačí zadat jejich typ. To znamená, že není potřeba psát "toto je IP adresa, toto je port — monitoruj", místo toho je třeba určit, podle jakých principů vyhledávat tyto objekty (targets — cíle). Prometheus sám, v závislosti na tom, které objekty jsou nyní aktivní, přitahuje potřebné a přidává je na monitorování.
Tento přístup se dobře hodí do struktury Kubernetes, kde se také vše mění: dnes 10 serverů, zítra 3. Abychom pokaždé nemuseli uvádět IP adresu serveru, napsali jsme jednou, jak ho najít — a Discovering to udělá.
Jazyk Prometheus se nazývá PromQL. Pomocí tohoto jazyka lze získávat hodnoty konkrétních metrik a poté je transformovat a vytvářet na jejich základě analytické výstupy.
https://prometheus.io/docs/prometheus/latest/querying/basics/

Jednoduchý dotaz

    container_memory_usage_bytes

Matematické operace

    container_memory_usage_bytes / 1024 / 1024

Vestavěné funkce

    sum(container_memory_usage_bytes) / 1024 / 1024

Upřesnění dotazu

    100 - avg by (instance) (rate(node_cpu_seconds_total{mode="idle"}[5m]) * 100)
Webové rozhraní Prometheus
Prometheus má své vlastní, poměrně minimalistické webové rozhraní. Vhodné spíše pro debuggování nebo demonstraci.
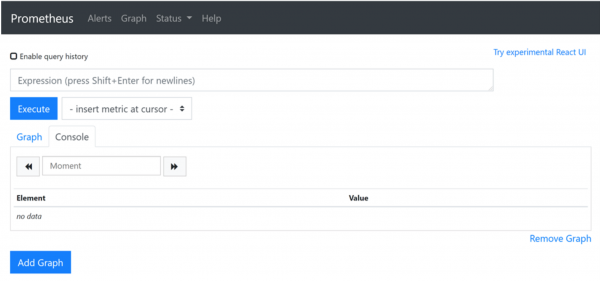
Do pole Expression lze psát dotaz v jazyce PromQL.
Na kartě Alerts naleznete pravidla alerů — alerting rules, a ta mají tři stavy:
- inactive — pokud je momentálně alert neaktivní, tedy je vše v pořádku a nedošlo k jeho spuštění;
- pending — to je v případě, kdy alert byl spuštěn, ale odeslání ještě neproběhlo. Zpoždění se nastavuje, aby kompenzovalo fluktuace v síti: pokud se během jedné minuty daná služba znovu spustila, není potřeba alarmovat;
- firing — to je třetí stav, kdy se alert aktivuje a odesílá zprávy.
V nabídce Status najdete přístup k informacím o tom, co vlastně Prometheus představuje. Tam je také přechod na cíle (targets), o kterých jsme mluvili výše.
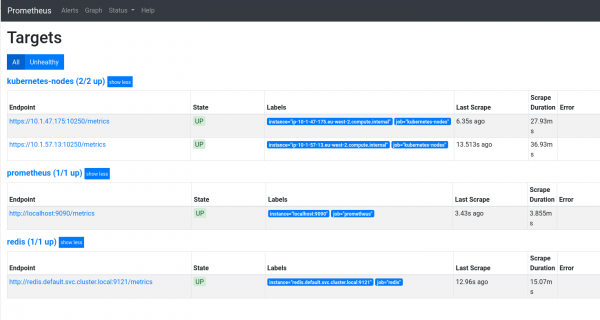
Podrobnější přehled rozhraní Prometheus naleznete .
Integrace s Grafana
V webovém rozhraní Prometheus nenajdete hezké a srozumitelné grafy, ze kterých byste mohli vyvodit stav klastru. Pro jejich vytváření se Prometheus integruje s Grafana. Vzniknou takto rozhraní.
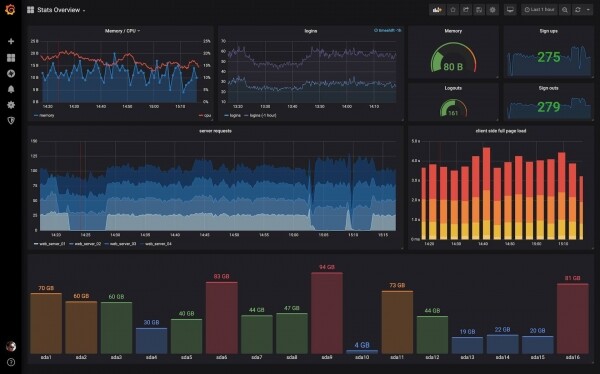
Nastavení integrace Prometheus a Grafana vůbec není složité, pokyny najdete v dokumentaci: , a tímto bych to ukončil.
V následujících článcích budeme pokračovat v tématu monitorování: budeme mluvit o sběru a analýze logů pomocí Grafana Loki a alternativních nástrojích.
Autor: Marcel Ibrajev, certifikovaný administrátor Kubernetes, praktikující inženýr ve společnosti , lektor a vývojář kurzů Slérm.
Zdroj: habr.com
