

Inženýr — v překladu z latiny — inspirován.
Inženýr dokáže vše. (c) R.Diesel.
Epigrafy.
Nebo příběh o tom, proč by si administrátor databází měl připomínat svou programátorskou minulost.
Úvod
Všechna jména byla změněna. Shody jsou náhodné. Materiál představuje výhradně osobní názor autora.
Zřeknutí se záruk: V plánované sérii článků nebude podrobný a přesný popis použitých tabulek a skriptů. Materiály nelze ihned použít "AS IS".
Za prvé, kvůli velkému objemu materiálu,
za druhé kvůli zaměření na produkční databázi skutečného zákazníka.
Proto budou v článcích uvedeny pouze myšlenky a popisy v nejobecnější podobě.
Možná v budoucnu systém doroste na úroveň zveřejnění na GitHubu, ale možná také ne. Čas ukáže.
Začátek příběhu- „».
Co se v důsledku stalo, v nejobecnějších rysech- „»
Proč mi to všechno?
Nuže, za prvé, abych sám nezapomněl, když vzpomínám na důchodové krásné chvíle.
Za druhé, abych systematizoval napsané. Neboť už sám, někdy začínám tápající a zapomínat jednotlivé části.
A to nejdůležitější — najednou se může někomu hodit a pomoci mu nevynalézat kolo a nesbírat vidle. Jinými slovy, zlepšit svou karmu (ne habrovskou). Neboť to nejcennější na tomto světě jsou myšlenky. Hlavní je najít myšlenku. A realizovat myšlenku do reality, to už je čistě technická záležitost.
Tak začněme, pomalu…
Stanovení úkolu.
Mám:
Databáze PostgreSQL (10.5), smíšeného typu zátěže (OLTP+DSS), střední-malé zátěže, umístěná v cloudu AWS.
Monitoring databáze chybí, monitoring infrastruktury je poskytován ve formě standardních prostředků AWS v minimální konfiguraci.
Požadováno:
Monitorovat výkon a stav databáze, najít a mít základní informace pro optimalizaci náročných dotazů na DB.
Krátký úvod nebo analýza možností řešení.
Nejprve se pokusíme prozkoumat možnosti řešení úkolu z pohledu srovnávací analýzy výhod a nepříjemností pro inženýra, zatímco prospěch a ztráty managementu ať zařídí ti, kdo to mají ve služebním plánu.
Možnost 1- „Práce na požádání“
Vše necháme tak, jak to je. Pokud zákazníka něco v funkcionalitě, výkonnosti databáze nebo aplikace neuspokojuje, informuje inženýry DBA prostřednictvím e-mailu nebo vytvořením incidentu v ticketovací systém.
Inženýr, který obdrží upozornění, se na problém podívá, navrhne řešení nebo problém odloží na neurčito, doufaje, že se to nějak vyřeší, a stejně to brzy zapadne do zapomnění.
Perníčky a buchty, modřiny a boulePerníčky a buchty:
1. Není potřeba nic zbytečně dělat
2. Vždy je možnost vykroutit se a vyhnout se zodpovědnosti.
3. Spousta času, který lze využít podle vlastního uvážení.
Modřiny a boule:
1. Dříve nebo později se zákazník zamyslí nad podstatou existence a univerzální spravedlnosti na tomto světě a opět si položí otázku – za co vlastně platím? Důsledek je vždy stejný – otázka je jen, kdy se zákazník nudí a mávne rukou na rozloučenou. A krmítko se vyprázdní. To je smutné.
2. Rozvoj inženýra – nula.
3. Obtíže při plánování práce a zátěže
Varianta 2 – „Tancujeme s bubny, prodáváme a obouváme“
Bod 1-Proč potřebujeme monitorovací systém, všechny informace budeme dostávat dotazy. Spustíme spoustu různých dotazů na slovník dat a dynamická zobrazení, zapneme různé počítadla, shromáždíme vše do tabulek, občas jakoby analyzujeme seznamy a tabulky. Výsledkem jsou hezké nebo méně hezké grafy, tabulky, zprávy. Hlavně aby toho bylo co nejvíce.
Bod 2-Generujeme aktivitu – spouštíme analýzu všeho tohoto.
Bod 3-Připravíme jakýsi dokument, nazveme ho jednoduše – „jak uspořádat databázi“.
Bod 4-Zákazník, vidíc toto krásné množství grafů a čísel, zůstává v dětské naivní víře – teď to konečně začne fungovat, brzy. A bez bolestně se snadno loučí se svými finančními prostředky. Management je také přesvědčen – naši inženýři pracují skvěle. Zátěž je na maximu.
Bod 5-Pravidelně opakovat Bod 1.
Perníčky a buchty, modřiny a boulePerníčky a buchty:
1. Život manažerů a inženýrů – je jednoduchý, předvídatelný a plný aktivity. Všechno hučí, všichni jsou zaneprázdněni.
2. Život zákazníka také není špatný – vždy věří, že je potřeba si trochu počkat a všechno se spraví. Není to opraveno, no co, to je nespravedlivý svět, v příštím životě – má štěstí.
Modřiny a boule:
1. Dříve či později se najde pohotovější poskytovatel podobné služby, který udělá totéž, ale o něco levněji. A pokud je výsledek stejný, proč platit víc. Což opět povede k vymizení zdroje obživy.
2. Je to nudné. Tak nudné jako jakákoli málo smysluplná činnost.
3. Stejně jako v předchozí variantě — žádný rozvoj. Ale pro inženýra je nevýhoda v tom, že na rozdíl od prvního variantu je tu potřeba neustále generovat databázi. A to bere čas. Který by se dal lépe využít pro sebe. Protože o sebe se nikdo nepostará, ostatním je to jedno.
Varianta 3 – Není třeba vymýšlet kolo, stačí si ho koupit a jezdit.
Inženýři jiných firem se ne nadarmo cpou pizzou zapíjenou pivem (ach, skvělé časy v devadesátých letech v Petrohradu). Pojďme využívat monitorovací systémy, které jsou vytvořeny, doladěny a fungují, a přinášejí skutečně užitek (alespoň jejich tvůrcům).
Perníčky a buchty, modřiny a boulePerníčky a buchty:
1. Není třeba ztrácet čas vymýšlením toho, co už bylo vymyšleno. Vezmi si a použij.
2. Monitorovací systémy nevyvíjejí blázni a samozřejmě jsou užitečné.
3. Funkční monitorovací systémy obvykle poskytují užitečné filtrované informace.
Modřiny a boule:
1. Inženýr v tomto případě není inženýr, ale pouze uživatel cizího produktu. Nebo uživatel.
2. Zákazníka je třeba přesvědčit o nutnosti koupit něco, čemu vlastně nerozumí, a ani by neměl, a rozpočet na rok je schválen a měnit se nebude. Potom je třeba vyčlenit samostatný zdroj a nastavit jej pro konkrétní systém. Tedy nejdříve je třeba platit, platit a znovu platit. A zákazník je lakomý. To je normální v tomto životě.
Co tedy dělat - Černyševský? Tvá otázka je velmi na místě. (c)
V této konkrétní situaci a nastalé situaci je možné jednat poněkud jinak — a co takhle vytvořit vlastní monitorovací systém.
No, není to systém v pravém slova smyslu, to by bylo příliš silné a domýšlivé, ale aspoň si ulehčit úkol a shromáždit více informací pro řešení incidentů výkonnosti. Abychom se nedostali do situace — „jdi tam, nevím kam, najdi to, nevím co“.
Jaké jsou klady a zápory této varianty:
Plusy:
1. Je to zajímavé. No, minimálně je to zajímavější než neustálé „shrink datafile, alter tablespace, atd.“
2. To jsou nové dovednosti a nové rozvoje. Co v perspektivě dříve nebo později přinese zasloužené odměny a bonbóny.
Nevýhody:
1. Bude třeba pracovat. Pracovat hodně.
2. Bude nutné pravidelně vysvětlovat smysl a perspektivy celé činnosti.
3. Něčemu se bude muset obětovat, protože jediný dostupný zdroj inženýra – čas – je omezený Vesmírem.
4. Nejstrašnější a nejnepříjemnější – nakonec to může skončit jako něco, co není myš, ani žába, ale neznámé stvoření.
Kdo neriskuje, ten nepije šampaňské.
Takže – začíná to nejzajímavější.
Celková myšlenka – schématicky
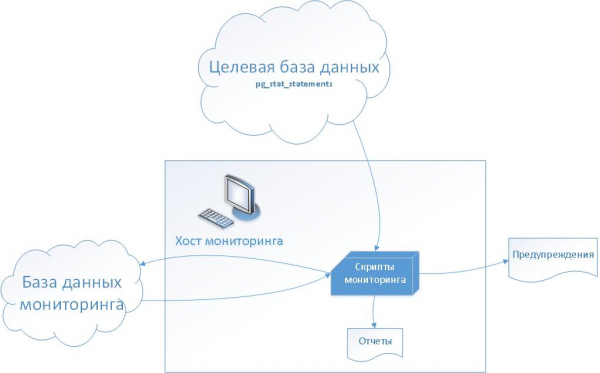
(Ilustrace pochází z článku «»)
Vysvětlení:
- Ve cílové databázi se instaluje standardní rozšíření PostgreSQL – “pg_stat_statements”.
- V databázi monitorování vytvoříme sadu servisních tabulek pro ukládání historie pg_stat_statements v počátečním stádiu a pro nastavování metrik a monitorování v budoucnu.
- Na hostiteli monitorování vytvoříme sadu bash skriptů, včetně těch pro generování incidentů v ticketovém systému.
Servisní tabulky
Na začátek schématicky zjednodušená ERD, co se nakonec stalo:
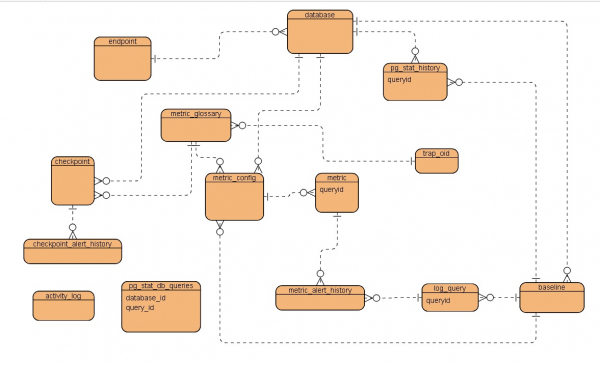
Krátký popis tabulekendpoint – host, bod připojení k instanci
database – parametry databáze
pg_stat_history – historická tabulka pro ukládání časových snímků zobrazení pg_stat_statements cílové databáze
metric_glossary – slovník metrik výkonnosti
metric_config – konfigurace jednotlivých metrik
metric – konkrétní metrika pro sledovaný dotaz
metric_alert_history – historie varování výkonnosti
log_query – servisní tabulka pro uchovávání rozebraných záznamů z log souboru PostgreSQL načítaného z AWS
baseline – parametry časového období používaného jako základní
checkpoint – konfigurace metrik kontroly stavu databáze
checkpoint_alert_history – historie varování metrik kontroly stavu databáze
pg_stat_db_queries – servisní tabulka aktivních dotazů
activity_log – servisní tabulka deníku aktivity
trap_oid – servisní tabulka konfigurace trap
Krok 1 – shromažďujeme statistické informace o výkonnosti a získáváme zprávy
Pro ukládání statistických informací slouží tabulka pg_stat_history
Struktura tabulky pg_stat_history
                                          Tabulka "public.pg_stat_history"
       Sloupec        |            Typ             |                          Modifikátory
---------------------+-----------------------------+-------------------------------------------
 id                  | celé číslo                  | není null, výchozí hodnota nextval('pg_stat_history_id_seq'::regclass)
 snapshot_timestamp  | časová značka bez časové zóny |
 database_id         | celé číslo                  |
 dbid                | oid                         |
 userid              | oid                         |
 queryid             | velké celé číslo            |
 query               | text                        |
 calls               | velké celé číslo            |
 total_time          | dvojité přesnost             |
 min_time            | dvojité přesnost             |
 max_time            | dvojité přesnost             |
 mean_time           | dvojité přesnost             |
 stddev_time         | dvojité přesnost             |
 rows                | velké celé číslo            |
 shared_blks_hit     | velké celé číslo            |
 shared_blks_read    | velké celé číslo            |
 shared_blks_dirtied | velké celé číslo            |
 shared_blks_written | velké celé číslo            |
 local_blks_hit      | velké celé číslo            |
 local_blks_read     | velké celé číslo            |
 local_blks_dirtied  | velké celé číslo            |
 local_blks_written  | velké celé číslo            |
 temp_blks_read      | velké celé číslo            |
 temp_blks_written   | velké celé číslo            |
 blk_read_time       | dvojité přesnost             |
 blk_write_time      | dvojité přesnost             |
 baseline_id         | celé číslo                  |
Indexy:
    "pg_stat_history_pkey" PRIMÁRNÍ KLÍČ, btree (id)
    "database_idx" btree (database_id)
    "queryid_idx" btree (queryid)
    "snapshot_timestamp_idx" btree (snapshot_timestamp)
Cizí klíčové omezení:
    "database_id_fk" CIZÍ KLÍČ (database_id) ODKAZUJE na database(id) PŘI ODSTRANĚNÍ KASKÁDNĚ
Jak je vidět, tabulka představuje pouze kumulativní údaje pohledu pg_stat_statements v cílové databázi.
Použití této tabulky je velmi jednoduché
pg_stat_history bude představovat shromážděnou statistiku provedení dotazů za každou hodinu. Na začátku každé hodiny, po naplnění tabulky, se statistika pg_stat_statements resetuje pomocí pg_stat_statements_reset().
Poznámka: statistika se shromažďuje pro dotazy, jejichž doba provádění přesahuje 1 sekundu.
Naplnění tabulky pg_stat_history
--pg_stat_history.sql
CREATE OR REPLACE FUNCTION pg_stat_history( ) RETURNS boolean AS $$
DECLARE
  endpoint_rec record ;
  database_rec record ;
  pg_stat_snapshot record ;
  current_snapshot_timestamp timestamp without time zone;
BEGIN
  current_snapshot_timestamp = date_trunc('minute',now());

  FOR endpoint_rec IN SELECT * FROM endpoint
  LOOP
    FOR database_rec IN SELECT * FROM database WHERE endpoint_id = endpoint_rec.id
	  LOOP

		RAISE NOTICE 'NOVÝ SNÍMEK SE VYTVÁŘÍ';

		-- Připojit se k cílové DB
	    EXECUTE 'SELECT dblink_connect(''LINK1'',''host='||endpoint_rec.host||' dbname='||database_rec.name||' user=USER password=PASSWORD '')';

        RAISE NOTICE 'host % a dbname % ',endpoint_rec.host,database_rec.name;
		RAISE NOTICE 'Vytvářím snímek pg_stat_statements pro databázi %',database_rec.name;

		SELECT
	      *
		INTO
		  pg_stat_snapshot
	    FROM dblink('LINK1',
	      'SELECT
	       dbid , SUM(calls),SUM(total_time),SUM(rows) ,SUM(shared_blks_hit) ,SUM(shared_blks_read) ,SUM(shared_blks_dirtied) ,SUM(shared_blks_written) ,
           SUM(local_blks_hit) , SUM(local_blks_read) , SUM(local_blks_dirtied) , SUM(local_blks_written) , SUM(temp_blks_read) , SUM(temp_blks_written) , SUM(blk_read_time) , SUM(blk_write_time)
	       FROM pg_stat_statements WHERE dbid=(SELECT oid from pg_database where datname=current_database() )
		   GROUP BY dbid
  	      '
	               )
	      AS t
	       ( dbid oid , calls bigint ,
  	         total_time double precision ,
	         rows bigint , shared_blks_hit bigint , shared_blks_read bigint ,shared_blks_dirtied bigint ,shared_blks_written	 bigint ,
             local_blks_hit	 bigint ,local_blks_read bigint , local_blks_dirtied bigint ,local_blks_written bigint ,
             temp_blks_read	 bigint ,temp_blks_written bigint ,
             blk_read_time double precision , blk_write_time double precision
	       );

		INSERT INTO pg_stat_history
          (
		    snapshot_timestamp  ,database_id  ,
			dbid , calls  ,total_time ,
            rows ,shared_blks_hit  ,shared_blks_read  ,shared_blks_dirtied  ,shared_blks_written ,local_blks_hit ,
            local_blks_read,local_blks_dirtied,local_blks_written,temp_blks_read,temp_blks_written,
            blk_read_time, blk_write_time
		  )
	    VALUES
	      (
	       current_snapshot_timestamp ,
		   database_rec.id ,
	       pg_stat_snapshot.dbid ,pg_stat_snapshot.calls,
	       pg_stat_snapshot.total_time,
	       pg_stat_snapshot.rows ,pg_stat_snapshot.shared_blks_hit ,pg_stat_snapshot.shared_blks_read ,pg_stat_snapshot.shared_blks_dirtied ,pg_stat_snapshot.shared_blks_written ,
           pg_stat_snapshot.local_blks_hit , pg_stat_snapshot.local_blks_read , pg_stat_snapshot.local_blks_dirtied , pg_stat_snapshot.local_blks_written ,
	       pg_stat_snapshot.temp_blks_read , pg_stat_snapshot.temp_blks_written , pg_stat_snapshot.blk_read_time , pg_stat_snapshot.blk_write_time
	      );

        RAISE NOTICE 'Vytvářím snímek pg_stat_statements pro dotazy s min_time větším než 1000ms';

        FOR pg_stat_snapshot IN
          -- Všechny dotazy s max_time přes 1000 ms
	      SELECT
	        *
	      FROM dblink('LINK1',
	        'SELECT
	         dbid , userid ,queryid,query,calls,total_time,min_time ,max_time,mean_time, stddev_time ,rows ,shared_blks_hit ,
			 shared_blks_read ,shared_blks_dirtied ,shared_blks_written ,
             local_blks_hit , local_blks_read , local_blks_dirtied ,
			 local_blks_written , temp_blks_read , temp_blks_written , blk_read_time ,
			 blk_write_time
	         FROM pg_stat_statements
			 WHERE dbid=(SELECT oid from pg_database where datname=current_database() AND min_time >= 1000 )
  	        '

	                  )
	        AS t
	         ( dbid oid , userid oid , queryid bigint ,query text , calls bigint ,
  	           total_time double precision ,min_time double precision	 ,max_time double precision	 , mean_time double precision	 ,  stddev_time double precision	 ,
	           rows bigint , shared_blks_hit bigint , shared_blks_read bigint ,shared_blks_dirtied bigint ,shared_blks_written	 bigint ,
               local_blks_hit	 bigint ,local_blks_read bigint , local_blks_dirtied bigint ,local_blks_written bigint ,
               temp_blks_read	 bigint ,temp_blks_written bigint ,
               blk_read_time double precision , blk_write_time double precision
	         )
	    LOOP
		  INSERT INTO pg_stat_history
          (
		    snapshot_timestamp  ,database_id  ,
			dbid ,userid  , queryid  , query  , calls  ,total_time ,min_time ,max_time ,mean_time ,stddev_time ,
            rows ,shared_blks_hit  ,shared_blks_read  ,shared_blks_dirtied  ,shared_blks_written ,local_blks_hit ,
            local_blks_read,local_blks_dirtied,local_blks_written,temp_blks_read,temp_blks_written,
            blk_read_time, blk_write_time
		  )
	      VALUES
	      (
	       current_snapshot_timestamp ,
		   database_rec.id ,
	       pg_stat_snapshot.dbid ,pg_stat_snapshot.userid ,pg_stat_snapshot.queryid,pg_stat_snapshot.query,pg_stat_snapshot.calls,
	       pg_stat_snapshot.total_time,pg_stat_snapshot.min_time ,pg_stat_snapshot.max_time,pg_stat_snapshot.mean_time, pg_stat_snapshot.stddev_time ,
	       pg_stat_snapshot.rows ,pg_stat_snapshot.shared_blks_hit ,pg_stat_snapshot.shared_blks_read ,pg_stat_snapshot.shared_blks_dirtied ,pg_stat_snapshot.shared_blks_written ,
           pg_stat_snapshot.local_blks_hit , pg_stat_snapshot.local_blks_read , pg_stat_snapshot.local_blks_dirtied , pg_stat_snapshot.local_blks_written ,
	       pg_stat_snapshot.temp_blks_read , pg_stat_snapshot.temp_blks_written , pg_stat_snapshot.blk_read_time , pg_stat_snapshot.blk_write_time
	      );

        END LOOP;

        PERFORM dblink_disconnect('LINK1');

	  END LOOP ;--FOR database_rec IN SELECT * FROM database WHERE endpoint_id = endpoint_rec.id

  END LOOP;

RETURN TRUE;
END
$$ LANGUAGE plpgsql;
V důsledku toho, po určité době, bude v tabulce pg_stat_history soubor snímků obsahu tabulky pg_stat_statements cílové databáze.
Samotné reportování
Pomocí jednoduchých dotazů lze získat velmi užitečné a zajímavé zprávy.
Agregovaná data za zadané časové období
Dotaz
SELECT
  database_id ,
  SUM(calls) AS calls ,SUM(total_time)  AS total_time ,
  SUM(rows) AS rows , SUM(shared_blks_hit)  AS shared_blks_hit,
  SUM(shared_blks_read) AS shared_blks_read ,
  SUM(shared_blks_dirtied) AS shared_blks_dirtied,
  SUM(shared_blks_written) AS shared_blks_written ,
  SUM(local_blks_hit) AS local_blks_hit ,
  SUM(local_blks_read) AS local_blks_read ,
  SUM(local_blks_dirtied) AS local_blks_dirtied ,
  SUM(local_blks_written)  AS local_blks_written,
  SUM(temp_blks_read) AS temp_blks_read,
  SUM(temp_blks_written) temp_blks_written ,
  SUM(blk_read_time) AS blk_read_time ,
  SUM(blk_write_time) AS blk_write_time
FROM
  pg_stat_history
WHERE
  queryid IS NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT
GROUP BY database_id ;
Čas DB
to_char(interval '1 millisecond' * pg_total_stat_history_rec.total_time, 'HH24:MI:SS.MS')
Čas I/O
to_char(interval '1 millisecond' * ( pg_total_stat_history_rec.blk_read_time + pg_total_stat_history_rec.blk_write_time ), 'HH24:MI:SS.MS')
TOP10 SQL podle celkového času
Dotaz
SELECT
  queryid ,
  SUM(calls) AS calls ,
  SUM(total_time)  AS total_time
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id = DATABASE_ID AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT
GROUP BY queryid
ORDER BY 3 DESC
LIMIT 10
------------------------------------------------------------------------------------- | TOP10 SQL PODLE CELKOVÉ DOBY VÝKONU | #| queryid| calls| procento volání| celkový čas (ms) | procento dbtime +----+-----------+-----------+-----------+--------------------------------+---------- | 1| 821760255| 2| .00001|00:03:23.141( 203141.681 ms.)| 5.42 | 2| 4152624390| 2| .00001|00:03:13.929( 193929.215 ms.)| 5.17 | 3| 1484454471| 4| .00001|00:02:09.129( 129129.057 ms.)| 3.44 | 4| 655729273| 1| .00000|00:02:01.869( 121869.981 ms.)| 3.25 | 5| 2460318461| 1| .00000|00:01:33.113( 93113.835 ms.)| 2.48 | 6| 2194493487| 4| .00001|00:00:17.377( 17377.868 ms.)| .46 | 7| 1053044345| 1| .00000|00:00:06.156( 6156.352 ms.)| .16 | 8| 3644780286| 1| .00000|00:00:01.063( 1063.830 ms.)| .03
TOP10 SQL podle celkového I/O času
Dotaz
SELECT
  queryid ,
  SUM(calls) AS calls ,
  SUM(blk_read_time + blk_write_time)  AS io_time
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT
GROUP BY  queryid
ORDER BY 3 DESC
LIMIT 10
---------------------------------------------------------------------------------------- | TOP10 SQL PODLE CELKOVÉHO ČASU I/O | #| queryid| volání| procento volání| I/O čas (ms)|% čase I/O db +----+-----------+-----------+-----------+--------------------------------+------------- | 1| 4152624390| 2| .00001|00:08:31.616( 511616.592 ms.)| 31.06 | 2| 821760255| 2| .00001|00:08:27.099( 507099.036 ms.)| 30.78 | 3| 655729273| 1| .00000|00:05:02.209( 302209.137 ms.)| 18.35 | 4| 2460318461| 1| .00000|00:04:05.981( 245981.117 ms.)| 14.93 | 5| 1484454471| 4| .00001|00:00:39.144( 39144.221 ms.)| 2.38 | 6| 2194493487| 4| .00001|00:00:18.182( 18182.816 ms.)| 1.10 | 7| 1053044345| 1| .00000|00:00:16.611( 16611.722 ms.)| 1.01 | 8| 3644780286| 1| .00000|00:00:00.436( 436.205 ms.)| .03
TOP10 SQL podle maximální doby vykonání
Dotaz
SELECT
  id AS snapshotid ,
  queryid ,
  snapshot_timestamp ,
  max_time
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT
ORDER BY 4 DESC
LIMIT 10
----------------------------------------------------------------------------------------- | TOP10 SQL PODLE MAXIMÁLNÍHO ČASU VYKRÁNÍ | #| snapshot| snapshotID| queryid| max_time (ms) +----+------------------+-----------+-----------+---------------------------------------- | 1| 05.04.2019 01:03| 4169| 655729273| 00:02:01.869( 121869.981 ms.) | 2| 04.04.2019 17:00| 4153| 821760255| 00:01:41.570( 101570.841 ms.) | 3| 04.04.2019 16:00| 4146| 821760255| 00:01:41.570( 101570.841 ms.) | 4| 04.04.2019 16:00| 4144| 4152624390| 00:01:36.964( 96964.607 ms.) | 5| 04.04.2019 17:00| 4151| 4152624390| 00:01:36.964( 96964.607 ms.) | 6| 05.04.2019 10:00| 4188| 1484454471| 00:01:33.452( 93452.150 ms.) | 7| 04.04.2019 17:00| 4150| 2460318461| 00:01:33.113( 93113.835 ms.) | 8| 04.04.2019 15:00| 4140| 1484454471| 00:00:11.892( 11892.302 ms.) | 9| 04.04.2019 16:00| 4145| 1484454471| 00:00:11.892( 11892.302 ms.) | 10| 04.04.2019 17:00| 4152| 1484454471| 00:00:11.892( 11892.302 ms.)
TOP10 SQL podle čtení/zápisu ve sdílených bufferech
Dotaz
SELECT
  id AS snapshotid ,
  queryid ,
  snapshot_timestamp ,
  shared_blks_read ,
  shared_blks_written
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT AND
  ( shared_blks_read > 0 OR shared_blks_written > 0 )
ORDER BY 4 DESC  , 5 DESC
LIMIT 10
-------------------------------------------------------------------------------------------- | TOP10 SQL PODLE SDÍLENÉHO ČTENÍ/ZÁPISU BUFFERU | #| snapshot| snapshotID| queryid| sdílené bloky čteny| sdílené bloky zapsány +----+------------------+-----------+-----------+---------------------+--------------------- | 1| 04.04.2019 17:00| 4153| 821760255| 797308| 0 | 2| 04.04.2019 16:00| 4146| 821760255| 797308| 0 | 3| 05.04.2019 01:03| 4169| 655729273| 797158| 0 | 4| 04.04.2019 16:00| 4144| 4152624390| 756514| 0 | 5| 04.04.2019 17:00| 4151| 4152624390| 756514| 0 | 6| 04.04.2019 17:00| 4150| 2460318461| 734117| 0 | 7| 04.04.2019 17:00| 4155| 3644780286| 52973| 0 | 8| 05.04.2019 01:03| 4168| 1053044345| 52818| 0 | 9| 04.04.2019 15:00| 4141| 2194493487| 52813| 0 | 10| 04.04.2019 16:00| 4147| 2194493487| 52813| 0 --------------------------------------------------------------------------------------------
Histogram rozložení dotazů podle maximální doby vykonávání
Požadavky
SELECT
  MIN(max_time) AS hist_min  ,
  MAX(max_time) AS hist_max ,
  (( MAX(max_time) - MIN(min_time) ) / hist_columns ) as hist_width
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT ;

SELECT
  SUM(calls) AS calls
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id =DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT AND
  ( max_time >= hist_current_min AND  max_time < hist_current_max ) ;
|-----------------------------------------------------------------------------------------------
| HISTOGRAM MAX_TIME
| CELKOVÝ POČET VOLÁNÍ : 33851920
| MIN DÉLKA  : 00:00:01.063
| MAX DÉLKA  : 00:02:01.869
---------------------------------------------------------------------------------
|                      min doba|                      max doba|     volání
+----------------------------------+----------------------------------+----------
| 00:00:01.063(      1063.830 ms.) | 00:00:13.144(     13144.445 ms.) | 9
| 00:00:13.144(     13144.445 ms.) | 00:00:25.225(     25225.060 ms.) | 0
| 00:00:25.225(     25225.060 ms.) | 00:00:37.305(     37305.675 ms.) | 0
| 00:00:37.305(     37305.675 ms.) | 00:00:49.386(     49386.290 ms.) | 0
| 00:00:49.386(     49386.290 ms.) | 00:01:01.466(     61466.906 ms.) | 0
| 00:01:01.466(     61466.906 ms.) | 00:01:13.547(     73547.521 ms.) | 0
| 00:01:13.547(     73547.521 ms.) | 00:01:25.628(     85628.136 ms.) | 0
| 00:01:25.628(     85628.136 ms.) | 00:01:37.708(     97708.751 ms.) | 4
| 00:01:37.708(     97708.751 ms.) | 00:01:49.789(    109789.366 ms.) | 2
| 00:01:49.789(    109789.366 ms.) | 00:02:01.869(    121869.981 ms.) | 0
TOP10 Snaps při dotazu za sekundu
Požadavky
--pg_qps.sql
--Vypočítat dotazy za sekundu
CREATE OR REPLACE FUNCTION pg_qps( pg_stat_history_id integer ) RETURNS double precision AS $$
DECLARE
 pg_stat_history_rec record ;
 prev_pg_stat_history_id integer ;
 prev_pg_stat_history_rec record;
 total_seconds double precision ;
 result double precision;
BEGIN
  result = 0 ;

  SELECT *
  INTO pg_stat_history_rec
  FROM
    pg_stat_history
  WHERE id = pg_stat_history_id ;

  IF pg_stat_history_rec.snapshot_timestamp IS NULL
  THEN
    RAISE EXCEPTION 'CHYBA - Nenalezen pg_stat_history pro id = %',pg_stat_history_id;
  END IF ;

 --RAISE NOTICE 'pg_stat_history_id = % , snapshot_timestamp = %', pg_stat_history_id ,
 pg_stat_history_rec.snapshot_timestamp ;

  SELECT
    MAX(id)
  INTO
    prev_pg_stat_history_id
  FROM
    pg_stat_history
  WHERE
    database_id = pg_stat_history_rec.database_id AND
	queryid IS NULL AND
	id  0
  THEN
    result = pg_stat_history_rec.calls / total_seconds ;
  ELSE
   result = 0 ;
  END IF;

 RETURN result ;
END
$$ LANGUAGE plpgsql;


SELECT
  id ,
  snapshot_timestamp ,
  calls ,
  total_time ,
  ( select pg_qps( id )) AS QPS ,
  blk_read_time ,
  blk_write_time
FROM
  pg_stat_history
WHERE
  queryid IS NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT AND
  ( select pg_qps( id )) IS NOT NULL
ORDER BY 5 DESC
LIMIT 10
|-----------------------------------------------------------------------------------------------
| TOP10 Snapslety seřazené podle počtu dotazů za sekundu
-----------------------------------------------------------------------------------------------------------------------------------------------
|    #|          snímek| snapshotID|      volání|                      celkový čas db|        QPS|                          I/O čas| I/O čas %
+-----+------------------+-----------+-----------+----------------------------------+-----------+----------------------------------+-----------
|    1|  04.04.2019 20:04|       4161|    5758631|  00:06:30.513(    390513.926 ms.)|   1573.396|  00:00:01.470(      1470.110 ms.)|       .376
|    2|  04.04.2019 17:00|       4149|    3529197|  00:11:48.830(    708830.618 ms.)|    980.332|  00:12:47.834(    767834.052 ms.)|    108.324
|    3|  04.04.2019 16:00|       4143|    3525360|  00:10:13.492(    613492.351 ms.)|    979.267|  00:08:41.396(    521396.555 ms.)|     84.988
|    4|  04.04.2019 21:03|       4163|    2781536|  00:03:06.470(    186470.979 ms.)|    785.745|  00:00:00.249(       249.865 ms.)|       .134
|    5|  04.04.2019 19:03|       4159|    2890362|  00:03:16.784(    196784.755 ms.)|    776.979|  00:00:01.441(      1441.386 ms.)|       .732
|    6|  04.04.2019 14:00|       4137|    2397326|  00:04:43.033(    283033.854 ms.)|    665.924|  00:00:00.024(        24.505 ms.)|       .009
|    7|  04.04.2019 15:00|       4139|    2394416|  00:04:51.435(    291435.010 ms.)|    665.116|  00:00:12.025(     12025.895 ms.)|      4.126
|    8|  04.04.2019 13:00|       4135|    2373043|  00:04:26.791(    266791.988 ms.)|    659.179|  00:00:00.064(        64.261 ms.)|       .024
|    9|  05.04.2019 01:03|       4167|    4387191|  00:06:51.380(    411380.293 ms.)|    609.332|  00:05:18.847(    318847.407 ms.)|     77.507
|   10|  04.04.2019 18:01|       4157|    1145596|  00:01:19.217(     79217.372 ms.)|    313.004|  00:00:01.319(      1319.676 ms.)|      1.666
Historie vykonávání za hodinu s počtem dotazů za sekundu a časem I/O
Dotaz
SELECT
  id ,
  timestamp_snímku ,
  volání ,
  celkový čas ,
  ( select pg_qps( id )) AS QPS ,
  blk_read_time ,
  blk_write_time
FROM
  pg_stat_history
WHERE
  queryid IS NULL AND
  database_id = DATABASE_ID  AND
  timestamp_snímku BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT
ORDER BY 2
|-----------------------------------------------------------------------------------------------
| HISTORIE VYKONÁNÍ HODINOVĚ S QueryPerSeconds a I/O časem
-----------------------------------------------------------------------------------------------------------------------------------------------
| HISTORIE DOTAZŮ ZA SEKUNDU
|    #|          snímek| snapshotID|      volání|                      celkový dbtime|        QPS|                          I/O čas| I/O čas %
+-----+------------------+-----------+-----------+----------------------------------+-----------+----------------------------------+-----------
|    1|  04.04.2019 11:00|       4131|       3747|  00:00:00.835(       835.374 ms.)|      1.041|  00:00:00.000(          .000 ms.)|       .000
|    2|  04.04.2019 12:00|       4133|    1002722|  00:01:52.419(    112419.376 ms.)|    278.534|  00:00:00.149(       149.105 ms.)|       .133
|    3|  04.04.2019 13:00|       4135|    2373043|  00:04:26.791(    266791.988 ms.)|    659.179|  00:00:00.064(        64.261 ms.)|       .024
|    4|  04.04.2019 14:00|       4137|    2397326|  00:04:43.033(    283033.854 ms.)|    665.924|  00:00:00.024(        24.505 ms.)|       .009
|    5|  04.04.2019 15:00|       4139|    2394416|  00:04:51.435(    291435.010 ms.)|    665.116|  00:00:12.025(     12025.895 ms.)|      4.126
|    6|  04.04.2019 16:00|       4143|    3525360|  00:10:13.492(    613492.351 ms.)|    979.267|  00:08:41.396(    521396.555 ms.)|     84.988
|    7|  04.04.2019 17:00|       4149|    3529197|  00:11:48.830(    708830.618 ms.)|    980.332|  00:12:47.834(    767834.052 ms.)|    108.324
|    8|  04.04.2019 18:01|       4157|    1145596|  00:01:19.217(     79217.372 ms.)|    313.004|  00:00:01.319(      1319.676 ms.)|      1.666
|    9|  04.04.2019 19:03|       4159|    2890362|  00:03:16.784(    196784.755 ms.)|    776.979|  00:00:01.441(      1441.386 ms.)|       .732
|   10|  04.04.2019 20:04|       4161|    5758631|  00:06:30.513(    390513.926 ms.)|   1573.396|  00:00:01.470(      1470.110 ms.)|       .376
|   11|  04.04.2019 21:03|       4163|    2781536|  00:03:06.470(    186470.979 ms.)|    785.745|  00:00:00.249(       249.865 ms.)|       .134
|   12|  04.04.2019 23:03|       4165|    1443155|  00:01:34.467(     94467.539 ms.)|    200.438|  00:00:00.015(        15.287 ms.)|       .016
|   13|  05.04.2019 01:03|       4167|    4387191|  00:06:51.380(    411380.293 ms.)|    609.332|  00:05:18.847(    318847.407 ms.)|     77.507
|   14|  05.04.2019 02:03|       4171|     189852|  00:00:10.989(     10989.899 ms.)|     52.737|  00:00:00.539(       539.110 ms.)|      4.906
|   15|  05.04.2019 03:01|       4173|       3627|  00:00:00.103(       103.000 ms.)|      1.042|  00:00:00.004(         4.131 ms.)|      4.010
|   16|  05.04.2019 04:00|       4175|       3627|  00:00:00.085(        85.235 ms.)|      1.025|  00:00:00.003(         3.811 ms.)|      4.471
|   17|  05.04.2019 05:00|       4177|       3747|  00:00:00.849(       849.454 ms.)|      1.041|  00:00:00.006(         6.124 ms.)|       .721
|   18|  05.04.2019 06:00|       4179|       3747|  00:00:00.849(       849.561 ms.)|      1.041|  00:00:00.000(          .051 ms.)|       .006
|   19|  05.04.2019 07:00|       4181|       3747|  00:00:00.839(       839.416 ms.)|      1.041|  00:00:00.000(          .062 ms.)|       .007
|   20|  05.04.2019 08:00|       4183|       3747|  00:00:00.846(       846.382 ms.)|      1.041|  00:00:00.000(          .007 ms.)|       .001
|   21|  05.04.2019 09:00|       4185|       3747|  00:00:00.855(       855.426 ms.)|      1.041|  00:00:00.000(          .065 ms.)|       .008
|   22|  05.04.2019 10:00|       4187|       3797|  00:01:40.150(    100150.165 ms.)|      1.055|  00:00:21.845(     21845.217 ms.)|     21.812
Text všech SQL-selectů
Dotaz
SELECT
  queryid ,
  query
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT
GROUP BY queryid , query
Výsledek
Jak je vidět, poměrně jednoduchými prostředky lze získat dostatek užitečných informací o zatížení a stavu databáze.
Poznámka:Pokud v dotazech zaznamenáme queryid, získáme historii pro jednotlivý dotaz (kvůli úspoře místa jsou zprávy pro jednotlivé dotazy vynechány).
Takže statistické údaje o výkonnosti dotazů jsou k dispozici a shromažďují se.
První fáze „sbírání statistických údajů“ – byla dokončena.
Můžeme přejít ke druhé fázi – „nastavení metrik výkonnosti“.
Ale to už je úplně jiný příběh.
Pokračování příště…
Zdroj: habr.com
