

V tomto článku si povíme něco o monitorování úložišť IBM Storwize a dalších úložišť, která podporují protokoly CIM/WBEM. Potřeba takového monitorování je považována za axiom. Jako systém monitorování budeme používat Zabbix.
V posledních verzích Zabbix se firma začala více soustředit na šablony — začaly se objevovat šablony pro monitorování služeb, DBMS a hardware serverů (IMM/iBMC) přes IPMI. Monitorování úložišť zatím zůstává mimo šablony dodávané s aplikací, proto pro integraci informací o stavu a výkonu komponent úložiště do Zabbix je potřeba použít vlastní šablony. Jeden z těchto šablon vám nabízím k dispozici.
Nejdříve trochu teorie.
Pro přístup ke stavu a statistikám úložiště IBM Storwize lze použít:
- Protokoly CIM/WBEM;
- (v IBM Storwize je podpora od verze softwaru 8.1.3);
- SNMP Traps (omezená sada trap, chybí statistiky);
- Připojení přes SSH s následným vzdáleným .
Zájemci se mohou podrobněji seznámit s různými metodami monitorování v příslušných sekcích dokumentace výrobce, a také v dokumentu .
Budeme používat protokoly CIM/WBEM, které umožňují získat parametry fungování úložiště bez významných změn softwaru pro různá úložiště. Protokoly CIM/WBEM fungují v souladu s . Storage Management Initiative – Specifikace je založena na otevřených standardech a , definovaných .
WBEM funguje na protokolu HTTP. Přes WBEM lze pracovat nejen s úložišti, ale také s HBA, switchem a páskovými knihovnami.
Podle a , hlavním komponentem realizace SMI je WBEM server, který zpracovává CIM-XML dotazy od WBEM klientů (v našem případě — od monitorovacích skriptů):
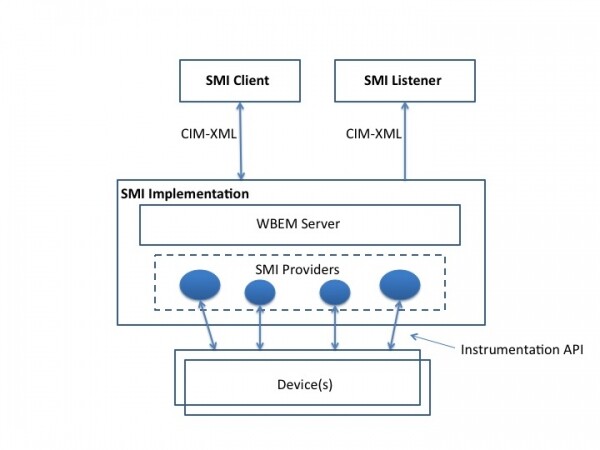
CIM je objektově orientovaný model založený na Unified Modeling Language (UML).
Spravované prvky jsou definovány jako CIM třídy, které mají vlastnosti a metody pro reprezentaci spravovaných dat a funkcí.
Podle , pro přístup k úložišti přes CIM/WBEM lze použít PyWBEM — open source knihovnu napsanou v Pythonu, která poskytuje vývojářům a systémovým administrátorům implementaci protokolu CIM pro přístup k CIM-objektům a provádění různých operací se WBEM-serverem, který pracuje podle SMI-S nebo jiných CIM-specifikací.
Pro spojení s WBEM-serverem použijeme konstruktor třídy :
conn = pywbem.WBEMConnection(server_uri, (self.login, self.password),
            namespace, no_verification=True)
Jedná se o virtuální spojení, protože CIM-XML/WBEM funguje přes HTTP, skutečné spojení se uskutečňuje při volání metod pro instanci třídy WBEMConnection. V souladu s IBM System Storage SAN Volume Controller and Storwize V7000 Best Practices and Performance Guidelines (Příklad C-8, str. 412) jako CIM namespace pro úložiště IBM Storwize použijeme „root/ibm“.
Všimněte si, že pro sběr statistik podle protokolu CIM-XML/WBEM je nutné přidat uživatele do příslušné bezpečnostní skupiny. Jinak při provádění WBEM-žádostí bude výstup atributů instance třídy prázdný..
Pro přístup ke statistikám úložiště musí uživatel, který provádí volání konstruktoru , mít oprávnění alespoň RestrictedAdmin (které je dostupné pro code_level > 7.8.0) nebo Administrator (což nedoporučuji z bezpečnostních důvodů).
Připojujeme se k úložišti přes SSH a zkontrolujeme čísla skupin:
> lsusergrp
id name            role            remote
0  SecurityAdmin   SecurityAdmin   no
1  Administrator   Administrator   no
2  CopyOperator    CopyOperator    no
3  Service         Service         no
4  Monitor         Monitor         no
5  RestrictedAdmin RestrictedAdmin no
Přidáváme uživatele zabbix do potřebné skupiny:
> chuser -usergrp 5 zabbix
Navíc, v souladu s IBM System Storage SAN Volume Controller and Storwize V7000 Best Practices and Performance Guidelines (str. 415) je třeba povolit sběr statistik na úložišti. Takto, pro sběr statistik každou minutu:
> startstats -interval 1
Kontrolujeme:
> lssystem | grep statistics
statistics_status on
statistics_frequency 1
Pro získání všech existujících tříd úložiště je nutné použít metodu EnumerateClassNames().
Příklad:
classnames = conn.EnumerateClassNames(namespace='root/ibm', DeepInheritance=True)
for classname in classnames:
     print (classname)
Pro získání hodnot parametrů úložiště je určena metoda třídy WBEMConnection, která vrací seznam instancí .
Příklad:
instances = conn.EnumerateInstances(classname,
                   namespace=nd_parameters['name_space'])
for instance in instances:
     for prop_name, prop_value in instance.items():
          print('  %s: %r' % (prop_name, prop_value))
Pro některé třídy, které obsahují velké množství instancí, jako je IBMTSSVC_StorageVolume, může být úplný dotaz na všechny instance docela pomalý. Může generovat velké objemy dat, která musí být připravena úložištěm, přenesena přes síť a zpracována skriptem. V takovém případě existuje metoda , která umožňuje získat pouze nás zajímající vlastnosti instance třídy. Tato metoda předpokládá použití dotazovacího jazyka podobného SQL – buď CIM Query Language (DMTF:CQL), nebo WBEM Query Language (WQL) pro dotazování CIM-objektů úložiště:
request = 'SELECT Name FROM IBMTSSVC_StorageVolumeStatistics'
objects_perfs_cim = wbem_connection.ExecQuery('DMTF:CQL', request)
Abychom zjistili, které třídy potřebujeme pro získání parametrů objektů úložiště, čteme dokumentaci, například .
Takže pro získání parametrů (nikoli výkonových čítačů) fyzických disků (Disk Drives) budeme dotazovat třídu IBMTSSVC_DiskDrive, pro získání parametrů objemů – třídu IBMTSSVC_StorageVolume, pro získání parametrů polí – třídu IBMTSSVC_Array, pro získání parametrů MDisks – třídu IBMTSSVC_BackendVolume atd.
O výkonu si můžete přečíst (konkrétně – ) a IBM System Storage SAN Volume Controller a Storwize V7000 osvědčené postupy a pokyny pro výkon (Příklad C-11, str. 415).
Pro získání statistik úložiště o objemech je třeba jako hodnotu parametru ClassName uvést IBMTSSVC_StorageVolumeStatistics. Potřebné pro sběr statistik vlastnosti třídy IBMTSSVC_StorageVolumeStatistics lze zobrazit v .
Dále pro analýzu výkonu lze použít třídy IBMTSSVC_BackendVolumeStatistics, IBMTSSVC_DiskDriveStatistics, IBMTSSVC_NodeStatistics.
Pro zapisování dat do systému monitorování použijeme mechanismus , realizovaný v pythonu v modulu . Strukturu tříd úložiště a jejich vlastností umístíme do slovníku ve formátu JSON.
Nahráváme šablonu na server Zabbix, ověřujeme, že ze serveru monitorování je přístup k úložištím pomocí protokolu WEB (TCP/5989), umisťujeme konfigurační soubory, skripty pro objevování a monitorování na server monitorování. Následně přidáváme do plánovače spuštění skriptů. Nakonec: objevujeme objekty úložišť (systémy RAID, fyzické a virtuální disky, enclosures a mnoho dalšího), předáváme je do Zabbix discoveries, čteme stav jejich parametrů, čteme statistiku výkonu (performance counters) a předáváme to vše do odpovídajících Zabbix Items naší šablony.
Šablonu Zabbix, python-skripty, strukturu tříd úložišť a jejich vlastností, a také příklady konfiguračních souborů lze .
Zdroj: habr.com
